EMアルゴリズム
概要
EMアルゴリズム(expectation–maximization algorithm)とは、見えない変数(潜在変数)をもつ確率モデルの最尤推定のための反復法で、現在の母数のもとでの潜在変数の事後分布で完全データの対数尤度の期待値 $Q$ をとる段と、$Q$ を最大にする段を交互に繰り返す。Jensen の不等式による対数尤度の下界を使うと、各反復で観測データの尤度が決して減らないことが示され、内点の不動点は尤度の停留点になる。不動点の近くでの収束は一般に 1 次で、その速さは欠損情報の割合 $1-I_{\mathrm{obs}}/I_{\mathrm{comp}}$ で決まる。正規混合や隠れ Markov モデルの推定に使われるが、局所的な極大や鞍点に止まることがある。
前提知識: 最尤推定, Jensenの不等式, 条件付き確率, 正規分布
身長のデータが二つの山をもつとき、「各人は見えない群 $k$ に属し、群ごとに正規分布に従う」と考えると、1 人のデータの密度は $\sum_k\pi_k\varphi(x;\mu_k,\sigma_k^2)$ という和になる。対数尤度は「和の対数」の和になり、微分して 0 と置いても閉じた形では解けない。ところが、もし各人の群が分かっていれば、群ごとに平均と分散を計算するだけで最尤推定ができる。
EM アルゴリズム は、この「見えない変数が分かれば易しい」という構造を使って、見えない変数の条件付き分布で期待値をとる E ステップと、その期待値を最大にする M ステップを交互に繰り返し、尤度を一歩ごとに増やしていく方法である。この記事では、反復で尤度が決して減らないこと(主定理)と、反復の不動点が尤度の停留点であることを証明し、収束の速さを欠損情報の割合で表す。多項分布・硬貨の混合・正規混合の 3 つの例で数値まで計算し、尤度の非有界性や境界の不動点などの落とし穴を反例で示す。多次元の正規混合のモデルそのもの(識別可能性など)は 混合Gaussモデル で扱う。
定義と使える条件
観測したデータ $x$ を固定する。見えない変数(潜在変数)$z$ は有限集合 $\mathcal Z$ に値をとるとし、母数 $\theta\in\Theta$ ごとに、$x$ と $z$ の同時の密度(または確率)$p(x,z\mid\theta)\ge0$ が与えられているとする。$(x,z)$ を 完全データ、$x$ を 観測データ という。観測データの尤度と対数尤度は
$$
L(\theta):=\sum_{z\in\mathcal Z}p(x,z\mid\theta),\qquad \ell(\theta):=\log L(\theta)\in[-\infty,\infty)
$$
である。$L(\theta)>0$ のとき、$z$ の 事後分布 を $q_\theta(z):=p(x,z\mid\theta)/L(\theta)$ と置く。
$L(\theta)>0$ となる $\theta$ と $\theta'\in\Theta$ について
$$
Q(\theta'\mid\theta):=\sum_{z:\,q_\theta(z)>0}q_\theta(z)\log p(x,z\mid\theta')\in[-\infty,\infty)
$$
と定める(完全データの対数尤度の、$\theta$ のもとでの事後分布による期待値)。初期値 $\theta^{(0)}$($L(\theta^{(0)})>0$)から次を繰り返して列 $\theta^{(0)},\theta^{(1)},\dots$ を作る手順を EM アルゴリズム(expectation–maximization algorithm)という。
- E ステップ:事後分布 $q_{\theta^{(k)}}$ を計算し、関数 $\theta'\mapsto Q(\theta'\mid\theta^{(k)})$ を作る。
- M ステップ:$Q(\theta'\mid\theta^{(k)})$ を最大にする $\theta'$ を一つ選び $\theta^{(k+1)}$ とする。
M ステップで最大点の代わりに $Q(\theta^{(k+1)}\mid\theta^{(k)})\ge Q(\theta^{(k)}\mid\theta^{(k)})$ を満たす点を選ぶものを 一般化 EM アルゴリズム(GEM)という。
データが独立な $n$ 個 $x_1,\dots,x_n$ で、それぞれに潜在変数 $z_i$ があるときは、$z=(z_1,\dots,z_n)$ として $p(x,z\mid\theta)=\prod_ip(x_i,z_i\mid\theta)$ と置けばよい。このとき事後分布も積になり、$Q$ は $i$ ごとの和に分かれる。潜在変数が連続の場合も、和を積分に替えれば thm-em-monotone の証明は同じ形で通る(一般の形は ESL17 §8.5.2、pp. 276–277)。微分を含む prop-em-stationary では、さらに積分と微分の交換を確かめる必要がある。
EM アルゴリズムを使ってよい条件と、主定理の仮定は次のとおりである。
- (i) 初期値で $L(\theta^{(0)})>0$ である(これがないと $q_\theta$ が定義できない)。
- (ii) 各 M ステップで $Q(\theta^{(k+1)}\mid\theta^{(k)})\ge Q(\theta^{(k)}\mid\theta^{(k)})$ が成り立つ(最大点が存在するか、少なくとも増やす点を選べる)。
- (iii) 不動点の性質(prop-em-stationary)には、$\Theta$ が $\mathbb R^d$ の開集合で、各 $p(x,z\mid\cdot)$ が微分可能であることを加える。
EM アルゴリズムが保証するのは「尤度が減らないこと」までで、最尤推定量(尤度の最大点)に着くことは保証しない。尤度に上限がない場合や、局所的な最大・鞍点に止まる場合は節「使える条件と反例」で示す。
公式の表
| 場面 | E ステップ | M ステップ | 根拠 |
|---|---|---|---|
| 一般 | $q_\theta(z)=p(x,z\mid\theta)/\sum_{z'}p(x,z'\mid\theta)$ | $\arg\max_{\theta'}Q(\theta'\mid\theta)$ | def-em-main |
| 2 成分の正規混合(1 次元) | $\gamma_i=\dfrac{\pi\varphi(x_i;\mu_2,\sigma_2^2)}{(1-\pi)\varphi(x_i;\mu_1,\sigma_1^2)+\pi\varphi(x_i;\mu_2,\sigma_2^2)}$ | $\pi'=\frac1n\sum_i\gamma_i$、$\mu_2'=\frac{\sum_i\gamma_ix_i}{\sum_i\gamma_i}$、$\sigma_2'^2=\frac{\sum_i\gamma_i(x_i-\mu_2')^2}{\sum_i\gamma_i}$(成分 1 は $1-\gamma_i$ で同じ形) | prop-em-gmm |
| 二項分布の混合(硬貨 2 枚、選ぶ確率 $\frac12$) | $\gamma_i=\dfrac{a^{h_i}(1-a)^{m-h_i}}{a^{h_i}(1-a)^{m-h_i}+b^{h_i}(1-b)^{m-h_i}}$ | $a'=\frac{\sum_i\gamma_ih_i}{m\sum_i\gamma_i}$、$b'=\frac{\sum_i(1-\gamma_i)h_i}{m\sum_i(1-\gamma_i)}$ | ex-em-coins |
| 隠れ Markov モデル | 前向き・後ろ向きで $\gamma_t,\xi_t$ | 推移・放出の回数の期待値の比 | 隠れMarkovモデル の定理「Baum–Welchの更新で尤度は減らない」 |
| 収束の速さ(1 次元) | — | 不動点の近くで誤差は毎回 $1-I_{\mathrm{obs}}/I_{\mathrm{comp}}$ 倍 | prop-em-rate |
主定理:尤度は減らない
$L(\theta)>0$ とし、$\theta'\in\Theta$ が $Q(\theta'\mid\theta)\ge Q(\theta\mid\theta)$ を満たすとする。このとき $L(\theta')\ge L(\theta)$ である。等号 $L(\theta')=L(\theta)$ が成り立つのは、$Q(\theta'\mid\theta)=Q(\theta\mid\theta)$ かつ $q_{\theta'}=q_\theta$ のときに限る。
とくに、条件 (i)(ii) のもとで EM アルゴリズム(および一般化 EM アルゴリズム)の列は $\ell(\theta^{(0)})\le\ell(\theta^{(1)})\le\ell(\theta^{(2)})\le\cdots$ を満たす。
$\mathcal Z$ 上の確率分布 $r$ と $\theta''\in\Theta$ について
$$
F(r,\theta''):=\sum_{z:\,r(z)>0}r(z)\log\frac{p(x,z\mid\theta'')}{r(z)}\in[-\infty,\infty)
$$
と置く($\log0=-\infty$)。
段 1($F$ は対数尤度以下):$S=\{z:r(z)>0\}$ とする。どの $z\in S$ でも $p(x,z\mid\theta'')>0$ なら、$\log$ が凹関数であることから、Jensenの不等式(有限個の点、重み $r(z)$)により
$$
F(r,\theta'')\le\log\sum_{z\in S}r(z)\frac{p(x,z\mid\theta'')}{r(z)}=\log\sum_{z\in S}p(x,z\mid\theta'')\le\log L(\theta'')=\ell(\theta'')
$$
である。ある $z\in S$ で $p(x,z\mid\theta'')=0$ なら $F(r,\theta'')=-\infty$ で、やはり $\ell(\theta'')$ 以下である。等号 $F(r,\theta'')=\ell(\theta'')>-\infty$ が成り立つのは、Jensen の不等式の等号の条件(Jensenの不等式 の命題「等号の条件」、$\log$ は狭義凹)から $p(x,z\mid\theta'')/r(z)$ が $S$ の上で定数で、かつ $S$ の外で $p(x,z\mid\theta'')=0$ のとき、すなわち $r=q_{\theta''}$ のときに限る。
段 2(事後分布で等号):$r=q_\theta$ とすると、$S$ の上で $p(x,z\mid\theta)/q_\theta(z)=L(\theta)$ なので $F(q_\theta,\theta)=\ell(\theta)$ である。また定義から、$H:=-\sum_{z\in S}q_\theta(z)\log q_\theta(z)$(有限の値)を使って
$$
F(q_\theta,\theta'')=Q(\theta''\mid\theta)+H\qquad(\theta''\in\Theta)
$$
である。$\theta''=\theta$ とすると $Q(\theta\mid\theta)=\ell(\theta)-H>-\infty$ である。
段 3(まとめ):段 1・2 と仮定から
$$
\ell(\theta')\ \ge\ F(q_\theta,\theta')=Q(\theta'\mid\theta)+H\ \ge\ Q(\theta\mid\theta)+H=F(q_\theta,\theta)=\ell(\theta)
$$
である。$\ell(\theta)>-\infty$ なので $\ell(\theta')>-\infty$、つまり $L(\theta')>0$ でもある。等号 $\ell(\theta')=\ell(\theta)$ なら二つの不等号がともに等号で、2 つ目から $Q(\theta'\mid\theta)=Q(\theta\mid\theta)$、1 つ目と段 1 の等号の条件から $q_\theta=q_{\theta'}$ を得る。逆にこの二つが成り立てば、段 1 の等号の条件により 1 つ目の不等号も等号である。
後半は、$\theta=\theta^{(k)}$、$\theta'=\theta^{(k+1)}$ に前半を当て、帰納法で $L(\theta^{(k)})>0$ を保ちながら進めればよい。$\square$
証明の $F(r,\theta)$ は、$r$ と $\theta$ の 2 変数の関数として見ると EM アルゴリズムの意味を明かす。段 1 から $F\le\ell$ で、$\theta$ を固定して $r$ について最大にすると $r=q_\theta$(E ステップ)、$r$ を固定して $\theta$ について最大にすることは $Q$ の最大化(M ステップ)と同じである。EM アルゴリズムは $F$ を一変数ずつ交互に最大にする座標上昇法である(ESL17 §8.5.3、pp. 277–278)。$F$ を対数尤度の 変分下界(evidence lower bound)と呼ぶこともある。E ステップで $r$ を事後分布 $q_\theta$ そのものにする代わりに、$r$ を扱いやすい族(たとえば成分ごとの積の形)に制限して $F$ を最大にするのが 変分推論 である。
不動点は停留点
$\Theta\subset\mathbb R^d$ を開集合とし、各 $z\in\mathcal Z$ について $\theta''\mapsto p(x,z\mid\theta'')$ が $\theta\in\Theta$ で微分可能、$L(\theta)>0$ とする。このとき
$$
\nabla\ell(\theta)=\nabla_{\theta'}Q(\theta'\mid\theta)\big|_{\theta'=\theta}
$$
である。とくに $\theta$ が EM アルゴリズムの不動点($\theta$ が $Q(\cdot\mid\theta)$ の最大点)なら $\nabla\ell(\theta)=0$ である。
$S=\{z:q_\theta(z)>0\}=\{z:p(x,z\mid\theta)>0\}$ とする。$z\in S$ なら $\theta'\mapsto\log p(x,z\mid\theta')$ は $\theta$ の近くで定義されて微分可能なので
$$
\nabla_{\theta'}Q(\theta'\mid\theta)\big|_{\theta'=\theta}=\sum_{z\in S}q_\theta(z)\frac{\nabla p(x,z\mid\theta)}{p(x,z\mid\theta)}=\frac1{L(\theta)}\sum_{z\in S}\nabla p(x,z\mid\theta)
$$
である。一方 $\nabla\ell(\theta)=\frac1{L(\theta)}\sum_{z\in\mathcal Z}\nabla p(x,z\mid\theta)$。差は $z\notin S$ の項で、そこでは $p(x,z\mid\cdot)\ge0$ が内点 $\theta$ で最小値 $0$ をとるので $\nabla p(x,z\mid\theta)=0$ である。よって両者は等しい。$\theta$ が $Q(\cdot\mid\theta)$ の最大点なら、内点での最大なので右辺は $0$ である。$\square$
逆は成り立たない。$\nabla\ell(\theta)=0$ でも $\theta$ が尤度の極大とは限らず、鞍点に止まることがある(節「よくある誤り」)。
収束の速さ
母数が 1 次元のとき、EM の写像 $M\colon\theta\mapsto\theta^{(k+1)}$ の不動点 $\hat\theta$ の近くでの速さは、情報量の比で決まる。
$$
I_{\mathrm{obs}}:=-\ell''(\hat\theta),\qquad I_{\mathrm{comp}}:=-\frac{\partial^2}{\partial\theta'^2}Q(\theta'\mid\hat\theta)\Big|_{\theta'=\hat\theta}
$$
をそれぞれ観測データと完全データの(観測された)情報量と呼ぶ。
$\Theta\subset\mathbb R$ を開区間、$\hat\theta$ を $M$ の不動点とし、$(\theta',\theta)\mapsto Q(\theta'\mid\theta)$ が $(\hat\theta,\hat\theta)$ の近くで $C^2$ 級、$I_{\mathrm{comp}}>0$、$M$ は $\hat\theta$ の近くで $\partial_{\theta'}Q(M(\theta)\mid\theta)=0$ を満たす微分可能な写像とする。さらに prop-em-stationary の仮定が $\hat\theta$ の近くの各点で成り立つとする。このとき
$$
M'(\hat\theta)=1-\frac{I_{\mathrm{obs}}}{I_{\mathrm{comp}}}
$$
であり、$M'(\hat\theta)\ge0$ である。$\hat\theta$ が $\ell$ の極大点で $I_{\mathrm{obs}}>0$ なら $0\le M'(\hat\theta)< 1$ で、$\hat\theta$ の十分近くから出発した列は $\hat\theta$ に収束し、$\lvert\theta^{(k+1)}-\hat\theta\rvert/\lvert\theta^{(k)}-\hat\theta\rvert\to M'(\hat\theta)$ となる($\theta^{(k)}\ne\hat\theta$ のとき)。
証明を開く
偏微分を添字で書く($Q_1=\partial_{\theta'}Q$、$Q_{12}=\partial_\theta\partial_{\theta'}Q$ など)。$Q_1(M(\theta)\mid\theta)=0$ を $\theta$ で微分して $\hat\theta$ を代入すると、$M(\hat\theta)=\hat\theta$ から $Q_{11}M'(\hat\theta)+Q_{12}=0$、すなわち $M'(\hat\theta)=-Q_{12}/Q_{11}$($(\hat\theta,\hat\theta)$ で評価)。一方 prop-em-stationary から $\hat\theta$ の近くのすべての $\theta$ で $\ell'(\theta)=Q_1(\theta\mid\theta)$ で、これを微分すると $\ell''(\theta)=Q_{11}(\theta\mid\theta)+Q_{12}(\theta\mid\theta)$。よって $M'(\hat\theta)=(Q_{11}-\ell'')/Q_{11}=1-I_{\mathrm{obs}}/I_{\mathrm{comp}}$。
範囲:thm-em-monotone の証明の段 1・2 から、すべての $\theta'$ で $\ell(\theta')\ge F(q_{\hat\theta},\theta')=Q(\theta'\mid\hat\theta)+H$、$\theta'=\hat\theta$ で等号である。よって $g(\theta'):=\ell(\theta')-Q(\theta'\mid\hat\theta)$ は $\theta'=\hat\theta$ で最小になり($\ell$ は $\ell'(\theta)=Q_1(\theta\mid\theta)$ から $C^2$ 級)、$g''(\hat\theta)\ge0$、すなわち $I_{\mathrm{comp}}\ge I_{\mathrm{obs}}$ で $M'(\hat\theta)\ge0$。$\hat\theta$ が極大点で $I_{\mathrm{obs}}>0$ なら $M'(\hat\theta)< 1$。最後の主張は、微分の定義から $M(\theta)-\hat\theta=M'(\hat\theta)(\theta-\hat\theta)+o(\theta-\hat\theta)$ で、$\hat\theta$ の近くでは $\lvert M(\theta)-\hat\theta\rvert\le c\lvert\theta-\hat\theta\rvert$($M'(\hat\theta)< c< 1$)となることによる。$\square$
正規混合の更新式
1 次元のデータ $x_1,\dots,x_n$ と $K$ 個の成分の正規混合 $\theta=(\pi_k,\mu_k,\sigma_k^2)_{k=1}^K$($\pi_k>0$、$\sum_k\pi_k=1$、$\sigma_k^2>0$)を考え、潜在変数 $z_i\in\{1,\dots,K\}$ を成分の番号とする($p(x_i,z_i=k\mid\theta)=\pi_k\varphi(x_i;\mu_k,\sigma_k^2)$)。E ステップの 責任 は
$$
\gamma_{ik}=\frac{\pi_k\varphi(x_i;\mu_k,\sigma_k^2)}{\sum_{j=1}^K\pi_j\varphi(x_i;\mu_j,\sigma_j^2)}
$$
である。$N_k:=\sum_i\gamma_{ik}$ と置き、$\bar x_k:=\frac1{N_k}\sum_i\gamma_{ik}x_i$ について $S_k:=\sum_i\gamma_{ik}(x_i-\bar x_k)^2>0$($k=1,\dots,K$)とすると、M ステップの最大点はただ 1 つで
$$
\pi_k'=\frac{N_k}n,\qquad\mu_k'=\bar x_k,\qquad\sigma_k'^2=\frac{S_k}{N_k}
$$
である。
証明を開く
$Q(\theta'\mid\theta)=\sum_k N_k\log\pi'_k+\sum_k\sum_i\gamma_{ik}\log\varphi(x_i;\mu'_k,\sigma'^2_k)$ で、$\pi'$ の部分と各 $k$ の $(\mu'_k,\sigma'^2_k)$ の部分に分かれる。$\pi'$ の部分:$\sum_kN_k\log\pi'_k-\sum_kN_k\log(N_k/n)=-n\sum_k\frac{N_k}n\log\frac{N_k/n}{\pi'_k}\le0$ で、Kullback–Leiblerダイバージェンス の定理「非負性(Gibbs の不等式)」により等号は $\pi'_k=N_k/n$ のときに限る。$(\mu,v)=(\mu'_k,\sigma'^2_k)$ の部分は $-\frac{N_k}2\log(2\pi v)-\frac1{2v}\sum_i\gamma_{ik}(x_i-\mu)^2$ で、$\sum_i\gamma_{ik}(x_i-\mu)^2=S_k+N_k(\bar x_k-\mu)^2$ だから、どの $v$ でも $\mu=\bar x_k$ でだけ最大になる。残る $h(v)=-\frac{N_k}2\log v-\frac{S_k}{2v}$ は $h'(v)=\frac{S_k-N_kv}{2v^2}$ により $v=S_k/N_k$ でだけ最大になる。$\square$
$S_k>0$ は、成分 $k$ の責任が正の点の中に異なる値が 2 つ以上あれば成り立つ。責任が 1 点に集中すると分散の更新が $0$ に近づき、尤度は上に有界でなくなる(反例の表の 3 行目)。
計算の手順
- 模型を書く:完全データ $(x,z)$ の密度 $p(x,z\mid\theta)$ を、$z$ が分かれば最尤推定が閉じた形で解けるように選ぶ。
- 初期値を選ぶ:$L(\theta^{(0)})>0$ を確かめる。対称な初期値(混合の成分を同じにするなど)を避け、複数の初期値を用意する。
- E ステップ:$q_{\theta^{(k)}}(z)$ を計算する。混合では責任 $\gamma_{ik}$。数値の下位桁あふれを避けるため、$\log$ をとった値から最大値を引いて指数をとる(log-sum-exp)。
- M ステップ:$Q(\theta'\mid\theta^{(k)})$ を最大にする。多くの模型では重み付きの最尤推定になる(prop-em-gmm)。
- 確かめる:$\ell(\theta^{(k+1)})\ge\ell(\theta^{(k)})$ を毎回確かめる。減ったら計算の誤りである(thm-em-monotone)。
- 止める:$\lvert\ell(\theta^{(k+1)})-\ell(\theta^{(k)})\rvert\le\delta(1+\lvert\ell(\theta^{(k)})\rvert)$(例えば $\delta=10^{-10}$)か反復の上限で止める。分散の下限を置くなど、退化した解に近づいたら止める。
- 選ぶ:初期値ごとの結果のうち対数尤度が最大のものを採る。
例題
4 つの区分の度数 $(x_1,x_2,x_3,x_4)=(125,18,20,34)$ が、確率 $\bigl(\frac12+\frac\theta4,\frac{1-\theta}4,\frac{1-\theta}4,\frac\theta4\bigr)$($0< \theta< 1$)の多項分布に従うとする。$\theta$ の最尤推定値を EM アルゴリズムで求める。使う公式:def-em-main、prop-em-rate。
答え:第 1 区分を確率 $\frac12$ の部分と $\frac\theta4$ の部分に分けた度数を潜在変数とすると、反復は
$$
\theta^{(k+1)}=\frac{y_k+x_4}{y_k+x_2+x_3+x_4},\qquad y_k=\frac{x_1\theta^{(k)}}{2+\theta^{(k)}}
$$
となる。$\theta^{(0)}=0.5$ から $0.608247$、$0.624321$、$0.626489$、$0.626777$、… と進み、$\hat\theta=\frac{15+\sqrt{53809}}{394}\approx0.626821$ に収束する。誤差は毎回ほぼ $0.13278$ 倍になり、これは $1-I_{\mathrm{obs}}/I_{\mathrm{comp}}$($I_{\mathrm{obs}}\approx377.517$、$I_{\mathrm{comp}}\approx435.318$)に一致する。
途中の計算を開く
完全データの度数を $(x_{11},x_{12},x_2,x_3,x_4)$($x_{11}+x_{12}=x_1$、確率 $\frac12,\frac\theta4,\frac{1-\theta}4,\frac{1-\theta}4,\frac\theta4$)とすると、完全データの対数尤度は定数を除いて $(x_{12}+x_4)\log\theta+(x_2+x_3)\log(1-\theta)$。$x_1$ を固定したとき $x_{12}$ は試行回数 $x_1$、成功確率 $\frac{\theta/4}{1/2+\theta/4}=\frac\theta{2+\theta}$ の二項分布に従うので、E ステップは $x_{12}$ を期待値 $y_k$ に置き換えることで、M ステップは $(y_k+x_4)\log\theta+(x_2+x_3)\log(1-\theta)$ の最大化である。最尤推定値は観測の対数尤度 $125\log(2+\theta)+38\log(1-\theta)+34\log\theta$ の微分を $0$ と置いた $197\theta^2-15\theta-68=0$ の正の根。$I_{\mathrm{obs}}=\frac{125}{(2+\hat\theta)^2}+\frac{38}{(1-\hat\theta)^2}+\frac{34}{\hat\theta^2}$、$I_{\mathrm{comp}}=\frac{y+34}{\hat\theta^2}+\frac{38}{(1-\hat\theta)^2}$($y=125\hat\theta/(2+\hat\theta)$)。
表の出る確率が $a$ の硬貨 A と $b$ の硬貨 B がある。各回、公平に一方を選んで 10 回投げることを 5 回行い、表の回数 $h=(2,9,8,3,7)$ を得た。どちらの硬貨を使ったかは記録していない。使う公式:def-em-main、公式の表の二項分布の混合の行。
答え:初期値 $(a,b)=(0.6,0.5)$ から、1 回目の責任(硬貨 A である事後確率)は $(0.1946,0.8050,0.7335,0.2660,0.6472)$、更新は $(a,b)\approx(0.711584,0.432064)$。反復を続けると $(a,b)\approx(0.799980,0.254075)$ に収束し、対数尤度は $-14.1077$ から $-10.2128$ まで増える。
途中の計算を開く
責任は $\gamma_i=\frac{a^{h_i}(1-a)^{10-h_i}}{a^{h_i}(1-a)^{10-h_i}+b^{h_i}(1-b)^{10-h_i}}$(選ぶ確率 $\frac12$ と二項係数は約分される)。M ステップは $Q=\sum_i[\gamma_i(h_i\log a+(10-h_i)\log(1-a))+(1-\gamma_i)(h_i\log b+(10-h_i)\log(1-b))]$ の最大化で、$a'=\sum_i\gamma_ih_i/(10\sum_i\gamma_i)$、$b'$ も同様。対数尤度は $\sum_i\log\bigl(\frac12\binom{10}{h_i}(a^{h_i}(1-a)^{10-h_i}+b^{h_i}(1-b)^{10-h_i})\bigr)$。収束値は 2 変数の数値最適化の結果と 6 桁まで一致する。
9 個のデータ $-1.2,-0.5,0.1,0.4,0.9,3.6,4.1,4.4,5.3$ に 2 成分の正規混合を当てはめる。記号は公式の表の 2 行目のとおり($\pi$ は成分 2 の重み)で、初期値は $\pi=0.5$、$\mu=(0,1)$、$\sigma^2=(1,1)$。使う公式:prop-em-gmm、thm-em-monotone。
答え:対数尤度は $-36.4030$(初期値)、$-18.8293$(1 回後)と増え、10 回ほどで $\pi\approx0.444444$、$\mu\approx(-0.060000,\,4.350001)$、$\sigma^2\approx(0.530419,\,0.382501)$、$\ell\approx-15.44573$ に落ち着く。責任がほぼ $0$ と $1$ に分かれるので、これは左の 5 点と右の 4 点のそれぞれの平均・分散($-0.06$、$0.5304$ と $4.35$、$0.3825$)にほぼ等しい。
途中の計算を開く
1 回目の責任(成分 2 の事後確率)は $0.1545,0.2689,0.4013,0.4750,0.5987,0.9569,0.9734,0.9802,0.9918$ で、更新は $\pi\approx0.644524$、$\mu\approx(-0.110755,\,3.008995)$、$\sigma^2\approx(1.061269,\,4.126290)$。300 回の反復で対数尤度が一度も減らないことを確かめた値と、分散を $0.05$ 以上に制限した 200 個の初期値からの数値最適化の最良値は一致する。
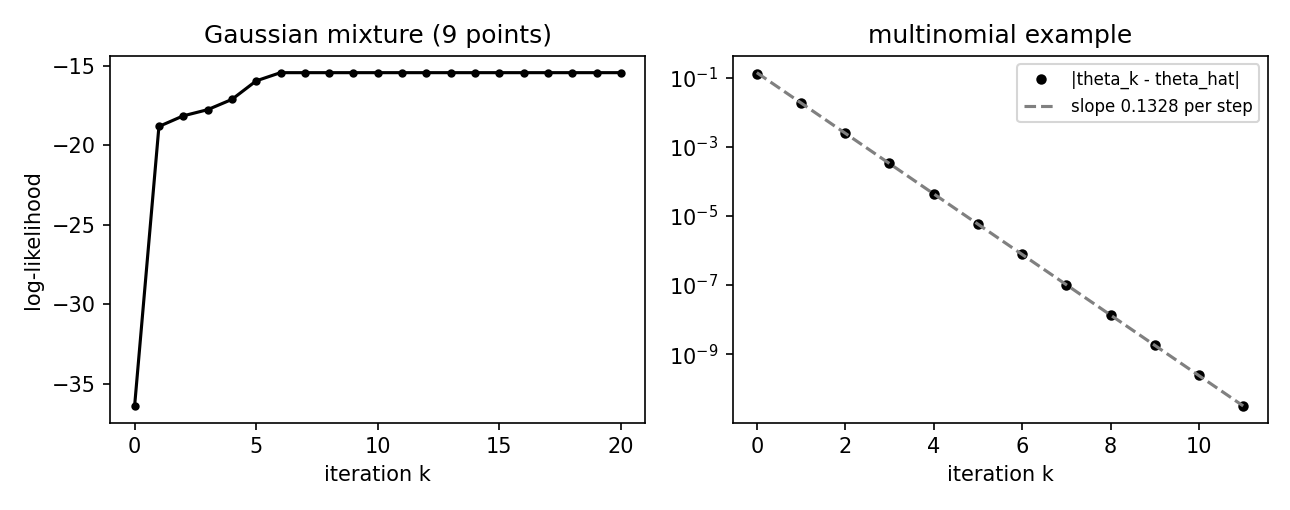 図: 左は例題 [ex-em-gmm] の対数尤度を反復の回数ごとに描いたもので、一度も減らずに約 -15.446 に落ち着く。右は例題 [ex-em-linkage] の誤差 |θ_k − θ̂| の片対数グラフで、点は傾き 0.1328 の直線に乗る(1 次収束)。
使える条件と反例
各行は主定理・命題の仮定か、反復が意味のある値に落ち着くための条件を 1 つだけ外す。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| (ii) M ステップで $Q$ を減らさない | ex-em-linkage で $\theta=0.5$ から $\theta'=0.3$ に動かす | $Q(0.3\mid0.5)< Q(0.5\mid0.5)$ で、対数尤度(多項係数を除いた $\sum_jx_j\log p_j$、$p_j$ は区分 $j$ の確率)も $-208.470$ から $-223.475$ に減る |
| (iii) $\theta$ は $\Theta$ の内点 | 成分を $N(0,1)$、$N(3,1)$ に固定し重み $p\in\Theta=[0,1]$ だけ推定、データ $2.5,3.2,2.9,3.8,0.2$、初期値 $p=0$ | 責任がすべて $0$ で $p=0$ が不動点だが、$\ell'(0)\approx1238.09\ne0$。$p=0.5$ からは $p\approx0.812885$ に収束する |
| 尤度が上に有界 | ex-em-gmm のデータで $\mu_1=x_1=-1.2$、$\sigma_1\to0$(ほかは $\pi=0.5$、$\mu_2=1.9$、$\sigma_2^2=79/15$(データの平均と、$n$ で割った分散)に固定) | $\ell\to+\infty$($\sigma_1=10^{-2}$ で $-20.14$、$10^{-6}$ で $-10.93$)。最尤推定値は存在せず、反復は退化した解に引き寄せられうる |
反例の確かめを開く
1 行目:定数を除いた $Q(\theta'\mid0.5)=(y+34)\log\theta'+38\log(1-\theta')$($y=125\cdot0.5/2.5=25$)で、$Q(0.5\mid0.5)\approx-67.235$、$Q(0.3\mid0.5)\approx-84.588$。2 行目:$p=0$ では $\gamma_i=0$ なので $p'=\frac15\sum_i\gamma_i=0$。$\ell'(0)=\sum_i(\varphi(y_i;3,1)-\varphi(y_i;0,1))/\varphi(y_i;0,1)$ で、$y_i=3.8$ の項が大きい。prop-em-stationary の証明は内点での最大を使うので、境界では使えない。3 行目:成分 1 の密度は $x_1$ で $\frac1{\sqrt{2\pi}\sigma_1}$ に比例して大きくなり、ほかの点では成分 2 の密度が正なので、対数尤度は $\log(1/\sigma_1)$ の速さで増える。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| EM の極限を最尤推定値とみなす | 尤度は増えるが、局所的な極大や鞍点に止まりうる。複数の初期値から比べる | 重みを $\frac12$、分散を $1$ に固定し平均 2 つを推定する混合で、データ $-2,-1.5,1.5,2$、初期値 $\mu_1=\mu_2=1$ だと $(0,0)$($\ell\approx-9.9258$、Hesse 行列の固有値 $-2$ と $4.25$ の鞍点)に止まる。$(-0.1,0.1)$ からは $(-1.7400,1.7400)$、$\ell\approx-6.5609$ |
| 母数の変化だけで収束を判定する | 対数尤度の変化と反復の上限も使う | 欠損情報の割合が $1$ に近いと 1 歩の変化は小さいが、極限は遠い(prop-em-rate) |
| 責任を密度の比のまま計算する | log-sum-exp で計算する | データが多いと密度の積が倍精度の範囲を下回る |
| 正規混合で分散に制限を置かない | 分散の下限か事前分布を置く | 反例の表の 3 行目 |
| 対数尤度が減ったのに続ける | 計算の誤りを探す | thm-em-monotone により正しい EM では減らない |
補足
EM アルゴリズムの名前と一般の形は Dempster・Laird・Rubin(1977)による。それ以前にも関連する仕事が多くあった(ESL17 Chapter 8 の Bibliographic Notes、p. 292)。thm-em-monotone の証明の下界 $F$ による見方は Neal と Hinton(1998)が明らかにした(同所)。隠れ Markov モデルの Baum–Welch アルゴリズムは EM アルゴリズムの特別な場合で、隠れMarkovモデル の定理「Baum–Welchの更新で尤度は減らない」が単調性を直接示している。
M ステップが閉じた形で解けないときは、$Q$ を 1 歩だけ増やす一般化 EM アルゴリズム(def-em-main)でも単調性は保たれる。収束が遅いときは、不動点の近くで Newton 法や加速法に切り替えることがある。
関連項目
- 前提: 最尤推定, Jensenの不等式
- 例: 隠れMarkovモデル, 正規分布
- 理論: Kullback–Leiblerダイバージェンス, Fisher情報量, 変分推論
- 比較: 勾配降下法
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

