交差検証
概要
交差検証(cross-validation)とは、データを分割し、一部で学習した予測を残りで採点することを分け方を替えて繰り返して予測の誤差を推定し、モデルや正則化の強さなどの母数を選ぶ方法である。観測が独立同分布で各分割の学習が残りのデータを見なければ、$K$ 分割の値の期待値は、大きさ $n-n/K$ のデータで学習したときの期待予測誤差に等しい。有界な損失では取り置いたデータでの選択の損を Hoeffding の不等式で抑えられ、罰則付き最小二乗では 1 個抜きの値が 1 回の当てはめから計算できる。一方、入れ子のモデルでは 1 個抜きが余分なモデルを一定の確率で選び続ける。
前提知識: 回帰分析, 期待値, Hoeffdingの不等式
11 個の点に多項式を当てはめるとき、次数を上げるほど当てはめの誤差(訓練誤差)は小さくなる。次数 $10$ ではすべての点を通り、訓練誤差は $0$ になる。しかし新しいデータを予測する力は、ある次数を超えると落ちていく。訓練誤差は、同じデータで学習し同じデータで採点するので、予測の誤差を小さく見積もる。
交差検証(cross-validation)は、データを分け、一部で学習して残りで採点することを、分け方を替えて繰り返し、予測の誤差を推定する方法である。推定した誤差が最小になるモデルや調整の母数(多項式の次数、正則化の強さ、近傍の数など)を選ぶのに使う。
この記事では、$K$ 分割と 1 個抜きの交差検証を定義し、交差検証の期待値がどの量に等しいかを主定理として証明する。取り置いた検証用のデータで候補を選んだときの誤差の上界、罰則付き最小二乗の 1 個抜きの公式、入れ子のモデルで 1 個抜きが大きいモデルを選び続けることも示す。
定義と使える条件
観測 $Z_i=(X_i,Y_i)$($i=1,\dots,n$)は、$\mathcal X\times\mathcal Y$ 上の同じ分布 $P$ に独立に従うとする。学習の手順 $\mathcal A$ は、有限個の観測の列 $d=(z_1,\dots,z_m)$ から予測の関数 $\hat f=\mathcal A(d)\colon\mathcal X\to\mathcal Y'$ を作る規則で、$(d,x)\mapsto\mathcal A(d)(x)$ は可測とする。損失 $L\colon\mathcal Y\times\mathcal Y'\to[0,\infty)$ は可測とする(2 乗損失 $(y-\hat y)^2$、分類の誤り $\mathbf 1[y\ne\hat y]$ など)。
$(X,Y)\sim P$ とし、予測の関数 $f$ の リスク を $R(f):=\mathrm E[L(Y,f(X))]$ と定める。大きさ $m$ の学習用データ $D_m$($P$ に独立に従う $m$ 個の観測)について
- 条件付きの予測誤差:$\mathrm{Err}(D_m):=R(\mathcal A(D_m))$。学習に使ったデータを固定した、その予測の関数の誤差である。
- 期待予測誤差:$\overline{\mathrm{Err}}_m:=\mathrm E\bigl[\mathrm{Err}(D_m)\bigr]$。学習用データの選ばれ方についても平均した誤差で、手順 $\mathcal A$ と大きさ $m$ だけで決まる。
$R(f)$ を計算するときの $(X,Y)$ は、$f$ を作るのに使った観測と独立にとる。
$\{1,\dots,n\}$ を空でない集合 $I_1,\dots,I_K$($K\ge2$)に分ける。分け方は観測によらずに決める(観測と独立な乱数で決めてもよい)。$D_{-k}$ を $I_k$ 以外の番号の観測の組とし、$\hat f^{-k}:=\mathcal A(D_{-k})$ とおく。
- $K$ 分割交差検証の推定値:
$$ \mathrm{CV}_K:=\frac1n\sum_{k=1}^K\sum_{i\in I_k}L\bigl(Y_i,\hat f^{-k}(X_i)\bigr). $$ - $K=n$(各 $I_k$ が 1 点)のとき 1 個抜き交差検証(leave-one-out)といい、$\mathrm{CV}_{\mathrm{loo}}$ と書く。
- 取り置き法(hold-out):大きさ $v$ の検証用の番号の集合 $V$ を 1 つだけとり、残りで学習した $\hat f$ について $\hat R:=\frac1v\sum_{i\in V}L(Y_i,\hat f(X_i))$ とする。
母数 $\lambda$ をもつ手順の族 $\mathcal A_\lambda$ では、$\lambda$ ごとに $\mathrm{CV}_K(\lambda)$ を計算し、最小にする $\hat\lambda$ を選んで、最後に全データで $\mathcal A_{\hat\lambda}$ を当てはめ直す。
使える条件は次のとおりである。
- (a) 独立同分布:観測が独立に同じ分布に従う。
- (b) 分割の外を見ない:$\hat f^{-k}$ は $D_{-k}$ だけから作る。変数の選択・前処理の母数・調整の母数の選択も、学習の手順の一部として各分割の中で行う。
- (c) 有界な損失:取り置き法の上界(thm-cv-holdout)では $0\le L\le B$。
- (d) 罰則付き最小二乗:1 個抜きの公式(prop-cv-loo)は、予測が prop-cv-loo の形の推定量で得られる場合に使う。
公式の表
| 量 | 公式 | 使える条件 | 根拠 |
|---|---|---|---|
| 交差検証の期待値 | $\mathrm E[\mathrm{CV}_K]=\sum_k\frac{\lvert I_k\rvert}{n}\overline{\mathrm{Err}}_{n-\lvert I_k\rvert}$ | (a)(b) | thm-cv-expect |
| 1 個抜きの期待値 | $\mathrm E[\mathrm{CV}_{\mathrm{loo}}]=\overline{\mathrm{Err}}_{n-1}$ | (a)(b) | thm-cv-expect |
| 取り置き法の誤差の幅 | $\lvert\hat R-R(\hat f)\rvert\le B\sqrt{\log(2/\delta)/(2v)}$(確率 $1-\delta$ 以上) | (a)(b)(c) | thm-cv-holdout |
| $M$ 個の候補からの選択 | $R(\hat f_{\hat\jmath})\le\min_jR(\hat f_j)+2B\sqrt{\log(2M/\delta)/(2v)}$ | (a)(b)(c) | thm-cv-holdout |
| 1 個抜きの残差 | $y_i-\hat y_i^{(-i)}=\dfrac{y_i-\hat y_i}{1-h_{ii}}$ | (d) | prop-cv-loo |
| 一般化交差検証 | $\mathrm{GCV}=\dfrac{\frac1n\sum_i(y_i-\hat y_i)^2}{(1-\operatorname{tr}H/n)^2}$ | (d) | 定義 |
| 入れ子の 2 つのモデル | 1 個抜きが大きいモデルを選ぶ確率 $\to P(\chi^2_1>2)\approx0.1573$ | 正規分布、小さいモデルが正しい | prop-cv-nested |
主定理と証明
交差検証の値は、全データで学習した予測の誤差 $\mathrm{Err}(D_n)$ を推定しているように見える。しかし実際に期待値として一致するのは、学習用データが少し小さい場合の期待予測誤差である。
条件 (a)(b) のもとで、def-cv-main の $\mathrm{CV}_K$ について
$$
\mathrm E[\mathrm{CV}_K]=\sum_{k=1}^K\frac{\lvert I_k\rvert}{n}\,\overline{\mathrm{Err}}_{n-\lvert I_k\rvert}
$$
が成り立つ(両辺が $+\infty$ の場合も含む)。とくに各 $I_k$ の大きさが $m=n/K$ なら $\mathrm E[\mathrm{CV}_K]=\overline{\mathrm{Err}}_{n-m}$ であり、$\mathrm E[\mathrm{CV}_{\mathrm{loo}}]=\overline{\mathrm{Err}}_{n-1}$ である。取り置き法では $\mathrm E[\hat R]=\overline{\mathrm{Err}}_{n-v}$ である。
分け方が観測と独立な乱数で決まる場合は、分け方を固定した条件付き期待値について示し、最後に分け方について平均すればよい。そこで分け方は固定する。
$k$ と $i\in I_k$ を固定する。$D_{-k}$ は $I_k$ 以外の番号の観測からなるので、$Z_i$ と $D_{-k}$ は独立である。関数
$$
g(d):=\mathrm E\bigl[L(Y,\mathcal A(d)(X))\bigr]=R(\mathcal A(d))\qquad((X,Y)\sim P)
$$
を考える。被積分関数 $L(y,\mathcal A(d)(x))$ は $(d,x,y)$ について可測で $0$ 以上なので、独立な 2 つの確率変数の関数の期待値に Fubini の定理を使って、
$$
\mathrm E\bigl[L(Y_i,\hat f^{-k}(X_i))\bigr]=\mathrm E\bigl[g(D_{-k})\bigr]
$$
を得る。$Z_i$ の分布が $P$ であることを使った。$D_{-k}$ は $P$ に独立に従う $n-\lvert I_k\rvert$ 個の観測なので、def-cv-risk の 2 により $\mathrm E[g(D_{-k})]=\overline{\mathrm{Err}}_{n-\lvert I_k\rvert}$ である。
$\mathrm{CV}_K$ は $0$ 以上の項の和なので、期待値は項ごとにとれる。$I_k$ の $\lvert I_k\rvert$ 個の項がどれも $\overline{\mathrm{Err}}_{n-\lvert I_k\rvert}$ を与えるので、
$$
\mathrm E[\mathrm{CV}_K]=\frac1n\sum_{k=1}^K\lvert I_k\rvert\,\overline{\mathrm{Err}}_{n-\lvert I_k\rvert}
$$
である。大きさが等しい場合と 1 個抜きは、その特別な場合である。取り置き法は、ただ 1 つの集合 $V$ について同じ計算をすればよい。$\square$
この定理から 3 つのことが分かる。第一に、交差検証が推定するのは $\overline{\mathrm{Err}}_{n-m}$ であって、全データで学習したときの $\overline{\mathrm{Err}}_n$ ではない。学習用データが大きいほど誤差が小さくなる手順では、$K$ が小さいほど交差検証は誤差を大きく見積もる(ex-cv-kfold)。第二に、期待値は学習用データの選ばれ方について平均したものなので、手元のデータで学習した予測の誤差 $\mathrm{Err}(D_n)$ を推定するとは限らない(ESL17 §7.10.1、p. 242)。第三に、証明で使ったのは $Z_i$ と $D_{-k}$ の独立性だけである。変数の選択を全データで済ませてから分けると、$\hat f^{-k}$ が $Z_i$ に依存し、この等式が成り立たない(反例の表の 2 行目)。
各項の期待値が分かっても、$\mathrm{CV}_K$ の分散は簡単には求まらない。異なる分割の項は同じ観測を学習に使うので独立でない。
取り置いたデータでの選択
候補の予測の関数が検証用のデータと独立に作られているなら、検証用データでの平均は独立な有界の確率変数の平均であり、Hoeffdingの不等式 がそのまま使える。
条件 (a)(c) を仮定する。観測を学習用の部分 $D_T$(大きさ $n-v$)と検証用の部分 $D_V$(大きさ $v$)に分け、$D_T$ だけから予測の関数 $\hat f_1,\dots,\hat f_M$ を作る。$\hat R_j:=\frac1v\sum_{i\in V}L(Y_i,\hat f_j(X_i))$ とし、$\hat\jmath$ を $\hat R_j$ が最小の番号(複数あれば最小の番号)とする。$0< \delta< 1$ について $\varepsilon:=B\sqrt{\log(2M/\delta)/(2v)}$ とおくと、確率 $1-\delta$ 以上で
- すべての $j$ について $\lvert\hat R_j-R(\hat f_j)\rvert< \varepsilon$、
- $R(\hat f_{\hat\jmath})< \min_jR(\hat f_j)+2\varepsilon$
が成り立つ。$M=1$ なら 1 は取り置き法の推定値の誤差の幅を与える。
$D_T$ の値 $d_T$ を固定し、$f_j:=\mathcal A_j(d_T)$ とする。$D_V$ は $D_T$ と独立なので、$D_V$ の観測は $D_T=d_T$ のもとでも独立に $P$ に従う。したがって $W_i:=L(Y_i,f_j(X_i))$($i\in V$)は独立で、$[0,B]$ に値をとり、平均は $R(f_j)$ である。Hoeffdingの不等式 の系「標本平均のずれ」により
$$
P\bigl(\lvert\hat R_j-R(f_j)\rvert\ge\varepsilon\bigr)\le2\exp\Bigl(-\frac{2v\varepsilon^2}{B^2}\Bigr)=\frac\delta M
$$
である。$M$ 個の事象の和集合の確率は和以下なので、1 が成り立たない確率は $\delta$ 以下である。この評価は $d_T$ によらないので、$D_T$ の分布について平均しても(Fubini の定理)確率 $\delta$ 以下である。
1 が成り立つとき、$j^*$ を $R(\hat f_j)$ が最小の番号とすると、$\hat\jmath$ の選び方から $\hat R_{\hat\jmath}\le\hat R_{j^*}$ なので
$$
R(\hat f_{\hat\jmath})< \hat R_{\hat\jmath}+\varepsilon\le\hat R_{j^*}+\varepsilon< R(\hat f_{j^*})+2\varepsilon
$$
であり、2 が成り立つ。$\square$
幅 $\varepsilon$ は候補の数 $M$ に $\sqrt{\log M}$ でしか依存しないので、検証用のデータが数千あれば、数十の候補から選んでも選択の損は小さい(ex-cv-holdout)。一方、選んだ候補の $\hat R_{\hat\jmath}$ は最小値をとったものなので、そのまま報告すると誤差を小さく見積もりがちである。選んだモデルの誤差は、選択に使っていない別のデータで測る。
1 個抜きの公式
1 個抜きは $n$ 回の当てはめを要するが、最小二乗とその罰則付きの形では 1 回の当てはめから計算できる。
$X$ を $n\times p$ 実行列(第 $i$ 行を $x_i^{\top}$)、$\Omega$ を $p$ 次の半正定値対称行列、$\lambda\ge0$、$y\in\mathbb R^n$ とし、$A:=X^{\top}X+\lambda\Omega$ とおく。$i$ を固定し、$A-x_ix_i^{\top}$ が正定値であるとする。
$$
\hat\beta:=A^{-1}X^{\top}y,\qquad \hat\beta^{(-i)}:=(A-x_ix_i^{\top})^{-1}(X^{\top}y-x_iy_i)
$$
はそれぞれ $\sum_j(y_j-x_j^{\top}\beta)^2+\lambda\beta^{\top}\Omega\beta$ と、その和から $j=i$ を除いたものを最小にするただ 1 つの $\beta$ である。$H:=XA^{-1}X^{\top}$、$\hat y:=X\hat\beta=Hy$ とおくと、$h_{ii}< 1$ であり
$$
y_i-x_i^{\top}\hat\beta^{(-i)}=\frac{y_i-\hat y_i}{1-h_{ii}}
$$
が成り立つ。
$A\succeq A-x_ix_i^{\top}$ なので $A$ も正定値である。最小にする問題の目的関数は $\beta$ の 2 次式で、2 次の部分の行列はそれぞれ $A$ と $A-x_ix_i^{\top}$ なので、勾配を $0$ とおいた正規方程式の解がただ 1 つの最小点であり、それが上の式である。
Sherman–Morrisonの公式 の補題「行列式の補題」により $\det(A-x_ix_i^{\top})=\det A\,(1-x_i^{\top}A^{-1}x_i)$ で、左辺と $\det A$ は正なので $h_{ii}=x_i^{\top}A^{-1}x_i< 1$ である。同じ記事の定理「Sherman–Morrisonの公式」を $u=-x_i$、$v=x_i$ で使うと
$$
(A-x_ix_i^{\top})^{-1}=A^{-1}+\frac{A^{-1}x_ix_i^{\top}A^{-1}}{1-h_{ii}}
$$
なので、$x_i^{\top}(A-x_ix_i^{\top})^{-1}=x_i^{\top}A^{-1}\bigl(1+\frac{h_{ii}}{1-h_{ii}}\bigr)=\frac{x_i^{\top}A^{-1}}{1-h_{ii}}$ である。$x_i^{\top}A^{-1}X^{\top}y=\hat y_i$ と $x_i^{\top}A^{-1}x_i=h_{ii}$ から
$$
x_i^{\top}\hat\beta^{(-i)}=\frac{\hat y_i-h_{ii}y_i}{1-h_{ii}},\qquad y_i-x_i^{\top}\hat\beta^{(-i)}=\frac{(1-h_{ii})y_i-\hat y_i+h_{ii}y_i}{1-h_{ii}}=\frac{y_i-\hat y_i}{1-h_{ii}}
$$
である。$\square$
$\lambda=0$ は通常の最小二乗で、$H$ は 回帰分析 のハット行列である。$\Omega=I$ はリッジ回帰(Tikhonov正則化)である。平滑化スプラインでは 平滑化スプライン の命題「1 個抜きの公式」、Nadaraya–Watson 推定量では ノンパラメトリック回帰 の命題「1 個抜きの公式」が同じ形の公式を与える。$h_{ii}$ を平均 $\operatorname{tr}H/n$ で置き換えたものが一般化交差検証 GCV である(ESL17 式 (7.51)・(7.52)、p. 244)。$\operatorname{tr}H$ は有効な母数の数で、$1/(1-u)^2\approx1+2u$ から GCV は残差の 2 乗の平均に $1+2\operatorname{tr}H/n$ を掛けた量に近く、赤池情報量規準 と同じ形の罰則になる(ESL17 p. 245)。
入れ子のモデルでの選択
交差検証は予測の誤差の推定には向くが、正しいモデルを当てる目的には向かない。最も簡単な入れ子のモデルで、それを直接示す。
$Y_1,\dots,Y_n$($n\ge2$)が独立に $N(\mu,1)$ に従うとし、2 乗損失で次の 2 つの手順を比べる。$M_0$ は常に $0$ を予測し、$M_1$ は学習用データの平均を予測する。$\bar Y$ を平均、$S^2:=\frac1{n-1}\sum_i(Y_i-\bar Y)^2$、$T:=\sqrt n\,\bar Y/S$ とする。
- $M_1$ の 1 個抜きの値が $M_0$ の値より小さいことは、$T^2>\dfrac{2n-1}{n-1}$ と同値である。
- $\mu=0$($M_0$ が正しい)なら、$M_1$ を選ぶ確率は $P\bigl(F_{1,n-1}>\frac{2n-1}{n-1}\bigr)$ で、$n\to\infty$ で $P(\chi^2_1>2)\approx0.15730$ に収束する。
- $\mu\ne0$ なら、$M_1$ を選ぶ確率は $1$ に収束する。
1。 $i$ を除いた平均は $\bar Y^{(-i)}=\frac{n\bar Y-Y_i}{n-1}$ なので $Y_i-\bar Y^{(-i)}=\frac n{n-1}(Y_i-\bar Y)$ である。$S_c:=\sum_i(Y_i-\bar Y)^2$ とおくと、2 つの 1 個抜きの値は
$$
\mathrm{CV}_1=\frac1n\Bigl(\frac n{n-1}\Bigr)^2S_c,\qquad \mathrm{CV}_0=\frac1n\sum_iY_i^2=\frac1n\bigl(S_c+n\bar Y^2\bigr)
$$
である。$\mathrm{CV}_1< \mathrm{CV}_0$ は $S_c\bigl(\frac{n^2}{(n-1)^2}-1\bigr)< n\bar Y^2$、すなわち $S_c\frac{2n-1}{(n-1)^2}< n\bar Y^2$ と同値で、両辺を $S^2=S_c/(n-1)$ で割れば $T^2>\frac{2n-1}{n-1}$ である($S>0$ は確率 $1$ で成り立つ)。
2。 $\mu=0$ なら $T$ は自由度 $n-1$ の $t$ 分布に従い(t分布 の定理「Student の定理」)、$T^2$ は $F_{1,n-1}$ に従う。$T^2=n\bar Y^2/S^2$ で、$n\bar Y^2\sim\chi^2_1$、大数の法則 により $S^2\to1$(概収束)なので、$T^2$ は $\chi^2_1$ に分布収束する。境目 $\frac{2n-1}{n-1}$ は $2$ に収束し、$\chi^2_1$ の分布関数は連続なので、確率は $P(\chi^2_1>2)$ に収束する。
3。 大数の法則 により $\bar Y\to\mu\ne0$、$S^2\to1$ なので $T^2=n\bar Y^2/S^2\to\infty$(概収束)であり、境目は有界なので確率は $1$ に収束する。$\square$
$M_0$ が正しくても、1 個抜きは $n$ によらずおよそ $16\%$ の確率で余分な母数をもつ $M_1$ を選ぶ。これは $\lvert T\rvert>\sqrt2$ を棄却の境目にした検定に当たり、水準が $0$ に近づかない。一般の線形回帰の変数選択でも、学習用データの大きさ $n_t$ について $n_t/n$ の下極限が正なら(1 個抜きは $n_t=n-1$)、1 個抜きなどの交差検証は余分な変数を選ぶ確率が $0$ に近づかず、$n_t/n\to0$、$n_t\to\infty$ とすると正しい変数の組を選ぶ確率が $1$ に近づくことが Shao(1993)によって示された(AC10 §7.1。この記事では証明しない)。予測の誤差の推定と真のモデルの特定は、目的として両立しにくい。
計算の手順
- 損失と候補を決める。 回帰なら 2 乗損失、分類なら誤り率か対数損失。母数の候補の格子(次数 $0,1,\dots$、$\lambda=10^{-4},10^{-3},\dots$)を作る。
- 分け方を決める。 $K=5$ か $10$ が標準的である(ESL17 p. 243)。分類では各分割の群の割合をそろえる(層化)。観測と独立な乱数で分け、種を記録する。
- 各分割で手順全体をやり直す。 前処理・変数の選択・母数の推定を $D_{-k}$ だけで行い、$I_k$ で採点する。
- 曲線を作って選ぶ。 候補ごとに $\mathrm{CV}_K$ を出し、最小の候補を選ぶ。最小値から各分割の誤差の標準誤差 1 つ分以内で最も単純な候補を選ぶ「標準誤差 1 つの規則」もある(ESL17 p. 244)。
- 全データで当てはめ直す。 選んだ母数で全データを学習する。誤差の報告は、選択に使っていない別のデータで行う。選択と評価の両方を交差検証で行うときは、外側の分割の中で内側の交差検証をやり直す(入れ子の交差検証)。
- 罰則付き最小二乗なら近道を使う。 1 個抜きは prop-cv-loo で 1 回の当てはめから計算する。
例題
$x_i=(i-1)/10$($i=1,\dots,11$)で、$y=(0.06,0.37,0.64,0.98,0.99,1.04,0.84,0.66,0.67,0.16,-0.07)$ とする。次数 $d=0,\dots,6$ の多項式を最小二乗で当てはめ、2 乗損失の 1 個抜きで $d$ を選ぶ。
使う公式:prop-cv-loo($\lambda=0$)。
答え:
| $d$ | $0$ | $1$ | $2$ | $3$ | $4$ | $5$ | $6$ |
|---|---|---|---|---|---|---|---|
| 訓練誤差 | $0.13988$ | $0.13591$ | $0.00619$ | $0.00539$ | $0.00518$ | $0.00455$ | $0.00404$ |
| 1 個抜き | $0.16925$ | $0.23390$ | $0.01116$ | $0.01420$ | $0.01946$ | $0.09854$ | $0.70143$ |
| GCV | $0.16925$ | $0.20303$ | $0.01171$ | $0.01331$ | $0.01740$ | $0.02200$ | $0.03057$ |
訓練誤差は $d$ とともに減るが、1 個抜きは $d=2$ で最小 $0.01116$ をとり、$d=2$ を選ぶ。データは $\sin\pi x$ に標準偏差 $0.1$ の正規分布の誤差を加えて作ったもので、$x$ が $[0,1]$ の一様分布に従う新しい点での予測誤差($0.01+\int_0^1(\hat f-\sin\pi x)^2dx$)も $d=2$ で最小 $0.01367$ になる。1 個抜きの値は、11 回の当てはめ直しで計算した値と一致する。
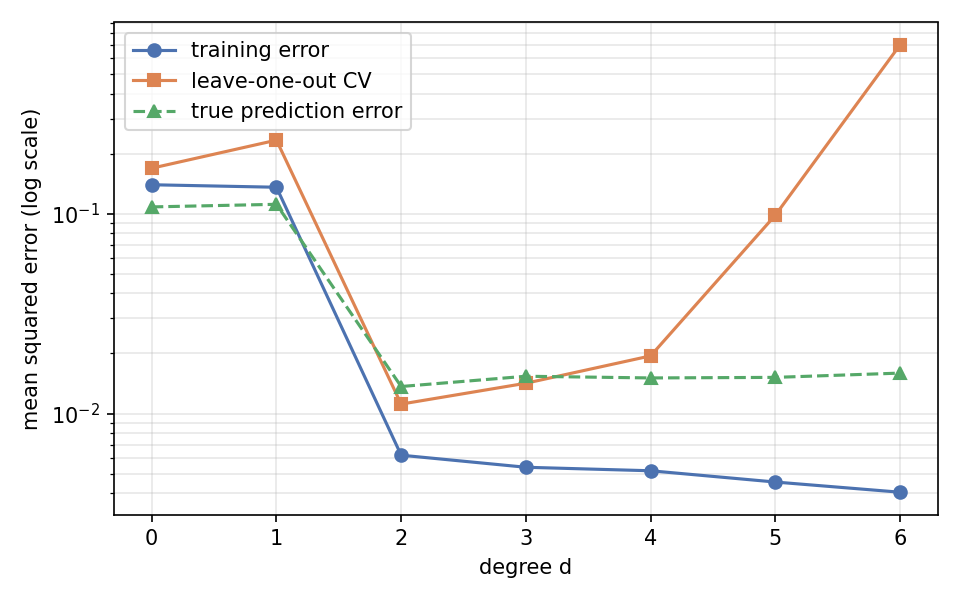 図:例題の多項式の次数 d(0 から 6)ごとの、訓練誤差(減り続ける)、1 個抜き交差検証(d=2 で最小で、d=5,6 で急に増える)、真の予測誤差(d=2 で最小)。縦軸は対数目盛
$y=(3,5,4,8,6,10)$ を、学習用データの平均で予測する手順を 2 乗損失で評価する。分割は $\{1,2\},\{3,4\},\{5,6\}$ とする。
使う公式:def-cv-main、prop-cv-loo($X$ が $1$ だけの列、$\lambda=0$ で $h_{ii}=1/n$)。
答え:3 分割では各分割を除いた平均が $7,6,5$ で、$\mathrm{CV}_3=\frac16(16+4+4+4+1+25)=9$。1 個抜きは $\frac16(\frac65)^2\sum_i(y_i-6)^2=\frac16\cdot1.44\cdot34=8.16$。訓練誤差は $34/6\approx5.66667$ である。
一般に、分散 $\sigma^2$ の分布から $m$ 個で学習した平均の 2 乗損失の期待予測誤差は $\overline{\mathrm{Err}}_m=\sigma^2(1+1/m)$ である。$n=10$ なら thm-cv-expect により $\mathrm E[\mathrm{CV}_2]=1.2\sigma^2$、$\mathrm E[\mathrm{CV}_5]=1.125\sigma^2$、$\mathrm E[\mathrm{CV}_{\mathrm{loo}}]=1.11111\sigma^2$ で、全データの $\overline{\mathrm{Err}}_{10}=1.1\sigma^2$ に $K$ が大きいほど近い。
prop-cv-nested で $\mu=0$ とする。
使う公式:prop-cv-nested の 2。
答え:$M_1$ を選ぶ確率は $n=10$ で $P(F_{1,9}>19/9)\approx0.18019$、$n=100$ で $P(F_{1,99}>199/99)\approx0.15940$、$n=1000$ で $0.15751$、極限は $0.15730$ である。乱数の種 $20261108$ で 20 万回の模擬を行うと、$n=10$ で $0.17895$、$n=100$ で $0.15956$ であった。
誤り率($B=1$)で $M=20$ 個の分類器から取り置き法で選ぶ。$\delta=0.05$ とする。
使う公式:thm-cv-holdout の 2。
答え:$v=1000$ なら $2\varepsilon=2\sqrt{\log800/2000}\approx0.11563$ で、選んだ分類器の誤り率は確率 $0.95$ 以上で最良のものより $0.116$ 未満しか悪くない。$2\varepsilon\le0.05$ にするには $v\ge2\log800/0.05^2$、すなわち $v\ge5348$ が要る。
使える条件と反例
各行は 1 つの条件だけを外す。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| (a) 独立性 | $x$ と独立に確率 $1/2$ でラベルが決まる 20 点を、それぞれ 2 回ずつ記録した 40 点に 1 近傍法を当てる | 1 個抜きの誤り率は $0$ だが、どの分類器の真の誤り率も $1/2$ である。thm-cv-expect の証明の独立性が成り立たない |
| (b) 分割の外を見ない | $n=50$(各群 25)、ラベルと独立な標準正規分布の説明変数 $p=1000$ 個。相関の大きい 20 個を全データで選んでから、最近重心法を 5 分割で評価する | 交差検証の誤り率の平均は $0.0764$ で、真の誤り率 $0.5$ を大きく下回る。選択を分割の中で行うと $0.5104$ |
| (d) 罰則付き最小二乗 | $x=(0,1,3,4)$、$y=(1,2,6,3)$ に、自分を含む 2 近傍の平均($h_{ii}=1/2$)を当てる | $\frac{y_i-\hat y_i}{1-h_{ii}}$ で計算した値は $5$ だが、実際の 1 個抜きの値は $6.125$ |
確かめを開く
1 行目:各点には同じ $x$ をもつ写しがちょうど 1 つあり、それが最も近い点なので、1 近傍法の予測は写しのラベルに等しく、誤りは起きない。ラベルが $X$ と独立で確率 $1/2$ なら、どの $f$ についても $P(Y\ne f(X))=1/2$ である。抜いた点の写しが学習用データに残っているので、$Z_i$ と $D_{-i}$ は独立でない。
2 行目:種 $20261108$、50 回の模擬。誤った手順では、選ばれた 20 変数は検証用の点も含めた全データでラベルと相関が大きくなるように選ばれているので、検証用の点の予測が当たりやすい。正しい手順の標準偏差は $0.0744$ で、平均 $0.5104$ は $0.5$ と矛盾しない(ESL17 §7.10.2、pp. 245–247 に同じ型の例がある)。
3 行目:自分を含めた当てはめは $\hat y=(1.5,1.5,4.5,4.5)$ で、公式の値は $(-1,1,3,-3)$、平均 2 乗は $5$。1 点を除いて残りの 2 近傍の平均で予測すると、残差は $(-3,-1.5,3.5,-1)$、平均 2 乗は $6.125$。1 点を除くと近傍の組そのものが変わるので、除いた点の重みを残りに配り直した形にならない。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 変数の選択や前処理を全データで行ってから交差検証する | 選択も含めて各分割の中でやり直す | 反例の表の 2 行目 |
| 交差検証の最小値を、選んだモデルの誤差として報告する | 最小値は小さめに偏る。選択に使わないデータで測るか入れ子にする | thm-cv-holdout の後の段落 |
| $\mathrm{CV}_K$ を全データで学習した予測の誤差の推定値とみなす | 期待値は大きさ $n-n/K$ の学習の誤差。$K$ が小さいと大きめに出る | thm-cv-expect、ex-cv-kfold |
| 1 個抜きで真のモデルを当てられると考える | 余分な母数を一定の確率で選び続ける | prop-cv-nested |
| 時系列や同じ対象の繰り返し測定を、ばらばらに分割する | 時間や対象のまとまりごとに分ける | 反例の表の 1 行目 |
| 1 個抜きの公式を任意の手順に使う | 罰則付き最小二乗の形の推定量に限る | 反例の表の 3 行目 |
補足
関連項目
- 前提: 回帰分析, 期待値, Hoeffdingの不等式
- 比較: 赤池情報量規準, ブートストラップ法, ジャックナイフ法
- 発展: 平滑化スプライン, ノンパラメトリック回帰, Tikhonov正則化, 統計的学習理論
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

