回帰分析
概要
回帰分析(regression analysis)とは、目的の量 $y$ が説明変数によってどう変わるかをデータから推し量る統計の方法であり、線形回帰では $y=X\beta+\varepsilon$ の係数 $\beta$ を最小二乗法で推定する。誤差が独立に同じ正規分布に従うとき、推定量 $\hat\beta$ は正規分布に従い、残差平方和は $\hat\beta$ と独立に自由度 $n-p$ のカイ二乗分布に従う。ここから係数の $t$ 検定と信頼区間、入れ子のモデルの $F$ 検定、予測区間が得られ、切片を含むモデルでは平方和の分解から決定係数が定まる。
回帰分析(regression analysis)は、目的の量 $y$ が説明のための量 $x_1,\dots,x_k$ によってどう変わるかを、データから推し量る統計の方法である。もっとも基本的な 線形回帰 では、$y$ の期待値が係数について 1 次の式 $\beta_1+\beta_2x+\cdots$ で書けると仮定し、係数を 最小二乗法 で推定する。
回帰分析では、観測の誤差に確率のモデルを置き、次の問いに答える。
- 推定した係数はどれくらい確かか(標準誤差と信頼区間)。
- 係数が $0$ かどうか、つまりその説明変数が本当に効いているか($t$ 検定)。
- 説明変数のいくつかをまとめて外してよいか($F$ 検定)。
- 当てはまりはどの程度か(決定係数)。新しい $x$ での $y$ はどの範囲に入るか(予測区間)。
どれも一つの定理から出る。誤差が独立に同じ正規分布に従うとき、係数の推定量は正規分布に従い、残差平方和は推定量と独立にカイ二乗分布に従う(thm-reg-sampling)。鍵は、当てはめが正射影であることである。
定義と使える条件
$n$ 組のデータ $(x_{i1},\dots,x_{ip};\ y_i)$($i=1,\dots,n$)を考える。$x_{ij}$ を並べた $n\times p$ 行列 $X=(x_{ij})$ を 計画行列、$y=(y_1,\dots,y_n)^{\top}$ を 目的変数 のベクトルという。切片を入れるときは $X$ の第 1 列をすべて $1$ にする。単回帰(説明変数が一つ)は $X$ の第 $i$ 行が $(1,x_i)$ の場合である。
未知の係数 $\beta\in\mathbb{R}^p$ と、確率変数を成分とする誤差 $\varepsilon\in\mathbb{R}^n$ によって
$$
y=X\beta+\varepsilon
$$
と書けるとし、次の条件を考える。
- $X$ は確率変数でない既知の $n\times p$ 実行列で、列は 1 次独立($\operatorname{rank}X=p$)であり、$n>p$ である。
- $E[\varepsilon]=0$ である。
- $\operatorname{Cov}(\varepsilon)=\sigma^2I_n$($\sigma>0$ は未知の定数)である。すなわち誤差は無相関で分散が等しい。
- $\varepsilon$ は(多変量正規分布 の意味で)多変量正規分布に従う。
1〜3 を満たすものを 線形回帰モデル、1〜4 を満たすものを 正規線形回帰モデル という。2〜4 をあわせると $\varepsilon\sim N_n(0,\sigma^2I_n)$、すなわち誤差は独立に同じ正規分布 $N(0,\sigma^2)$ に従う(多変量正規分布 の定理「無相関なら独立」)。
線形回帰モデルについて次のように定める。$V:=(X^{\top}X)^{-1}$、その第 $j$ 対角成分を $v_j$ とする。
- 係数の 最小二乗推定量 $\hat\beta:=VX^{\top}y$、ハット行列 $H:=XVX^{\top}$。
- 当てはめ値 $\hat y:=X\hat\beta=Hy$、残差 $e:=y-\hat y=(I_n-H)y$、残差平方和 $\mathrm{RSS}:=\lvert e\rvert^2$。
- 誤差の分散の推定量 $\hat\sigma^2:=\mathrm{RSS}/(n-p)$、$\hat\beta_j$ の 標準誤差 $\mathrm{se}_j:=\hat\sigma\sqrt{v_j}$。
- $X$ の列の張る空間が $\mathbf 1:=(1,\dots,1)^{\top}$ を含むとき、$\bar y:=\frac1n\sum_iy_i$、全平方和 $\mathrm{TSS}:=\sum_i(y_i-\bar y)^2$、回帰平方和 $\mathrm{ESS}:=\sum_i(\hat y_i-\bar y)^2$、決定係数 $R^2:=1-\mathrm{RSS}/\mathrm{TSS}$($\mathrm{TSS}>0$ のとき)。
最小二乗法 の定理「最小二乗解と正規方程式」により、$\hat\beta$ は $\lvert y-Xb\rvert^2$ を最小にするただ一つの $b$ であり、$H$ は $X$ の列空間 $\operatorname{Im}X$ への正射影の行列である。正射影と射影行列 の定理「射影行列は対称で冪等な行列」と定理「射影行列の固有値・対角化・トレース」により、$H$ と $I_n-H$ は対称で冪等、階数(=トレース)はそれぞれ $p$ と $n-p$ である。
検定と区間推定に使う分布を一つ定めておく。
$a,b$ を正の整数とし、$U\sim\chi^2_a$ と $W\sim\chi^2_b$ が独立であるとする。$\dfrac{U/a}{W/b}$ の分布を 自由度 $(a,b)$ の $F$ 分布 といい、$F_{a,b}$ と書く。$0<\alpha<1$ について、$P(T>c)=\alpha$ となる $c$ を、$T\sim t_\nu$ なら $t_\nu(\alpha)$、$T\sim F_{a,b}$ なら $F_{a,b}(\alpha)$ と書き、上側 $100\alpha\%$ 点 という。
$T\sim t_b$ なら、t分布 の定理「$t$ 分布の密度」により $T$ は $Z/\sqrt{W/b}$($Z\sim N(0,1)$ と $W\sim\chi^2_b$ が独立)と同じ分布に従い、$Z^2\sim\chi^2_1$ なので $T^2\sim F_{1,b}$ である。とくに $F_{1,b}(\alpha)=t_b(\alpha/2)^2$ である。
公式の表
正規線形回帰モデル(def-reg-model の 1〜4)のもとでの公式である。「条件」の列は、必要な条件の番号である。
| 量 | 公式・分布 | 条件 | 根拠 |
|---|---|---|---|
| 係数の推定量 | $\hat\beta=(X^{\top}X)^{-1}X^{\top}y$ | 1 | 最小二乗法 |
| 平均と共分散 | $E[\hat\beta]=\beta$、$\operatorname{Cov}(\hat\beta)=\sigma^2(X^{\top}X)^{-1}$ | 1〜3 | 最小二乗法(Gauss–Markov の定理) |
| 分散の推定 | $E[\hat\sigma^2]=\sigma^2$ | 1〜3 | 最小二乗法(誤差の分散の不偏推定) |
| 係数の分布 | $\hat\beta\sim N_p(\beta,\sigma^2(X^{\top}X)^{-1})$ | 1〜4 | thm-reg-sampling |
| 残差平方和の分布 | $\mathrm{RSS}/\sigma^2\sim\chi^2_{n-p}$、$\hat\beta$ と独立 | 1〜4 | thm-reg-sampling |
| $t$ 統計量 | $(\hat\beta_j-\beta_j)/\mathrm{se}_j\sim t_{n-p}$ | 1〜4 | thm-reg-sampling |
| 係数の信頼区間(係数 $1-\alpha$) | $\hat\beta_j\pm t_{n-p}(\alpha/2)\,\mathrm{se}_j$ | 1〜4 | cor-reg-intervals |
| 予測区間($x_0$ での新しい観測) | $x_0^{\top}\hat\beta\pm t_{n-p}(\alpha/2)\,\hat\sigma\sqrt{1+x_0^{\top}(X^{\top}X)^{-1}x_0}$ | 1〜4 | cor-reg-intervals |
| 平方和の分解 | $\mathrm{TSS}=\mathrm{ESS}+\mathrm{RSS}$、$0\le R^2\le1$ | 1、切片 | thm-reg-anova |
| 入れ子のモデルの $F$ 統計量 | $\dfrac{(\mathrm{RSS}_0-\mathrm{RSS})/(p-p_0)}{\mathrm{RSS}/(n-p)}\sim F_{p-p_0,\,n-p}$ | 1〜4、小さいモデルが正しい | thm-reg-f |
| 単回帰の傾き | $\hat\beta_2=S_{xy}/S_{xx}$、$\mathrm{se}_2=\hat\sigma/\sqrt{S_{xx}}$ | 1 | 散布図と回帰直線、ex-reg-simple |
単回帰では $S_{xx}:=\sum_i(x_i-\bar x)^2$、$S_{xy}:=\sum_i(x_i-\bar x)(y_i-\bar y)$ である。
主定理と証明
推定量と残差平方和の分布
正規線形回帰モデル(def-reg-model の 1〜4)について、次が成り立つ。
- $\hat\beta\sim N_p\bigl(\beta,\ \sigma^2(X^{\top}X)^{-1}\bigr)$ である。
- $\mathrm{RSS}/\sigma^2\sim\chi^2_{n-p}$ である。
- $\hat\beta$ と $\mathrm{RSS}$ は独立である。
- $0$ でない $c\in\mathbb{R}^p$ について
$$ T_c:=\frac{c^{\top}\hat\beta-c^{\top}\beta}{\hat\sigma\sqrt{c^{\top}(X^{\top}X)^{-1}c}}\sim t_{n-p} $$
である。とくに $c$ を第 $j$ 単位ベクトルとすれば $(\hat\beta_j-\beta_j)/\mathrm{se}_j\sim t_{n-p}$ である。
$V:=(X^{\top}X)^{-1}$、$L:=VX^{\top}$ とおく。$LX=I_p$ なので $\hat\beta=Ly=\beta+L\varepsilon$ である。また $HX=X$ から $(I_n-H)X=O$ なので、残差は $e=(I_n-H)(X\beta+\varepsilon)=(I_n-H)\varepsilon$ である。
段 1(1)。 $\varepsilon\sim N_n(0,\sigma^2I_n)$ なので、多変量正規分布 の定理「1 次変換で多変量正規分布は保たれる」により
$$
\hat\beta=\beta+L\varepsilon\sim N_p\bigl(\beta,\ \sigma^2LL^{\top}\bigr),\qquad LL^{\top}=VX^{\top}XV=V
$$
である。
段 2(2)。 $Z:=\varepsilon/\sigma\sim N_n(0,I_n)$ とおく。$I_n-H$ は対称で冪等なので
$$
\frac{\mathrm{RSS}}{\sigma^2}=\frac{\lvert(I_n-H)\varepsilon\rvert^2}{\sigma^2}=Z^{\top}(I_n-H)^{\top}(I_n-H)Z=Z^{\top}(I_n-H)Z
$$
である。$I_n-H$ は階数 $n-p\ge1$ の対称な冪等行列なので、カイ二乗分布 の定理「2 次形式がカイ二乗分布に従う条件」により $\mathrm{RSS}/\sigma^2\sim\chi^2_{n-p}$ である。
段 3(3)。 $\hat\beta-\beta$ と $e$ を縦に並べたベクトルは
$$
\begin{pmatrix}\hat\beta-\beta\\ e\end{pmatrix}=\begin{pmatrix}L\\ I_n-H\end{pmatrix}\varepsilon
$$
と $\varepsilon$ の 1 次変換で書けるので、同じ定理により $N_{p+n}$ に従う。その共分散行列の右上の区画は
$$
\sigma^2L(I_n-H)^{\top}=\sigma^2(L-LH)=\sigma^2(L-VX^{\top}XVX^{\top})=\sigma^2(L-L)=O
$$
である。多変量正規分布 の定理「無相関なら独立」により、$\hat\beta$ と $e$ は独立である。$\mathrm{RSS}=\lvert e\rvert^2$ は $e$ の関数なので、$\hat\beta$ と $\mathrm{RSS}$ も独立である(Dur19 Theorem 2.1.10, p. 47)。
段 4(4)。 $\tau^2:=c^{\top}Vc$ とおくと、$V$ は正定値なので $\tau>0$ である。段 1 と同じ定理により $c^{\top}\hat\beta\sim N(c^{\top}\beta,\sigma^2\tau^2)$ なので、$Z_c:=(c^{\top}\hat\beta-c^{\top}\beta)/(\sigma\tau)\sim N(0,1)$ である。$W:=\mathrm{RSS}/\sigma^2\sim\chi^2_{n-p}$ は段 3 により $Z_c$ と独立で、$\hat\sigma=\sigma\sqrt{W/(n-p)}$ なので
$$
T_c=\frac{c^{\top}\hat\beta-c^{\top}\beta}{\sigma\tau\sqrt{W/(n-p)}}=\frac{Z_c}{\sqrt{W/(n-p)}}
$$
である。t分布 の定理「$t$ 分布の密度」により $T_c\sim t_{n-p}$ である。$c=e_j$ なら $\tau^2=v_j$、$\hat\sigma\tau=\mathrm{se}_j$ である。$\square$
$\sigma$ を知っていれば $Z_c\sim N(0,1)$ をそのまま使えるが、実際には $\sigma$ は未知で、$\hat\sigma$ で置き換える。その代償として、正規分布が自由度 $n-p$ の $t$ 分布に変わる。t分布 の定理「Student の定理」は、$X=\mathbf 1$($p=1$、$\beta$ は母平均)の場合にあたる。
正規線形回帰モデルで、$0<\alpha<1$、$q:=t_{n-p}(\alpha/2)$ とする。
- $P\bigl(\lvert\hat\beta_j-\beta_j\rvert\le q\,\mathrm{se}_j\bigr)=1-\alpha$ である。すなわち区間 $\hat\beta_j\pm q\,\mathrm{se}_j$ は確率 $1-\alpha$ で $\beta_j$ を含む。
- $x_0\in\mathbb{R}^p$ と、$\varepsilon$ と独立な $\varepsilon_0\sim N(0,\sigma^2)$ について、新しい観測を $y_0:=x_0^{\top}\beta+\varepsilon_0$ とする。$h_0:=x_0^{\top}(X^{\top}X)^{-1}x_0$ とおくと
$$ P\Bigl(\lvert y_0-x_0^{\top}\hat\beta\rvert\le q\,\hat\sigma\sqrt{1+h_0}\Bigr)=1-\alpha $$
である。
要点:1 は thm-reg-sampling の 4 から、2 は予測の誤差 $y_0-x_0^{\top}\hat\beta$ が残差と独立な正規分布に従うことから従う。
詳しい証明を開く
1 は thm-reg-sampling の 4 と、$t$ 分布が原点について対称であることから $P(\lvert T\rvert\le q)=1-2\cdot\frac\alpha2$ となることによる。2:$D:=y_0-x_0^{\top}\hat\beta=\varepsilon_0-x_0^{\top}L\varepsilon$ である。$(\varepsilon,\varepsilon_0)\sim N_{n+1}(0,\sigma^2I_{n+1})$ の 1 次変換として、$(D,e)$ は多変量正規分布に従い、$\mathrm{Var}(D)=\sigma^2(1+x_0^{\top}LL^{\top}x_0)=\sigma^2(1+h_0)$、$\mathrm{Cov}(D,e)=-\sigma^2x_0^{\top}L(I_n-H)^{\top}=0$ である。よって $D/(\sigma\sqrt{1+h_0})\sim N(0,1)$ は $\mathrm{RSS}$ と独立で、thm-reg-sampling の段 4 と同じ議論により $D/(\hat\sigma\sqrt{1+h_0})\sim t_{n-p}$ である。$\square$
予測区間の $\sqrt{1+h_0}$ の $1$ は新しい観測そのものの誤差 $\varepsilon_0$、$h_0$ は係数の推定の誤差による。期待値 $x_0^{\top}\beta$ だけの信頼区間なら $\sqrt{h_0}$ になる(thm-reg-sampling の 4 で $c=x_0$)。
平方和の分解と決定係数
def-reg-model の 1 を満たし、$\mathbf 1\in\operatorname{Im}X$(たとえば $X$ が切片の列をもつ)とする。このとき
- $\sum_ie_i=0$、$\sum_i\hat y_i=\sum_iy_i$ である。
- $\mathrm{TSS}=\mathrm{ESS}+\mathrm{RSS}$ である。したがって $\mathrm{TSS}>0$ なら $0\le R^2\le1$ である。
- $\mathrm{TSS}>0$、$\mathrm{ESS}>0$ なら、$R^2$ は $y$ と $\hat y$ の標本相関係数の 2 乗に等しい。単回帰では $R^2$ は $x$ と $y$ の相関係数 $r$ の 2 乗である。
$H$ は $\operatorname{Im}X$ への正射影なので、$e=(I_n-H)y$ は $\operatorname{Im}X$ の元すべてと直交する。
1:$\mathbf 1\in\operatorname{Im}X$ なので $\sum_ie_i=\mathbf 1^{\top}e=0$ であり、$y=\hat y+e$ から $\sum_i\hat y_i=\sum_iy_i$ である。
2:$y-\bar y\mathbf 1=(\hat y-\bar y\mathbf 1)+e$ で、$\hat y-\bar y\mathbf 1\in\operatorname{Im}X$ は $e$ と直交するので、三平方の定理から $\lvert y-\bar y\mathbf 1\rvert^2=\lvert\hat y-\bar y\mathbf 1\rvert^2+\lvert e\rvert^2$ である。これが $\mathrm{TSS}=\mathrm{ESS}+\mathrm{RSS}$ であり、各項は $0$ 以上なので $R^2=\mathrm{ESS}/\mathrm{TSS}\in[0,1]$ である。
3 は、相関係数の分子が $\mathrm{ESS}$ になることによる。
3 の証明を開く
1 から $\hat y$ の平均も $\bar y$ なので、標本相関係数は $\rho:=\dfrac{\langle y-\bar y\mathbf 1,\hat y-\bar y\mathbf 1\rangle}{\sqrt{\mathrm{TSS}\cdot\mathrm{ESS}}}$ である。分子は $\langle(\hat y-\bar y\mathbf 1)+e,\ \hat y-\bar y\mathbf 1\rangle=\mathrm{ESS}$ なので $\rho^2=\mathrm{ESS}^2/(\mathrm{TSS}\cdot\mathrm{ESS})=\mathrm{ESS}/\mathrm{TSS}=R^2$ である。単回帰では $\hat y_i-\bar y=\hat\beta_2(x_i-\bar x)$ であり、$\hat y$ は $x$ の 1 次式なので、$\hat\beta_2\ne0$($\mathrm{ESS}>0$ と同値)なら $y$ と $\hat y$ の相関係数の 2 乗は $y$ と $x$ の相関係数の 2 乗に等しい。$\square$
単回帰の場合は 散布図と回帰直線 の系「回帰直線の性質」の (4)(残差平方和の最小値が $ns_y^2(1-r^2)$)と同じ内容である。
入れ子のモデルの $F$ 検定
正規線形回帰モデルで、$X_0$ を $X$ のいくつかの列からなる $n\times p_0$ 行列($1\le p_0< p$)とし、$X_0$ だけで当てはめたときの残差平方和を $\mathrm{RSS}_0$ とする。$E[y]=X\beta\in\operatorname{Im}X_0$(小さいモデルが正しい)なら
$$
F:=\frac{(\mathrm{RSS}_0-\mathrm{RSS})/(p-p_0)}{\mathrm{RSS}/(n-p)}\sim F_{p-p_0,\,n-p}
$$
である。とくに $X$ の第 1 列が $\mathbf 1$ で $X_0=\mathbf 1$ のとき、$E[y]$ が定数ベクトルなら $\dfrac{R^2/(p-1)}{(1-R^2)/(n-p)}\sim F_{p-1,\,n-p}$ である。
要点:3 つの直交する部分空間への射影に カイ二乗分布 の定理「Cochran の定理」を使う。
詳しい証明を開く
$H_0$ を $\operatorname{Im}X_0$ への正射影の行列とする。$\operatorname{Im}X_0\subset\operatorname{Im}X$ なので $HH_0=H_0$、対称性から $H_0H=H_0$ であり、$A_1:=H_0$、$A_2:=H-H_0$、$A_3:=I_n-H$ はどれも対称で冪等、階数(=トレース)は $p_0$、$p-p_0$、$n-p$ で和は $n$、$A_1+A_2+A_3=I_n$ である。仮定 $X\beta\in\operatorname{Im}X_0$ から $(I_n-H_0)X\beta=0$ なので、$\mathrm{RSS}_0=\lvert(I_n-H_0)y\rvert^2=\lvert(I_n-H_0)\varepsilon\rvert^2$ である。$Z:=\varepsilon/\sigma$ とおくと、$I_n-H_0=A_2+A_3$ と $A_2A_3=O$ から $\mathrm{RSS}_0/\sigma^2=Z^{\top}A_2Z+Z^{\top}A_3Z$、$\mathrm{RSS}/\sigma^2=Z^{\top}A_3Z$ である。Cochran の定理により $Z^{\top}A_2Z\sim\chi^2_{p-p_0}$ と $Z^{\top}A_3Z\sim\chi^2_{n-p}$ は独立で、$F=\frac{Z^{\top}A_2Z/(p-p_0)}{Z^{\top}A_3Z/(n-p)}$ は def-reg-f の $F_{p-p_0,n-p}$ に従う。後半は $X_0=\mathbf 1$ で $\mathrm{RSS}_0=\mathrm{TSS}$、$p_0=1$ とし、thm-reg-anova の $\mathrm{TSS}-\mathrm{RSS}=R^2\,\mathrm{TSS}$、$\mathrm{RSS}=(1-R^2)\mathrm{TSS}$ を代入すればよい。$\square$
thm-reg-f で $X_0$ が $X$ から第 $j$ 列だけを除いたもの($p_0=p-1$)なら、$F=(\hat\beta_j/\mathrm{se}_j)^2$ である。
要点:第 $j$ 列のうち他の列と直交する成分 $w$ を使うと、$\hat\beta_j$、$v_j$、$\mathrm{RSS}_0-\mathrm{RSS}$ がすべて $w$ で書ける。
詳しい証明を開く
$x_j$ を $X$ の第 $j$ 列、$H_0$ を $\operatorname{Im}X_0$ への正射影とし、$w:=(I_n-H_0)x_j$ とおく。列が 1 次独立なので $w\ne0$ であり、$\operatorname{Im}X$ は $\operatorname{Im}X_0$ と $w$ の張る直線の直交和である。よって $H-H_0$ は $w$ の張る直線への正射影 $ww^{\top}/\lvert w\rvert^2$ で、$\mathrm{RSS}_0-\mathrm{RSS}=\lvert(H-H_0)y\rvert^2=(w^{\top}y)^2/\lvert w\rvert^2$ である。一方 $w\in\operatorname{Im}X$ なので $w^{\top}y=w^{\top}Hy=\sum_k\hat\beta_kw^{\top}x_k$ で、$k\ne j$ なら $w^{\top}x_k=0$、$w^{\top}x_j=\lvert w\rvert^2$ なので $\hat\beta_j=w^{\top}y/\lvert w\rvert^2$ である。この式から、def-reg-model の 1〜3 のもとで $\mathrm{Var}(\hat\beta_j)=\sigma^2/\lvert w\rvert^2$ であり、最小二乗法 の定理「Gauss–Markov の定理」の 1 の $\mathrm{Var}(\hat\beta_j)=\sigma^2v_j$ と比べて $v_j=1/\lvert w\rvert^2$ である。したがって $(\hat\beta_j/\mathrm{se}_j)^2=\frac{(w^{\top}y)^2/\lvert w\rvert^4}{\hat\sigma^2/\lvert w\rvert^2}=\frac{\mathrm{RSS}_0-\mathrm{RSS}}{\hat\sigma^2}=F$ である。$\square$
したがって、係数を一つだけ外すかどうかの $F$ 検定は、その係数の $t$ 検定と同じ判定をする(def-reg-f の後の $F_{1,b}(\alpha)=t_b(\alpha/2)^2$)。
計算の手順
データ $(X,y)$ と有意水準 $\alpha$(たとえば $0.05$)が与えられたとき、次の順に計算する。
- モデルを決める。 計画行列 $X$ の列(切片、説明変数、その 2 乗や積など)を決め、列が 1 次独立で $n>p$ であることを確かめる。そうでなければ列を減らす(ex-reg-counterexamples の 1 行目)。
- 係数を求める。 正規方程式 $X^{\top}X\hat\beta=X^{\top}y$ を解く。数値的には QR 分解を使う方が安定である(最小二乗法 の定理「QR 分解による最小二乗解」)。単回帰なら $\hat\beta_2=S_{xy}/S_{xx}$、$\hat\beta_1=\bar y-\hat\beta_2\bar x$。
- 残差と分散を求める。 $e=y-X\hat\beta$、$\mathrm{RSS}=\lvert e\rvert^2$、$\hat\sigma^2=\mathrm{RSS}/(n-p)$。
- 標準誤差と $t$ 統計量。 $v_j=((X^{\top}X)^{-1})_{jj}$、$\mathrm{se}_j=\hat\sigma\sqrt{v_j}$、$t_j=\hat\beta_j/\mathrm{se}_j$。$\lvert t_j\rvert>t_{n-p}(\alpha/2)$ なら「$\beta_j=0$」を水準 $\alpha$ で棄却する(thm-reg-sampling の 4)。信頼区間は $\hat\beta_j\pm t_{n-p}(\alpha/2)\mathrm{se}_j$。
- 当てはまりと全体の検定。 切片があれば $R^2=1-\mathrm{RSS}/\mathrm{TSS}$、$F=\frac{R^2/(p-1)}{(1-R^2)/(n-p)}$ を $F_{p-1,n-p}(\alpha)$ と比べる(thm-reg-f)。いくつかの列をまとめて外すかどうかは、外したモデルの $\mathrm{RSS}_0$ で thm-reg-f の $F$ を計算する。
- 予測。 $x_0$ での予測値 $x_0^{\top}\hat\beta$ と、予測区間 $x_0^{\top}\hat\beta\pm t_{n-p}(\alpha/2)\hat\sigma\sqrt{1+h_0}$(cor-reg-intervals)。
- 残差を見る。 残差を当てはめ値や説明変数に対して描き、曲がり・ばらつきの変化・外れ値がないかを見る。手順 4〜6 の分布は def-reg-model の 1〜4 に依存するので、条件が崩れていそうなら結論を保留する(ex-reg-counterexamples)。
場合 やること 結果の形 係数 1 つが $0$ か 手順 4 の $t$ 検定 $t_{n-p}$ と比べる 係数をまとめて外せるか 手順 5 の入れ子の $F$ 検定 $F_{p-p_0,n-p}$ と比べる 期待値 $x_0^{\top}\beta$ の区間 $x_0^{\top}\hat\beta\pm t_{n-p}(\alpha/2)\hat\sigma\sqrt{h_0}$ 区間 新しい観測 $y_0$ の区間 手順 6 区間(期待値の区間より広い)
例題
以下の $t_\nu(\alpha)$、$F_{a,b}(\alpha)$ の値は数値計算による値である($t_4(0.025)\approx2.776445$、$F_{1,4}(0.05)=t_4(0.025)^2\approx7.708647$、$F_{2,4}(0.05)=2(\sqrt{20}-1)\approx6.944272$)。
$x=(1,2,3,4,5,6)$、$y=(3,4,8,9,12,13)$ に $y=\beta_1+\beta_2x+\varepsilon$ を当てはめる($n=6$、$p=2$)。
使う公式:手順 2〜5、thm-reg-sampling、cor-reg-intervals、thm-reg-anova。
答え:$\hat\beta_1=\frac23\approx0.666667$、$\hat\beta_2=\frac{15}7\approx2.142857$、$\mathrm{RSS}=\frac{52}{21}\approx2.476190$、$\hat\sigma^2=\frac{13}{21}\approx0.619048$。傾きの標準誤差は $\mathrm{se}_2=\sqrt{26/735}\approx0.188080$、$t_2\approx11.3933>2.776445$ で、$\beta_2=0$ は水準 $5\%$ で棄却される。傾きの $95\%$ 信頼区間は $[1.620663,\ 2.665051]$。切片は $\mathrm{se}_1\approx0.732467$、$t_1\approx0.9102$ で、$\beta_1=0$ は棄却されない。$R^2=1-\frac{52/21}{497/6}=\frac{3375}{3479}\approx0.970106$。
途中の計算を開く
$\bar x=\frac72$、$\bar y=\frac{49}6$、$S_{xx}=\frac{35}2$、$S_{xy}=\frac{75}2$ なので $\hat\beta_2=\frac{75/2}{35/2}=\frac{15}7$、$\hat\beta_1=\frac{49}6-\frac{15}7\cdot\frac72=\frac23$ である。当てはめ値は $\frac{59}{21}+\frac{45}{21}(k-1)$($k=1,\dots,6$)で、残差は $\frac1{21}(4,-20,19,-5,13,-11)$、その 2 乗の和は $\frac{1092}{441}=\frac{52}{21}$ である。$(X^{\top}X)^{-1}=\begin{pmatrix}13/15&-1/5\\-1/5&2/35\end{pmatrix}$ なので $v_2=\frac2{35}=\frac1{S_{xx}}$、$v_1=\frac{13}{15}$。$\mathrm{se}_2=\sqrt{\frac{13}{21}\cdot\frac2{35}}=\sqrt{\frac{26}{735}}$、$t_2=\frac{15/7}{\sqrt{26/735}}$。区間は $\frac{15}7\pm2.776445\times0.188080$。$\mathrm{TSS}=\sum(y_i-\bar y)^2=\frac{497}6$。
ex-reg-simple のデータで、$x_0=7$ での新しい観測 $y_0$ の $95\%$ 予測区間を求める。
使う公式:cor-reg-intervals の 2。
答え:予測値 $x_0^{\top}\hat\beta=\frac23+7\cdot\frac{15}7=\frac{47}3\approx15.666667$、$h_0=\frac{13}{15}$。予測区間は $[12.682078,\ 18.651255]$、期待値 $\beta_1+7\beta_2$ の信頼区間は $[13.633012,\ 17.700321]$ で、予測区間の方が広い。
途中の計算を開く
$x_0=(1,7)^{\top}$ で $h_0=x_0^{\top}(X^{\top}X)^{-1}x_0=\frac{13}{15}-2\cdot\frac{7}{5}+49\cdot\frac2{35}=\frac{13}{15}$。予測区間の半幅は $2.776445\sqrt{\frac{13}{21}\bigl(1+\frac{13}{15}\bigr)}=2.776445\sqrt{\frac{52}{45}}\approx2.984589$、期待値の区間の半幅は $2.776445\sqrt{\frac{13}{21}\cdot\frac{13}{15}}=2.776445\cdot\frac{13}{\sqrt{315}}\approx2.033654$。
$x=(0,1,2,3,4,5,6)$、$y=(2,2,3,5,6,9,11)$ に $y=\beta_1+\beta_2x+\beta_3x^2+\varepsilon$ を当てはめ($n=7$、$p=3$)、$\beta_3=0$ かどうかを調べる。
使う公式:thm-reg-sampling の 4、thm-reg-f、prop-reg-f-t。
答え:$\hat\beta=(\frac{25}{14},\frac27,\frac3{14})\approx(1.785714,\,0.285714,\,0.214286)$、$\mathrm{RSS}=\frac57$、$\hat\sigma^2=\frac5{28}$。2 次の係数は $\mathrm{se}_3\approx0.046107$、$t_3\approx4.647580>2.776445$ で、水準 $5\%$ で $\beta_3=0$ は棄却される。直線だけのモデルでは $\mathrm{RSS}_0=\frac{32}7$ で、$F=\frac{(32/7-5/7)/1}{(5/7)/4}=21.6=t_3^2>7.708647$ となり、同じ判定になる。
途中の計算を開く
$X^{\top}X=\begin{pmatrix}7&21&91\\21&91&441\\91&441&2275\end{pmatrix}$、$X^{\top}y=(38,\,158,\,776)^{\top}$ で、正規方程式を解くと上の $\hat\beta$ になる。残差は $\frac1{14}(3,\,-4,\,-3,\,6,\,-5,\,6,\,-3)$ で、2 乗の和は $\frac{9+16+9+36+25+36+9}{196}=\frac{140}{196}=\frac57$ である。$(X^{\top}X)^{-1}$ の第 3 対角成分は $v_3=\frac1{84}$ なので $\mathrm{se}_3=\sqrt{\frac5{28}\cdot\frac1{84}}=\sqrt{\frac{5}{2352}}$、$t_3=\frac{3/14}{\mathrm{se}_3}$ である。直線のモデルの当てはめは $\hat y=\frac57+\frac{11}7x$ で、残差 $\frac17(9,-2,-6,-3,-7,3,6)$ の 2 乗の和が $\frac{224}{49}=\frac{32}7$ である。
ex-reg-quadratic の 2 次のモデルについて、$R^2$ と「切片以外の係数がすべて $0$」の $F$ 検定を求める。
使う公式:thm-reg-anova、thm-reg-f の後半。
答え:$\bar y=\frac{38}7$、$\mathrm{TSS}=\frac{516}7\approx73.714286$、$R^2=1-\frac{5/7}{516/7}=\frac{511}{516}\approx0.990310$。$F=\frac{R^2/2}{(1-R^2)/4}=\frac{511\cdot4}{2\cdot5}=204.4>6.944272$ で、全体として説明変数は効いている。
図 1 は ex-reg-simple と ex-reg-prediction を描いたものである。
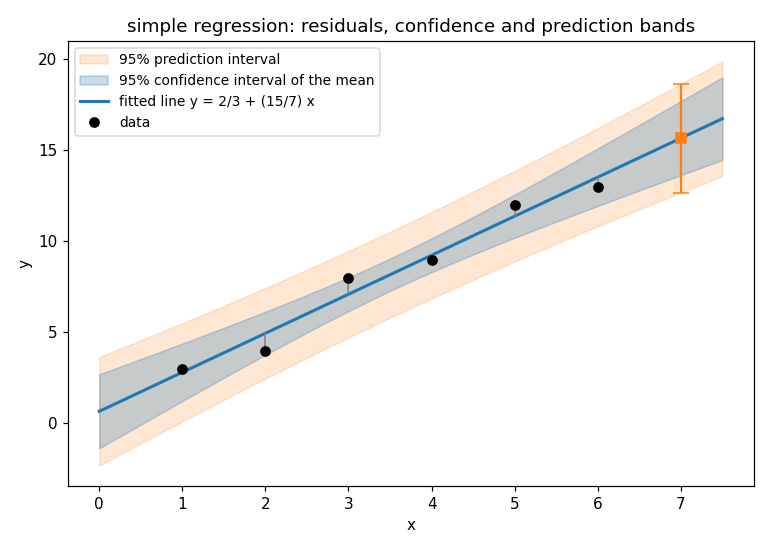 ex-reg-simple のデータ(黒い点)と回帰直線(青の実線)。灰色の縦線は残差。内側の濃い帯(灰色がかった青)は期待値 β1+β2x の 95% 信頼区間、外側の薄い橙の帯は新しい観測の 95% 予測区間で、x = 7 での予測区間は約 12.68 から 18.65
使える条件と反例
thm-reg-sampling とそこから導いた区間・検定は、def-reg-model の 1〜4 をすべて使う。thm-reg-anova は切片($\mathbf 1\in\operatorname{Im}X$)を使う。次の表の各行は、条件を一つだけ外している。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 1:列が 1 次独立 | $X$ の列が $\mathbf 1$、$x$、$2x$ | $\hat\beta$ が一つに決まり、$\mathrm{se}_j$ が定まる |
| 3:誤差の分散が等しい | $x=(0,1,2)$ の単回帰、$\operatorname{Cov}(\varepsilon)=\operatorname{diag}(1,1,4)$ | ある $\sigma^2$ で $\operatorname{Cov}(\hat\beta)=\sigma^2(X^{\top}X)^{-1}$ |
| 3:誤差が無相関 | 切片をもつモデル、$\varepsilon=Z\mathbf 1$($Z\sim N(0,\sigma^2)$) | $\mathrm{RSS}/\sigma^2\sim\chi^2_{n-p}$(実際は $\mathrm{RSS}=0$) |
| 4:誤差が正規分布 | $n=2$、$X=\mathbf 1$、$\varepsilon_i$ が独立に確率 $\frac12$ ずつ $\pm\sigma$ | $\mathrm{RSS}/\sigma^2\sim\chi^2_1$(実際は $0$ か $2$ の 2 値) |
| 切片($\mathbf 1\in\operatorname{Im}X$) | 原点を通る直線 $y=\beta x$、$x=(1,2,3)$、$y=(3,1,2)$ | $\mathrm{TSS}=\mathrm{ESS}+\mathrm{RSS}$、$0\le R^2\le1$ |
1 行目:$b$ と $b+t(0,2,-1)^{\top}$($t$ は任意)で $Xb$ が等しいので最小二乗解は無数にあり、$X^{\top}X$ は正則でない。係数ごとの推定と $v_j$ は意味をもたない。当てはめ値は一つに決まる(最小二乗法 の定理「最小二乗解と正規方程式」の 2)。
2 行目:$L=(X^{\top}X)^{-1}X^{\top}$ とすると $\operatorname{Cov}(\hat\beta)=L\operatorname{diag}(1,1,4)L^{\top}=\begin{pmatrix}11/12&-3/4\\-3/4&5/4\end{pmatrix}$ だが、$(X^{\top}X)^{-1}=\begin{pmatrix}5/6&-1/2\\-1/2&1/2\end{pmatrix}$ で、成分の比は $1.1$、$1.5$、$2.5$ とそろわない。どの $\sigma^2$ をとっても標準誤差の公式は正しくない。
3 行目:誤差は平均 $0$ の正規分布で、各成分の分散は $\sigma^2$ で等しいが、どの 2 つも相関 $1$ である。$\varepsilon\in\operatorname{Im}X$ なので $e=(I_n-H)\varepsilon=0$、$\mathrm{RSS}=0$ であり、$\hat\sigma=0$ となって $t$ 統計量も定義できない。
4 行目:誤差は独立で平均 $0$、分散 $\sigma^2$ だが正規分布でない。$\mathrm{RSS}=(\varepsilon_1-\varepsilon_2)^2/2$ は確率 $\frac12$ で $0$、確率 $\frac12$ で $2\sigma^2$ である。$\chi^2_1$ は密度をもつので、$\mathrm{RSS}/\sigma^2$ が $\chi^2_1$ に従うことはない。ただし $E[\mathrm{RSS}/\sigma^2]=1$ で、不偏性(最小二乗法 の命題「誤差の分散の不偏推定」)は保たれている。
5 行目:$\hat\beta=\frac{\sum x_iy_i}{\sum x_i^2}=\frac{11}{14}$、$\mathrm{RSS}=\frac{75}{14}\approx5.357$、$\mathrm{TSS}=2$ で、$\mathrm{RSS}>\mathrm{TSS}$ となり、$1-\mathrm{RSS}/\mathrm{TSS}=-\frac{47}{28}<0$ である。平均の値 $\bar y=2$ を予測に使う方が、原点を通る直線より当てはまりがよい。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| $\hat\sigma^2=\mathrm{RSS}/n$ とする | $\mathrm{RSS}/(n-p)$ で割る | $E[\mathrm{RSS}]=(n-p)\sigma^2$(最小二乗法 の命題「誤差の分散の不偏推定」) |
| $t$ 検定に正規分布の点 $1.96$ を使う | 自由度 $n-p$ の $t$ 分布の点を使う | $\sigma$ を $\hat\sigma$ で置き換えている(thm-reg-sampling の 4)。$n=6$、$p=2$ では $2.776$ |
| 予測区間を期待値の信頼区間で代用する | 予測区間は $\sqrt{1+h_0}$、期待値の区間は $\sqrt{h_0}$ | 新しい観測には誤差 $\varepsilon_0$ が加わる(cor-reg-intervals、ex-reg-prediction) |
| 各係数の $t$ 検定がすべて有意でないので、まとめて外してよいとする | まとめて外すかどうかは thm-reg-f の $F$ 検定で調べる | 一つずつの $t$ 検定は「ほかの係数を残したまま、その一つを外せるか」を調べている。まとめて外すのは別の仮説である |
| $R^2$ が大きいほどよいモデルとする | 列を増やすと $R^2$ は減らない。比較は $F$ 検定などで | 列を足すと $\operatorname{Im}X$ が大きくなり $\mathrm{RSS}$ は増えない(最小二乗法 の最小性) |
| 原点を通るモデルでも $R^2=1-\mathrm{RSS}/\mathrm{TSS}$ を $[0,1]$ の値と読む | 切片がないと負になりうる | ex-reg-counterexamples の 5 行目 |
補足
- 正規性がないとき。 def-reg-model の 1〜3 だけでも、$\hat\beta$ は不偏で、線形な不偏推定量のなかで分散が最小である(最小二乗法 の定理「Gauss–Markov の定理」)。区間・検定の分布は 4 に依存し、誤差が正規分布でないときは一般に正確でない(ex-reg-counterexamples の 4 行目)。$n$ が大きいときの近似には計画行列にも条件が要る。たとえば $X$ の列が $\mathbf 1$ と $(1,0,\dots,0)^{\top}$ なら $\hat\beta_2-\beta_2=\varepsilon_1-\frac1{n-1}\sum_{i\ge2}\varepsilon_i$ で、$n$ を大きくしても $\varepsilon_1$ の分布が残る。この記事では大標本の近似は扱わない。
- 列が 1 次独立でないとき。 当てはめ値は一つに決まり、最小ノルムの係数は Moore–Penrose逆行列 で $X^+y$ と書ける。
- 線形回帰の位置づけ。 係数の推定・標準誤差・$t$ 統計量・$F$ 統計量の扱いは ESL17 §3.2((3.6)〜(3.16)、pp. 44–51)にまとまっている。そこでは標本分布((3.10)・(3.11))と $F$ 統計量の分布は証明なしで述べられている。
- 名前。 「回帰」の由来は、親子の身長の関係で予測が平均の側に戻ることにある(散布図と回帰直線 の注意「「回帰」という名前」)。
関連項目
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

