決定木
概要
決定木(decision tree)とは、「特徴量がしきい値より小さいか」のような問いを根から順にたどり、着いた葉の値を予測として返す規則で、入力の空間をセルに分けてセルごとに一定の値をとる関数である。データからは、各節点のデータを Gini 係数やエントロピーなどの不純度が最も下がるように 2 つに分けることをくり返して作り、不純度が凹関数なら、子の不純度をデータ数で重み付けた平均は親の不純度を超えない。2 類の分類でカテゴリの特徴量を分けるときは、値を類 1 の割合の順に並べた前半と後半の分割の中に最良のものがある(Breiman の定理)。回帰では葉の値に平均を使う。
前提知識: 二分木, 凸関数, Jensenの不等式
決定木(decision tree)は、「$j$ 番目の特徴量はしきい値 $\theta$ より小さいか」のような問いを根から順にたどり、たどり着いた葉に書かれた値を予測として返す予測の規則である。分類に使うものを分類木、実数値の予測に使うものを回帰木という。葉は入力の空間を互いに交わらない領域(セル)に分け、決定木はセルごとに一定の値をとる関数になる。
データから決定木を作るときは、根から始めて、各節点のデータを「不純度」が最も下がるように 2 つに分ける操作をくり返す(CART・ID3 などの方法)。この記事では、不純度が凹関数なら分割で不純度が増えないこと、2 類の分類でカテゴリの特徴量を分けるとき、値を「類 1 の割合」の順に並べて前半と後半に分ければ $2^{L-1}-1$ 通りの分割の中の最良のものが得られること(Breiman の定理、主定理)を証明し、回帰木の葉の値と分割の計算、手順と例を述べる。
計算量の理論では、入力について 1 回ずつ問い(2 つの値の比較、1 つの変数の値など)を発して答えを決める手順を表す木も決定木と呼ばれる(比較だけで並べ替える手順を表す「比較の木」は 二分木 の例)。この記事の決定木はデータから作る予測の規則で、別のものである。
定義と使える条件
集合 $X$ の上の 決定木 とは、根付きの有限な 二分木 で、各内部節点 $v$ に $X$ の部分集合 $A_v$(「問い」:$x\in A_v$ なら左、そうでなければ右の子へ進む)を、各葉 $\ell$ に値 $c_\ell$ を割り当てたものである。$x\in X$ から根を出発して問いに答えながら進み、着いた葉の値を $T(x)$ とする。葉 $\ell$ に着く $x$ の全体を セル $R_\ell$ とすると、セルは $X$ を互いに交わらない集合に分け、$T(x)=\sum_\ell c_\ell\mathbf 1[x\in R_\ell]$ である。
$X=\mathbb R^d$ では問いを $A_v=\{x\mid x_j< \theta\}$(座標 $j$ としきい値 $\theta$)の形に限ることが多い。このときセルは座標軸に平行な箱である。カテゴリの値をとる特徴量では $A_v=\{x\mid x_j\in C\}$(値の集合 $C$)の形の問いを使う。根で 1 回だけ分ける木を 決定株 という。
訓練データ $(x_1,y_1),\dots,(x_n,y_n)$ を固定する。分類では $y_i\in\{1,\dots,K\}$、回帰では $y_i\in\mathbb R$ である。節点 $v$ に着くデータの添字の集合を $I_v$、その個数を $n_v$ とし、分類では類 $k$ の割合を $p_{v,k}=\lvert\{i\in I_v\mid y_i=k\}\rvert/n_v$ と書く。$p_v=(p_{v,1},\dots,p_{v,K})$ は単体 $\Delta_K=\{p\in\mathbb R^K\mid p_k\ge0,\ \sum_kp_k=1\}$ の点である。
$\Delta_K$ の上の凹関数 $\iota$ で、頂点(1 つの類だけの点)で $0$、それ以外で正のものを 不純度 という。代表例は次の 3 つである。
$$
\text{Gini 係数 }\ \iota_G(p)=\sum_kp_k(1-p_k)=1-\sum_kp_k^2,\qquad\text{エントロピー }\ \iota_H(p)=-\sum_kp_k\log p_k,\qquad\text{誤分類率 }\ \iota_M(p)=1-\max_kp_k
$$
($0\log0=0$)。節点 $v$ を子 $v_L,v_R$ に分けるとき、
$$
\Delta\iota=\iota(p_v)-\frac{n_{v_L}}{n_v}\iota(p_{v_L})-\frac{n_{v_R}}{n_v}\iota(p_{v_R})
$$
をその分割の 利得(不純度の減少)という。2 類($K=2$)では類 $2$ の割合を $p$ として $\iota_G=2p(1-p)$、$\iota_H=-p\log p-(1-p)\log(1-p)$、$\iota_M=\min\{p,1-p\}$ である。
3 つとも凹関数である($\iota_G$ は $-\sum p_k^2$ が、$\iota_H$ は $-t\log t$ が凹、$\iota_M$ は 1 次関数の最小値)。$\iota_G$ と $\iota_H$ は狭義凹で、$\iota_M$ は狭義凹でない。分類の葉の値には葉のデータの多数の類を使い、そのとき葉の誤り数は $n_\ell\,\iota_M(p_\ell)$ である。回帰では葉の値に葉のデータの平均を使い、不純度の代わりに 2 乗誤差の和
$$
\mathrm{SSE}(I)=\sum_{i\in I}(y_i-\bar y_I)^2,\qquad\bar y_I=\frac1{\lvert I\rvert}\sum_{i\in I}y_i
$$
を使う。
この記事の定理を使う条件は次のとおりである。
- (i) 利得が負にならないこと(prop-dt-gain)には不純度が凹であることが、利得が $0$ になるのが子の割合が等しいときだけであることには狭義凹であることが要る(反例の表の 1・2 行目)。
- (ii) Breiman の定理(thm-dt-breiman)は 2 類の分類で、不純度が凹のときの主張である(反例の表の 3 行目)。
- (iii) どの定理も 1 回の分割についての主張で、貪欲に作った木全体の最適性は保証しない(よくある誤りの表)。
不純度は分割で増えない
不純度 $\iota$ が凹なら、どの分割でも $\Delta\iota\ge0$ である。$\iota$ が狭義凹で両方の子が空でなければ、$\Delta\iota=0$ と $p_{v_L}=p_{v_R}$ は同値である。
$\pi_L=n_{v_L}/n_v$、$\pi_R=n_{v_R}/n_v$ とおくと $\pi_L+\pi_R=1$ で、類 $k$ の個数を数えると $n_vp_{v,k}=n_{v_L}p_{v_L,k}+n_{v_R}p_{v_R,k}$ だから $p_v=\pi_Lp_{v_L}+\pi_Rp_{v_R}$ である。凹性から $\iota(p_v)\ge\pi_L\iota(p_{v_L})+\pi_R\iota(p_{v_R})$、すなわち $\Delta\iota\ge0$ である。片方の子が空なら等号である。狭義凹で $\pi_L,\pi_R>0$ のとき、凹性の不等式の等号は $p_{v_L}=p_{v_R}$ のときに限る。逆に $p_{v_L}=p_{v_R}$ なら $p_v$ もそれに等しく $\Delta\iota=0$ である。$\square$
回帰木では、同じことが 2 乗誤差の和の分解として正確に書ける。
有限集合 $I$ と実数 $y_i$($i\in I$)について、
- $c\mapsto\sum_{i\in I}(y_i-c)^2$ は $c=\bar y_I$ でだけ最小値 $\mathrm{SSE}(I)$ をとる。
- $I$ を空でない $I_L,I_R$ に分けると
$$ \mathrm{SSE}(I)-\mathrm{SSE}(I_L)-\mathrm{SSE}(I_R)=\frac{\lvert I_L\rvert\,\lvert I_R\rvert}{\lvert I\rvert}\bigl(\bar y_{I_L}-\bar y_{I_R}\bigr)^2\ \ge0 $$
である。
1。 $\sum_i(y_i-c)^2=\sum_i(y_i-\bar y_I)^2+2(\bar y_I-c)\sum_i(y_i-\bar y_I)+\lvert I\rvert(\bar y_I-c)^2$ で、中央の和は $0$ だから、$\mathrm{SSE}(I)+\lvert I\rvert(\bar y_I-c)^2$ に等しい。
2。 1 の式を $I_L$ の上で $c=\bar y_I$ として使うと $\sum_{i\in I_L}(y_i-\bar y_I)^2=\mathrm{SSE}(I_L)+n_L(\bar y_{I_L}-\bar y_I)^2$($n_L=\lvert I_L\rvert$)で、$I_R$ も同様である。足すと $\mathrm{SSE}(I)=\mathrm{SSE}(I_L)+\mathrm{SSE}(I_R)+n_L(\bar y_{I_L}-\bar y_I)^2+n_R(\bar y_{I_R}-\bar y_I)^2$ である。$n=n_L+n_R$、$\bar y_I=(n_L\bar y_{I_L}+n_R\bar y_{I_R})/n$ から $\bar y_{I_L}-\bar y_I=\frac{n_R}n(\bar y_{I_L}-\bar y_{I_R})$、$\bar y_{I_R}-\bar y_I=-\frac{n_L}n(\bar y_{I_L}-\bar y_{I_R})$ で、最後の 2 項の和は $\frac{n_Ln_R^2+n_Rn_L^2}{n^2}(\bar y_{I_L}-\bar y_{I_R})^2=\frac{n_Ln_R}{n}(\bar y_{I_L}-\bar y_{I_R})^2$ である。$\square$
主定理:カテゴリの特徴量の最良の分割
カテゴリの値 $1,\dots,L$ をとる特徴量で節点を分けるとき、問いは値の集合 $C$ で決まり、$C$ と補集合は同じ分割を与えるので、空でも全体でもない分割は $2^{L-1}-1$ 通りある。2 類の分類では、これを $L-1$ 通りの候補に減らせる。
2 類の分類で、節点のデータのうち特徴量の値が $l$ のものの個数を $n_l>0$、そのうち類 $1$ のものの個数を $s_l$ とし、$p_l=s_l/n_l$ とおく($l=1,\dots,L$、$L\ge2$)。$\varphi\colon[0,1]\to\mathbb R$ を凹関数とし、値の集合 $C$ による分割の加重不純度を
$$
W(C)=n(C)\,\varphi\Bigl(\frac{s(C)}{n(C)}\Bigr)+n(C^c)\,\varphi\Bigl(\frac{s(C^c)}{n(C^c)}\Bigr),\qquad n(C)=\sum_{l\in C}n_l,\ \ s(C)=\sum_{l\in C}s_l
$$
とする($C=\emptyset$ の項は $0$ とする)。値を $p_{l_1}\le p_{l_2}\le\cdots\le p_{l_L}$ と並べる(同じ割合の値の順は任意)。このとき、空でも全体でもない $C$ についての $W(C)$ の最小値は、$C=\{l_1,\dots,l_k\}$($1\le k\le L-1$)のどれかでとられる。
利得は節点の不純度から $W(C)/n_v$ を引いたものなので、$W$ の最小化は利得の最大化と同じである。Gini 係数・エントロピー・誤分類率のどれでもよい(HTF09 §9.2.4 はこの事実を Gini 係数とエントロピーについて述べ、証明を Breiman らの本に帰している)。以下の証明は、$W$ を平面の点の関数とみて、凹関数の最小値が多角形の頂点でとられることを使う。
段 1:$W$ を平面の凹関数で書く。 錐 $K=\{(a,b)\in\mathbb R^2\mid 0\le b\le a,\ a>0\}\cup\{(0,0)\}$ の上で $g(a,b)=a\,\varphi(b/a)$($a>0$)、$g(0,0)=0$ とおく。$g$ は $K$ の上で凹関数である。実際、$u=(a_1,b_1)$、$u'=(a_2,b_2)$ が $a_1,a_2>0$ をみたし $0< \lambda< 1$ なら、$a=\lambda a_1+(1-\lambda)a_2$ とおくと
$$
\frac{\lambda b_1+(1-\lambda)b_2}{a}=\frac{\lambda a_1}{a}\cdot\frac{b_1}{a_1}+\frac{(1-\lambda)a_2}{a}\cdot\frac{b_2}{a_2}
$$
は $b_1/a_1$ と $b_2/a_2$ の凸結合なので、$\varphi$ の凹性から $g(\lambda u+(1-\lambda)u')\ge\lambda g(u)+(1-\lambda)g(u')$ である。$u'=(0,0)$ のときは $g(\lambda u)=\lambda g(u)$ で等号である。
$v_l=(n_l,s_l)\in K$、$V=\sum_lv_l$ とし、$u\in K$、$V-u\in K$ について $F(u)=g(u)+g(V-u)$ とおくと、$W(C)=F(u_C)$($u_C=\sum_{l\in C}v_l$)で、$F$ は凹関数である。
段 2:$F$ の定義域の多角形。 $Z=\{\sum_l\lambda_lv_l\mid 0\le\lambda_l\le1\}$ とおく。$Z$ は $[0,1]^L$ の 1 次写像による像なのでコンパクト凸集合で、$u\in Z$ なら $u$ も $V-u=\sum_l(1-\lambda_l)v_l$ も $K$ に入る。実数 $\tau$ について $C^+_\tau=\{l\mid p_l>\tau\}$、$C^-_\tau=\{l\mid p_l< \tau\}$ とし、$Q=\{u_{C^\pm_\tau}\mid\tau\in\mathbb R\}$(有限集合)とおく。$Z$ は $Q$ の凸包 $\operatorname{conv}Q$ に等しいことを示す。
$Q\subset Z$ は明らかなので、$z\in Z\setminus\operatorname{conv}Q$ があったとする。$\operatorname{conv}Q$ はコンパクト凸集合なので、点と凸集合の分離定理により $c=(c_1,c_2)$ があって $\langle c,z\rangle>\max_{q\in Q}\langle c,q\rangle$ となる。一方、$\lambda\in[0,1]^L$ について $\langle c,\sum_l\lambda_lv_l\rangle=\sum_l\lambda_l\langle c,v_l\rangle$ の最大値は $\lambda_l=\mathbf 1[\langle c,v_l\rangle>0]$ でとられ、そのときの点は $u_C$、$C=\{l\mid\langle c,v_l\rangle>0\}$ である。$\langle c,v_l\rangle=n_l(c_1+c_2p_l)$ と $n_l>0$ から、$c_2>0$ なら $C=C^+_{-c_1/c_2}$、$c_2< 0$ なら $C=C^-_{-c_1/c_2}$、$c_2=0$ なら $C$ は空か全体($c_1\le0$ なら $C^+_1=\emptyset$、$c_1>0$ なら $C^-_2$ が全体)で、どの場合も $u_C\in Q$ である。よって $\langle c,z\rangle\le\langle c,u_C\rangle\le\max_{q\in Q}\langle c,q\rangle$ となり矛盾する。
段 3:最小値。 任意の $C$ について $u_C\in Z=\operatorname{conv}Q$ なので $u_C=\sum_j\mu_jq_j$($q_j\in Q$、$\mu_j\ge0$、$\sum_j\mu_j=1$)と書け、$F$ の凹性から
$$
W(C)=F(u_C)\ge\sum_j\mu_jF(q_j)\ge\min_{q\in Q}F(q)
$$
である。$Q$ の点は $C^\pm_\tau$ の形の集合 $C'$ の $u_{C'}$ で、$C^+_\tau$ は並べた順の後半、$C^-_\tau$ は前半なので、$W(C')=W(C'^c)$ により $C'$ を前半 $\{l_1,\dots,l_k\}$($0\le k\le L$)に取り替えてよい。よってすべての $C$ についての $W(C)$ の最小値は、ある前半 $\{l_1,\dots,l_k\}$ でとられる。
段 4:自明な分割を除く。 $g$ は凹で $g(\lambda u)=\lambda g(u)$ をみたすので、$g(u+u')=2g(\frac{u+u'}2)\ge g(u)+g(u')$ である。よってすべての $C$ で $W(C)=g(u_C)+g(V-u_C)\le g(V)=W(\emptyset)$ である。段 3 の最小値が $k=0$ または $k=L$(値 $g(V)$)でとられたなら、すべての $C$ で $W(C)=g(V)$ なので、$k=1$ の前半も最小値をとる。そうでなければ最小値をとる $k$ は $1\le k\le L-1$ をみたす。$\square$
$L$ 個の値の分け方を $2^{L-1}-1$ 通り調べる代わりに、割合で並べて $L-1$ 通りを調べればよい。3 類以上ではこのような簡単化はできない(HTF09 §9.2.4)。回帰で 2 乗誤差を使うときも、値を $y$ の平均の順に並べた前半と後半の分割の中に最良のものがある(同じ箇所の主張。この記事では証明しない)。
公式の表
| 量 | 式 | 条件 | 根拠 |
|---|---|---|---|
| Gini 係数 | $1-\sum_kp_k^2$(2 類で $2p(1-p)$) | — | def-dt-impurity |
| エントロピー | $-\sum_kp_k\log p_k$ | $0\log0=0$ | def-dt-impurity |
| 誤分類率 | $1-\max_kp_k$(2 類で $\min\{p,1-p\}$) | — | def-dt-impurity |
| 利得 | $\iota(p_v)-\frac{n_L}{n_v}\iota(p_L)-\frac{n_R}{n_v}\iota(p_R)\ge0$ | $\iota$ が凹 | prop-dt-gain |
| 利得が $0$ | $p_L=p_R$ と同値 | $\iota$ が狭義凹、子が空でない | prop-dt-gain |
| 回帰の葉の値 | $\bar y_\ell$(葉のデータの平均) | 2 乗誤差 | prop-dt-regression の 1 |
| 回帰の分割の利得 | $\frac{n_Ln_R}{n}(\bar y_L-\bar y_R)^2$ | 2 乗誤差 | prop-dt-regression の 2 |
| 実数の特徴量の候補 | 並べた値の隣どうしの中点(異なる値が $r$ 個なら $r-1$ 通り) | 問いが $x_j< \theta$ の形 | 候補の間で分割が変わらないこと |
| カテゴリの特徴量の候補 | 類 1 の割合の順の前半($L-1$ 通り) | 2 類、$\iota$ が凹 | thm-dt-breiman |
| 剪定の基準 | $\sum_\ell n_\ell Q_\ell+\alpha\lvert T\rvert$ | $\alpha\ge0$ | rem-dt-pruning |
計算の手順
決定木を訓練データから作る標準の手順(CART の形)は次のとおりである。
- 根に全データを置く。
- 節点 $v$ ごとに、すべての特徴量 $j$ について分割の候補を作る。実数の特徴量なら、$I_v$ のデータを $x_j$ の値で並べ、隣り合う異なる値の中点をしきい値の候補にする。カテゴリの特徴量なら、2 類のときは値を類 1 の割合で並べて前半と後半に分ける $L-1$ 通り(thm-dt-breiman)、3 類以上なら全部か近似で調べる。
- 各候補の利得(回帰なら prop-dt-regression の 2 乗誤差の減少)を計算し、最大のものを選ぶ。並べたあとは、しきい値を 1 つ右へずらすごとに左右の個数が 1 点分ずつ変わるだけなので、特徴量ごとに $O(n_v)$ 回の更新で全部の候補を計算できる。
- 止める条件(節点が純粋、データ数が決めた数より少ない、深さが上限など)を満たすまで、子の節点で 2・3 をくり返す。利得が $0$ というだけでは止めない(よくある誤りの表)。
- 大きく育てた木を、rem-dt-pruning の基準で剪定する。$\alpha$ は交差検証などで選ぶ。
- 各葉の値を、分類なら多数の類、回帰なら平均にする。
例題
2 類で $(400,400)$ 個のデータ(組は(類 0 の数, 類 1 の数))の節点を、分割 A では $(300,100)$ と $(100,300)$ に、分割 B では $(200,400)$ と $(200,0)$ に分ける(HTF09 §9.2.3 の例)。3 つの不純度で比べる。
使う公式:def-dt-impurity の加重不純度。
答え:誤分類率はどちらも $0.25$。Gini 係数は A が $0.375$、B が $\frac13\approx0.333333$。エントロピー(自然対数)は A が $0.562335$、B が $0.477386$。Gini 係数とエントロピーは純粋な子を作る B を選ぶ。
途中の計算を開く
A:各子の類 1 の割合は $\frac14$ と $\frac34$ で、誤分類率 $\frac14$、Gini 係数 $2\cdot\frac14\cdot\frac34=\frac38$、エントロピー $-\frac14\log\frac14-\frac34\log\frac34\approx0.562335$。重みは $\frac12$ ずつなので加重もこの値。B:子 $(200,400)$ は重み $\frac34$、割合 $\frac23$ で、誤分類率 $\frac13$、Gini 係数 $\frac49$、エントロピー $0.636514$。子 $(200,0)$ は重み $\frac14$ で純粋なので $0$。加重は誤分類率 $\frac34\cdot\frac13=\frac14$、Gini 係数 $\frac34\cdot\frac49=\frac13$、エントロピー $\frac34\cdot0.636514\approx0.477386$。
$x=1,2,\dots,8$ の 8 点に類 $(0,0,1,0,1,1,1,0)$ がついている。Gini 係数で最良のしきい値を求める。
使う公式:公式の表の「実数の特徴量の候補」、def-dt-impurity。
答え:候補は $1.5,2.5,\dots,7.5$ の 7 つで、加重 Gini 係数は順に $\frac37,\frac13,\frac7{15},\frac38,\frac7{15},\frac12,\frac37$。最良はしきい値 $2.5$(左 2 点はどちらも類 0、右 6 点のうち類 1 が 4 点)で、加重 Gini 係数 $\frac13\approx0.333333$、親の $\frac12$ からの利得 $\frac16\approx0.166667$。
途中の計算を開く
しきい値 $2.5$:左は純粋で $0$、右は割合 $\frac23$ で $2\cdot\frac23\cdot\frac13=\frac49$、重み $\frac68$ を掛けて $\frac13$。しきい値 $4.5$:左 4 点のうち類 1 は 1 点で $\frac38$、右 4 点のうち 3 点で $\frac38$、加重 $\frac38$。ほかも同様に、左右の個数と類 1 の数から計算する。
特徴量が 4 つの値 $a,b,c,d$ をとり、(データ数, 類 1 の数)が $a:(10,2)$、$b:(20,14)$、$c:(10,9)$、$d:(20,5)$ のとき、Gini 係数で最良の分割を求める。
使う公式:thm-dt-breiman。
答え:割合は $a:\frac15$、$d:\frac14$、$b:\frac7{10}$、$c:\frac9{10}$ なので、候補は $\{a\}\mid\{d,b,c\}$、$\{a,d\}\mid\{b,c\}$、$\{a,d,b\}\mid\{c\}$ の 3 つで、加重 Gini 係数(データ数で割ったもの)は順に $0.464$、$\frac{161}{450}\approx0.357778$、$0.436$。最良は $\{a,d\}\mid\{b,c\}$ で、全 7 通りの分割を調べた最小値と一致する。エントロピーでも同じ分割が最良になる。
途中の計算を開く
$\{a,d\}$ は 30 点で類 1 が 7 点、$\{b,c\}$ は 30 点で類 1 が 23 点。加重 Gini 係数は $\frac12\cdot2\cdot\frac7{30}\cdot\frac{23}{30}+\frac12\cdot2\cdot\frac{23}{30}\cdot\frac7{30}=\frac{161}{450}$。前半でない分割は $\{a,b\}\mid\{c,d\}$($0.497778$)、$\{a,c\}\mid\{b,d\}$($0.4975$)、$\{a,b,c\}\mid\{d\}$($0.4375$)、$\{a,c,d\}\mid\{b\}$($0.46$)で、どれも $\frac{161}{450}$ より大きい。親は 60 点で類 1 が 30 点、Gini 係数 $\frac12$。
$x=1,\dots,6$ で $y=(1,2,2,7,8,10)$ のとき、2 乗誤差で最良のしきい値を求める。
使う公式:prop-dt-regression。
答え:全体の平均は $5$、2 乗誤差の和は $72$。しきい値 $3.5$ で左の平均 $\frac53$、右の平均 $\frac{25}3$ に分けると、減少は $\frac{3\cdot3}6\bigl(\frac{20}3\bigr)^2=\frac{200}3$ で、残りは $\frac{16}3\approx5.333333$。ほかのしきい値($1.5,2.5,4.5,5.5$)の残りは $52.8$、$35.25$、$24$、$42$ で、$3.5$ が最良である。
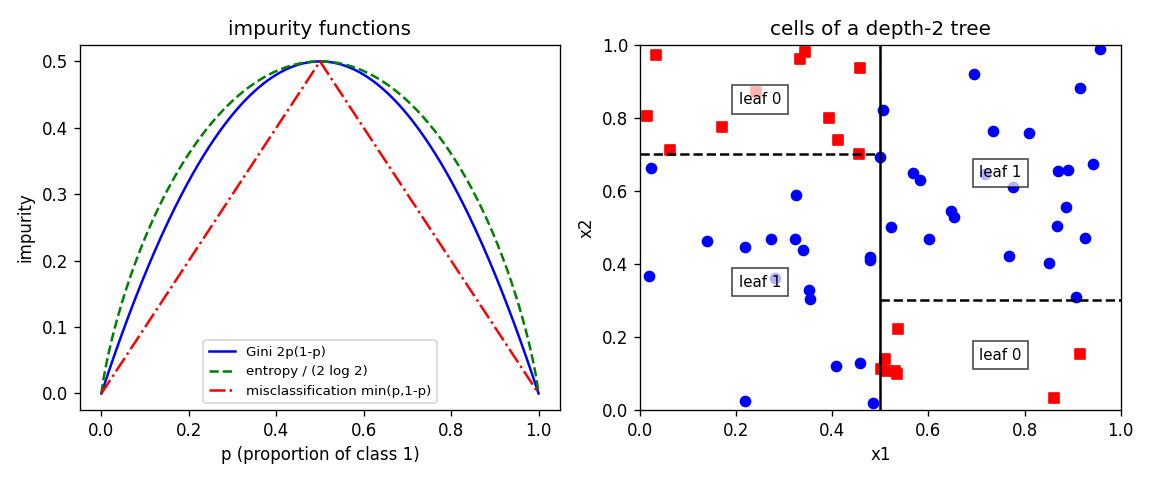 図: 左は 2 類の不純度を、類 1 の割合 p(横軸)の関数として描いたもの。Gini 係数 2p(1-p)(青の実線)、エントロピーを 2 log 2 で割って p=1/2 で 0.5 になるようにしたもの(緑の破線)、誤分類率 min(p,1-p)(赤の一点鎖線)。3 つとも p=0 と p=1 で 0、p=1/2 で最大の凹関数で、誤分類率だけが折れ線である。右は単位正方形の 60 点を、根の問い x1 < 0.5 と、左の子の問い x2 < 0.7、右の子の問い x2 < 0.3 の深さ 2 の木で 4 つのセル(長方形)に分けた様子。丸は類 1、四角は類 0 で、各セルに葉の値を書いた。
使える条件と反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 狭義凹(誤分類率は凹だが狭義凹でない) | $(100,300)$ を $(100,200)$ と $(0,100)$ に分ける | prop-dt-gain の後半「利得 $0$ なら子の割合が等しい」。割合は $\frac23$ と $1$ で異なるが、誤分類率の利得は $0$(Gini 係数では $\frac1{24}>0$) |
| 凹性($\varphi(p)=(p(1-p))^2$) | 割合 $0.1$ の節点を、割合 $0$ と $0.2$ の同じ大きさの子に分ける | prop-dt-gain の前半の不等式そのもの。親 $\frac{81}{10000}$、子の加重 $\frac8{625}=\frac{128}{10000}$ で、利得は負 |
| 凹性(同じ $\varphi$) | カテゴリ $a:(1,0)$、$b:(4,1)$、$c:(5,1)$((データ数, 類 1 の数)) | thm-dt-breiman の結論。割合の順は $a,c,b$ で、前半の分割 $\{a\}\mid\{c,b\}$、$\{a,c\}\mid\{b\}$ の $W/n$ は $\frac{98}{3645}$、$\frac{443}{17280}$ だが、前半でない $\{a,b\}\mid\{c\}$ は $\frac{16}{625}$ でより小さい |
反例の確かめを開く
1 行目:親の誤分類率は $\frac14$。子は重み $\frac34$ で誤分類率 $\frac13$、重み $\frac14$ で $0$ なので加重 $\frac14$。Gini 係数は親 $\frac38$、子の加重 $\frac34\cdot\frac49=\frac13$。2 行目:$\varphi(0.1)=0.09^2$、$\varphi(0.2)=0.16^2$。3 行目:$\{a,b\}$ は $(5,1)$、$\{c\}$ も $(5,1)$ で、$W/n=\varphi(\frac15)=\frac{16}{625}=0.0256$。$\{a,c\}=(6,1)$、$\{b\}=(4,1)$ で $\frac6{10}\varphi(\frac16)+\frac4{10}\varphi(\frac14)=\frac{443}{17280}\approx0.025637$。$\{a\}=(1,0)$、$\{c,b\}=(9,2)$ で $\frac9{10}\varphi(\frac29)=\frac{98}{3645}\approx0.026886$。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| どの分割も利得 $0$ なら、それ以上分けても良くならない | 2 段先で大きく良くなることがある | 2 つの 0/1 の特徴量の排他的論理和をラベルとする 4 点 $(0,0),(0,1),(1,0),(1,1)$(類 $0,1,1,0$)では、根のどの分割も子の割合が $\frac12$ で利得 $0$ だが、深さ 2 の木で誤りが $0$ になる |
| 貪欲に作った木は不純度や誤りの意味で最良 | 各節点で最良の分割を選ぶだけで、木全体は最良とは限らない | 上の例。最良の木を求める問題は計算量の意味で難しい(rem-dt-pruning) |
| 木は大きいほど良い | 訓練誤差は減るが汎化誤差は増えうる | 葉の数に制限がない木は任意の有限個の点を打ち砕く(rem-dt-pruning) |
| 誤分類率で木を育てる | 育てるときは Gini 係数かエントロピーを使う | 誤分類率は狭義凹でなく、純粋な子を作る分割を区別しない(ex-dt-compare、反例の表の 1 行目) |
| カテゴリの値を番号の大小で並べて分ける | 2 類なら類 1 の割合で並べる | thm-dt-breiman。番号の順に意味はない |
補足
葉 $\ell$ のデータ数を $n_\ell$、葉の不純度(回帰なら葉の平均 2 乗誤差)を $Q_\ell$、葉の数を $\lvert T\rvert$ とし、$\alpha\ge0$ について $C_\alpha(T)=\sum_\ell n_\ell Q_\ell+\alpha\lvert T\rvert$ を最小にする部分木(内部節点を葉に縮めて得られる木)を選ぶのが コスト複雑度剪定 である。各 $\alpha$ について $C_\alpha$ を最小にする最小の部分木はただ 1 つで、縮めたときの $\sum_\ell n_\ell Q_\ell$ の増え方(減る葉 1 つあたり)が最も小さい内部節点から順に縮めていく列の中にある(HTF09 §9.2.2、pp. 307–308。この記事では証明しない)。
木の大きさを制限する理由は次のとおりである。$\mathbb R^d$ で、第 1 座標が相異なる $k$ 点は、第 1 座標のしきい値で 1 点ずつ切り離す $k$ 個の葉の木で、どのラベルの付け方も実現できる($k$ 点を打ち砕く)。よって葉の数に制限のない木の族の VC次元 は無限である(SSBD14 §18.1)。また、特徴量が $0$ か $1$ の値をとる場合($X=\{0,1\}^d$)に、データへの当てはまりと節点の数の釣り合いを測る基準(SSBD14 式 (18.1))を最小にする木を求める問題は、P$\ne$NP なら多項式時間では解けない(SSBD14 §18.2 の脚注。この記事では証明しない)。このため実際の方法は貪欲な成長と剪定を組み合わせる。
多数の木を組み合わせる方法として、データの復元抽出と特徴量の無作為な制限で育てた多数の木の多数決をとるランダムフォレスト(SSBD14 §18.3)や、前の木の誤りに重みをかけて次の木を育てる ブースティング がある。
文献
HTF09 §9.2.2–9.2.4(pp. 307–310)、SSBD14 第 18 章(§18.1、§18.2 と式 (18.1)、§18.2.1、§18.3)。
関連項目
- 前提: 二分木, 凸関数, Jensenの不等式
- 比較: サポートベクターマシン, カーネル法
- 発展: ブースティング, VC次元
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

