一般化線形モデル
概要
一般化線形モデル(generalized linear model)とは、応答 $y_i$ が指数分散型の分布(正規・Poisson・二項・ガンマ分布など)に従い、その平均 $\mu_i$ をリンク関数 $g$ で変換した $g(\mu_i)$ が説明変数の 1 次式 $x_i^{\mathsf T}\beta$ で表されるとする回帰のモデルである。Poisson 回帰・ロジスティック回帰・線形回帰を含む。係数は最尤法で推定し、Fisher のスコア法の更新が重み付き最小二乗になる反復重み付き最小二乗法(IRLS)で計算する。正準リンクでは対数尤度が凹で解は一意、当てはまりは逸脱度で測る。
回帰分析 の線形回帰は、応答 $y$ が正規分布に従い、その平均が説明変数の 1 次式 $x^{\mathsf T}\beta$ で表されると仮定する。しかし、ある日の事故の件数($0,1,2,\dots$ の値をとる)や、$n$ 匹のうち反応した割合($0$ と $1$ の間)では、平均を 1 次式で直接表すと負の値や $1$ を超える値が出てしまい、分散も平均とともに変わる。一般化線形モデル(generalized linear model, GLM)は、応答の分布を正規分布から 指数型分布族 に広げ、平均 $\mu$ を リンク関数 $g$ で変換したもの $g(\mu)$ を 1 次式で表す。Poisson 分布と対数リンクなら Poisson 回帰、二項分布とロジットリンクならロジスティック回帰、正規分布と恒等リンクなら通常の線形回帰になる。この枠組みは J. A. Nelder と R. W. M. Wedderburn(1972)による(Bis06 p. 213)。
母数は最尤法で推定する。尤度方程式は一般に非線形だが、Fisher のスコア法(Newton 法のヘッセ行列をその期待値で置き換えたもの)の 1 回の更新は、重みと応答を作り直した 重み付き最小二乗 になる。この 反復重み付き最小二乗法(IRLS)で、どのモデルも同じ計算の手順で当てはめられる。当てはまりの悪さは、正規分布の残差平方和を一般化した 逸脱度 で測る。
この記事では、モデルを定義し、スコアと Fisher 情報行列の公式、IRLS が Fisher のスコア法と一致すること、正準リンクで対数尤度が凹になること、逸脱度が非負であることを証明し、Poisson 回帰とロジスティック回帰の例を数値まで計算する。
定義と使える条件
$\Theta\subset\mathbb{R}$ を開区間、$b\colon\Theta\to\mathbb{R}$ を 2 回微分可能で $b''>0$ の関数とする。$\theta\in\Theta$ と $\phi>0$ について、$\mathbb{R}$ 上の測度 $\nu$(Lebesgue 測度か数え上げ測度)に関する密度
$$
f(y;\theta,\phi)=\exp\Bigl(\frac{y\theta-b(\theta)}{\phi}+c(y,\phi)\Bigr)
$$
をもつ分布の族を 指数分散型の分布族 という。$\theta$ を 正準母数、$\phi$ を 分散母数 という。
$\phi$ を固定すると、これは自然母数 $\zeta=\theta/\phi$、十分統計量 $y$、キュムラント関数 $A(\zeta)=b(\phi\zeta)/\phi$ の 1 母数の指数型分布族である($\zeta\in\Theta/\phi$ で $\log\int e^{\zeta y+c(y,\phi)}\,\nu(dy)=b(\phi\zeta)/\phi$ が密度の積分が $1$ であることから従う)。
$y$ が密度 $f(y;\theta,\phi)$ に従えば $E[y]=b'(\theta)$、$\operatorname{Var}(y)=\phi\,b''(\theta)$ である。$\mu:=b'(\theta)$ は $\theta$ の狭義増加関数なので逆関数 $\theta=(b')^{-1}(\mu)$ があり、$V(\mu):=b''\bigl((b')^{-1}(\mu)\bigr)$ を 分散関数 という。$\operatorname{Var}(y)=\phi V(\mu)$ である。
指数型分布族 の補題「キュムラント関数の微分」により、平均は $A'(\zeta)=b'(\phi\zeta)=b'(\theta)$、分散は $A''(\zeta)=\phi\,b''(\phi\zeta)=\phi\,b''(\theta)$ である($\Theta/\phi$ は開区間で自然母数空間に含まれるので、$\zeta$ はその内部にある)。$b''>0$ から $b'$ は狭義増加である。$\square$
観測 $(x_i,y_i)$($i=1,\dots,n$、$x_i\in\mathbb{R}^p$)について、次の 3 つを仮定するモデルを 一般化線形モデル という。
- ランダムな部分:$y_1,\dots,y_n$ は独立で、$y_i$ は密度 $f(y;\theta_i,\phi/\omega_i)$ に従う。$\omega_i>0$ は既知の重み(二項分布の試行回数など)、$\phi$ は全観測に共通である。
- 線形予測子:$\eta_i:=x_i^{\mathsf T}\beta$($\beta\in\mathbb{R}^p$ は未知の係数)。
- リンク関数:狭義単調で 2 回微分可能な関数 $g$ により $g(\mu_i)=\eta_i$、$\mu_i:=E[y_i]$。
$g=(b')^{-1}$、すなわち $\theta_i=\eta_i$ となるリンクを 正準リンク という。
$x_i$ を行に並べた $n\times p$ の行列を $X$ と書く。この記事の結果を使ってよい条件は次のとおりである。
- (i) $X$ の列が 1 次独立(階数 $p$)である。
- (ii) 各 $\eta_i$ が $g$ の値域に入り、$\mu_i=g^{-1}(\eta_i)$ が $b'$ の値域に入る。
- (iii) 対数尤度の凹性と最尤推定量の一意性(thm-glm-canonical)は正準リンクのとき。
- (iv) 最尤推定量の存在は別に確かめる。データが線形分離できるロジスティック回帰などでは存在しない(ex-glm-separation)。
公式の表
主な分布(確率分布の一覧)を指数分散型に書くと次のようになる。$d(y,\mu)$ は単位逸脱度(prop-glm-deviance)である。
| 分布 | $\theta(\mu)$ | $b(\theta)$ | $V(\mu)$ | $\phi/\omega$ | 正準リンク | $d(y,\mu)$ |
|---|---|---|---|---|---|---|
| 正規分布 $N(\mu,\sigma^2)$ | $\mu$ | $\theta^2/2$ | $1$ | $\sigma^2$ | 恒等 $\mu$ | $(y-\mu)^2$ |
| Poisson 分布 | $\log\mu$ | $e^\theta$ | $\mu$ | $1$ | 対数 $\log\mu$ | $2\bigl(y\log\frac y\mu-(y-\mu)\bigr)$ |
| 二項分布の割合(試行 $m$ 回) | $\log\frac\mu{1-\mu}$ | $\log(1+e^\theta)$ | $\mu(1-\mu)$ | $1/m$ | ロジット $\log\frac\mu{1-\mu}$ | $2\bigl(y\log\frac y\mu+(1-y)\log\frac{1-y}{1-\mu}\bigr)$ |
| ガンマ分布(形 $\alpha$) | $-1/\mu$ | $-\log(-\theta)$ | $\mu^2$ | $1/\alpha$ | 逆数 $-1/\mu$ | $2\bigl(\frac{y-\mu}\mu-\log\frac y\mu\bigr)$ |
$y=0$ では $y\log y=0$ と読む。ガンマ分布では正準リンクより対数リンク $\log\mu$ がよく使われる($\eta$ の符号の制約がない)。
| 量 | 式 | 使える条件 | 根拠 |
|---|---|---|---|
| スコア | $U(\beta)=\frac1\phi\sum_i\frac{\omega_i(y_i-\mu_i)}{V(\mu_i)g'(\mu_i)}x_i$ | (ii) | thm-glm-score |
| Fisher 情報行列 | $\mathcal I(\beta)=\frac1\phi X^{\mathsf T}WX$、$W=\operatorname{diag}\Bigl(\frac{\omega_i}{V(\mu_i)g'(\mu_i)^2}\Bigr)$ | (ii) | thm-glm-score |
| IRLS の 1 回の更新 | $\beta^{\mathrm{new}}=(X^{\mathsf T}WX)^{-1}X^{\mathsf T}Wz$、$z_i=\eta_i+(y_i-\mu_i)g'(\mu_i)$ | (i)(ii) | thm-glm-irls |
| 正準リンクの尤度方程式 | $X^{\mathsf T}\Omega(y-\hat\mu)=0$、$\Omega=\operatorname{diag}(\omega_i)$ | (i)(ii) | thm-glm-canonical |
| 逸脱度 | $D=\sum_i\omega_id(y_i,\hat\mu_i)$、$d(y,\mu)=2\int_\mu^y\frac{y-t}{V(t)}\,dt\ge0$ | (ii) | prop-glm-deviance |
| Pearson 統計量 | $\chi^2_{\mathrm P}=\sum_i\omega_i(y_i-\hat\mu_i)^2/V(\hat\mu_i)$ | (ii) | 定義 |
| $\phi$ の推定 | $\hat\phi=\chi^2_{\mathrm P}/(n-p)$ | $\phi$ が未知 | 定義(モーメント法) |
| $\hat\beta$ の近似的な共分散 | $\phi(X^{\mathsf T}\hat WX)^{-1}$ | 大標本、モデルが正しい | 証明しない(rem-glm-asymptotics) |
| 入れ子のモデルの比較 | $(D_0-D_1)/\phi$ は近似的に自由度 $p_1-p_0$ のカイ二乗分布 | 大標本、小さいモデルが正しい | 証明しない(rem-glm-asymptotics) |
主定理と証明
以下、$\ell(\beta)=\sum_i\ell_i$、$\ell_i:=\frac{\omega_i}\phi\bigl(y_i\theta_i-b(\theta_i)\bigr)+c(y_i,\phi/\omega_i)$ を対数尤度とする。$\theta_i$ は $\mu_i=g^{-1}(x_i^{\mathsf T}\beta)$ を通じて $\beta$ の関数である。
(ii) の下で、スコア $U(\beta):=\nabla_\beta\ell(\beta)$ と Fisher 情報行列 $\mathcal I(\beta):=E[U(\beta)U(\beta)^{\mathsf T}]$ は
$$
U(\beta)=\frac1\phi\sum_{i=1}^n\frac{\omega_i(y_i-\mu_i)}{V(\mu_i)g'(\mu_i)}x_i,\qquad\mathcal I(\beta)=\frac1\phi X^{\mathsf T}WX,\quad W=\operatorname{diag}\Bigl(\frac{\omega_i}{V(\mu_i)g'(\mu_i)^2}\Bigr)
$$
である。$E[U(\beta)]=0$ である。
$\frac{\partial\ell_i}{\partial\theta_i}=\frac{\omega_i}\phi(y_i-b'(\theta_i))=\frac{\omega_i}\phi(y_i-\mu_i)$ である。$\mu=b'(\theta)$ から $\frac{d\mu}{d\theta}=b''(\theta)=V(\mu)$、$g(\mu)=\eta$ から $\frac{d\mu}{d\eta}=\frac1{g'(\mu)}$、$\eta_i=x_i^{\mathsf T}\beta$ から $\nabla_\beta\eta_i=x_i$ である。逆関数の微分と連鎖律により
$$
\nabla_\beta\ell_i=\frac{\partial\ell_i}{\partial\theta_i}\cdot\frac{d\theta_i}{d\mu_i}\cdot\frac{d\mu_i}{d\eta_i}\cdot x_i=\frac{\omega_i(y_i-\mu_i)}{\phi\,V(\mu_i)g'(\mu_i)}x_i
$$
で、和をとれば $U$ の式を得る。$E[y_i]=\mu_i$ から $E[U]=0$ である。$y_i$ は独立なので、$i\ne j$ の交差項の期待値は $E[y_i-\mu_i]E[y_j-\mu_j]=0$ で消える。lem-glm-moments により $\operatorname{Var}(y_i)=\frac\phi{\omega_i}V(\mu_i)$ だから
$$
\mathcal I(\beta)=\sum_i\frac{\omega_i^2\operatorname{Var}(y_i)}{\phi^2V(\mu_i)^2g'(\mu_i)^2}x_ix_i^{\mathsf T}=\frac1\phi\sum_i\frac{\omega_i}{V(\mu_i)g'(\mu_i)^2}x_ix_i^{\mathsf T}=\frac1\phi X^{\mathsf T}WX.\ \square
$$
(i)(ii) の下で、$W$ の対角成分は正なので $X^{\mathsf T}WX$ は正定値である。現在の値 $\beta$ から Fisher のスコア法で更新した $\beta^{\mathrm{new}}:=\beta+\mathcal I(\beta)^{-1}U(\beta)$ は
$$
\beta^{\mathrm{new}}=(X^{\mathsf T}WX)^{-1}X^{\mathsf T}Wz,\qquad z_i:=\eta_i+(y_i-\mu_i)g'(\mu_i)
$$
に等しい。すなわち、応答 $z$(作業応答)を重み $W$ で $X$ に回帰した重み付き最小二乗の解である。$\phi$ は更新に現れない。
$W$ の第 $i$ 対角成分 $w_i$ について $w_i(y_i-\mu_i)g'(\mu_i)=\frac{\omega_i(y_i-\mu_i)}{V(\mu_i)g'(\mu_i)}$ なので、$r_i:=(y_i-\mu_i)g'(\mu_i)$ とおくと $U(\beta)=\frac1\phi X^{\mathsf T}Wr$ である。$v\ne0$ なら $v^{\mathsf T}X^{\mathsf T}WXv=\sum_iw_i(x_i^{\mathsf T}v)^2>0$($Xv\ne0$ は (i) による)なので正定値。よって
$$
\beta+\mathcal I^{-1}U=\beta+(X^{\mathsf T}WX)^{-1}X^{\mathsf T}Wr=(X^{\mathsf T}WX)^{-1}X^{\mathsf T}W(X\beta+r)
$$
であり、$X\beta+r=z$ である。重み付き最小二乗 $\min_\gamma\sum_iw_i(z_i-x_i^{\mathsf T}\gamma)^2$ の正規方程式は $X^{\mathsf T}WX\gamma=X^{\mathsf T}Wz$ なので、その解に一致する。$\square$
正準リンクと (i)(ii) を仮定する。このとき
- $U(\beta)=\frac1\phi X^{\mathsf T}\Omega(y-\mu)$、ヘッセ行列は $\nabla^2\ell(\beta)=-\frac1\phi X^{\mathsf T}\operatorname{diag}\bigl(\omega_iV(\mu_i)\bigr)X=-\mathcal I(\beta)$ で、$y$ によらない。したがって Newton 法と Fisher のスコア法(IRLS)は同じ更新を与える。
- $\ell$ は $\beta$ について狭義凹であり、最尤推定量は存在すればただ 1 つで、尤度方程式 $X^{\mathsf T}\Omega(y-\hat\mu)=0$ の唯一の解である。
- $X$ が定数の列を含めば $\sum_i\omega_iy_i=\sum_i\omega_i\hat\mu_i$ である。
正準リンクでは $\theta_i=\eta_i=x_i^{\mathsf T}\beta$ なので、$\ell(\beta)=\frac1\phi\sum_i\omega_i\bigl(y_ix_i^{\mathsf T}\beta-b(x_i^{\mathsf T}\beta)\bigr)+(\beta\text{ によらない項})$ である。微分して
$$
\nabla\ell=\frac1\phi\sum_i\omega_i\bigl(y_i-b'(\theta_i)\bigr)x_i=\frac1\phi X^{\mathsf T}\Omega(y-\mu),\qquad\nabla^2\ell=-\frac1\phi\sum_i\omega_ib''(\theta_i)x_ix_i^{\mathsf T}.
$$
$b''(\theta_i)=V(\mu_i)$ であり、正準リンクでは $g'(\mu)=\frac{d\theta}{d\mu}=\frac1{V(\mu)}$ なので $W$ の成分は $\frac{\omega_i}{V(\mu_i)\cdot V(\mu_i)^{-2}}=\omega_iV(\mu_i)$ となり、$\nabla^2\ell=-\mathcal I$ である。Newton 法の更新 $\beta-(\nabla^2\ell)^{-1}\nabla\ell$ は Fisher のスコア法の更新 $\beta+\mathcal I^{-1}U$ と同じである。これが 1 である。
2:$v\ne0$ なら $-v^{\mathsf T}\nabla^2\ell\,v=\frac1\phi\sum_i\omega_iV(\mu_i)(x_i^{\mathsf T}v)^2>0$((i) と $V>0$)なので、ヘッセ行列は至る所で負定値であり、$\ell$ は狭義凹である。狭義凹関数の最大点は高々 1 つで、内点での最大点は勾配が $0$ の点と一致する(凸関数)。
3:定数の列を $v=(1,\dots,1)^{\mathsf T}$ とすると、尤度方程式の $v$ の行が $\sum_i\omega_i(y_i-\hat\mu_i)=0$ である。$\square$
$y$ が $b'$ の値域に入るとき、$\ell^{\mathrm{unit}}(\mu;y):=y\theta(\mu)-b(\theta(\mu))$($\theta(\mu)=(b')^{-1}(\mu)$)は $\mu=y$ で最大になり、
$$
d(y,\mu):=2\bigl(\ell^{\mathrm{unit}}(y;y)-\ell^{\mathrm{unit}}(\mu;y)\bigr)=2\int_\mu^y\frac{y-t}{V(t)}\,dt\ge0
$$
で、等号は $\mu=y$ のときに限る。各 $\mu_i$ を自由に選べるモデル(飽和モデル、$\hat\mu_i=y_i$)とモデルの当てはめ $\hat\mu_i$ の対数尤度の差の $2\phi$ 倍が 逸脱度 $D:=\sum_i\omega_id(y_i,\hat\mu_i)$ である。
$\frac{d}{dt}\ell^{\mathrm{unit}}(t;y)=(y-b'(\theta(t)))\theta'(t)=\frac{y-t}{V(t)}$ である($\theta'(t)=1/V(t)$)。微分積分学の基本定理により差は $\int_\mu^y\frac{y-t}{V(t)}dt$ である。$\mu< y$ なら積分区間で $y-t>0$、$\mu>y$ なら向きが逆で $y-t< 0$ なので、どちらでも積分は正であり、$\mu=y$ なら $0$ である。対数尤度の差については、$c(y_i,\phi/\omega_i)$ は $\mu$ によらないので打ち消し合い、$2\phi\bigl(\ell(\text{飽和})-\ell(\hat\mu)\bigr)=2\sum_i\omega_i\bigl(\ell^{\mathrm{unit}}(y_i;y_i)-\ell^{\mathrm{unit}}(\hat\mu_i;y_i)\bigr)=D$ である。$\square$
表の単位逸脱度は、この積分を $V(t)=1,\,t,\,t(1-t),\,t^2$ について計算したものである。$y$ が $b'$ の値域の端(Poisson 分布の $y=0$ など)にあるときは、$y$ を端に近づけた極限($y\log y\to0$)として同じ式を使い、そのときも $d(y,\mu)>0$($\mu\ne y$)である。
モデルが正しく、標本が大きいとき、$\hat\beta$ は真の値に近く、近似的に平均 $\beta$、共分散 $\mathcal I(\hat\beta)^{-1}=\phi(X^{\mathsf T}\hat WX)^{-1}$ の正規分布に従う(ロジスティック回帰について HTF09 §4.4.3、p. 125。1 母数の指数型分布族の場合は 最尤推定 の定理「指数型分布族の最尤推定量」)。入れ子のモデルの逸脱度の差 $(D_0-D_1)/\phi$ は、対数尤度比の 2 倍なので、尤度比検定 の注意「一般の Wilks の定理」により近似的にカイ二乗分布に従う。これらはこの記事では証明しない。
計算の手順
- 分布とリンクを選び、$b'$、$V$、$g$、$g'$、単位逸脱度を表から用意する。重み $\omega_i$(二項分布の割合なら試行回数)を決める。
- 初期値:$\hat\mu_i^{(0)}:=y_i$ を値域の内側に少しずらしたもの(Poisson なら $y_i+0.5$、二項の割合なら $(m_iy_i+0.5)/(m_i+1)$)とし、$\eta_i^{(0)}=g(\hat\mu_i^{(0)})$ とおく。$\beta=0$ から始めるより反復が少ない(ex-glm-poisson)。
- 現在の $\eta_i,\mu_i$ から作業応答 $z_i=\eta_i+(y_i-\mu_i)g'(\mu_i)$ と重み $w_i=\omega_i/(V(\mu_i)g'(\mu_i)^2)$ を作る(thm-glm-irls)。
- 重み付き最小二乗 $X^{\mathsf T}WX\beta=X^{\mathsf T}Wz$ を解く($W^{1/2}X$ の QR 分解で解くと安定)。新しい $\eta=X\beta$、$\mu=g^{-1}(\eta)$。
- 逸脱度 $D$ の変化が許容誤差(たとえば相対値 $10^{-8}$)より小さくなるまで 3〜4 を繰り返す。$D$ が増えたら更新の幅を半分にする。反復の上限(たとえば $25$ 回)に達しても止まらず係数が増え続けるなら、最尤推定量が存在しない(完全分離など)ことを疑う(ex-glm-separation)。
- 収束したら、標準誤差を $\sqrt{\hat\phi\,[(X^{\mathsf T}\hat WX)^{-1}]_{jj}}$($\phi$ が既知なら $\hat\phi=\phi$)、当てはまりを $D$ と $\chi^2_{\mathrm P}$ で、入れ子のモデルの比較を逸脱度の差で行う(rem-glm-asymptotics)。
例題
正規分布・恒等リンクでは $g'=1$、$V=1$ なので $z_i=y_i$、$w_i=\omega_i$ で、IRLS はどの初期値からも 1 回の更新で(重み付き)最小二乗推定量に達する。逸脱度は残差平方和 $\sum_i\omega_i(y_i-\hat\mu_i)^2$ である。
使う公式:thm-glm-irls、表の正規分布の行。
答え:$x=(0,1,2,3,4)$、$y=(1.0,2.5,2.9,4.2,5.1)$ に定数項と傾きを当てはめると、初期値 $\beta=(10,-3)$ からでも 1 回で $\hat\beta=(1.16,\,0.99)$ になる。
$x=(0,1,2,3,4)$ で件数 $y=(2,3,6,7,12)$ を観測した。Poisson 分布・対数リンク $\log\mu_i=\beta_0+\beta_1x_i$ を当てはめる。
使う公式:手順 2〜6、thm-glm-canonical、prop-glm-deviance。
答え:$\hat\beta=(0.75008,\,0.43132)$、標準誤差 $(0.44427,\,0.14465)$。$x$ が $1$ 増えると平均件数は $e^{0.43132}\approx1.53928$ 倍になる。当てはめ $\hat\mu=(2.11718,3.25893,5.01641,7.72167,11.88581)$、逸脱度 $D\approx0.27985$(自由度 $3$)、Pearson 統計量 $\chi^2_{\mathrm P}\approx0.28846$。定数だけのモデルの逸脱度は $10.24031$ で、差 $9.96046$ は自由度 $1$ のカイ二乗分布の上側確率 $\approx0.0016$ にあたる。
途中の計算を開く
正準リンクなので $w_i=\mu_i$、$z_i=\eta_i+(y_i-\mu_i)/\mu_i$。初期値 $\mu^{(0)}=y+0.5$ からの反復は、1 回目 $\beta=(0.77004,0.42696)$、$D=0.282577$、2 回目 $(0.75025,0.43127)$、$D=0.2798533$、3 回目 $(0.75008,0.43132)$、$D=0.2798532$ で、以後は小数 5 桁で変わらない。$\beta=0$($D\approx67.75$)から更新の幅を半分にせずに反復すると、1 回目で $D$ が $39308$ に跳ね上がってから下がり、小数 5 桁でそろうまで 11 回かかる(手順 5 の半減はこれを防ぐためのものである)。thm-glm-canonical の 3 により $\sum\hat\mu_i=\sum y_i=30$、$\sum x_i\hat\mu_i=\sum x_iy_i=84$ が成り立っている。標準誤差は $(X^{\mathsf T}\operatorname{diag}(\hat\mu)X)^{-1}$ の対角成分の平方根($\phi=1$)。
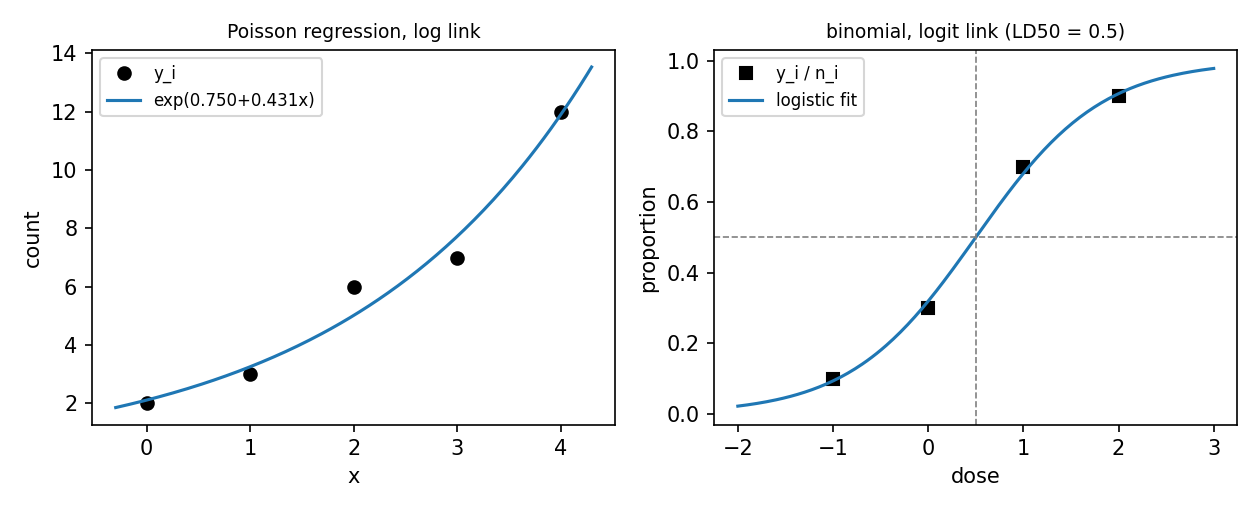 図: 左は5点の件数のデータと、指数関数の曲線 exp(0.750+0.431x) の当てはめ。右は4つの用量での成功の割合 0.1、0.3、0.7、0.9 と、S字形のロジスティック曲線の当てはめで、曲線は用量 0.5 で割合 0.5 を通る
用量 $x=(-1,0,1,2)$ でそれぞれ $m=10$ 匹に投与し、反応したのは $(1,3,7,9)$ 匹であった。二項分布の割合 $y_i=(\text{反応数})/10$、重み $\omega_i=10$、ロジットリンク $\log\frac{\mu_i}{1-\mu_i}=\beta_0+\beta_1x_i$ を当てはめる。
使う公式:手順 2〜6、thm-glm-canonical。
答え:$\hat\beta=(-0.75696,\,1.51391)$、標準誤差 $(0.46526,\,0.45161)$、当てはめの割合 $(0.09356,0.31931,0.68069,0.90644)$、逸脱度 $\approx0.04426$(自由度 $2$)。半数が反応する用量(LD50)$-\hat\beta_0/\hat\beta_1$ はちょうど $0.5$ である。
途中の計算を開く
$\beta=0$ から始めて、1 回目 $(-0.56,1.12)$、2 回目 $(-0.72501,1.45002)$、3 回目 $(-0.75598,1.51195)$、4 回目 $(-0.75696,1.51391)$。LD50 が $0.5$ になるのは対称性による:データは $x\mapsto1-x$、反応数 $\mapsto10-$反応数 で不変なので、$(\beta_0,\beta_1)$ が解なら $(-\beta_0-\beta_1,\beta_1)$ も尤度方程式の解であり、thm-glm-canonical の 2(一意性)から $\beta_0=-\beta_0-\beta_1$、すなわち $\beta_0+0.5\beta_1=0$。
使える条件と反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| データが分離されていない((iv)) | ロジスティック回帰、$x=(-2,-1,1,2)$、$y=(0,0,1,1)$、$\eta=\beta_0+\beta_1x$ | $\ell(0,t)\to0$($t\to\infty$)だが $\ell< 0$ なので最大値をとらず、最尤推定量が存在しない。IRLS の傾きは反復ごとにおよそ $1$ ずつ増え続ける |
| $X$ の列が 1 次独立((i)) | 説明変数の列 $x$ と $2x$ を両方入れる | $X^{\mathsf T}WX$ が特異で IRLS の更新が定まらず(thm-glm-irls)、$\beta$ は識別できない($\beta_1+2\beta_2$ だけが決まる) |
| 分散が $\phi V(\mu)$(lem-glm-moments) | 定数だけの Poisson 回帰に、平均 $5$・分散 $15$ の負の二項分布の $n=50$ 個のデータを当てはめる | thm-glm-score の $\mathcal I=E[UU^{\mathsf T}]$ が $3$ 倍ずれ、モデルの標準誤差 $1/\sqrt{n\mu}\approx0.0632$ に対し $\hat\beta_0$ の実際の標準偏差は $\approx0.110$(比 $\approx\sqrt3$) |
| 正準リンク(thm-glm-canonical の 1) | Poisson 分布・恒等リンク $\mu_i=\beta x_i$、$x=(1,2)$、$y=(3,2)$、$\beta=2$ | 観測情報 $-\ell''(\beta)=\sum y_ix_i^2/\mu_i^2=1.25$ が Fisher 情報 $\sum x_i^2/\mu_i=1.5$ と違い、Newton 法と IRLS の更新が一致しない |
1 行目:$\ell(\beta)=\sum_i\bigl(y_i\eta_i-\log(1+e^{\eta_i})\bigr)$ で、$\beta=(0,t)$ なら $\ell=-2\log(1+e^{-t})-2\log(1+e^{-2t})$。$t=1,5,10$ で $\ell\approx-0.880,\ -0.0135,\ -9.08\times10^{-5}$ と $0$ に近づく。どの $\beta$ でも各項は負なので $\ell< 0$ で、上限 $0$ は達成されない。IRLS($\mu^{(0)}=(0.25,0.25,0.75,0.75)$ から)の傾きは $1.459,2.297,3.205,4.165,\dots$ で、12 回目に $12.14$ である。外した条件は分離していないことだけで、$X$ の階数は $2$、リンクは正準である。
2 行目:$X=(1,x,2x)$ では $X(0,2,-1)^{\mathsf T}=0$ なので階数が落ちる。
3 行目:負の二項分布(成功確率 $r/(r+5)$、$r=2.5$)は平均 $5$、分散 $5+5^2/2.5=15$。$\hat\beta_0=\log\bar y$ の標準偏差を 20000 回の乱数の反復(種 $20261105$)で求めると $0.1097$、Pearson 統計量を自由度で割った平均は $2.97$ で、$\hat\phi\approx3$ と推定すれば標準誤差を $\sqrt{\hat\phi}$ 倍に補正できる。外したのは分散の形だけで、平均の構造(定数の対数リンク)は正しい。
4 行目:$\ell(\beta)=\sum_i(y_i\log(\beta x_i)-\beta x_i)$ から $-\ell''(\beta)=\sum_iy_i/\beta^2=5/4$、一方 $\mathcal I(\beta)=\sum_ix_i^2/(V(\mu_i)g'(\mu_i)^2)=\sum_ix_i^2/\mu_i=\frac12+1$。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 対数リンクの係数 $\beta_1$ を「$x$ が $1$ 増えたときの件数の増加量」と読む | 平均が $e^{\beta_1}$ 倍になる | $\mu=e^{\beta_0+\beta_1x}$(ex-glm-poisson) |
| $\log y$ を通常の最小二乗で回帰すれば Poisson 回帰と同じとする | 一般化線形モデルは $g(E[y])$ を 1 次式で表す。$E[\log y]\ne\log E[y]$ で、$y=0$ では $\log y$ が定義されない | def-glm-model |
| 収束しないので反復の上限を増やす | 完全分離などで最尤推定量が存在しないことを疑う | ex-glm-separation |
| 件数のデータで過分散を無視する | $\hat\phi=\chi^2_{\mathrm P}/(n-p)$ を推定して標準誤差を $\sqrt{\hat\phi}$ 倍する | 反例の表の 3 行目 |
| 逸脱度の差を、試行回数や平均が小さいときもカイ二乗分布で判定する | 大標本の近似なので、小さい件数では正確検定やシミュレーションで確かめる | rem-glm-asymptotics |
補足
- 線形判別分析との関係。 共通の共分散をもつ正規分布の群では、事後確率の対数オッズが $x$ の 1 次式になる(線形判別分析)。ロジスティック回帰は同じ形を、$x$ の分布を仮定せずに条件付き尤度だけから推定する。
- ほかのリンク。 二項分布では標準正規分布の分布関数の逆関数をリンクにしたプロビット回帰もある(Bis06 §4.3.5、pp. 210–211)。多群の応答はソフトマックス関数で多項分布に広げ、IRLS も行列の重みで同じ形になる(Bis06 §4.3.4、pp. 209–210)。
- 正則化。 対数尤度に $\lambda\sum_j\lvert\beta_j\rvert$ の罰則を付けると、IRLS の各段を重み付きの LASSO で解く方法になる(HTF09 §4.4.4、pp. 125–126)。
関連項目
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

