Huffman符号
概要
Huffman符号(Huffman code)とは、記号ごとの出現確率が分かっているとき、確率の最も小さい 2 つを 1 つにまとめる操作を 1 つになるまで繰り返して二分木を作り、根から葉までの道を 0 と 1 の列として各記号に割り当てる接頭符号である。記号を 1 つずつ符号語に置き換えて一意に復号できる符号の中で、確率で重み付けた平均の長さを最小にする。たとえば確率 $0.4,0.2,0.2,0.1,0.1$ の 5 記号では平均 $2.2$ bit となり、固定長の 3 bit より短い。平均の長さ $L$ はエントロピー $H$ と $H\le L< H+1$ の関係にあり、記号数 $m$ に対し $O(m\log m)$ の手間で作れるので、データ圧縮の基本的な手法として使われる。
5 種類の文字 a, b, c, d, e がそれぞれ確率 $0.4,0.2,0.2,0.1,0.1$ で現れる文書を 0 と 1 の列に直す。どの文字にも 3 bit の符号語を割り当てれば 1 文字あたり 3 bit かかる。よく出る文字に短い符号語を、まれな文字に長い符号語を割り当てると、たとえば a=00, b=10, c=11, d=010, e=011 で 1 文字あたり平均 $2.2$ bit になる。しかもこの $2.2$ は、文字を 1 つずつ符号語に置き換えて、受け取った列から元の文書を一意に復元できる方法の中で最小である。この最小の割り当てを機械的に作る手順が Huffman 符号(Huffman code)である。
手順はきわめて単純で、「確率の最も小さい 2 つを 1 つにまとめる」ことを 1 つになるまで繰り返すだけである。この記事では、符号と二分木の対応を定め、Huffman 符号が接頭符号の中で平均の長さを最小にすること(最適性)を完全に証明する。さらに McMillan の不等式を証明して、一意に復号できるすべての符号の中でも最適であることを示し、平均の長さとエントロピーの関係、計算の手間を述べる。
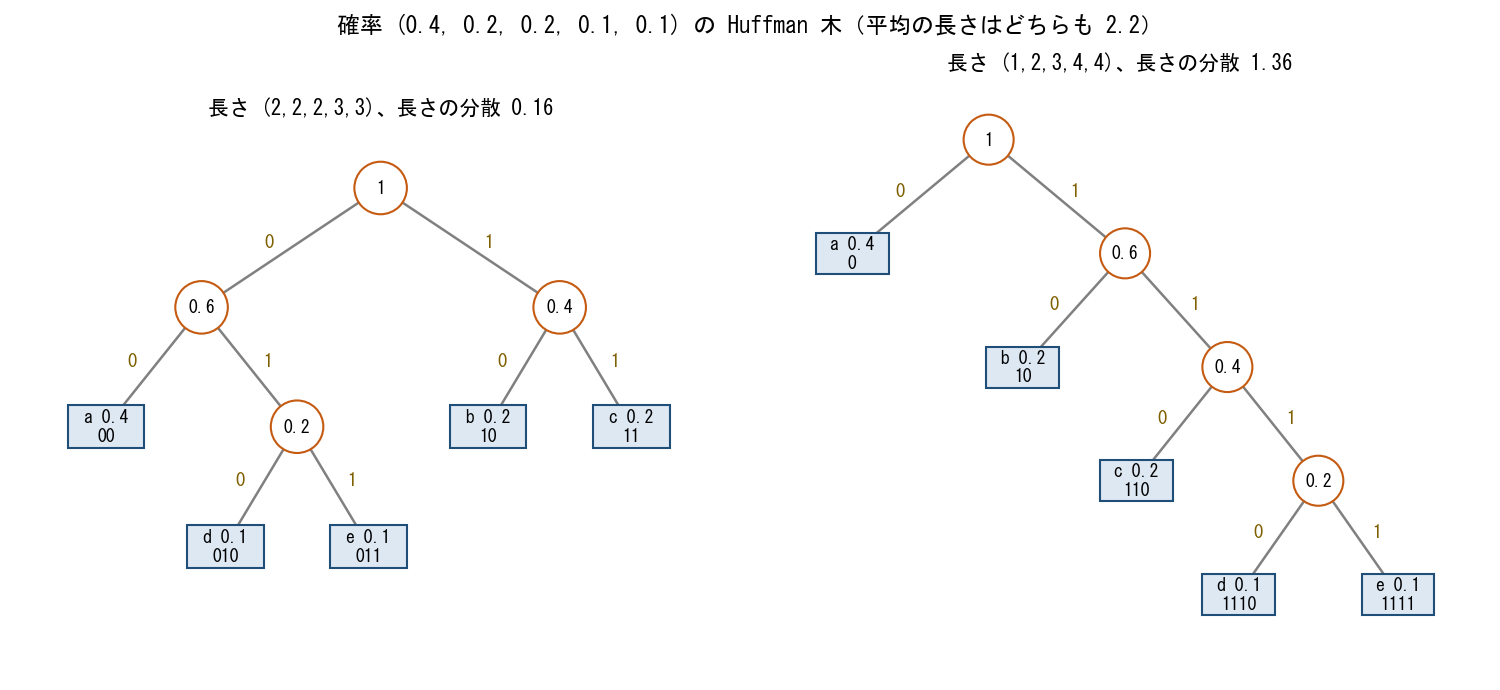 図: 確率 0.4, 0.2, 0.2, 0.1, 0.1 の 5 文字 a, b, c, d, e について作った 2 つの Huffman 木。左の木では a, b, c が深さ 2、d, e が深さ 3 の葉で、符号語は 00, 10, 11, 010, 011 である。右の木では a, b, c, d, e がそれぞれ深さ 1, 2, 3, 4, 4 の葉で、符号語は 0, 10, 110, 1110, 1111 である。内部の節点には下の葉の確率の和が書かれ、どちらの木も平均の長さは 2.2 である。
定義と使える条件
以下、$\mathcal X=\{1,\dots,m\}$($m\ge2$)を記号の集合とし、確率 $p_1,\dots,p_m>0$、$\sum_ip_i=1$ を固定する。$\{0,1\}^*$ を 0 と 1 の有限列の全体、$\lvert w\rvert$ を列 $w$ の長さとする。
- 符号 とは、各記号 $i$ に空でない列 $c(i)\in\{0,1\}^*$(符号語)を割り当てる写像 $c$ であり、記号の列 $i_1\cdots i_k$ を符号語をつないだ列 $c(i_1)\cdots c(i_k)$ に移す。この写像が記号の有限列の全体で単射のとき、$c$ は 一意に復号できる という。
- どの符号語も、ほかの符号語の先頭部分(接頭辞)でないとき、$c$ を 接頭符号(prefix code)という。
- $\ell_i:=\lvert c(i)\rvert$ とおき、平均の長さ を $L(c):=\sum_{i=1}^mp_i\ell_i$ とする。接頭符号の中で $L$ を最小にするものを 最適な接頭符号 という。
接頭符号は一意に復号できる。受け取った列を先頭から読み、符号語に一致した時点で区切ればよく、接頭符号ではその区切り方しかないからである。符号語 $\{0,1,00\}$ は接頭符号でなく、列 $00$ が「$0,0$」とも「$00$」とも読めるので一意に復号できない。
接頭符号 $c$ に対し、符号語の接頭辞(空列と符号語自身を含む)を節点とし、列 $w$ の子を $w0$(左)と $w1$(右)とする二分木(二分木)を $c$ の 符号の木 という。接頭符号なので、葉はちょうど符号語であり、葉 $c(i)$ に記号 $i$ を書く。葉の深さは符号語の長さである。逆に、葉が $m$ 個の二分木の葉に記号を 1 つずつ書けば、根からの道の左右を $0,1$ と読んで接頭符号が得られる。節点の 重み を、その下にある葉の確率の和とする。
- 記号ごとに、節点 1 個だけの木を作り、重みを $p_i$ とする。
- 木が 2 本以上ある間、重みの最も小さい木を 2 本選び(等しい重みがあればどれを選んでもよい)、新しい根の左右の子としてつなぎ、重みを 2 本の重みの和とする。
- 1 本になった木を符号の木とする接頭符号を Huffman 符号 という。
併合は $m-1$ 回行われ、できる木の内部の節点はどれも子を 2 つもつ。
使える条件:
- (i) 記号を 1 つずつ符号語に置き換える符号(記号ごとの符号)の中での最適性である。複数の記号をまとめた組を 1 つの記号とみれば、1 記号あたりの長さはさらに縮む(ex-huf-block)。
- (ii) 確率 $p_i$ が分かっている。違う分布に合わせて作ると損をする(反例の表)。
- (iii) 0 と 1 の費用が等しく、費用は長さで測る。
- (iv) 符号語の文字は 2 種類である。3 種類以上では手順を直す必要がある(反例の表)。
主定理
Huffman 符号は最適な接頭符号である。等しい重みをどう選んでも、得られる平均の長さは同じ最小値になる。
証明の鍵は 2 つの補題である。最適な木には子が 1 つだけの節点がないこと(lem-huf-full)と、確率の最も小さい 2 つの記号を最も深い兄弟の葉に置いても損をしないこと(lem-huf-sibling)である。この 2 つを使うと、最初の併合で 2 つの記号を 1 つにまとめた $m-1$ 個の記号の問題に帰着でき、記号の個数についての帰納法が回る。同じ流れの証明は Eri19 Lemma 4.5(p. 168)と Theorem 4.6(pp. 168–169)にあり、言明は PW25 Theorem 10.11(p. 210)にもある。
最適な接頭符号はある。また、最適な接頭符号の符号の木では、内部の節点はどれも子を 2 つもつ。
存在:各記号に長さ $\lceil\log_2m\rceil$ の相異なる列を割り当てる符号は接頭符号で、その平均の長さを $L_0$ とする。$L(c)\le L_0$ の接頭符号では、どの $i$ についても $p_i\ell_i\le L_0$ なので $\ell_i\le L_0/\min_jp_j$ であり、そのような符号は有限個しかない。よってその中で $L$ を最小にするものがあり、それが最適である。
木の形:最適な $c$ の符号の木で、列 $w$ の節点が内部の節点で子が $wb$($b\in\{0,1\}$)だけだとする。$w$ を接頭辞にもつ符号語はすべて $wbu$ の形である。これを $wu$ に置き換えた符号 $c'$ を考える。$wu$ は空でない($w$ が根で $u$ が空なら、符号語 $b$ がほかのすべての符号語の接頭辞になり、$m\ge2$ と接頭符号であることに反する)。$c'$ も接頭符号である。実際、置き換えた符号語どうしでは接頭辞の関係は変わらない。置き換えない符号語 $x$ は $w$ を接頭辞にもたず、$x$ が $wu$ の接頭辞なら $x$ は $w$ の接頭辞(長さ $\lvert x\rvert\le\lvert w\rvert$ の場合)か $w$ を接頭辞にもつ(そうでない場合)。前者なら $x$ は $wbu$ の接頭辞となって $c$ が接頭符号であることに反し、後者は起こらない。$wu$ が $x$ の接頭辞なら $w$ が $x$ の接頭辞となり、これも起こらない。$w$ の下には葉が少なくとも 1 つあり、その記号の長さが $1$ 減るので $L(c')< L(c)$ となり、$c$ の最適性に反する。$\square$
$x\ne y$ を、$p_x\le p_y\le p_z$($z\ne x,y$)を満たす記号とする。このとき最適な接頭符号 $c$ で、$c(x)$ と $c(y)$ が最後の 1 文字だけ異なり、その長さが符号語の長さの最大値であるものがある。
lem-huf-full により最適な接頭符号 $c$ をとる。$m\ge2$ なので根は葉でない。深さ最大の葉 $a$ をとり、その深さを $\ell_{\max}$ とする。$a$ の親は lem-huf-full により子を 2 つもち、$a$ の兄弟 $b$ が内部の節点ならその下に深さ $\ell_{\max}+1$ 以上の葉があって矛盾するので、$b$ も葉である。
葉 $a$ に書かれた記号を $u$ とし、$u\ne x$ なら記号 $x$ と $u$ の葉を入れ替える。平均の長さの変化は
$$
\bigl(p_x\ell_{\max}+p_u\ell_x\bigr)-\bigl(p_x\ell_x+p_u\ell_{\max}\bigr)=(p_u-p_x)(\ell_x-\ell_{\max})\le0
$$
である($p_x\le p_u$、$\ell_x\le\ell_{\max}$)。次に葉 $b$ の記号を $v$ とする。$v\ne x$ であり、$v\ne y$ なら $p_y\le p_v$、$\ell_y\le\ell_{\max}$ なので、同じ計算で $y$ と $v$ を入れ替えても平均の長さは増えない。得られた符号は最適な $c$ 以下の平均の長さをもつので最適であり、$x,y$ は深さ $\ell_{\max}$ の兄弟の葉に書かれている。$\square$
$m$ についての帰納法で示す。$m=2$ では Huffman 符号の長さは $(1,1)$、$L=1$ で、どの符号語も空でないのでどの接頭符号も $L\ge1$ である。
$m\ge3$ とし、手順が最初に併合する 2 つの記号を $x,y$ とする。これは lem-huf-sibling の条件 $p_x\le p_y\le p_z$ を満たす。$x,y$ を 1 つの新しい記号 $z_0$ に置き換え、確率 $p_{z_0}:=p_x+p_y$ とした $m-1$ 個の記号の分布 $P'$ を考える。手順の 2 回目以降は、$P'$ に Huffman の手順を(同じ選び方で)行うことにほかならない。よって $P$ の Huffman 木 $H$ は、$P'$ の Huffman 木 $H'$ の葉 $z_0$ を、$x,y$ を子にもつ節点に置き換えたものである。$x,y$ の深さは $z_0$ の深さより $1$ 大きいので
$$
L(H)=L(H')+p_x+p_y
$$
である。
一方、lem-huf-sibling により、$x,y$ が兄弟の葉である最適な接頭符号の木 $T$ がある。$x,y$ の葉を取り除き、その親を記号 $z_0$ の葉とした木 $T'$ は $P'$ の符号の木で、同じ理由で $L(T)=L(T')+p_x+p_y$ である。帰納法の仮定により $H'$ は $P'$ の最適な接頭符号なので $L(H')\le L(T')$ であり、
$$
L(H)=L(H')+p_x+p_y\le L(T')+p_x+p_y=L(T)
$$
となる。$T$ は最適なので $H$ も最適である。等しい重みの選び方によらず $L(H)$ は最適値に等しいので、後半も従う。$\square$
定理は「どの記号の符号語も短くできない」とは主張しない。2 つの記号の長さを入れ替えれば、一方は短くなる。主張は確率で重み付けた平均についての最小性である。
一意に復号できる符号の中での最適性
接頭符号に限らず、一意に復号できる符号に広げても平均の長さは縮まない。これは次の不等式から従う。
一意に復号できる符号の長さ $\ell_1,\dots,\ell_m$ は $\sum_{i=1}^m2^{-\ell_i}\le1$ を満たす。
証明を開く
$S:=\sum_i2^{-\ell_i}$、$\ell_{\max}:=\max_i\ell_i$ とおく。正の整数 $k$ について $S^k=\sum_{i_1,\dots,i_k}2^{-(\ell_{i_1}+\cdots+\ell_{i_k})}=\sum_{n=k}^{k\ell_{\max}}A_n2^{-n}$ である。ここで $A_n$ は、符号語をつないだ長さが $n$ になる記号の列 $(i_1,\dots,i_k)$ の個数である。一意に復号できるので、相異なる記号の列は相異なる 0 と 1 の列に移り、長さ $n$ の列は $2^n$ 個しかないから $A_n\le2^n$ である。よって $S^k\le k\ell_{\max}$、すなわち $S\le(k\ell_{\max})^{1/k}$ であり、$k\to\infty$ として $S\le1$ を得る。$\square$
一意に復号できるどの符号 $c$ についても、Huffman 符号 $H$ は $L(H)\le L(c)$ を満たす。
証明を開く
$c$ の長さ $\ell_i\ge1$ は thm-huf-mcmillan により $\sum_i2^{-\ell_i}\le1$ を満たす。二分木 の記事の定理「葉の深さの不等式」の 2 により、葉が $m$ 個で深さが $\ell_1,\dots,\ell_m$ の二分木があり、その葉に記号を書けば長さ $\ell_i$ の接頭符号 $c'$ が得られる。$L(c')=L(c)$ であり、thm-huf-optimal から $L(H)\le L(c')=L(c)$ である。$\square$
thm-huf-mcmillan と 二分木 の記事の定理(Kraftの不等式)を合わせると、一意に復号できる符号で実現できる長さの組と、接頭符号で実現できる長さの組は同じである(Mac03 §5.2、pp. 94–95)。復号のしやすさで接頭符号を選んでも、長さの面では何も失わない。
エントロピーとの関係
$H_2:=-\sum_ip_i\log_2p_i$ を分布の エントロピー(単位 bit)とする。
- Huffman 符号 $H$ は $H_2\le L(H)< H_2+1$ を満たす。左の不等式は一意に復号できるどの符号でも成り立つ。
- $L(H)=H_2$ となるのは、各 $p_i$ が $2^{-k_i}$($k_i$ は整数)の形のときに限る。
証明を開く
1:一意に復号できる符号の長さ $\ell_i$ について、$\log_2$ の凹性(Jensen の不等式)と thm-huf-mcmillan により $H_2-L=\sum_ip_i\log_2\frac{2^{-\ell_i}}{p_i}\le\log_2\sum_i2^{-\ell_i}\le0$ である。上からの評価には $\ell_i^*:=\lceil\log_2(1/p_i)\rceil$ をとる。$0< p_i< 1$ なので $\ell_i^*\ge1$ で、$\sum_i2^{-\ell_i^*}\le\sum_ip_i=1$ だから 二分木 の定理により長さ $\ell_i^*$ の接頭符号がある。その平均の長さは $\sum_ip_i\ell_i^*<\sum_ip_i(\log_2\frac1{p_i}+1)=H_2+1$ であり、thm-huf-optimal により $L(H)$ はこれ以下である。2:$L(H)=H_2$ なら上の 2 つの不等号がともに等号で、Jensen の等号条件から $2^{-\ell_i}/p_i$ は $i$ によらず、$\sum_i2^{-\ell_i}=1$ なので $p_i=2^{-\ell_i}$ である。逆に $p_i=2^{-k_i}$ なら長さ $k_i$ の接頭符号(Kraft の和は $1$)の平均の長さが $H_2$ なので、1 と合わせて $L(H)=H_2$ である。$\square$
同じ評価は エントロピー の記事にもあり、そこでは独立な $n$ 個の記号を組にして符号化すれば 1 記号あたりの長さを $H_2+\frac1n$ 未満にできることも示されている。Huffman 符号の上の評価 $H_2+1$ の「$+1$」は、記号を 1 つずつ符号化する限り避けられない。値が 2 個の分布では、どの符号語も長さ $1$ 以上だからである。
平均の長さの計算と手間
符号の木の内部の節点の重みをすべて足すと、平均の長さ $L$ に等しい。とくに Huffman 符号の平均の長さは、併合で作った $m-1$ 個の重みの和である。
証明を開く
内部の節点の重みは、その下の葉の確率の和である。重みを全部足すと、葉 $i$ の確率 $p_i$ は、$i$ を下にもつ内部の節点、すなわち根から $i$ までの道の上の葉でない節点の個数だけ数えられる。その個数は深さ $\ell_i$ に等しいので、和は $\sum_ip_i\ell_i=L$ である。$\square$
Huffman の手順で $t$ 回目の併合で作った重みを $s_t$ とすると、$s_1\le s_2\le\cdots\le s_{m-1}$ である。よって確率を小さい順に並べてあれば、元の記号の列と併合した節点の列の 2 本の待ち行列を使い、$O(m)$ の手間で Huffman 木を作れる。並べる手間を含めると $O(m\log m)$ である。
証明を開く
$t$ 回目に重み $a\le b$ の 2 本を併合したとき、残りの木の重みはどれも $b$ 以上である。$t+1$ 回目に併合する 2 本がどちらも新しい $s_t$ でなければ、その和は $b+b\ge a+b=s_t$ であり、一方が $s_t$ ならその和は $s_t$ 以上である。よって $s_t\le s_{t+1}$ である。併合した節点を作った順に後ろへ並べた待ち行列は重みの小さい順になり、元の記号の待ち行列も小さい順なので、最も小さい 2 本はそれぞれの先頭 2 本の中にある。1 回の併合は定数の手間で済み、併合は $m-1$ 回である。$\square$
並べ替えをしない場合は、重みを優先度とするヒープを使えば 1 回の併合が $O(\log m)$ で、全体で $O(m\log m)$ になる(Eri19 p. 169)。
公式の表
| 量 | 式・値 | 条件 | 根拠 |
|---|---|---|---|
| Huffman 符号の平均の長さ | 接頭符号の中で最小 | 記号ごとの符号 | thm-huf-optimal |
| 同上 | 一意に復号できる符号の中で最小 | 記号ごとの符号 | cor-huf-ud |
| 符号語の長さ | $\sum_i2^{-\ell_i}\le1$ | 一意に復号できる | thm-huf-mcmillan |
| 平均の長さ | 内部の節点の重みの和 | 任意の符号の木 | prop-huf-internal |
| エントロピーとの差 | $H_2\le L< H_2+1$ | Huffman 符号 | cor-huf-entropy |
| 等号 | $L=H_2\iff p_i=2^{-k_i}$ | Huffman 符号 | cor-huf-entropy |
| $n$ 個ずつまとめた符号 | $H_2\le L_n/n< H_2+\frac1n$ | 独立同分布 | エントロピー |
| 併合の回数・手間 | $m-1$ 回、$O(m\log m)$(整列済みなら $O(m)$) | — | prop-huf-monotone |
計算の手順
- 確率を並べる:確率を書き出し、和が $1$ であることを確かめ、小さい順に並べる。
- 併合する:最も小さい 2 つを足して新しい重みとし、並びに戻す。1 つになるまで繰り返し、併合ごとの重みを書き留める。
- 長さを読む:記号 $i$ の長さ $\ell_i$ は、$i$ を含む併合の回数である。符号語は木を根から左を $0$、右を $1$ として読む。
- 検算する:$\sum_i2^{-\ell_i}=1$、$L=$(書き留めた重みの和)(prop-huf-internal)、$H_2\le L< H_2+1$ を確かめる。
例題
使う公式:手順、prop-huf-internal。
問:確率 $0.4,0.2,0.2,0.1,0.1$ の a, b, c, d, e について Huffman 符号を作り、平均の長さを求めよ。
答え:まず d, e を併合して $0.2$ を作る。残りは $0.4,0.2,0.2,0.2$ で、$0.2$ が 3 つ並ぶ。b, c を選べば $0.4$ ができ、次に d・e の節点 $0.2$ と a の $0.4$ を併合して $0.6$、最後に $1$ となる。長さは $(2,2,2,3,3)$ である(図の左)。d・e の節点と c を選び、次に b と、できた節点 $0.4$ を選べば、長さは $(1,2,3,4,4)$ になる(図の右)。どちらも $L=0.2+0.4+0.6+1.0=2.2$ で、$H_2\approx2.121928$、固定長の $3$ より短い。長さの分散は左が $0.16$、右が $1.36$ で、出力の長さのばらつきを抑えたいときは、等しい重みでは併合した節点を後に選ぶとよい。
使う公式:cor-huf-entropy の 2。
問:確率 $\frac12,\frac14,\frac18,\frac1{16},\frac1{16}$ の Huffman 符号を求めよ。
答え:$\frac1{16}+\frac1{16}=\frac18$、$\frac18+\frac18=\frac14$、$\frac14+\frac14=\frac12$、$\frac12+\frac12=1$ と併合し、長さは $(1,2,3,4,4)$、符号語は $0,10,110,1110,1111$ である。$L=1.875=H_2$ で、エントロピーにちょうど一致する。記号が $m$ 個のとき最長の符号語は $m-1$ 文字になりうることも分かる。
使う公式:cor-huf-entropy、エントロピー のまとめた符号の評価。
問:確率 $0.9$ で $0$、$0.1$ で $1$ を独立に出す情報源を、$n$ 個ずつまとめて Huffman 符号にしたときの 1 記号あたりの平均の長さを求めよ。
答え:$n=1$ では記号が 2 個なので $L=1$ である。$n=2$ では組の確率 $0.81,0.09,0.09,0.01$ を $0.01+0.09=0.1$、$0.09+0.1=0.19$、$0.19+0.81=1$ と併合し、$L_2=0.1+0.19+1=1.29$、$L_2/2=0.645$ である。同様に $L_3/3\approx0.532667$、$L_4/4\approx0.492550$ となり、$H_2=h_2(0.9)\approx0.468996$ に近づいていく。
使う公式:thm-huf-optimal。
問:確率 $0.35,0.17,0.17,0.16,0.15$ について、確率の和がなるべく半分ずつになるように上から 2 つに分けることを繰り返す符号と、Huffman 符号の平均の長さを比べよ。
答え:上から分けると $\{0.35,0.17\}$ と $\{0.17,0.16,0.15\}$、後者を $\{0.17\}$ と $\{0.16,0.15\}$ に分けて、長さ $(2,2,2,3,3)$、$L=2.31$ である。Huffman 符号は $0.15+0.16=0.31$、$0.17+0.17=0.34$、$0.31+0.34=0.65$、$0.65+0.35=1$ と併合して長さ $(1,3,3,3,3)$、$L=2.30$ となり、わずかに短い。上から分ける方法が最適とは限らない例は Mac03 Example 5.18(p. 100)にもある。
使える条件と反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 一意に復号できる | 確率 $\frac12,\frac14,\frac14$ に符号語 $0,1,00$ | $L=1.25$ で Huffman 符号の $1.5$ や $H_2=1.5$ より小さく、cor-huf-ud と cor-huf-entropy の下限の結論そのものが成り立たない。ただし $00$ を復元できない |
| 最も小さい 2 つを併合 | 確率 $0.5,0.3,0.2$ で大きい 2 つを併合 | 長さ $(2,2,1)$、$L=1.8$ で、最適値 $1.5$ に届かない。手順を変えると最適性が成り立たない |
| 符号語の文字が 2 種類 | 文字 $0,1,2$ で、確率 $\frac14$ ずつの 4 記号を 3 つずつ併合 | 3 つを併合したあと 2 本しか残らず、長さ $(1,2,2,2)$、$L=1.75$。長さ $(1,1,2,2)$ なら $1.5$ で、そのまま 3 つずつ併合する手順は最適でない |
| 確率が分かっている | 確率 $\frac12,\frac14,\frac14$ 用の長さ $(1,2,2)$ を、実際の確率 $0.1,0.45,0.45$ に使う | $L=1.9$ で、正しい分布の Huffman 符号の $1.55$ より $0.35$ bit 長い。正しい分布に対する最適性が成り立たない(定理の結論は作った分布に対しては成り立つ) |
| 記号が独立 | $X_1$ が公平な硬貨で $X_1=X_2=\cdots=X_n$ | 記号ごとの Huffman 符号は 1 記号 1 bit だが、列全体の情報は 1 bit で、$n$ 記号を 1 bit で送れる。記号ごとの符号の中での最適性という結論は成り立つが、「圧縮の限界」と読む論法は通らない |
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| Huffman 木は 1 つに決まる | 等しい重みの選び方で木が変わる。平均の長さは同じ | ex-huf-two-trees |
| 平均の長さはエントロピーに等しい | 等しいのは確率がすべて 2 の冪のときだけ。確率 $0.99,0.01$ では $L=1$、$H_2\approx0.080793$ | cor-huf-entropy |
| 各記号の長さは $\lceil\log_2(1/p_i)\rceil$ 以下 | 確率 $0.01,0.30,0.34,0.35$ では長さ $(3,3,2,1)$ で、$0.30$ の記号は $3>\lceil\log_2(1/0.3)\rceil=2$。平均は $1.96$ で、$\lceil\log_2(1/p_i)\rceil$ の長さの平均 $2.05$ より短い | 最適なのは平均で、記号ごとではない |
| 上から半分ずつ分ければ最適 | 最適とは限らない | ex-huf-fano |
| 接頭符号でない符号まで許せば短くなる | 一意に復号できる限り短くならない | cor-huf-ud |
| 作るのに $O(m^2)$ の手間がかかる | ヒープで $O(m\log m)$、整列済みなら $O(m)$ | prop-huf-monotone |
補足
Huffman 符号は D. A. Huffman が 1951 年に MIT の大学院生として考案し、1952 年に発表した(Eri19 p. 166 とその脚注 4、Mac03 の文献表 p. 616)。当時知られていた上から分ける方法(ex-huf-fano)は最適とは限らず、下から併合する点が新しかった(同じ脚注)。算術符号や Lempel–Ziv の方法とともに、記号をまとめて圧縮する考え方を実用にした方法の一つである(PW25 p. 197)。
記号ごとの符号では、確率が $1$ に近い記号があると $L$ と $H_2$ の差が大きくなる。この差は、ex-huf-block のように記号をまとめて符号化するか、記号の列全体に 1 つの符号語を割り当てる方法で縮められる。一方、確率がよく分からない場合や、時間とともに変わる場合には、出現回数を数えながら木を作り直す方法が使われる。
圧縮の限界を与えるのは エントロピー であり、誤りのある通信路で送る限界は Shannonの通信路符号化定理、ある程度の誤りを許した圧縮の限界は レート歪み理論 が与える。
関連項目
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

