多腕バンディット
概要
多腕バンディット(multi-armed bandit)とは、報酬の分布が分からない $K$ 本の腕から毎回 1 本を選んで引き、得た報酬だけを手がかりに次の選び方を決める逐次的な意思決定の問題である。最良の腕を引き続けた場合との報酬の差の期待値(後悔)は、劣った腕ごとの期待値の差と引いた回数の期待値の積の和に分解できる。報酬が分散の目安 $1$ の劣 Gauss のとき、標本平均に信頼区間の幅を足した指数で腕を選ぶ UCB 方策は、期間 $n$ を知って信頼の水準を $1/n^2$ にとれば、後悔が $\log n$ に比例する量で抑えられ、この増え方は一致的な方策では改良できない(Lai–Robbins の下界)。探索と活用の釣り合いの基本的な模型である。
前提知識: 確率変数, 期待値, Hoeffdingの不等式, 濃度不等式
多腕バンディット(multi-armed bandit)は、報酬の分布が分からない $K$ 本の「腕」(選択肢)の中から毎回 1 本を選んで引き、得た報酬だけを手がかりに次の選び方を決める、逐次的な意思決定の問題である。名は、腕を引くと賞金の出る賭博機械(one-armed bandit)が何台も並んだ様子に由来する。臨床試験での治療法の割り当て、広告やウェブページの案の選択などがこの形をしている。
難しさは 探索 と 活用 の釣り合いにある。これまで良かった腕(活用)ばかり引くと、少ない観測で不運に低く見積もった本当に良い腕を二度と試さないおそれがある。逆に満遍なく引き続ける(探索)と、悪いと分かった腕にも報酬を払い続ける。良し悪しは、最良の腕を引き続けた場合と比べた報酬の損失の期待値(後悔)で測る。
この記事では、確率的な多腕バンディットの定義と、後悔を腕ごとの引いた回数に分ける公式を証明し、信頼区間の上端で腕を選ぶ UCB 方策 の後悔が期間 $n$ の対数でしか増えないことを証明する。どの方策も避けられない後悔の下界(Lai–Robbins の定理)は主張として述べる。
定義と使える条件
$K\ge2$ を腕の数、$n\ge1$ を 期間(引く回数)とする。$[K]=\{1,\dots,K\}$ と書く。
$\mathbb{R}$ 上の確率分布 $P_1,\dots,P_K$ で、どれも期待値 $\mu_i=\int x\,dP_i(x)$ が有限なものの組を 確率的な $K$ 本腕バンディット(環境)という。$\mu^\ast=\max_i\mu_i$ を最良の期待値、$\Delta_i=\mu^\ast-\mu_i\ge0$ を腕 $i$ の 差(gap)という。$\Delta_i>0$ の腕を 劣った腕 という。
報酬は次のように生じる。互いに独立な確率変数 $Y_{s,i}$($s=1,\dots,n$、$i\in[K]$)で $Y_{s,i}$ の分布が $P_i$ であるものと、これらと独立な確率変数 $U$ を用意する。$Y_{s,i}$ は腕 $i$ を $s$ 回目に引いたときの報酬、$U$ は選び方に使う乱数である。
方策 は、各 $t=1,\dots,n$ について、$t$ 回目に引く腕 $A_t\in[K]$ を $U$ とそれまでの $A_1,X_1,\dots,A_{t-1},X_{t-1}$ の関数として決める規則である。腕 $i$ を $t$ 回目までに引いた回数を $T_i(t)=\#\{u\le t\mid A_u=i\}$ とし、$t$ 回目の報酬を $X_t=Y_{T_{A_t}(t),\,A_t}$ とする。期間 $n$ の 後悔(regret)を
$$
R_n=n\mu^\ast-E\Bigl[\sum_{t=1}^nX_t\Bigr]
$$
と定める。
最良の腕を知っていて引き続ける方策の報酬の期待値は $n\mu^\ast$ なので、$R_n$ は腕を知らないことによる損失である。$R_n\ge0$ は次の公式から分かる。報酬の表 $Y_{s,i}$ を先に用意しておく書き方は、腕 $i$ から得た最初の $s$ 個の報酬が独立同分布の列 $Y_{1,i},\dots,Y_{s,i}$ になることを、選び方によらず保証するためのものである。
UCB 方策についての結論を使える条件をまとめる。
- 確率的:各腕の報酬は固定された分布から独立に出る(敵対的に選ばれない)。
- 劣 Gauss:$Y_{s,i}-\mu_i$ が分散の目安 $1$ の劣 Gauss である。すなわち全ての $\lambda\in\mathbb{R}$ で $E[e^{\lambda(Y-\mu_i)}]\le e^{\lambda^2/2}$(濃度不等式 の定義「劣 Gauss 性」)。報酬が $[0,1]$ に値をとれば、Hoeffdingの不等式 の補題「Hoeffding の補題」から分散の目安 $\frac14$ の劣 Gauss なので、この条件を満たす。
- 期間 $n$ を知っている:信頼の水準を $\delta=1/n^2$ にとる。
- 期待値の差 $\Delta_i$ は未知でよい。
後悔の分解
どの方策についても
$$
R_n=\sum_{i=1}^K\Delta_i\,E[T_i(n)]
$$
である。とくに $R_n\ge0$ で、$R_n=0$ となるのは劣った腕を引く確率が全ての回で $0$ のときに限る。
$t$ と $i$ を固定する。$s\in\{0,\dots,t-1\}$ について、事象 $E_s=\{A_t=i,\ T_i(t-1)=s\}$ は $U$ と、腕 $i$ の最初の $s$ 個の報酬 $Y_{1,i},\dots,Y_{s,i}$ と、ほかの腕の報酬 $Y_{u,j}$($j\ne i$)だけで決まる。実際、$t-1$ 回目までの選択と観測を順に再現すると、腕 $i$ からは $s$ 個しか報酬を読まない。よって $E_s$ は $Y_{s+1,i}$ と独立で、$E_s$ の上で $X_t=Y_{s+1,i}$ だから
$$
E\bigl[X_t\mathbf 1\{A_t=i\}\bigr]=\sum_{s=0}^{t-1}E\bigl[Y_{s+1,i}\mathbf 1_{E_s}\bigr]=\sum_{s=0}^{t-1}\mu_iP(E_s)=\mu_iP(A_t=i)
$$
である($Y_{s+1,i}$ は可積分)。$\sum_iP(A_t=i)=1$ なので $E[X_t]=\sum_i\mu_iP(A_t=i)$ で、
$$
R_n=\sum_{t=1}^n\sum_{i=1}^K(\mu^\ast-\mu_i)P(A_t=i)=\sum_{i=1}^K\Delta_i\sum_{t=1}^nP(A_t=i)=\sum_{i=1}^K\Delta_iE[T_i(n)]
$$
を得る。各項は $0$ 以上で、和が $0$ になるのは $\Delta_i>0$ の全ての $i$ と全ての $t$ で $P(A_t=i)=0$ のときである。$\square$
したがって後悔を小さくするには、劣った腕 $i$ を引く回数の期待値を、差 $\Delta_i$ が大きいほど少なくすればよい。ただし劣った腕を見分けるには、その腕を何度か引いて期待値を見積もる必要がある。
主定理:UCB 方策の後悔
腕 $i$ を $s$ 回引いたときの標本平均を $\hat\mu_{i,s}=\frac1s\sum_{u=1}^sY_{u,i}$ と書く。
条件 2 の下で、$s\ge1$、$\varepsilon>0$ について
$$
P(\hat\mu_{i,s}-\mu_i\ge\varepsilon)\le e^{-s\varepsilon^2/2},\qquad P(\hat\mu_{i,s}-\mu_i\le-\varepsilon)\le e^{-s\varepsilon^2/2}
$$
である。
濃度不等式 の命題「劣 Gauss の裾と独立な和」の (2) により、$\sum_{u\le s}(Y_{u,i}-\mu_i)$ は分散の目安 $s$ の劣 Gauss である。$\lambda$ を $\lambda/s$ に替えると、$\hat\mu_{i,s}-\mu_i$ は分散の目安 $s/s^2=1/s$ の劣 Gauss で、同じ命題の (1) から 1 つ目を得る。2 つ目は $-(Y_{u,i}-\mu_i)$(これも分散の目安 $1$ の劣 Gauss)に当てる。$\square$
$\varepsilon=\sqrt{2\log(1/\delta)/s}$ とおくと右辺は $\delta$ になる。
$0<\delta\le1$ とする($\delta=1$ なら幅は $0$ で、標本平均が最大の腕を選ぶ 貪欲な方策 になる)。$t-1$ 回目の後の腕 $i$ の 指数 を
$$
\mathrm{UCB}_i(t-1)=\begin{cases}+\infty&(T_i(t-1)=0)\\[2pt]\hat\mu_{i,T_i(t-1)}+\sqrt{\dfrac{2\log(1/\delta)}{T_i(t-1)}}&(T_i(t-1)\ge1)\end{cases}
$$
と定め、$A_t$ を指数が最大の腕とする(最大が複数あれば、そのうち番号の最小のものなど、乱数を使わずに決めておいた規則で選ぶ)。これを UCB 方策(upper confidence bound、信頼の上限)という。
指数は「期待値がもっともらしく取りうる最大の値」で、lem-mab-tail によれば $\mu_i$ を下回る確率は各 $s$ で $\delta$ 以下である。まだよく調べていない腕ほど幅 $\sqrt{2\log(1/\delta)/T_i}$ が大きく、引かれやすい。この楽観が探索を自動的に生む。最初の $K$ 回は各腕を 1 回ずつ引く。
条件 1・2 を仮定し、UCB 方策を $\delta=1/n^2$ で使う。このとき劣った腕 $i$ について
$$
E[T_i(n)]\le3+\frac{16\log n}{\Delta_i^2}
$$
であり、したがって
$$
R_n\le3\sum_{i=1}^K\Delta_i+\sum_{i:\Delta_i>0}\frac{16\log n}{\Delta_i}
$$
である。
$\mu_1=\mu^\ast$ としてよい。劣った腕 $i$ を 1 つ固定し、$\Delta=\Delta_i$ と書く。$n=1$ なら $E[T_i(1)]\le1$ なので、$n\ge2$ とする。$L=2\log(1/\delta)=4\log n$ とおき、整数
$$
u=\Bigl\lceil\frac{4L}{\Delta^2}\Bigr\rceil
$$
をとる。$u\ge4L/\Delta^2$ から $\sqrt{L/u}\le\Delta/2$ である。次の 2 つの事象の共通部分を $G$ とする。
$$
G_1=\Bigl\{\hat\mu_{1,s}+\sqrt{L/s}>\mu_1\ \text{が全ての }s\in[n]\text{ で成り立つ}\Bigr\},\qquad G_2=\Bigl\{\hat\mu_{i,u}+\sqrt{L/u}<\mu_1\Bigr\}.
$$
$u>n$ のときは $G_2$ を全事象とする。
1. $G$ の上で $T_i(n)\le u$。 $u\ge n$ なら明らかである。$u< n$ で $T_i(n)>u$ とすると、$T_i$ は 1 ずつ増えるので、$T_i(t-1)=u$ かつ $A_t=i$ となる $t$ がある。そのとき $G_2$ から $\mathrm{UCB}_i(t-1)=\hat\mu_{i,u}+\sqrt{L/u}<\mu_1$ である。一方、腕 1 の指数は、$T_1(t-1)=0$ なら $+\infty$、$T_1(t-1)=s\ge1$ なら $G_1$ から $\hat\mu_{1,s}+\sqrt{L/s}>\mu_1$ である。どちらでも $\mathrm{UCB}_1(t-1)>\mathrm{UCB}_i(t-1)$ で、指数が最大の腕を選ぶことに反する。
2. $G$ の外の確率。 lem-mab-tail と $\delta=1/n^2$ から
$$
P(G_1^c)\le\sum_{s=1}^nP\Bigl(\hat\mu_{1,s}-\mu_1\le-\sqrt{L/s}\Bigr)\le n\delta=\frac1n
$$
である。$u\le n$ のとき、$\mu_1=\mu_i+\Delta$ と $\sqrt{L/u}\le\Delta/2$ から
$$
P(G_2^c)=P\Bigl(\hat\mu_{i,u}-\mu_i\ge\Delta-\sqrt{L/u}\Bigr)\le P\Bigl(\hat\mu_{i,u}-\mu_i\ge\frac\Delta2\Bigr)\le e^{-u\Delta^2/8}\le e^{-L/2}=\frac1{n^2}
$$
である(最後は $u\Delta^2/8\ge L/2$ による)。
3. まとめ。 $T_i(n)\le n$ なので
$$
E[T_i(n)]\le u+n\bigl(P(G_1^c)+P(G_2^c)\bigr)\le\frac{4L}{\Delta^2}+1+1+\frac1n\le3+\frac{16\log n}{\Delta^2}
$$
である。後悔の評価は prop-mab-decomp に代入し、$\Delta_i>0$ の腕について和をとって得る。$\square$
この証明は LS20 Theorem 7.1 の証明(そこでは定数 $c=\frac12$ を最後に選ぶ)と同じ筋である。後悔は $n$ について $\log n$ でしか増えないが、差 $\Delta_i$ が小さい腕では $1/\Delta_i$ が大きくなり、評価が意味を失う。差によらない形にもできる。
thm-mab-ucb と同じ仮定の下で、$n\ge2$ なら
$$
R_n\le8\sqrt{nK\log n}+3\sum_{i=1}^K\Delta_i
$$
である。
$\varepsilon>0$ とする。$\Delta_i<\varepsilon$ の腕は $\sum_i\Delta_iE[T_i(n)]\le\varepsilon\sum_iE[T_i(n)]\le\varepsilon n$ と抑え、$\Delta_i\ge\varepsilon$ の腕には thm-mab-ucb の $E[T_i(n)]$ の評価を使うと
$$
R_n\le\varepsilon n+\sum_{i:\Delta_i\ge\varepsilon}\Bigl(3\Delta_i+\frac{16\log n}{\Delta_i}\Bigr)\le\varepsilon n+\frac{16K\log n}{\varepsilon}+3\sum_i\Delta_i
$$
である。$\varepsilon=\sqrt{16K\log n/n}$ とおくと、最初の 2 項の和は $2\sqrt{16nK\log n}=8\sqrt{nK\log n}$ である。$\square$
避けられない後悔
UCB の後悔の $\log n$ の増え方は改良できない。どの方策も、すべての環境で後悔を小さくしようとすれば、劣った腕を $\log n$ に比例する回数は引かざるを得ない。ここでは腕の分布が Bernoulli 分布の場合を述べる。$\mathrm{kl}(p,q)=p\log\frac pq+(1-p)\log\frac{1-p}{1-q}$ は Bernoulli 分布どうしの Kullback–Leiblerダイバージェンス である。
腕の分布が全て Bernoulli 分布である環境の全体を考える。方策が 一致的、すなわちこの全体のどの環境でも、どの $p>0$ についても $R_n/n^p\to0$($n\to\infty$)であるとする。このとき、どの環境についても、$\mu^\ast<1$ なら
$$
\liminf_{n\to\infty}\frac{R_n}{\log n}\ge\sum_{i:\Delta_i>0}\frac{\Delta_i}{\mathrm{kl}(\mu_i,\mu^\ast)}
$$
である。
この記事では証明しない。一般の分布族についての主張と証明が LS20 Definition 16.1・Theorem 16.2 にある。Bernoulli 分布の族では、そこでの $d_{\inf}(P_i,\mu^\ast)$(期待値が $\mu^\ast$ を超える分布への Kullback–Leibler ダイバージェンスの下限)が、$\mathrm{kl}$ の第 2 引数についての連続性から $\mathrm{kl}(\mu_i,\mu^\ast)$ に等しい。期間 $n$ を固定して全ての環境での最大をとると、どの方策も $\frac1{27}\sqrt{(K-1)n}$ 以上の後悔をもつ環境がある(LS20 Theorem 15.2、分散 $1$ の Gauss 分布の腕で $n\ge K-1$)。cor-mab-minimax はこれと $\sqrt{\log n}$ の因子を除いて一致する。
2 点の上の分布の全変動距離は $\lvert\mu_i-\mu^\ast\rvert$ なので、Kullback–Leiblerダイバージェンス の定理「Pinsker の不等式」から $\mathrm{kl}(\mu_i,\mu^\ast)\ge2\Delta_i^2$ である。よって下界の係数 $\Delta_i/\mathrm{kl}(\mu_i,\mu^\ast)$ は $1/(2\Delta_i)$ 以下で、thm-mab-ucb の係数 $16/\Delta_i$ と同じ $1/\Delta_i$ の形である。Bernoulli の腕では、指数の幅を $\mathrm{kl}$ で決める KL-UCB 方策が $\lim R_n/\log n$ を下界の値にちょうど一致させる(LS20 第 10 章と §16.1 の注意)。期待値の事後分布から標本を引いて腕を選ぶ Thompson サンプリングも、Bernoulli の腕で同じ性質をもつことが示されている(LS20 §8.3 の文献の注、方策は第 36 章)。
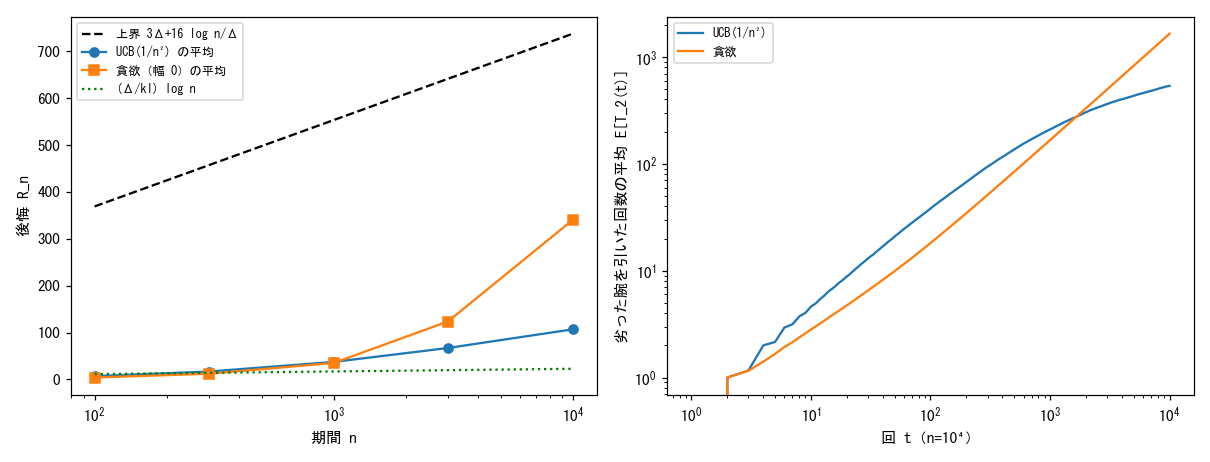 図: 2 本の腕の期待値が 0.6 と 0.4 の Bernoulli 分布の場合。左は期間 n を 100 から 10^4 まで変えたときの、UCB 方策と貪欲な方策(幅 0)の後悔の平均(各 200 回の試行)、定理の上界 3Δ+16 log n/Δ(破線)、Lai–Robbins の下界の主要項(点線)。UCB の後悔は上界より十分小さく対数的に増え、貪欲な方策の後悔は n とともに比例的に増える。右は n=10^4 の試行で、劣った腕を引いた回数の平均の推移を両対数で描いたもの。UCB は増え方が鈍り、貪欲な方策は傾き 1 の直線に近づく。
図の UCB と貪欲な方策の値は、乱数の種を固定した 200 回の試行の平均である(図の説明の条件で計算した数値)。
公式の表
| 量 | 式 | 使える条件 | 根拠 |
|---|---|---|---|
| 後悔 | $R_n=n\mu^\ast-E[\sum_tX_t]$ | 期待値が有限 | def-mab-regret |
| 後悔の分解 | $R_n=\sum_i\Delta_iE[T_i(n)]$ | どの方策でも | prop-mab-decomp |
| 標本平均の裾 | $P(\hat\mu_{i,s}-\mu_i\ge\varepsilon)\le e^{-s\varepsilon^2/2}$ | 分散の目安 $1$ の劣 Gauss | lem-mab-tail |
| UCB の指数 | $\hat\mu_{i,T_i}+\sqrt{2\log(1/\delta)/T_i}$ | $T_i\ge1$ | def-mab-ucb |
| 劣った腕を引く回数 | $E[T_i(n)]\le3+16\log n/\Delta_i^2$ | 条件 1・2、$\delta=1/n^2$ | thm-mab-ucb |
| 差に依存する上界 | $R_n\le3\sum_i\Delta_i+\sum_{\Delta_i>0}16\log n/\Delta_i$ | 同上 | thm-mab-ucb |
| 差によらない上界 | $R_n\le8\sqrt{nK\log n}+3\sum_i\Delta_i$ | 同上、$n\ge2$ | cor-mab-minimax |
| 漸近的な下界 | $\liminf R_n/\log n\ge\sum_{\Delta_i>0}\Delta_i/\mathrm{kl}(\mu_i,\mu^\ast)$ | Bernoulli の腕、一致的な方策、$\mu^\ast<1$ | thm-mab-lai-robbins(証明しない) |
| 最悪の場合の下界 | $\max R_n\ge\frac1{27}\sqrt{(K-1)n}$ | Gauss の腕、$n\ge K-1$ | rem-mab-lai-robbins(証明しない) |
計算の手順
UCB 方策で腕を選び、後悔を見積もる手順である。
- 報酬の尺度をそろえる。 報酬が区間 $[a,b]$ に値をとるなら $(Y-a)/(b-a)$ に直して $[0,1]$ に収める(条件 2 を満たす)。劣 Gauss の分散の目安が $\sigma^2$ なら、幅を $\sigma$ 倍にする。
- 信頼の水準を決める。 期間 $n$ を知っていれば $\delta=1/n^2$ とする。
- 初めに各腕を 1 回ずつ引く。 $T_i=0$ の腕の指数は $+\infty$ である。
- 毎回、指数の最大の腕を引く。 引いた腕の $T_i$ と報酬の和だけを更新する(ほかの腕の指数は変わらない)。
- 後悔を見積もる。 期待値が分かっている試験の環境なら $\sum_i\Delta_iT_i(n)$ の平均で後悔を推定し、thm-mab-ucb の上界と比べる。
状況 起こること 対処 差 $\Delta_i$ が非常に小さい 差に依存する上界が大きくなる 差によらない上界 cor-mab-minimax で見る 期間 $n$ が分からない $\delta=1/n^2$ が決められない $t$ 回目に $\delta_t$ を $t$ から決める版を使う(LS20 第 8 章) 報酬の範囲が分からない 幅の尺度が合わず、劣 Gauss の条件が保証されない 反例の表の 1 行目のように後悔が大きくなりうる
例題
期待値 $0.7,\ 0.5,\ 0.2$ の 3 本の腕を、毎回独立に等確率で選ぶ。$n=300$ での後悔を求める。
使う公式:prop-mab-decomp。
答え:差は $0,\ 0.2,\ 0.5$ で、$E[T_i(300)]=100$ なので $R_{300}=(0.2+0.5)\times100=70$ である。選び方を学ばない方策の後悔は $n$ に比例する。
期待値 $0.6$ と $0.4$ の Bernoulli 分布の 2 本の腕($\Delta=0.2$)で、UCB 方策を $\delta=1/n^2$ で使う。$n=10^4$ のときの上界を求める。
使う公式:thm-mab-ucb、cor-mab-minimax。報酬は $[0,1]$ に値をとるので条件 2 を満たす。
答え:差に依存する上界は $3\times0.2+16\log(10^4)/0.2\approx737.4$、差によらない上界は $8\sqrt{2\times10^4\log(10^4)}+0.6\approx3434.2$ である。乱数の種を固定した 200 回の試行では、後悔の平均は約 $106.9$(標準誤差約 $1.2$)で、上界は成り立つが余裕が大きい。
途中の計算を開く
$\log(10^4)=4\log10\approx9.2103$。$16\times9.2103/0.2\approx736.83$ に $0.6$ を足す。$2\times10^4\times9.2103=184206$、その平方根は約 $429.19$ で、$8$ 倍は約 $3433.55$。$n=10^3$ では上界は約 $553.2$、試行の平均は約 $37.4$ である。
ex-mab-bound の環境で、下界の係数を求める。
使う公式:thm-mab-lai-robbins。
答え:$\mathrm{kl}(0.4,0.6)=0.4\log\frac23+0.6\log\frac32=0.2\log\frac32\approx0.081093$ で、係数は $0.2/0.081093\approx2.4663$ である。一致的な方策の後悔は大きな $n$ で $2.47\log n$ 程度より小さくできない。UCB の上界の係数 $16/0.2=80$ はこの約 $32$ 倍である。
使える条件と反例
各行は thm-mab-ucb の条件を 1 つだけ外す。後悔の下限は、悪い事象の確率とその上での損失の積で抑えた。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 分散の目安 $1$ の劣 Gauss(条件 2) | 腕 1 は $-6$ と $7$ を確率 $\frac12$ ずつ(期待値 $\frac12$)、腕 2 は常に $0$。$n=1000$ | 腕 1 の最初の報酬が $-6$ なら指数は $-6+\sqrt{4\log1000}\approx-0.743<0$ で二度と引かれず、$R_n\ge\frac12\cdot\frac12\cdot999=249.75$。上界 $1.5+32\log1000\approx222.5$ を超える |
| $\delta=1/n^2$(条件 3) | $\delta=e^{-0.045}\approx0.956$ に固定。腕 1 は期待値 $\frac12$ の Bernoulli、腕 2 は常に $0.4$ | 腕 1 の最初の報酬が $0$ なら指数は $0.3<0.4$ のままで、$R_n\ge0.05(n-1)$ は $n$ に比例する。$n=10^5$ で $4999.95$ となり上界 $1842.4$ を超える |
| 確率的(条件 1) | 報酬の表 $x_{t,i}\in\{0,1\}$ を前もって決める($K=2$)。UCB は乱数を使わない方策なので、UCB を走らせながら $t$ 回目に選ばれる腕の報酬を $0$、もう一方を $1$ と決めておける | 得る報酬は $0$。各回でちょうど 1 本の腕が $1$ を出すので、一方の腕は合計 $n/2$ 以上を出し、その腕を引き続けた場合との差は $n/2$ 以上で、$n$ に比例する |
反例の確かめを開く
1 行目:$\delta=10^{-6}$ で幅は $\sqrt{2\log10^6/T}$、$T=1$ で $\sqrt{4\log1000}\approx5.257$。腕 2 の指数は $0+\sqrt{\cdots}>0$ なので、腕 1 の指数は腕 2 を下回り続け、腕 2 が残りの $999$ 回引かれる。分布は $[-6,7]$ に値をとり、Hoeffdingの不等式 の補題からは分散の目安 $13^2/4=42.25$ の劣 Gauss だが、目安 $1$ では劣 Gauss でない(分散が $42.25>1$ で、目安は分散以上でなければならない)。2 行目:$\sqrt{2\log(1/\delta)}=\sqrt{0.09}=0.3$。腕 1 の指数は $T_1=1$ のまま $0+0.3$ で、腕 2 の指数は常に $0.4$ 以上。3 行目の後悔は、敵対的な報酬の場合の定義(最良の固定した腕の報酬の和との差)による。
3 行目の状況(報酬の表が $[0,1]$ の値で前もって決まっている 敵対的なバンディット)では、選び方に乱数を使う方策 Exp3 の後悔(最良の固定した腕との差の期待値)は $2\sqrt{nK\log K}$ 以下である(LS20 Theorem 11.1。この記事では証明しない)。乱数を使うことで、表を作る側が選ばれる腕を前もって知ることができなくなる。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 標本平均が最大の腕を引き続ける(貪欲な方策) | 信頼区間の幅を足した指数で選ぶ | 最良の腕を一度低く見積もると二度と引かず、後悔が $n$ に比例する(図の左) |
| 後悔を「最良の腕を引かなかった回数」と数える | 回数に差 $\Delta_i$ を掛けて足す | prop-mab-decomp。差の小さい腕を引く損失は小さい |
| $T_i(t)$ 回の標本平均にそのまま固定回数の Hoeffding の不等式を当てる | 回数が乱数なので、全ての $s$ について和をとる(ユニオン評価)か、報酬の表で書く | prf-mab-ucb の 2 の $P(G_1^c)\le n\delta$ |
| 報酬の尺度を気にせず同じ幅を使う | 分散の目安に合わせて幅を $\sigma$ 倍する | 反例の表の 1 行目 |
補足
腕の数が多く、腕が特徴ベクトルで表され期待値がその 1 次式である 線形バンディット、選ぶたびに状態が変わる Markov決定過程 の学習(強化学習)は、同じ探索と活用の釣り合いを扱う。UCB と同じ楽観の考え方がこれらにも使われる(LS20 第 19 章・第 38 章)。多腕バンディットは状態が 1 つしかない Markov 決定過程の学習とみなせる。
文献
LS20 Lemma 4.5(後悔の分解)、Theorem 7.1・7.2(UCB の上界)、Theorem 15.2(最悪の場合の下界)、Definition 16.1・Theorem 16.2(漸近的な下界)。
関連項目
- 前提: Hoeffdingの不等式, 濃度不等式, 期待値
- 理論: Kullback–Leiblerダイバージェンス, 大数の法則
- 比較: Markov決定過程
- 発展: 強化学習
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

