PAC学習
概要
PAC学習(PAC learning)とは、許容する誤り率 $\varepsilon$ と失敗の確率 $\delta$ を決めたとき、データの分布が何であっても、決まった数の独立な例から確率 $1-\delta$ 以上で誤り率 $\varepsilon$ 以下の分類器を選べる、という学習の枠組みである。仮説の集合 $\mathcal H$ が有限なら、訓練誤差を最小にする規則で $\log(\lvert\mathcal H\rvert/\delta)/\varepsilon$ 個の例で足り、正解が $\mathcal H$ に入らない場合も $2\log(2\lvert\mathcal H\rvert/\delta)/\varepsilon^2$ 個で足りる。無限の集合でも学べることがあり、学べるのは VC 次元が有限のときに限る。
前提知識: 確率空間, 独立性(確率論), Hoeffdingの不等式, VC次元
例を見て規則を学ぶ機械が「学べた」とは何を意味するか。訓練に使う例はたまたま偏るかもしれないし、どんなに例を集めても、見ていない点での答えは保証できない。そこで要求を 2 つ緩める。誤り率が小さい(approximately correct)ことを、高い確率で(probably)満たせばよい、とする。
PAC学習(probably approximately correct learning)は、この要求を数式にした学習の枠組みで、Valiant(1984)が導入した(SSBD14 §3.4、p. 50)。要点は、誤り率の許容 $\varepsilon$ と失敗の確率 $\delta$ を先に決めたとき、データの分布が何であっても、決まった数の例で要求を満たせることである。この記事では次を示す。
- 仮説の集合が有限なら、訓練誤差を最小にする規則で学べ、例の数は $\log(\lvert\mathcal H\rvert/\delta)/\varepsilon$ で足りる(thm-pac-finite)。正解が仮説の集合に入っていない場合でも $2\log(2\lvert\mathcal H\rvert/\delta)/\varepsilon^2$ で足りる(thm-pac-agnostic)。
- 無限の集合でも学べることがある。平面の軸に平行な長方形は $4\log(4/\delta)/\varepsilon$ 個の例で学べる(prop-pac-rectangles)。
- 学べるかどうかは VC次元 が有限かどうかで決まる(thm-pac-fundamental、引用)。VC 次元が無限なら学べないことは、No-Free-Lunch 定理から直ちに出る(prop-pac-infinite-vc)。
定義と使える条件
定義域 $\mathcal X$ と ラベル の集合 $\{0,1\}$ を固定する。$\mathcal X\to\{0,1\}$ の関数を 仮説(分類器)といい、仮説の集合 $\mathcal H$ を 仮説クラス という。無限のクラスでは、以下に現れる事象が可測であることを仮定する。
$\mathcal X\times\{0,1\}$ 上の確率分布 $\mathcal D$ に対し、仮説 $h$ の 真の誤差 と、例の列 $S=((x_1,y_1),\dots,(x_m,y_m))$ での 訓練誤差 を
$$
L_{\mathcal D}(h):=\mathcal D\bigl(\{(x,y)\mid h(x)\ne y\}\bigr),\qquad L_S(h):=\frac1m\#\{i\mid h(x_i)\ne y_i\}
$$
とおく。ラベルが関数 $f\colon\mathcal X\to\{0,1\}$ で決まり $x$ が $\mathcal X$ 上の分布 $\mathcal D$ に従う場合は、$(x,f(x))$ の分布について同じ量を考え、$L_{(\mathcal D,f)}(h)=\mathcal D(\{x\mid h(x)\ne f(x)\})$ と書く。学習アルゴリズム は、有限の例の列 $S$ に仮説 $A(S)$ を対応させる規則である。$A(S)$ は $\mathcal H$ に入っていなくてもよい。$L_S$ を $\mathcal H$ の上で最小にする $h_S\in\mathcal H$ を返す規則を 経験リスク最小化(ERM)という。
- (実現可能な場合)$\mathcal H$ が PAC 学習可能 であるとは、関数 $m_{\mathcal H}\colon(0,1)^2\to\mathbb N$ と学習アルゴリズム $A$ があって、次が成り立つことをいう。どの $\varepsilon,\delta\in(0,1)$、どの $\mathcal X$ 上の分布 $\mathcal D$、どのラベルの関数 $f$ についても、ある $h^*\in\mathcal H$ が $L_{(\mathcal D,f)}(h^*)=0$ を満たす(実現可能性)ならば、$\mathcal D$ に独立に従い $f$ でラベルをつけた $m\ge m_{\mathcal H}(\varepsilon,\delta)$ 個の例 $S$ について、確率 $1-\delta$ 以上で $L_{(\mathcal D,f)}(A(S))\le\varepsilon$ となる。
- (不可知な場合)$\mathcal H$ が 不可知 PAC 学習可能 であるとは、$m_{\mathcal H}$ と $A$ があって、どの $\varepsilon,\delta\in(0,1)$、どの $\mathcal X\times\{0,1\}$ 上の分布 $\mathcal D$ についても、$\mathcal D$ に独立に従う $m\ge m_{\mathcal H}(\varepsilon,\delta)$ 個の例 $S$ について、確率 $1-\delta$ 以上で
$$ L_{\mathcal D}(A(S))\le\inf_{h\in\mathcal H}L_{\mathcal D}(h)+\varepsilon $$
となることをいう。
条件を満たす最小の $m_{\mathcal H}$ を 標本複雑度 という。$A(S)$ がつねに $\mathcal H$ に入るとき 適正(proper)な学習という。
1 は SSBD14 Definition 3.1(p. 43)、2 は Definition 3.3(p. 46)である(Definition 3.3 では右辺が $\min$ と書かれている)。どちらも分布 $\mathcal D$ について何も仮定しない。$\varepsilon$ が「ほぼ正しい」、$\delta$ が「おそらく」にあたる。不可知な場合の分布ではラベルが $x$ の関数でなくてよい(同じ $x$ に $0$ と $1$ の両方がつきうる)ので、雑音のあるデータを扱える。
公式の表
| クラス | 十分な例の数 | 学習の規則 | 根拠 |
|---|---|---|---|
| 有限、実現可能 | $\dfrac{\log(\lvert\mathcal H\rvert/\delta)}{\varepsilon}$ | 任意の ERM | thm-pac-finite |
| 有限、不可知 | $\dfrac{2\log(2\lvert\mathcal H\rvert/\delta)}{\varepsilon^2}$ | 任意の ERM | thm-pac-agnostic |
| 実数直線の閾値 $\mathbf 1[x\ge t]$、実現可能 | $\dfrac{\log(1/\delta)}{\varepsilon}$ | 正の例の最小値を閾値にする | ex-pac-threshold |
| 平面の軸に平行な長方形、実現可能 | $\dfrac{4\log(4/\delta)}{\varepsilon}$ | 正の例を囲む最小の長方形 | prop-pac-rectangles |
| VC 次元 $d$、実現可能 | $C_2\dfrac{d\log(1/\varepsilon)+\log(1/\delta)}{\varepsilon}$ | 任意の ERM | thm-pac-fundamental |
| VC 次元 $d$、不可知 | $C_2\dfrac{d+\log(1/\delta)}{\varepsilon^2}$ | 任意の ERM | thm-pac-fundamental |
| VC 次元 $\infty$ | 学習できない | — | prop-pac-infinite-vc |
$\log$ は自然対数、$C_2$ は $\mathcal H$ によらない定数である。どの行でも $\delta$ には $\log(1/\delta)$ でしかよらない。失敗の確率を $10$ 分の $1$ にするのに、例は足し算で増やせば足りる。
計算の手順
- 実現可能か($\mathcal H$ の中に誤差 $0$ の仮説があるか)を決める。分からなければ不可知な場合の式を使う。
- 有限のクラスなら $\lvert\mathcal H\rvert$ を数える。無限のクラスなら VC 次元を求める(VC次元)。
- $\varepsilon,\delta$ を決めて表の式に入れ、切り上げる。
- 得られる数は上界である。実際の失敗確率はずっと小さいことが多い(図)。
有限クラスの主定理
$\mathcal H$ を有限の仮説クラス、$\varepsilon,\delta\in(0,1)$ とし、$m$ は
$$
m\ge\frac{\log(\lvert\mathcal H\rvert/\delta)}{\varepsilon}
$$
を満たす整数とする。$\mathcal X$ 上の分布 $\mathcal D$ とラベルの関数 $f$ が実現可能性を満たすとき、$\mathcal D$ に独立に従い $f$ でラベルをつけた $m$ 個の例 $S$ について、確率 $1-\delta$ 以上で、訓練誤差を最小にする すべての $h_S\in\mathcal H$ が $L_{(\mathcal D,f)}(h_S)\le\varepsilon$ を満たす。特に $\mathcal H$ は ERM で PAC 学習可能である。
SSBD14 Corollary 2.3(pp. 40–41)・Corollary 3.2(p. 44)と同じ主張で、証明は次の通りである。
$L(h):=L_{(\mathcal D,f)}(h)$ と書く。実現可能性から $L(h^*)=0$ の $h^*\in\mathcal H$ がある。$L(h^*)=0$ なので、確率 $1$ で $h^*(x_i)=f(x_i)$ がすべての $i$ で成り立ち、$L_S(h^*)=0$ である。よって訓練誤差の最小値は確率 $1$ で $0$ で、どの ERM の出力 $h_S$ も $L_S(h_S)=0$ を満たす。
悪い仮説 の集合を $\mathcal H_B:=\{h\in\mathcal H\mid L(h)>\varepsilon\}$ とおく。ある ERM の出力が $L(h_S)>\varepsilon$ となるなら、その $h_S$ は $\mathcal H_B$ に入り $L_S(h_S)=0$ を満たす。よって
$$
\bigl\{\text{ある ERM の出力が }L(h_S)>\varepsilon\bigr\}\subset\bigcup_{h\in\mathcal H_B}\{L_S(h)=0\}
$$
(確率 $0$ の集合を除いて)である。$h\in\mathcal H_B$ を 1 つ固定する。$L_S(h)=0$ は $m$ 個の例のすべてで $h(x_i)=f(x_i)$ となることで、例は独立だから
$$
P\bigl(L_S(h)=0\bigr)=\prod_{i=1}^m\mathcal D\bigl(\{x\mid h(x)=f(x)\}\bigr)=(1-L(h))^m\le(1-\varepsilon)^m\le e^{-\varepsilon m}.
$$
最後は $1-u\le e^{-u}$ による。合併の確率は確率の和以下だから、
$$
P\bigl(\text{ある ERM の出力が }L(h_S)>\varepsilon\bigr)\le\lvert\mathcal H_B\rvert e^{-\varepsilon m}\le\lvert\mathcal H\rvert e^{-\varepsilon m}.
$$
$m\ge\log(\lvert\mathcal H\rvert/\delta)/\varepsilon$ なら $\lvert\mathcal H\rvert e^{-\varepsilon m}\le\delta$ である。$m_{\mathcal H}(\varepsilon,\delta):=\lceil\log(\lvert\mathcal H\rvert/\delta)/\varepsilon\rceil$ とおけば、def-pac-def の 1 が ERM について成り立つ。∎
証明が使ったのは、各 $h\in\mathcal H_B$ が $m$ 回続けて当たる確率が小さいことと、合併の確率の評価だけである。$\mathcal D$ が何であっても同じ評価になる。
$\mathcal H$ を有限の仮説クラス、$\varepsilon,\delta\in(0,1)$ とし、$m\ge2\log(2\lvert\mathcal H\rvert/\delta)/\varepsilon^2$ とする。$\mathcal X\times\{0,1\}$ 上のどの分布 $\mathcal D$ についても、$\mathcal D$ に独立に従う $m$ 個の例 $S$ について、確率 $1-\delta$ 以上で次が成り立つ。
- すべての $h\in\mathcal H$ で $\lvert L_S(h)-L_{\mathcal D}(h)\rvert\le\varepsilon/2$。
- 訓練誤差を最小にするすべての $h_S\in\mathcal H$ が $L_{\mathcal D}(h_S)\le\min_{h\in\mathcal H}L_{\mathcal D}(h)+\varepsilon$ を満たす。
特に $\mathcal H$ は ERM で不可知 PAC 学習可能である。
SSBD14 Corollary 4.6(p. 57)と同じ主張である。
$h\in\mathcal H$ を 1 つ固定し、$\xi_i:=\mathbf 1[h(x_i)\ne y_i]$ とおく。$\xi_1,\dots,\xi_m$ は独立で同じ分布に従い、値は $[0,1]$ に入り、平均は $L_{\mathcal D}(h)$ で、$L_S(h)=\frac1m\sum_i\xi_i$ である。Hoeffdingの不等式(SSBD14 Lemma 4.5、p. 56)により
$$
P\Bigl(\lvert L_S(h)-L_{\mathcal D}(h)\rvert>\frac\varepsilon2\Bigr)\le2\exp\Bigl(-2m\Bigl(\frac\varepsilon2\Bigr)^2\Bigr)=2e^{-m\varepsilon^2/2}.
$$
$h$ について合併をとると、1 が成り立たない確率は $2\lvert\mathcal H\rvert e^{-m\varepsilon^2/2}$ 以下で、$m\ge2\log(2\lvert\mathcal H\rvert/\delta)/\varepsilon^2$ ならこれは $\delta$ 以下である。
1 が成り立つとき、ERM の出力 $h_S$ と任意の $h\in\mathcal H$ について
$$
L_{\mathcal D}(h_S)\le L_S(h_S)+\frac\varepsilon2\le L_S(h)+\frac\varepsilon2\le L_{\mathcal D}(h)+\varepsilon.
$$
真ん中の不等号は $h_S$ が訓練誤差を最小にすることによる。$h$ について最小をとれば 2 を得る。∎
不可知な場合は $1/\varepsilon^2$、実現可能な場合は $1/\varepsilon$ である。実現可能な場合は誤差 $0$ の仮説との比較だけで済み、悪い仮説が $m$ 回続けて当たる確率を直接に評価できる。不可知な場合は訓練誤差と真の誤差の差を平均のまわりのゆらぎとして測るので、$1/\sqrt m$ の精度しか出ない。この差は証明の粗さによるものではなく、2 つ以上の関数を含むクラスでは、thm-pac-fundamental の下界の通りどの学習アルゴリズムでも避けられない。
無限のクラス
軸に平行な長方形
$\mathcal X=\mathbb R^2$ とし、$\mathcal H_{\mathrm{rec}}$ を閉長方形 $[a_1,b_1]\times[a_2,b_2]$($a_j\le b_j$)の指示関数の全体に、恒等的に $0$ の関数を加えたものとする。このクラスは無限である。学習の規則として、正の例をすべて含む最小の閉長方形 $R_S$(正の例が無ければ恒等的に $0$)を返すものを使う。$R_S$ は訓練誤差 $0$ の仮説なので、この規則は ERM の 1 つである。
$\varepsilon,\delta\in(0,1)$、$m\ge4\log(4/\delta)/\varepsilon$ とする。$\mathbb R^2$ 上のどの(Borel)確率分布 $\mathcal D$ と、どの $f\in\mathcal H_{\mathrm{rec}}$ についても、$\mathcal D$ に独立に従い $f$ でラベルをつけた $m$ 個の例 $S$ について、確率 $1-\delta$ 以上で $L_{(\mathcal D,f)}(R_S)\le\varepsilon$ となる。特に $\mathcal H_{\mathrm{rec}}$ は PAC 学習可能である。
$f$ が恒等的に $0$ なら正の例はなく $R_S$ も恒等的に $0$ で、誤差は $0$ である。以下 $f$ を長方形 $R^*=[a_1,b_1]\times[a_2,b_2]$ の指示関数とする。正の例はすべて $R^*$ に入るので $R_S\subset R^*$ で、$R_S$ が誤るのは $R^*\setminus R_S$ の点だけである。よって $L(R_S)=\mathcal D(R^*\setminus R_S)$ である。$\mathcal D(R^*)\le\varepsilon$ なら結論は明らかなので、$\mathcal D(R^*)>\varepsilon$ とする。
左の帯を作る。$g(t):=\mathcal D([a_1,t]\times[a_2,b_2])$($a_1\le t\le b_1$)は増加関数で、閉集合の減少列の測度の連続性から右連続である。$g(b_1)=\mathcal D(R^*)>\varepsilon/4$ だから $t_1:=\min\{t\mid g(t)\ge\varepsilon/4\}$ が存在し、帯 $T_1:=[a_1,t_1]\times[a_2,b_2]$ は $\mathcal D(T_1)\ge\varepsilon/4$ を満たす。また $[a_1,t_1)\times[a_2,b_2]$ は $t< t_1$ の $[a_1,t]\times[a_2,b_2]$ の増加列の合併だから、その測度は $\varepsilon/4$ 以下である。同じように右・下・上の帯 $T_2,T_3,T_4$ を作る(右の帯は $[t_2,b_1]\times[a_2,b_2]$ で、$(t_2,b_1]\times[a_2,b_2]$ の測度は $\varepsilon/4$ 以下、など)。
例が $T_1$ に 1 つでも入れば、その例は正で第 1 座標は $t_1$ 以下だから、$R_S=[l,r]\times[d,u]$ の左端 $l$ は $t_1$ 以下である。すると $R^*$ のうち $R_S$ の左にある部分 $\{z\in R^*\mid z_1< l\}$ は $[a_1,t_1)\times[a_2,b_2]$ に含まれ、測度は $\varepsilon/4$ 以下である。$R^*\setminus R_S$ は、左・右・下・上にはみ出す 4 つの部分の合併である。4 つの帯のすべてに例が入れば、4 つの部分の測度はどれも $\varepsilon/4$ 以下で、$L(R_S)\le\varepsilon$ となる。
したがって $L(R_S)>\varepsilon$ となるのは、ある帯に例が 1 つも入らないときに限る。$\mathcal D(T_j)\ge\varepsilon/4$ だから、1 つの帯に例が入らない確率は $(1-\varepsilon/4)^m\le e^{-\varepsilon m/4}$ で、
$$
P\bigl(L(R_S)>\varepsilon\bigr)\le4e^{-\varepsilon m/4}\le\delta\qquad\Bigl(m\ge\frac{4\log(4/\delta)}{\varepsilon}\Bigr).
$$
∎
$\mathcal D$ に原子があっても、帯を閉区間でとり、はみ出す部分を開いた側で評価しているので証明は変わらない。同じ議論で、$\mathbb R^n$ の軸に平行な直方体は $2n\log(2n/\delta)/\varepsilon$ 個の例で学べる(帯が $2n$ 本になる)。
VC 次元が無限のクラス
学習アルゴリズムを 1 つ決めると、それが失敗する分布がある、というのが No-Free-Lunch 定理である。
$A$ を任意の学習アルゴリズム、$m$ を $\lvert\mathcal X\rvert/2$ より小さい自然数とする。このとき $\mathcal X\times\{0,1\}$ 上の分布 $\mathcal D$ で、次の 2 つを満たすものがある。
SSBD14 Theorem 5.1(p. 61、証明は pp. 61–63)の主張である。証明は、$C$ の上の一様分布と $C$ 上の $2^{2m}$ 通りのラベルの付け方の平均をとり、どの $A$ でも誤差の期待値が $1/4$ 以上になるラベルの付け方があることを示す。誤差は $1$ 以下だから、期待値 $1/4$ 以上から $P(L\ge1/8)\ge1/7$ が出る(ex-pac-nfl)。1・2 の完全な証明は 統計的学習理論 の定理「どのアルゴリズムにも失敗する分布がある」にあり、$C$ を粉砕される集合にとれば「さらに」の部分も同じ証明で出る。
$\mathcal H$ の VC 次元が無限なら、$\mathcal H$ は PAC 学習可能でない。特に $\mathcal X$ が無限集合で $\mathcal H$ が $\mathcal X\to\{0,1\}$ の関数の全体なら、$\mathcal H$ は PAC 学習可能でない。
SSBD14 Theorem 6.6(p. 70)と Corollary 5.2(p. 63)の主張で、次のように thm-pac-nfl から出る。
$\mathcal H$ が PAC 学習可能だとし、$m_{\mathcal H}$ と $A$ をとる。$\varepsilon:=1/16$、$\delta:=1/8$、$m:=\max\bigl(m_{\mathcal H}(\varepsilon,\delta),1\bigr)$ とおく。VC 次元が無限だから、$\mathcal H$ に粉砕される大きさ $2m$ の集合 $C$ がある。thm-pac-nfl の後半により、$\mathcal X$ 上の分布($\mathcal D$ の $x$ の周辺分布)と $f\in\mathcal H$ で、$L(f)=0$(実現可能)なのに確率 $1/7$ 以上で $L(A(S))\ge1/8>\varepsilon$ となるものがある。すると $L(A(S))\le\varepsilon$ となる確率は $1-1/7=6/7$ 以下で、$1-\delta=7/8$ に届かない。$A$ と $m_{\mathcal H}$ は任意だったから、$\mathcal H$ は PAC 学習可能でない。後半は、$\mathcal X$ が無限なら関数の全体がどの有限集合も粉砕することから従う。∎
学習理論の基本定理
逆に VC 次元が有限なら学習でき、例の数も VC 次元で決まる。
$\mathcal H$ を $\mathcal X\to\{0,1\}$ の関数のクラスとする。
- 次は同値である。(a) $\mathcal H$ は PAC 学習可能。(b) $\mathcal H$ は不可知 PAC 学習可能。(c) 任意の ERM が $\mathcal H$ を不可知 PAC 学習する。(d) $\mathcal H$ の VC 次元は有限。
- VC 次元 $d$ が有限なら、$\mathcal H$ によらない定数 $C_1,C_2>0$ があって、標本複雑度は次を満たす。
$$ C_1\frac{d+\log(1/\delta)}{\varepsilon}\le m_{\mathcal H}(\varepsilon,\delta)\le C_2\frac{d\log(1/\varepsilon)+\log(1/\delta)}{\varepsilon}\quad(\text{実現可能}), $$
$$ C_1\frac{d+\log(1/\delta)}{\varepsilon^2}\le m_{\mathcal H}(\varepsilon,\delta)\le C_2\frac{d+\log(1/\delta)}{\varepsilon^2}\quad(\text{不可知}). $$
1 は SSBD14 Theorem 6.7(p. 72、証明は §6.5)の 6 つの同値のうち 4 つ、2 は Theorem 6.8(pp. 72–73、証明は第 28 章)である。2 の下界は $d\ge1$ で使う($d=0$ では $\mathcal H$ は 1 つの関数だけで、例を使わずに学べる)。(d)⇒(c) の証明は、Sauer–Shelahの補題 で $\mathcal H$ を $m$ 点に制限したときの関数の数を $m$ の多項式で抑え、thm-pac-agnostic の合併の議論を、この「実質の大きさ」についての一様収束の評価に置き換えて行う(SSBD14 §6.5.1–6.5.2、pp. 73–76)。同じ評価は Rademacher複雑度 からも出る。(a)⇒(d) は prop-pac-infinite-vc である。
thm-pac-finite の $\log\lvert\mathcal H\rvert$ は、VC 次元の評価 $d\le\log_2\lvert\mathcal H\rvert$ と比べると粗いことがある。$\{1,\dots,k\}$ 上の閾値関数 $\mathbf 1[x\ge t]$ のクラスでは $\lvert\mathcal H\rvert=k+1$ だが $d=1$ である(SSBD14 §6.3.4、p. 72)。
例
$\mathcal X=\{0,1\}^{10}$ 上の連言($x_1\wedge\neg x_3$ のような、リテラルの「かつ」)のクラスは $\lvert\mathcal H\rvert\le3^{10}+1=59050$ である。$\varepsilon=0.05$、$\delta=0.01$ では、実現可能なら $312$ 個、不可知なら $13028$ 個の例で足りる。
計算を開く
各変数は「そのまま現れる・否定で現れる・現れない」の 3 通りで、これに恒等的に $0$ の式を加える(SSBD14 §8.2.3、p. 106)。$\log59050\approx10.986$、$\log100\approx4.605$ なので、thm-pac-finite から $(10.986+4.605)/0.05\approx311.83$。thm-pac-agnostic から $2\log(2\cdot59050\cdot100)/0.05^2\approx13027.57$。変数を $20$ 個にすると $\log\lvert\mathcal H\rvert$ が約 $2$ 倍になり、実現可能な場合は $532$ 個である。$\lvert\mathcal H\rvert$ は変数の数について指数的に増えるが、例の数は線形にしか増えない。
$\mathcal X=\mathbb R$、$\mathcal H=\{\mathbf 1[x\ge t]\mid t\in\mathbb R\}$ とし、正の例の最小値を閾値にする(正の例が無ければ恒等的に $0$)。$\varepsilon=0.05$、$\delta=0.01$ では $m=93$ 個で足り、そのときの失敗の確率は $[0,1]$ の一様分布で $0.95^{93}\approx0.00848$ である。
証明と計算を開く
目標を $\mathbf 1[x\ge t^*]$ とすると、学習した閾値 $\hat t$ は $t^*$ 以上で、誤るのは $[t^*,\hat t)$ の点だけである。$s:=\min\{s\ge t^*\mid\mathcal D([t^*,s])\ge\varepsilon\}$ とおくと(存在しなければ誤差はつねに $\varepsilon$ 以下)、$[t^*,s]$ に例が入れば $\hat t\le s$ で誤差は $\mathcal D([t^*,s))\le\varepsilon$。入らない確率は $(1-\varepsilon)^m\le e^{-\varepsilon m}$ なので $m\ge\log(1/\delta)/\varepsilon=92.10$ で足りる。$t^*=0.37$ の一様分布で $2\times10^4$ 回試すと失敗の割合は $0.00850$ だった。
prop-pac-rectangles で $\varepsilon=0.05$、$\delta=0.01$ なら $m=480$ である。$[0,1]^2$ の一様分布、目標 $[0.2,0.7]\times[0.3,0.8]$ で $2\times10^4$ 回試すと、失敗の割合は $m=100$ で $0.232$、$m=200$ で $0.0069$、$m=480$ で $0$ 回だった。
計算を開く
$4\log400/0.05\approx479.32$。上界は $4(1-0.0125)^{480}\approx0.00955$。$m=200$ の上界 $4e^{-2.5}\approx0.328$ は実際の値 $0.0069$ よりずっと大きい。証明は分布によらない最悪の場合を扱うためである。
誤差 $L$ が $0\le L\le1$ で $E[L]\ge1/4$ なら、$p:=P(L\ge1/8)$ は $1/7$ 以上である。
計算を開く
$E[L]\le p\cdot1+(1-p)\cdot\frac18$ だから $\frac14\le\frac18+\frac78p$、すなわち $p\ge\frac17$。$L$ が確率 $\frac17$ で $1$、確率 $\frac67$ で $\frac18$ をとるとき $E[L]=\frac17+\frac6{56}=\frac14$ で等号が成り立つ。
反例の表
thm-pac-finite(有限、実現可能、訓練と評価が同じ分布の独立な例)から条件を 1 つずつ外す。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| VC 次元が有限(有限のクラス) | $\mathcal X=\mathbb N$、$\mathcal H$ は $\mathbb N\to\{0,1\}$ の関数の全体 | PAC 学習可能性。どの $m$ でも失敗する分布がある(prop-pac-infinite-vc) |
| 実現可能性 | $\mathcal H=\{\text{恒等的に }0,\ \text{恒等的に }1\}$、ラベルは $x$ と独立な公平な硬貨 | 誤差 $\varepsilon$ 以下。どの $h$ も $L_{\mathcal D}(h)=1/2$ で、$\varepsilon< 1/2$ は達成できない。不可知な場合の保証($\min$ からの差)は残る |
| 評価の分布が訓練の分布と同じ | $\mathcal X=[0,1]$、$\mathcal H=\{0,\mathbf 1_{[1/2,1]}\}$、目標 $\mathbf 1_{[1/2,1]}$、訓練は $[0,1/2)$ の一様分布、評価は $[1/2,1]$ の一様分布 | 誤差 $\varepsilon$ 以下。訓練の例はすべてラベル $0$ で、ERM は恒等的に $0$ を返しうるので、評価での誤差は $m$ によらず $1$ |
2 行目で $m=1000$ とすると、ERM の訓練誤差の平均は $0.4875$ で、真の誤差 $0.5$ より小さく見える。
確かめを開く
1 行目:$\mathbb N$ のどの有限集合も粉砕されるので VC 次元は無限で、prop-pac-infinite-vc の後半が当てはまる。外れているのは有限性だけである。
2 行目:どの $h$ も $L_{\mathcal D}(h)=\frac12=\min_h L_{\mathcal D}(h)$ なので、実現可能性だけが外れている。ERM は $0$ と $1$ の多い方を選ぶので訓練誤差は $\frac12$ 未満になりやすい($2\times10^4$ 回の平均 $0.4875$)。
3 行目:クラスは有限で目標は $\mathcal H$ に入り、訓練の分布では実現可能である。どちらの仮説も訓練誤差 $0$ なので恒等的に $0$ も ERM の出力で、thm-pac-finite は訓練の分布での誤差 $0$ を保証するが、評価の分布では誤差 $1$ になる。
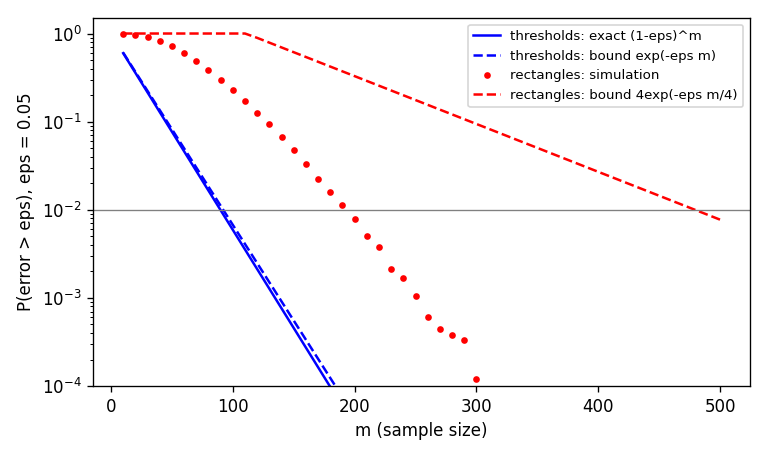 図: 誤差の許容 ε=0.05 のときの、失敗の確率 P(L(h_S)>ε)(縦軸、対数目盛り)と例の数 m(横軸、10 から 500)。青の実線は実数直線の閾値関数の厳密値 (1-ε)^m、青の破線はその上界 e^{-εm}。赤の点は軸に平行な長方形の学習のシミュレーション([0,1]^2 の一様分布、目標 [0.2,0.7]×[0.3,0.8]、各 m で 10 万回)で、m=100 で約 0.23、m=200 で約 0.008、m=300 で約 0.0001。赤の破線は上界 4e^{-εm/4} で、m=480 で 0.01 を下回る。灰色の横線は δ=0.01。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| ある決まった分布で誤差が小さければ PAC 学習できる | すべての分布について同じ $m$ で成り立つことを要求する | def-pac-def。分布を固定すると条件が弱くなる |
| 無限のクラスは学習できない | VC 次元が有限なら学習できる | ex-pac-threshold、prop-pac-rectangles |
| パラメータの数が VC 次元を決める | 1 つのパラメータでも VC 次元は無限になりうる | $\{x\mapsto\mathbf 1[\sin(\theta x)>0]\}$(SSBD14 §6.3.5、p. 72) |
| 雑音があっても $1/\varepsilon$ 個の例で足りる | 不可知な場合は $1/\varepsilon^2$ のオーダーが要る | thm-pac-fundamental の 2 |
| 学習可能なら速く学習できる | 例の数と計算時間は別の問題 | 補足の 3 項 DNF |
補足
計算量。 Valiant の元の定義は、学習アルゴリズムの計算時間が $1/\varepsilon$、$1/\delta$ と問題の大きさの多項式であることも要求する(SSBD14 §3.4、p. 50)。3 項の DNF(連言 3 つの「または」)のクラスは $\lvert\mathcal H\rvert\le3^{3n}$ で例の数は少なくて済むが、RP $\ne$ NP なら、その中から仮説を選ぶ多項式時間のアルゴリズムはない(Pitt–Valiant 1988、Kearns ほか 1994。SSBD14 §8.2.4、p. 107)。一方、3-CNF という大きいクラスから仮説を選べば多項式時間で学べる(§8.3、p. 107)。仮説を $\mathcal H$ の外からとってよいことは、計算量では意味がある。
弱い学習。 $\varepsilon$ を $1/2$ よりわずかに小さい値に固定した学習しかできなくても、それを組み合わせて任意の $\varepsilon$ を達成できる(ブースティング)。
関連項目
- 前提: Hoeffdingの不等式, 独立性(確率論)
- 理論: 統計的学習理論, VC次元, Sauer–Shelahの補題, Rademacher複雑度
- 手法: ブースティング, サポートベクターマシン
- 関連: P≠NP予想
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

