カイ二乗検定
概要
カイ二乗検定(chi-squared test)とは、$k$ 区分の度数 $N_i$ と仮説の期待度数 $E_i$ から $X^2=\sum_i(N_i-E_i)^2/E_i$ を計算し、カイ二乗分布と比べる検定である。試行が独立で確率がすべて正なら、$n\to\infty$ で確率が既知のとき $X^2$ は $\chi^2_{k-1}$ に収束する。階数の条件のもとで $s$ 個の母数を区分の度数から最尤推定すると自由度は $k-1-s$ に減るが、生のデータから推定すると極限は一般にカイ二乗分布にならない。適合度や独立性の判定に使う。
観測した度数が仮説の予想からどれだけずれているかを、$\sum(\text{観測}-\text{期待})^2/\text{期待}$ という 1 つの数で測り、カイ二乗分布と比べて判定する。これが カイ二乗検定 である(Pea00)。さいころが公平か、遺伝の比が理論どおりか、2 つの属性が独立かが、同じ計算で調べられる。
使うときに迷うのは自由度である。確率が全部わかっていれば「区分の数 $-1$」だが、確率の中の母数を $s$ 個データから推定すると $s$ 減る(Fis22)。しかも減ってよいのは、区分の度数から最尤推定したときで、生のデータから推定すると極限は一般にカイ二乗分布でなくなる(CL54)。この記事では、この減り方を射影として証明し、生のデータで推定した場合の極限、検出力の計算、自由度を誤ったときの有意水準のずれを扱う。単純な適合度の場合の極限は カイ二乗分布 に、独立性の検定の証明は 分割表 にあるので、そちらを引く。
定義と使える条件
結果が $1,\dots,k$ のどれかである試行を独立に $n$ 回行い、$i$ が出た回数を $N_i$ とする。$(N_1,\dots,N_k)$ は 多項分布 に従う。確率の族 $p(\theta)=(p_1(\theta),\dots,p_k(\theta))$($\theta\in\Theta\subset\mathbb{R}^s$)に対し、
$$
X^2(\theta):=\sum_{i=1}^k\frac{(N_i-np_i(\theta))^2}{np_i(\theta)}
$$
とおく。$E_i:=np_i(\theta)$ を 期待度数 という。
仮説 $H_0$:ある $\theta_0\in\Theta$ について確率は $p(\theta_0)$ である。$\hat\theta$ を $\theta$ の推定量として、$X^2(\hat\theta)$ が $\chi^2_\nu$ の上側 $\alpha$ 点を超えるとき $H_0$ を棄却する検定を、自由度 $\nu$ の Pearson のカイ二乗検定(水準 $\alpha$)という。確率が完全に指定されている場合は $\hat\theta$ を使わず $X^2$ をそのまま使う。
$Y_1,\dots,Y_n$ が独立に $N(\mu,\sigma^2)$ に従い、$S^2$ を不偏分散とする。仮説 $\sigma^2=\sigma_0^2$ に対し、$T:=(n-1)S^2/\sigma_0^2$ を $\chi^2_{n-1}$ と比べる検定を 分散のカイ二乗検定 という。
使える条件は次のとおりである。
- (a) 推定量:$\hat\theta$ は区分の度数 $N_i$ の尤度の一致な最大点である。
- (b) 階数:$A_{ij}:=\partial_jp_i(\theta_0)/\sqrt{p_i(\theta_0)}$ の $k\times s$ 行列 $A$ の階数が $s$ である。
- (c) 内点:$\theta_0$ は $\Theta$ の内点、すべての $p_i(\theta_0)>0$、$p$ は $\theta_0$ の近くで $C^3$ 級である。
- (d) 独立:$n$ 回の試行は独立である。
- (e) 大標本:$n\to\infty$ の近似である。小さな確率の区分では $n$ が相当大きくても近似が悪い。
- (f) 正規性:分散の検定だけに要る。
公式の表
| 検定 | 統計量 | 極限の自由度 | 使える条件 | 根拠 |
|---|---|---|---|---|
| 適合度(確率が既知) | $X^2$ | $k-1$ | (d)(e) | カイ二乗分布 の定理「Pearson の定理」 |
| 適合度(母数 $s$ 個を推定) | $X^2(\hat\theta)$ | $k-1-s$ | (a)〜(e) | thm-chi-composite |
| 独立性($r\times c$ 表) | $\sum_{ij}(N_{ij}-E_{ij})^2/E_{ij}$、$E_{ij}=N_{i\cdot}N_{\cdot j}/n$ | $(r-1)(c-1)$ | (d)(e)、全周辺確率が正 | 分割表 の定理「独立性の検定統計量の漸近分布」 |
| 生のデータで最尤推定($\mu_j< 1$ があるとき) | $X^2(\tilde\theta)$ | カイ二乗分布でない | thm-chi-cl の条件 | thm-chi-cl |
| 尤度比 | $G^2=2\sum N_i\log(N_i/E_i)$ | 確率が既知なら $k-1$、母数 $s$ 個を推定すれば $k-1-s$ | $X^2$ と同じ | prop-chi-score |
| 局所対立 | $X^2$ | 非心 $\chi^2_{k-1}(\lambda)$、$\lambda=\sum\delta_i^2/p_i$ | (d)(e) | thm-chi-power |
| 分散 | $T$ | $\chi^2_{n-1}$(正確) | (f) | カイ二乗分布 の例「偏差平方和の分解」 |
独立性の検定は、$p_{ij}=a_ib_j$ を母数 $s=(r-1)+(c-1)$ 個の族とみた複合の適合度検定で、$k=rc$ から $k-1-s=(r-1)(c-1)$ である。
主定理
以下 $u:=(\sqrt{p_i(\theta_0)})_i$、$W_n:=\bigl((N_i-np_i(\theta_0))/\sqrt{np_i(\theta_0)}\bigr)_i$ とし、$W_n(\theta)$ を同じ式で $\theta_0$ を $\theta$ に替えたものとする。$\Pi:=I_k-uu^{\top}$ である。カイ二乗分布 の定理「Pearson の定理」の証明のとおり、$W_n$ は $N_k(0,\Pi)$ に分布収束する。$\lvert W_n(\theta)\rvert^2=X^2(\theta)$ である。
(a)〜(d) を仮定し、$H_0$ が正しいとする。このとき $n\to\infty$ で $X^2(\hat\theta)$ は $\chi^2_{k-1-s}$ に分布収束する。さらに $W_n(\hat\theta)=(I-P_A)W_n+o_p(1)$ である。ここで $P_A:=A(A^{\top}A)^{-1}A^{\top}$ は $A$ の像への直交射影である。
段 1(スコアを $W_n$ で書く)。 区分の度数だけを観測とするモデルの対数尤度は $\ell(\theta)=\sum_iN_i\log p_i(\theta)$ である。$\sum_ip_i\equiv1$ を微分すると $\sum_i\partial_jp_i=0$、すなわち $u^{\top}A=0$ である。したがって
$$
n^{-1/2}\partial_j\ell(\theta_0)=n^{-1/2}\sum_iN_i\frac{\partial_jp_i}{p_i}=n^{-1/2}\sum_i(N_i-np_i)\frac{\partial_jp_i}{p_i}=(A^{\top}W_n)_j .
$$
観測 1 個の Fisher 情報行列は $\sum_i\partial_jp_i\partial_lp_i/p_i$ の成分をもつ行列 $A^{\top}A$ で、(b) により正定値である。
段 2(推定量の展開)。 標本空間が有限で $p_i(\theta_0)>0$ なので、Wald検定 の条件 (i)〜(v) は (a)(c)(d) と (b) から従う(導関数は有限個の値しかとらず、支配は自明である。$p_i(\theta)$ の連続性から $\theta_0$ の近くで $p_i>0$)。同じ記事の補題「最尤推定量の周りの局所展開」の 2 により
$$
h_n:=\sqrt n(\hat\theta-\theta_0)=(A^{\top}A)^{-1}A^{\top}W_n+o_p(1)
$$
であり、とくに $h_n$ は確率有界である。
段 3(残差の展開)。 Taylor の定理から $p_i(\hat\theta)-p_i(\theta_0)=n^{-1/2}\nabla p_i(\theta_0)^{\top}h_n+o_p(n^{-1/2})$ なので、
$$
N_i-np_i(\hat\theta)=\sqrt{np_i(\theta_0)}\,(W_n)_i-\sqrt n\,\nabla p_i(\theta_0)^{\top}h_n+o_p(\sqrt n)
$$
である。$\sqrt{np_i(\hat\theta)}$ で割り、$p_i(\hat\theta)\to p_i(\theta_0)>0$ を使うと
$$
W_n(\hat\theta)=W_n-Ah_n+o_p(1)=(I-P_A)W_n+o_p(1)
$$
を得る。
段 4(射影の階数)。 $W_n\to\Pi Z$($Z\sim N_k(0,I_k)$)の法則収束と 確率変数の収束 の定理「連続写像による収束の保存」により、$(I-P_A)W_n$ は $(I-P_A)\Pi Z$ に分布収束する。$u^{\top}A=0$ から $P_Au=0$ なので
$$
R:=(I-P_A)\Pi=I-P_A-uu^{\top}
$$
は、互いに直交する単位ベクトル $u$ と $s$ 次元の $\operatorname{Im}A$ の直交補空間への直交射影で、階数は $k-1-s$ である。
段 5(結論)。 確率変数の収束 の定理「Slutskyの定理」と連続写像により、$X^2(\hat\theta)=\lvert W_n(\hat\theta)\rvert^2$ は $\lvert RZ\rvert^2=Z^{\top}RZ$ に分布収束する。カイ二乗分布 の定理「2 次形式がカイ二乗分布に従う条件」により、これは $\chi^2_{k-1-s}$ に従う。$\square$
自由度の意味はこの射影で見える。$W_n$ は $\sum_i(N_i-np_i)=0$ のために $u$ の方向に動けず、母数をデータに合わせることで $\operatorname{Im}A$ の方向のずれが消える。$s$ 個の母数がちょうど $s$ 方向を消すのは、(b) の階数の条件があるときである。
$Y_1,\dots,Y_n$ が独立に密度 $f(y;\theta_0)$ に従い、Wald検定 の条件 (i)〜(v) を満たすとする。$\mathcal I$ を Fisher 情報行列、$\tilde\theta$ を $Y$ の尤度の一致な最大点とする。標本空間の分割 $C_1,\dots,C_k$ を固定し、$N_i:=\#\{m\mid Y_m\in C_i\}$、$p_i(\theta):=P_\theta(Y\in C_i)$ とする。$p_i(\theta_0)>0$、$p$ は $C^2$ 級で $\partial_jp_i=\mathrm E_\theta[\mathbf 1_{C_i}\partial_j\log f]$ とし、$A$ の階数を $s$ とする($k-1\ge s$)。このとき
$$
X^2(\tilde\theta)\ \longrightarrow\ \sum_{i=1}^{k-1-s}Z_i^2+\sum_{j=1}^{s}(1-\mu_j)Z_{k-1-s+j}^2\qquad(\text{分布収束})
$$
である。$Z_i$ は独立に $N(0,1)$ に従い、$\mu_j\in(0,1]$ は $\mathcal I^{-1/2}A^{\top}A\,\mathcal I^{-1/2}$ の固有値である。$0\le1-\mu_j< 1$ なので、極限の上側確率は $\chi^2_{k-1-s}$ のもの以上、$\chi^2_{k-1}$ のもの以下である(CL54)。
$Z_n:=n^{-1/2}\sum_m\nabla\log f(Y_m;\theta_0)$ とする。$(W_n,Z_n)$ は独立同分布の和で、$\mathrm E[\frac{\mathbf 1_{C_i}-p_i}{\sqrt{p_i}}\partial_j\log f]=\partial_jp_i/\sqrt{p_i}=A_{ij}$(スコアの平均は $0$)なので、共分散が $\begin{pmatrix}\Pi&A\\A^{\top}&\mathcal I\end{pmatrix}$ の正規分布に同時に分布収束する。
Wald検定 の補題「最尤推定量の周りの局所展開」の 2 により $\sqrt n(\tilde\theta-\theta_0)=\mathcal I^{-1}Z_n+o_p(1)$ である。prf-chi-composite の段 3 と同じ展開で $W_n(\tilde\theta)=W_n-A\mathcal I^{-1}Z_n+o_p(1)$ なので、これは $N_k(0,\Sigma)$ に分布収束する。共分散は
$$
\Sigma=\Pi-A\mathcal I^{-1}A^{\top}-A\mathcal I^{-1}A^{\top}+A\mathcal I^{-1}\mathcal I\,\mathcal I^{-1}A^{\top}=\Pi-BB^{\top},\qquad B:=A\mathcal I^{-1/2}
$$
である。$u^{\top}A=0$ なので $\operatorname{Im}B=\operatorname{Im}A\perp u$ である。$BB^{\top}$ の 0 でない固有値は $B^{\top}B$ の固有値 $\mu_j>0$(階数 $s$)で、固有ベクトルは $\operatorname{Im}A$ にある。よって $\Sigma$ は $u$ で固有値 $0$、$\operatorname{Im}A$ で固有値 $1-\mu_j$、残りの $k-1-s$ 次元で固有値 $1$ をもつ。$\Sigma$ は共分散行列なので $1-\mu_j\ge0$ である。直交対角化すると、$N_k(0,\Sigma)$ の長さの 2 乗は主張の和の法則に従う。$\square$
$\mu_j$ は「区分の度数が持つ $\theta$ の情報」と「生のデータが持つ情報」の比である。区分に分けると情報が減るので $A^{\top}A\le\mathcal I$ で、$\mu_j\le1$ はこれを表す。
- $p_1,\dots,p_{k-1}$ を母数とする多項分布のモデルで、点 $p$ での Wald検定 のスコア統計量は $X^2(p)$ に等しい。
- thm-chi-composite の仮定のもとで、$G^2:=2\sum_iN_i\log(N_i/np_i(\hat\theta))$ は $G^2-X^2(\hat\theta)\to0$(確率収束)を満たす。同じことは確率が既知の場合にも成り立つ。
証明を開く
1:スコアは $s_i=N_i/p_i-N_k/p_k$($i< k$)、情報行列は $n(\operatorname{diag}(1/p_i)+\mathbf 1\mathbf 1^{\top}/p_k)$ で、逆行列は $(\operatorname{diag}(p_i)-pp^{\top})/n$ である(掛けて確かめる。$p$ は $k-1$ 次元)。$v_i:=N_i/p_i$($i\le k$)とすると、スコア統計量は $v$ の $p$ に関する分散の $1/n$ 倍である($v_i-v_k=s_i$ で、分散は定数をずらしても変わらない)。$\sum_ip_iv_i^2-(\sum_ip_iv_i)^2=\sum_iN_i^2/p_i-n^2$ なので、これは $\sum_iN_i^2/(np_i)-n=X^2(p)$ に等しい。
2:$E_i:=np_i(\hat\theta)$、$D_i:=N_i-E_i$ とすると、thm-chi-composite から $D_i=O_p(\sqrt n)$、$E_i/n\to p_i(\theta_0)>0$ である。$2(E+D)\log(1+D/E)=2D+D^2/E+O(\lvert D\rvert^3/E^2)$ を $i$ について足すと、$\sum_iD_i=0$ から $G^2=X^2(\hat\theta)+O_p(n^{-1/2})$ を得る。$\square$
したがって Pearson の検定はスコア検定の一種で、thm-chi-composite は Wald検定 の定理「3 つの統計量の漸近同等性」の、$r=k-1-s$ 個の制約の場合と読める。$G^2$ は 尤度比検定 の統計量である。
検出力
$Z_1,\dots,Z_\nu$ が独立に $N(0,1)$ に従い $\sum_i\mu_i^2=\lambda$ のとき、$\sum_i(Z_i+\mu_i)^2$ の分布を 非心度 $\lambda$ の非心カイ二乗分布 $\chi^2_\nu(\lambda)$ という。正規分布の回転不変性から、法則は $\mu$ の長さだけで決まる。
$p_0$ の成分はすべて正、$\sum_i\delta_i=0$ とする。各 $n$ で真の確率が $p_0+\delta/\sqrt n$ なら、$p_0$ に対する $X^2$ は $\chi^2_{k-1}(\lambda)$、$\lambda:=\sum_i\delta_i^2/p_{0,i}$ に分布収束する。また、真の確率が $q\ne p_0$ で固定なら $X^2/n\to w^2:=\sum_i(q_i-p_{0,i})^2/p_{0,i}>0$(確率収束)で、検定の検出力は $1$ に収束する。
$p_n:=p_0+\delta/\sqrt n$ とする。$m$ 回目の試行のベクトル $\xi_{n,m}$ を第 $i$ 成分 $(\mathbf 1\{\text{結果}=i\}-p_{n,i})/\sqrt{p_{0,i}}$ で定めると、有界で平均 $0$、共分散は $\Pi$ に収束する。三角配列について Lindeberg–Fellerの中心極限定理 と Cramér–Wold の方法を使うと、$n^{-1/2}\sum_m\xi_{n,m}\to N_k(0,\Pi)$ である。$(N_i-np_{0,i})/\sqrt{np_{0,i}}$ はこれに $\mu_i:=\delta_i/\sqrt{p_{0,i}}$ を足したものである。$u^{\top}\mu=\sum_i\delta_i=0$ なので $\mu\in\operatorname{Im}\Pi$ で、極限は $\Pi Z+\mu$ の $k-1$ 次元の部分空間の中の正規分布である。長さの 2 乗は定義により $\chi^2_{k-1}(\lvert\mu\rvert^2)$ に従う。固定の $q$ については大数の法則で $N_i/n\to q_i$ である。$\square$
固定の $q$ で必要な標本の大きさの見積もりには、$\lambda=nw^2$ として $\chi^2_{k-1}(\lambda)$ を使う。
計算の手順
- 区分を決める。 データを見る前に決める。各試行が 1 つの区分にだけ入るようにする。
- 母数を推定する。 区分の度数の尤度を最大にする $\hat\theta$ を求める。
- 期待度数を計算する。 $E_i=np_i(\hat\theta)$。小さいものがあれば、区分をまとめるか、正確な計算(Fisherの正確検定 など)に替える。
- 統計量を計算する。 $X^2=\sum_i(N_i-E_i)^2/E_i$。度数で計算し、割合で計算しない。
- 自由度を数える。 $\nu=$ 区分の数 $-1-$ 推定した母数の数。
- 判定する。 $X^2$ が $\chi^2_\nu$ の上側 $\alpha$ 点を超えれば棄却する。棄却したら、各区分の $(N_i-E_i)/\sqrt{E_i}$ を見てどこがずれたかを調べる。
期待度数の目安には、$E_i\ge1$ を求めるもの(ER10 p. 491)や、自由度 $2$ 以上の分割表で、$E_i< 5$ の区分が $5$ つに $1$ つ程度までなら最小 $1$ まで許すもの(Coc54)がある。どれも経験則で定理ではない。
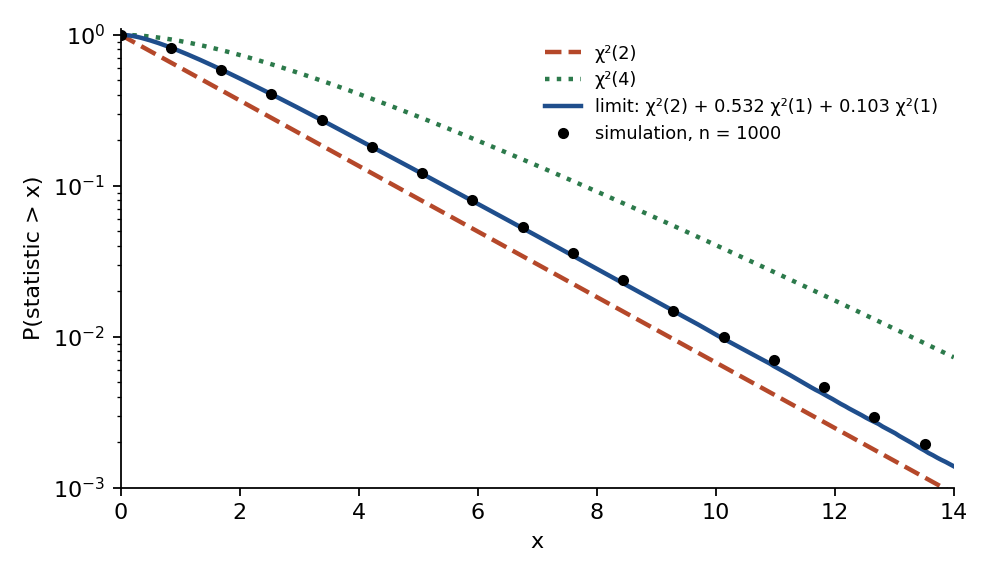 図: 区分のデータから推定するか生のデータから推定するかで異なる上側確率を比べた対数軸のグラフ。正規分布の平均と分散を推定し 5 区分で検定する場合で、横軸は棄却の閾値、縦軸は上側確率。自由度 2 と自由度 4 のカイ二乗分布の曲線の間に、生のデータで推定したときの極限の曲線と n=1000 の模擬の点が乗る。
例題
4 つの型の度数 $315,108,101,32$($n=556$)が、比 $9:3:3:1$ に合うかを調べる。
使う公式:確率が既知の場合(自由度 $k-1$)。
答え:$E=(312.75,104.25,104.25,34.75)$、$X^2=0.4700$、$G^2=0.4754$、自由度 $3$ で $p$ 値 $0.9254$。棄却しない。
遺伝子型の度数 $233,385,129$($n=747$)が、$(\theta^2,2\theta(1-\theta),(1-\theta)^2)$ に合うかを調べる。
使う公式:thm-chi-composite($k=3$、$s=1$)。
答え:$\hat\theta=(2n_1+n_2)/(2n)=0.56961$、$E=(242.37,366.26,138.37)$、$X^2=1.9555$、自由度 $1$ で $p$ 値 $0.1620$。自由度を誤って $2$ とすると $0.3762$ になる。
途中の計算を開く
対数尤度は定数を除いて $(2n_1+n_2)\log\theta+(n_2+2n_3)\log(1-\theta)$ で、これが $\hat\theta$ を与える。代入を整理すると $X^2=n(4n_1n_3-n_2^2)^2/\bigl((2n_1+n_2)^2(2n_3+n_2)^2\bigr)$ である。$\theta=0.4$、$n=500$ の模擬($40$ 万回)で、名目 $5\%$ の棄却率は自由度 $1$ で $0.0507$、自由度 $2$ で $0.0144$ である。
0, 1, 2, 3, 4 件の度数が $109,65,22,3,1$($n=200$)のデータを、区分 $\{0\},\{1\},\{2\text{ 以上}\}$ の度数 $109,65,26$ で Poisson 分布と比べる。
使う公式:thm-chi-composite、thm-chi-cl。
答え:
| 推定 | $\lambda$ の値 | 期待度数 | $X^2$ | 自由度 $1$ の $p$ 値 |
|---|---|---|---|---|
| 区分の度数の最尤 | $0.61446$ | $108.19,66.48,25.34$ | $0.0562$ | $0.8125$ |
| 生のデータの最尤(標本平均) | $0.61$ | $108.67,66.29,25.04$ | $0.0628$ | $0.8021$ |
$\lambda=0.61$ で $\mathcal I=1/\lambda=1.6393$、$A^{\top}A=1.5562$、$\mu=0.9493$ なので、生の最尤の極限は $\chi^2_1+0.0507\chi^2_1$ で、自由度 $1$ の棄却点を使ったときの大きさは $0.0516$ である。この例ではほとんど情報が失われず、差は小さい。
正規分布の平均と分散を生のデータの最尤で推定し、$N(0,1)$ の $5$ 等確率の固定の区分で検定する(真の分布は $N(0,1)$)。
使う公式:thm-chi-cl($k=5$、$s=2$)。
答え:$\mu_1=0.46826$、$\mu_2=0.89696$ で、極限は $\chi^2_2+0.53174\chi^2_1+0.10304\chi^2_1$、平均 $2.6348$ である。
| 使う棄却点 | 極限での大きさ | 模擬 $n=100$ | 模擬 $n=1000$ |
|---|---|---|---|
| $\chi^2_2$ の $5\%$ 点 $5.991$ | $0.0763$ | $0.0773$ | $0.0761$ |
| $\chi^2_4$ の $5\%$ 点 $9.488$ | $0.0134$ | $0.0126$ | $0.0126$ |
自由度を $2$ とすると棄却しすぎ、$4$ とすると棄却しなさすぎる。模擬は各 $4$ 万回である。
$p_0=(\frac14,\frac14,\frac14,\frac14)$、$q=(0.35,0.25,0.2,0.2)$、水準 $5\%$(棄却点 $7.8147$)とする。
使う公式:thm-chi-power。
答え:$w^2=0.06$。$n=200$ で $\lambda=12$、$\chi^2_3(12)$ による検出力の近似は $0.8402$(多項分布の正確な和では $0.8218$)。検出力 $80\%$ に要する $\lambda$ は $10.9026$ なので $n\approx182$(正確な検出力は $0.7807$)。この例では近似が正確な値より少し高いので、余裕をもたせる。
正規標本 $n=20$、$s^2=2$ で $\sigma_0^2=1$ を調べる。
使う公式:def-chi-variance。
答え:$T=19\times2=38$。$\chi^2_{19}$ の両側 $5\%$ の棄却点 $8.9065$、$32.8523$ の外にあり棄却する。両側の $p$ 値は $0.01187$ である。
使える条件と反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| (a) | 正規分布の 2 母数を生のデータで推定し 5 区分(ex-chi-normal) | 極限が $\chi^2_2$ でない。自由度 $2$ の棄却点で大きさ $0.0763$ |
| (b) | $q=\theta_1+\theta_2$ として $p=(q^2,q(1-q),q(1-q),(1-q)^2)$($k=4$、母数 2 個) | $A$ の階数が $1$ で、自由度は見かけの $1$ でなく $2$。$\chi^2_1$ の棄却点で大きさ $0.1465$ |
| (c) | $p=(\theta,\frac{1-\theta}2,\frac{1-\theta}2)$、$\theta\le\frac13$、真の値 $\theta_0=\frac13$ | 極限が $\frac12\chi^2_1+\frac12\chi^2_2$ の混合。$\chi^2_1$ の棄却点で大きさ $0.0983$ |
| (d) | 同じ観測を 2 度数える($k=4$、$p_i=\frac14$) | $X^2$ が 2 倍になり、大きさ $P(\chi^2_3>3.907)=0.2716$ |
| (e) | $k=2$、$p=(0.99,0.01)$、$n=10$ | $N_2\ge1$ で棄却となり、$\chi^2_1$ の棄却点の正確な大きさは $0.0956$ |
| (f) | Laplace 分布(尖度 $\kappa=6$)で分散の検定 | 大きさの極限が $0.2151$(名目 $5\%$) |
確かめを開く
(b):$p$ は $q$ だけによるので $\operatorname{Im}A$ は 1 次元で、$q$ を母数とする族に thm-chi-composite を使うと自由度は $k-1-1=2$ である。$P(\chi^2_2>3.841)=e^{-1.9207}=0.1465$(模擬 $0.1482$)。
(c):$\theta_0$ が端点なので、$h_n$ は片側に切れる。確率 $\frac12$ で $\hat\theta=\theta_0$(極限 $\chi^2_2$)、確率 $\frac12$ で内部の最大点(極限 $\chi^2_1$)となる。$\frac12P(\chi^2_1>3.841)+\frac12P(\chi^2_2>3.841)=0.0983$(模擬 $0.0977$)。
(d):度数が全部 2 倍のとき、$n$ も 2 倍とみなすと $X^2$ は 2 倍になる。$P(2\chi^2_3>7.815)=0.2716$。
(e):$N_2=1$ なら $X^2=(1-0.1)^2/(10\cdot0.01\cdot0.99)=8.18$ で棄却し、$N_2=0$ なら $X^2\approx0.10$ で棄却しないので、大きさは $1-0.99^{10}$ である。$n=30$ で $0.0361$、$n=100$ で $0.0794$($N_2\ge3$ で棄却)、$n=500$ で $0.0377$、$n=1000$ で $0.0365$ で、離散性のために単調でない。
(f):$\sqrt n(S^2-\sigma^2)$ は $N(0,(\kappa-1)\sigma^4)$ に分布収束する。$\chi^2_{n-1}$ の分位点は $n\pm1.96\sqrt{2n}$ に近いので、大きさの極限は $2\bigl(1-\Phi(1.96\sqrt{2/(\kappa-1)})\bigr)$ で、$\kappa=3$ で $0.05$、$\kappa=6$ で $0.2151$(模擬 $n=2000$ で $0.2150$)、一様分布 $\kappa=1.8$ で $0.0019$(模擬 $0.0022$)である。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 推定した母数を引かない | $k-1-s$ | thm-chi-composite、ex-chi-hw |
| 生のデータの平均と分散を入れて $k-1-s$ とする | 極限は一般にカイ二乗分布でない。区分の度数で推定するか、棄却点を補正する | thm-chi-cl |
| 割合や百分率で計算する | 度数で計算する。$X^2$ は $n$ に比例する | thm-chi-power |
| 1 人が複数回答した度数をそのまま使う | 各試行が 1 区分だけに入る表にする | 条件 (d) |
| 区分をデータを見て決める | 事前に決める。結果を見て分けると有意水準を保証できない | 定理の区分は固定 |
| 棄却されなかったので仮説が正しいとする | 証拠が足りないだけのことがある | ex-chi-power、統計的仮説検定 |
| $n$ が大きく有意なら差が大きいとする | $w^2$ で効果の大きさを見る | thm-chi-power |
| 表を集計してから独立性を見る | 層で向きが逆転することがある | Simpsonのパラドックス |
補足
連続分布の適合度。 区分に分けずに分布関数全体を比べる方法が Kolmogorov–Smirnov検定 である。カイ二乗検定は区分の取り方に依存する代わりに、離散データにそのまま使える。標準書。 検定全般の理論は LR05、スコア統計量との関係を含む漸近論は vdV98 で扱われている。区分の数。 $k$ を大きくすると各区分の情報は減るが検出できる対立は細かくなる。$k$ が $n$ とともに増える場合はこの記事の定理の範囲外である。
関連項目
- 前提: カイ二乗分布, 多項分布, Wald検定
- 比較: 尤度比検定, Kolmogorov–Smirnov検定, Fisherの正確検定
- 発展: 分割表, 統計的仮説検定
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

