ジャックナイフ法
概要
ジャックナイフ法(jackknife)とは、独立同分布の標本から 1 個ずつ抜いて推定量を計算し直し、その $n$ 個の値から偏りと分散を推定する方法である。偏りが $a/n+b/n^2+O(n^{-3})$ の形なら補正後の偏りは $O(n^{-2})$ になる。分散の推定は Efron–Stein の不等式により $n-1$ 個の推定量の分散を上から抑え、2 次の積率が有限で標本平均の $C^1$ 級の関数なら一致する。中央値では一致しない。
推定量の偏りや標準誤差は、公式が分からないことが多い。ジャックナイフ法 は、データを 1 個ずつ抜いて同じ推定量を計算し直し、その $n$ 個の値のばらつきから偏りと分散を推定する。標本分散を $n$ で割った推定量にこの補正を当てると、不偏分散がちょうど出てくる。乱数を使わず、推定量を $n$ 回計算するだけで済む。
偏りの補正は M. H. Quenouille が(Que56)、分散の推定は J. W. Tukey が(Tuk58)提案した。この記事では、推定量の偏りが $1/n$ の展開をもつときに主要項が消えること、$n-1$ 個の標本の推定量の分散を上から抑えること(Efron–Stein の不等式)、標本平均の滑らかな関数で分散の推定が一致することを証明する。逆に、中央値では分散の推定が一致しないことも証明する。この記事の中心は、この方法が通用する場合と通用しない場合の境目である。
定義と使える条件
$X_1,\dots,X_n$ を独立同分布、$\hat\theta_n=t_n(X_1,\dots,X_n)$ を実数の値をとる推定量とし、$t_n$ は引数の並べ替えで値を変えないとする。$\theta$ を推定したい量とする。
$X_i$ を除いた $n-1$ 個で計算した値を $\hat\theta_{(i)}:=t_{n-1}(X_1,\dots,X_{i-1},X_{i+1},\dots,X_n)$、その平均を $\bar\theta_{(\cdot)}:=\frac1n\sum_i\hat\theta_{(i)}$ とする。次を定める。
- 偏りのジャックナイフ推定:$\hat b_J:=(n-1)(\bar\theta_{(\cdot)}-\hat\theta_n)$。
- ジャックナイフ推定量:$\tilde\theta_J:=\hat\theta_n-\hat b_J=n\hat\theta_n-(n-1)\bar\theta_{(\cdot)}$。
- 擬似値:$P_i:=n\hat\theta_n-(n-1)\hat\theta_{(i)}$。
- 分散のジャックナイフ推定:$v_J:=\dfrac{n-1}n\sum_{i=1}^n\bigl(\hat\theta_{(i)}-\bar\theta_{(\cdot)}\bigr)^2$。
擬似値の標本平均が $\tilde\theta_J$ で、$\frac1{n(n-1)}\sum_i(P_i-\tilde\theta_J)^2=v_J$ である。つまり $P_1,\dots,P_n$ を独立な観測値のように扱うと、平均が補正した推定量、「分散 $/n$」が $v_J$ になる。これが「擬似値」の名の由来である。
係数 $n-1$ は、次の計算から来る。$\mathrm E\hat\theta_m=\theta+a/m+\cdots$ なら $\bar\theta_{(\cdot)}-\hat\theta_n$ の期待値は $a(\frac1{n-1}-\frac1n)=\frac a{n(n-1)}$ に近いので、$n-1$ 倍すると偏りの主要項 $a/n$ になる。$v_J$ の係数 $\frac{n-1}n$ は、$\hat\theta_{(i)}$ どうしのずれが小さいことを補う。$\hat\theta_{(i)}$ は $n-1$ 個を共有するので、標本平均では $\hat\theta_{(i)}-\bar\theta_{(\cdot)}=(\bar X-X_i)/(n-1)$ と、ふつうの標本の $1/(n-1)$ の大きさしかない。
使える条件は次のとおりである。
- (i) 独立同分布:$X_i$ は独立で同じ分布に従う。
- (ii) 偏りの展開(偏りの補正に使う):$\mathrm E\hat\theta_m=\theta+a/m+b/m^2+O(m^{-3})$。
- (iii) 滑らかさ(分散の推定に使う):$\hat\theta_n=g(\bar X_n)$、$g$ は平均の近くで $C^1$ 級。
- (iv) 2 次の積率:$\mathrm E\lvert X_1\rvert^2< \infty$。
公式の表
| 量 | 式 | 使える条件 | 根拠 |
|---|---|---|---|
| 標本平均 | $\tilde\theta_J=\bar X$、$v_J=s^2/n$($s^2$ は不偏分散) | $n\ge2$ | prop-jk-mean |
| $\frac1n\sum(X_i-\bar X)^2$ | $\tilde\theta_J=s^2$ | $n\ge2$ | thm-jk-vstat |
| 2 次の V 統計量 | $\tilde\theta_J$ は U 統計量で不偏 | $n\ge2$、$h$ が対称で有限な期待値 | thm-jk-vstat |
| 補正後の偏り | $\mathrm E\tilde\theta_J-\theta=O(n^{-2})$($a/n$ の項が消える) | (i)(ii) | thm-jk-bias |
| 分散の上界 | $\mathrm E\sum_i(\hat\theta_{(i)}-\bar\theta_{(\cdot)})^2\ge\operatorname{Var}\hat\theta_{n-1}$ | (i)、$\hat\theta_{n-1}$ の 2 次の積率が有限 | thm-jk-efron-stein |
| 分散の一致性 | $nv_J\to\nabla g(\mu)^{\top}\Sigma\nabla g(\mu)$(確率 $1$) | (i)(iii)(iv) | thm-jk-consistency |
| 中央値($n=2m$) | $v_J=\frac{n-1}4(X_{(m+1)}-X_{(m)})^2$ | 順序統計量が定まる | thm-jk-median |
主定理
偏りの補正
$\hat\theta_n=\bar X_n$(各 $n$ で標本平均)のとき、$P_i=X_i$ である。したがって $\tilde\theta_J=\bar X_n$、$\hat b_J=0$、$v_J=\frac1{n(n-1)}\sum_i(X_i-\bar X_n)^2$ である。
$(n-1)\hat\theta_{(i)}=n\bar X_n-X_i$ なので $P_i=n\bar X_n-(n\bar X_n-X_i)=X_i$ である。残りは擬似値の平均と分散の式による。$\square$
(i) を仮定する。$\mathrm E\hat\theta_m$ が $m\ge m_0$ で $\theta+\frac am+\frac b{m^2}+R_m$、$\lvert R_m\rvert\le cm^{-3}$ と書けるとする。このとき $n>m_0$ で
$$
\mathrm E\tilde\theta_J=\theta-\frac b{n(n-1)}+nR_n-(n-1)R_{n-1}
$$
であり、とくに $\mathrm E\tilde\theta_J-\theta=O(n^{-2})$ である。
(i) から各 $\hat\theta_{(i)}$ は $n-1$ 個の独立同分布の標本の推定量なので、$\mathrm E\bar\theta_{(\cdot)}=\mathrm E\hat\theta_{n-1}$ である。よって $\mathrm E\tilde\theta_J=n\mathrm E\hat\theta_n-(n-1)\mathrm E\hat\theta_{n-1}$ で、展開を代入すると、$\theta$ の係数は $n-(n-1)=1$、$a$ の係数は $1-1=0$、$b$ の係数は $\frac1n-\frac1{n-1}=-\frac1{n(n-1)}$ である。残りは $nR_n-(n-1)R_{n-1}=O(n^{-2})$ である。$\square$
定数 $\theta$ の項も $a/n$ の項も、$n\mathrm E\hat\theta_n-(n-1)\mathrm E\hat\theta_{n-1}$ という差で処理されている。これは数列の極限を速めるのと同じ操作なので、偏りの形が $1/n$ の展開でないと働かない(ex-jk-table の絶対値の行)。
$n\ge2$、$h$ を対称な可測関数とし、$\mathrm E\lvert h(X_1,X_2)\rvert$、$\mathrm E\lvert h(X_1,X_1)\rvert$ が有限とする。$\hat\theta_n:=\frac1{n^2}\sum_{i,j}h(X_i,X_j)$ のとき
$$
\tilde\theta_J=\frac1{n(n-1)}\sum_{i\ne j}h(X_i,X_j)
$$
である。とくに $\tilde\theta_J$ は $\theta=\mathrm Eh(X_1,X_2)$ の不偏推定量である。
$S:=\sum_{i\ne j}h(X_i,X_j)$、$D:=\sum_ih(X_i,X_i)$ とおく。$X_k$ を除くと、非対角の和から $2\sum_{j\ne k}h(X_k,X_j)$ が、対角の和から $h(X_k,X_k)$ が消えるので
$$
(n-1)^2\hat\theta_{(k)}=S-2\sum_{j\ne k}h(X_k,X_j)+D-h(X_k,X_k)
$$
である。$k$ について平均すると $(n-1)^2\bar\theta_{(\cdot)}=\frac{n-2}nS+\frac{n-1}nD$ である。よって
$$
\tilde\theta_J=\frac{S+D}n-\frac1{n-1}\Bigl(\frac{n-2}nS+\frac{n-1}nD\Bigr)=\frac Sn\Bigl(1-\frac{n-2}{n-1}\Bigr)=\frac S{n(n-1)}
$$
である。不偏性は $\mathrm Eh(X_i,X_j)=\theta$($i\ne j$)による。$\square$
$h(x,y)=\frac12(x-y)^2$ なら $\hat\theta_n=\frac1n\sum(X_i-\bar X)^2$、$\tilde\theta_J=s^2$ である。
分散の推定は保守的である
次の不等式は Efron と Stein による(ES81)。前半の一般の形を、分散を差分の和に分けて示し、それをジャックナイフの和と比べる。
$Z=t(X_1,\dots,X_m)$ を独立な確率変数の関数で $\mathrm EZ^2< \infty$ とし、$X_j'$ を $X_j$ の独立な写し、$Z^{[j]}$ を $X_j$ を $X_j'$ に替えた値とする。このとき
$$
\operatorname{Var}Z\le\frac12\sum_{j=1}^m\mathrm E\bigl(Z-Z^{[j]}\bigr)^2
$$
である。さらに $X_1,\dots,X_n$($n=m+1$)が独立同分布で $t$ が対称なら、$\hat\theta_{(i)}$ を $Z$ の形の値として
$$
\operatorname{Var}\hat\theta_{n-1}\le\mathrm E\sum_{i=1}^n\bigl(\hat\theta_{(i)}-\bar\theta_{(\cdot)}\bigr)^2=\frac n{n-1}\mathrm Ev_J
$$
である。
$\mathcal F_j:=\sigma(X_1,\dots,X_j)$、$D_j:=\mathrm E[Z\mid\mathcal F_j]-\mathrm E[Z\mid\mathcal F_{j-1}]$ とすると、$Z-\mathrm EZ=\sum_jD_j$ で、異なる $j$ の $D_j$ は直交するので $\operatorname{Var}Z=\sum_j\mathrm ED_j^2$ である。$\mathrm E^{(j)}$ を $X_j$ だけについての積分とすると、独立性から $\mathrm E[Z\mid\mathcal F_{j-1}]=\mathrm E[\mathrm E^{(j)}Z\mid\mathcal F_j]$ なので、$D_j=\mathrm E[Z-\mathrm E^{(j)}Z\mid\mathcal F_j]$ である。Jensen の不等式から $\mathrm ED_j^2\le\mathrm E(Z-\mathrm E^{(j)}Z)^2$ である。右辺は $X_j$ についての条件付き分散の期待値で、同じ分布の独立な 2 点の差の 2 乗の半分に等しいので、$\frac12\mathrm E(Z-Z^{[j]})^2$ である。
後半。$m=n-1$、$Z:=\hat\theta_{(n)}=t(X_1,\dots,X_{n-1})$ とする。$X_n$ を $X_j$ の写しと見ると、$t$ の対称性から $Z^{[j]}$ は $\hat\theta_{(j)}$ と同じ値である。交換可能性から $\mathrm E(\hat\theta_{(i)}-\hat\theta_{(k)})^2$ は $i\ne k$ によらないので、これを $\Delta$ と書くと、前半は $\operatorname{Var}Z\le\frac{n-1}2\Delta$ である。一方、$n$ 個の数の分散の恒等式
$$
\sum_i(\hat\theta_{(i)}-\bar\theta_{(\cdot)})^2=\frac1{2n}\sum_{i,k}(\hat\theta_{(i)}-\hat\theta_{(k)})^2
$$
の期待値は $\frac1{2n}n(n-1)\Delta=\frac{n-1}2\Delta$ である。両者を比べて主張を得る。$\square$
$v_J$ は $\hat\theta_n$ の分散の推定である。$\operatorname{Var}\hat\theta_n$ が $\frac{n-1}n\operatorname{Var}\hat\theta_{n-1}$ に近いなら、定理は $v_J$ が平均的に過大になることを述べている。ただしこの定理は上界であって、一致性は言っていない。中央値のように、比の極限の分布の平均が $2$ のこともある(thm-jk-median)。
滑らかな統計量での一致性
$X_1,X_2,\dots$ を $\mathbb{R}^p$ の値の独立同分布、$\mathrm E\lvert X_1\rvert^2< \infty$、$\mu:=\mathrm EX_1$、$\Sigma:=\operatorname{Cov}X_1$ とし、$g$ を $\mu$ の近傍で定義された $C^1$ 級の実数値関数、$\hat\theta_n:=g(\bar X_n)$ とする。このとき確率 $1$ で、十分大きい $n$ について $\hat\theta_n$ と $\hat\theta_{(i)}$ がすべて定義され、
$$
nv_J\longrightarrow\sigma_g^2:=\nabla g(\mu)^{\top}\Sigma\,\nabla g(\mu)
$$
である。$\sigma_g^2$ は $\sqrt n(\hat\theta_n-g(\mu))$ の極限の正規分布 $N(0,\sigma_g^2)$ の分散である。
段 1。 $\delta_i:=\bar X_{(i)}-\bar X_n=(\bar X_n-X_i)/(n-1)$ である($\bar X_{(i)}$ は $X_i$ を除いた平均)。ブートストラップ法 の補題「最大の項は $\sqrt n$ より小さい」を各座標に使うと、確率 $1$ で $\max_{i\le n}\lvert X_i\rvert/\sqrt n\to0$ である。大数の強法則 とあわせて、確率 $1$ で $\bar X_n\to\mu$、$\max_i\lvert\delta_i\rvert\to0$ である。また $\frac1{n-1}\sum_i(X_i-\bar X_n)(X_i-\bar X_n)^{\top}\to\Sigma$ である。以下、これらが成り立つ標本の列を固定する。$n$ が大きければ $\bar X_n$ と $\bar X_{(i)}$ はすべて、$g$ が $C^1$ 級である凸な近傍に入る。
段 2。 平均値の定理から、$c_i:=g(\bar X_{(i)})-g(\bar X_n)=\nabla g(\xi_i)\cdot\delta_i$ となる $\xi_i$($\bar X_n$ と $\bar X_{(i)}$ を結ぶ線分上)がある。$a_i:=\nabla g(\mu)\cdot\delta_i$、$b_i:=c_i-a_i$ とする。$\xi_i\to\mu$ は $i$ について一様なので、$\eta_n:=\max_i\lvert\nabla g(\xi_i)-\nabla g(\mu)\rvert\to0$ である。
段 3。 $nv_J=(n-1)\sum_i(c_i-\bar c)^2$ である($\hat\theta_n$ を引いても差は変わらない)。$\sum_i\delta_i=0$ なので $\bar a=0$ で、
$$
(n-1)\sum_ia_i^2=\frac1{n-1}\sum_i\bigl(\nabla g(\mu)\cdot(X_i-\bar X_n)\bigr)^2\longrightarrow\sigma_g^2
$$
である。また
$$
(n-1)\sum_ib_i^2\le\eta_n^2(n-1)\sum_i\lvert\delta_i\rvert^2=\eta_n^2\frac1{n-1}\sum_i\lvert X_i-\bar X_n\rvert^2\longrightarrow0
$$
である。$\mathbb{R}^n$ の Euclid ノルムの三角不等式と、平均を引くことがノルムを増やさないことから、$\sqrt{(n-1)\sum(c_i-\bar c)^2}$ と $\sqrt{(n-1)\sum a_i^2}$ の差は $\sqrt{(n-1)\sum b_i^2}$ 以下である。よって $nv_J\to\sigma_g^2$ である。
段 4。 平均値の定理と $\mathbb{R}^p$ の 中心極限定理 から、$\sqrt n(g(\bar X_n)-g(\mu))=\nabla g(\zeta_n)\cdot\sqrt n(\bar X_n-\mu)$ は $N(0,\sigma_g^2)$ に分布収束する($\zeta_n\to\mu$ と Slutsky の定理、確率変数の収束)。$\square$
$\sigma_g^2>0$ なら、$\hat\theta_n\pm z_{\alpha/2}\sqrt{v_J}$ は漸近的に水準 $1-\alpha$ の信頼区間である。定理は $\nabla g$ の連続性だけを使い、$g$ の式も $\Sigma$ の推定も要らない。
中央値では一致しない
$X_i$ を独立同分布とし、分布関数 $F$ は $F(q)=\frac12$ となる $q$ の近傍で連続な正の密度 $f$ をもつとする。$n=2m$、$\hat\theta_n=\frac12(X_{(m)}+X_{(m+1)})$ とし、奇数の個数の中央値は中央の順序統計量とする。このとき
$$
v_J=\frac{n-1}4\bigl(X_{(m+1)}-X_{(m)}\bigr)^2
$$
であり、$E$ を平均 $1$ の指数分布に従う確率変数として、
$$
4f(q)^2\,nv_J\longrightarrow E^2\qquad(\text{分布収束})
$$
である。$\sqrt n(\hat\theta_n-q)$ の極限の分散は $\frac1{4f(q)^2}$(M推定量 の系「代表的な推定量の漸近分散」)なので、$nv_J$ はこの分散に確率収束しない。比の極限 $E^2$ は平均 $2$ の分布である。
$X_i$ が下から $m$ 番目以内なら、残り $2m-1$ 個の中央の値(下から $m$ 番目)は $X_{(m+1)}$ である。上から $m$ 番目以内なら $X_{(m)}$ である。$D:=X_{(m+1)}-X_{(m)}$ とすると、$\hat\theta_{(i)}$ は 2 つの値を $m$ 回ずつとるので、$\bar\theta_{(\cdot)}$ からのずれはすべて $\pm D/2$ で、$v_J=\frac{n-1}n\cdot n\cdot\frac{D^2}4$ である。
$U_i$ を $(0,1)$ の一様乱数とし、$Q$ を $F$ の分位点関数とすると、$X_i=Q(U_i)$ と同じ分布である。一様な順序統計量の隣り合う間隔は $D_U:=U_{(m+1)}-U_{(m)}\sim\mathrm{Beta}(1,n)$ に従うので、$\Pr(nD_U>t)=(1-t/n)^n\to e^{-t}$、すなわち $nD_U\to E$ である。$U_{(m)},U_{(m+1)}\to\frac12$(確率収束)で、$Q$ は $\frac12$ の近傍で $C^1$ 級、$Q'(\frac12)=1/f(q)$ なので、平均値の定理から $D=Q'(\zeta_n)D_U$($\zeta_n\to\frac12$)である。Slutsky の定理から $nf(q)D\to E$ である。$4f(q)^2nv_J=\frac{n-1}n(nf(q)D)^2$ なので主張を得る。$\mathrm EE^2=2$ である。極限が定数でないので、確率収束しない。$\square$
分散の推定が一致しない原因は、$X_i$ を 1 個抜いても中央値がほとんど動かないことにある。$\hat\theta_{(i)}$ が見ているのは中央の隣り合う 2 点の間隔 1 個だけで、$n$ 個の値のばらつきの情報が使われていない。平均のように、抜いた点の値に滑らかに反応する統計量なら、$n$ 個の変化から分布全体が見える。
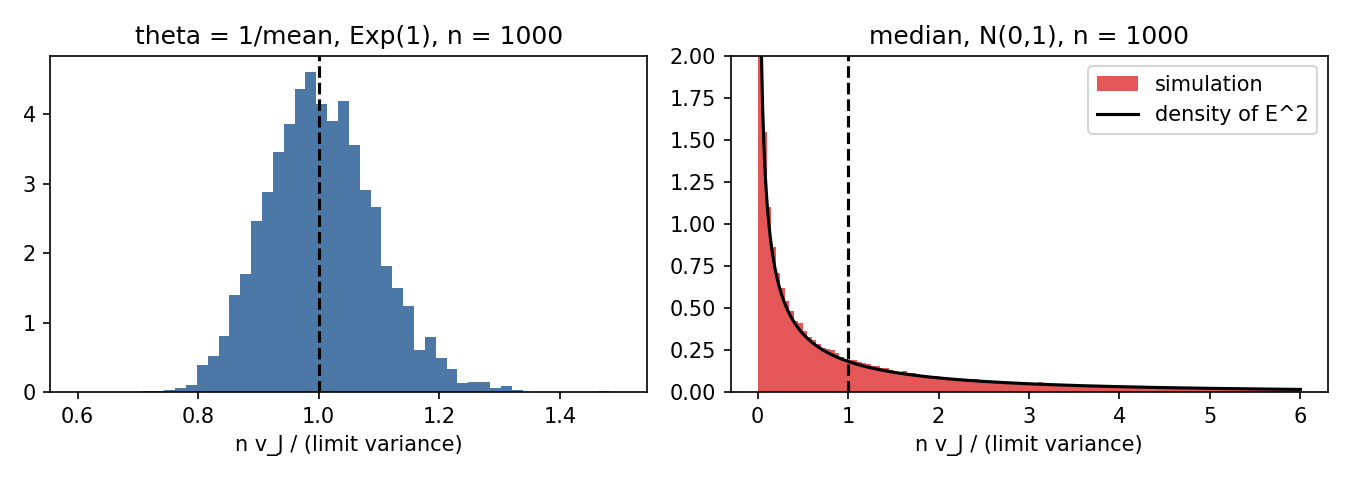 図: 左は指数分布の標本平均の逆数で、n=1000 のときの n v_J を極限の分散で割った値の度数分布。1 の周りに集中する。右は標準正規分布の中央値で、同じ比の度数分布と E の 2 乗の密度を重ねたもの。1 に集中せず 0 の近くに高く裾が長い。
計算の手順
- データから $\hat\theta_n$ を計算する。
- $i=1,\dots,n$ について、$X_i$ を除いて $\hat\theta_{(i)}$ を計算する(推定量を $n$ 回計算する)。
- $\bar\theta_{(\cdot)}$、$\hat b_J$、$\tilde\theta_J$、$v_J$ を def-jk-main の式で求める。
- 分散の推定を使ってよいかを確かめる:統計量が標本平均の滑らかな関数のように振る舞うか。$\hat\theta_{(i)}$ の値が少数の点に集まっているなら(中央値、最大値)、$v_J$ を信用しない。
- 区間を作るなら、$\hat\theta_n\pm z_{\alpha/2}\sqrt{v_J}$ を使う。$\tilde\theta_J$ を中心にしてもよい。偏りの補正は分散を増やすことがあるので、$\lvert\hat b_J\rvert$ が $\sqrt{v_J}$ より十分小さいなら補正の必要は薄い。
例題
データ $(2,4,9)$ で、標本平均、標本分散 $\frac1n\sum(x_i-\bar x)^2$、平均の逆数の 3 つ。
使う公式:def-jk-main、prop-jk-mean、thm-jk-vstat。
答え:
| 統計量 | $\hat\theta$ | $\hat\theta_{(i)}$ | $\hat b_J$ | $\tilde\theta_J$ | $v_J$ |
|---|---|---|---|---|---|
| 標本平均 | $5$ | $6.5,\ 5.5,\ 3$ | $0$ | $5$ | $4.3333$ |
| 標本分散 | $8.6667$ | $6.25,\ 12.25,\ 1$ | $-4.3333$ | $13$ | $42.25$ |
| 平均の逆数 | $0.2$ | $0.15385,\ 0.18182,\ 0.33333$ | $0.04600$ | $0.15400$ | $0.012434$ |
標本分散の $\tilde\theta_J=13$ は不偏分散 $\frac12(9+1+16)$ に一致する。
途中の計算を開く
標本平均:$s^2=13$ なので $v_J=13/3$。標本分散:$(4,9)$ を残すと $6.25$ で、3 つの平均は $6.5$、$\hat b_J=2(6.5-\frac{26}3)=-\frac{13}3$。$v_J=\frac23\bigl(0.0625+33.0625+30.25\bigr)=42.25$。平均の逆数:$\bar\theta_{(\cdot)}=\frac{287}{1287}$ で、$\hat b_J=\frac{296}{6435}$、$\tilde\theta_J=\frac{991}{6435}$。
$X_i$ を率 $\lambda$ の指数分布の標本、$\hat\theta_n=1/\bar X_n$ とする。
使う公式:$n\bar X_n$ は Gamma 分布に従うので $\mathrm E\hat\theta_n=\frac{n\lambda}{n-1}$($n\ge2$)、$\operatorname{Var}\hat\theta_n=\frac{n^2\lambda^2}{(n-1)^2(n-2)}$($n\ge3$)。thm-jk-bias。
答え:$\mathrm E\tilde\theta_J-\lambda=-\frac{\lambda}{(n-1)(n-2)}$($n\ge3$)である。$\lambda=1$ で次のとおりである。後ろの 2 列は乱数の種 $20261107$、$20$ 万回の平均である。
| $n$ | $\hat\theta_n$ の偏り | $\tilde\theta_J$ の偏り | $\operatorname{Var}\hat\theta_n$ | $\mathrm Ev_J$ | $\mathrm E\sum(\hat\theta_{(i)}-\bar\theta_{(\cdot)})^2$ |
|---|---|---|---|---|---|
| $10$ | $0.11111$ | $-0.01389$ | $0.15432$ | $0.2027$ | $0.2252$ |
| $20$ | $0.05263$ | $-0.00292$ | $0.06156$ | $0.0692$ | $0.0728$ |
| $50$ | $0.02041$ | $-0.00043$ | $0.02169$ | $0.0226$ | $0.0231$ |
最後の列は $\operatorname{Var}\hat\theta_{n-1}$($n=10$ で $0.1808$)以上で、thm-jk-efron-stein のとおりである。
途中の計算を開く
$\mathrm E\tilde\theta_J=n\frac{n\lambda}{n-1}-(n-1)\frac{(n-1)\lambda}{n-2}=\lambda\frac{n^2(n-2)-(n-1)^3}{(n-1)(n-2)}=\lambda\frac{n^2-3n+1}{(n-1)(n-2)}$。分子は $(n-1)(n-2)-1$。偏りの展開は $\frac\lambda{n-1}=\frac\lambda n+\frac\lambda{n^2}+\cdots$ で、$a=b=\lambda$。
$y=(3,5,6,8,10,12)$、$z=(2,4,4,7,7,9)$ の対で、比 $R=\bar y/\bar z$ を推定する。$g(a,b)=a/b$ なので thm-jk-consistency の範囲にある。
答え:$\hat R=44/33=1.33333$、$\hat b_J=0.00283$、$\tilde\theta_J=1.33050$、$\sqrt{v_J}=0.05818$。
比較のために $\nabla g$ を手で計算する公式 $\frac1{n(n-1)\bar z^2}\sum(y_i-\hat Rz_i)^2$ の平方根は $0.05642$ で近い。公式を知らなくても、推定量を 6 回計算するだけで同じ大きさが得られる。
データ $(1,2,4,7,8,15)$ の中央値。
使う公式:thm-jk-median の前半。
答え:$\hat\theta=5.5$。$\hat\theta_{(i)}$ は $7,7,7,4,4,4$ で、$D=3$、$v_J=\frac54\cdot9=11.25$。標準正規分布の標本(乱数の種 $20261107$)で $4f(q)^2nv_J$ を調べると次のとおりで、$n$ を増やしても $1$ に集まらない。
| $n$ | 比の平均 | 比の中央値 | 比が $1$ 以下の確率 |
|---|---|---|---|
| $20$ | $1.770$ | $0.473$ | $0.638$ |
| $100$ | $1.967$ | $0.482$ | $0.632$ |
| $1000$ | $1.981$ | $0.477$ | $0.633$ |
| 極限 $E^2$ | $2$ | $(\log2)^2\approx0.4805$ | $1-e^{-1}\approx0.6321$ |
使える条件と反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| (ii) 偏りの展開 | $N(0,1)$ の標本、$\hat\theta_n=\lvert\bar X_n\rvert$、$\theta=0$ | 偏りは $c/\sqrt n$ の形で、補正しても $n\to\infty$ で半分になるだけ(thm-jk-bias の結論が成り立たない) |
| (iii) 滑らかさ | 中央値 | $nv_J$ が分散に収束しない(thm-jk-median) |
| (iii) 滑らかさ | $U(0,1)$ の標本、$\hat\theta_n=\max_iX_i$ | 偏りは $O(n^{-2})$ に減るが、$n^2v_J\to E^2$ で分散の推定は一致しない |
| (i) 独立性 | $X_i=Z_i+Z_{i+1}$($Z_i$ は独立な $N(0,1)$)の標本平均 | $nv_J\to2$ だが $n\operatorname{Var}\bar X_n\to4$ |
| (iv) 2 次の積率 | Cauchy 分布の標本の $\hat\theta_n=$ 標本平均 | $\bar X_n$ は $\theta$ に近づかず、$nv_J=s^2\to\infty$ |
確かめを開く
1 行目:$\sqrt n\bar X_n\sim N(0,1)$ から $\mathrm E\lvert\bar X_n\rvert=c/\sqrt n$、$c=\sqrt{2/\pi}$ で、$\mathrm E\tilde\theta_J=c(\sqrt n-\sqrt{n-1})=\frac c{\sqrt n+\sqrt{n-1}}$。$n$ が大きいと $\frac c{2\sqrt n}$ に近く、$n=10$ で $0.2523$ が $0.1295$ に減るだけである。$g(x)=\lvert x\rvert$ は $\mu=0$ で微分できない。
3 行目:$\hat\theta_{(i)}$ は $n-1$ 回 $X_{(n)}$、$1$ 回 $X_{(n-1)}$ をとる。$D=X_{(n)}-X_{(n-1)}$ として $\bar\theta_{(\cdot)}=X_{(n)}-D/n$、$\sum(\hat\theta_{(i)}-\bar\theta_{(\cdot)})^2=(n-1)\frac{D^2}{n^2}+\frac{(n-1)^2D^2}{n^2}=\frac{n-1}nD^2$ で、$v_J=(\frac{n-1}n)^2D^2$。$D\sim\mathrm{Beta}(1,n)$ から $nD\to E$。真の $n(1-X_{(n)})\to E$ の分散は $1$ なので、比の極限は $E^2$。偏りは、$m$ 個の最大値の期待値 $\frac m{m+1}$ から $\mathrm E\tilde\theta_J=\frac{n^2}{n+1}-\frac{(n-1)^2}n=1-\frac1{n(n+1)}$。
4 行目:prop-jk-mean から $nv_J=s^2$ で、$s^2\to\mathrm EX_1^2=2$(偶数番と奇数番に分けて大数の強法則)。$n\operatorname{Var}\bar X_n=4-\frac2n$(ブートストラップ法 の反例の表と同じ計算)。
5 行目:$\bar X_n$ は Cauchy 分布に従うので収束しない。$\frac1n\sum X_i^2\to\infty$(確率 $1$)で $\bar X_n^2/(\frac1n\sum X_i^2)$ は $0$ に確率収束するので、$s^2\to\infty$(確率収束)。$n=1000$ の $s^2$ の中央値は乱数の種 $20261107$ の $2000$ 回で約 $1485$ である。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| $v_J$ に $\frac1n$ や $\frac1{n-1}$ を掛ける | 係数は $\frac{n-1}n$ | $\hat\theta_{(i)}$ のずれは標本の $1/(n-1)$ の大きさ(prop-jk-mean) |
| $\tilde\theta_J$ はいつも不偏と考える | 主要項が消えるだけ | thm-jk-bias、ex-jk-exponential |
| どの統計量でも使えると考える | 中央値・最大値では $v_J$ が一致しない | thm-jk-median、反例の表 |
| 偏りの補正は無条件に良いと考える | $\frac1{n}$ の展開がないと効かず、分散が増えることもある | 反例の表の 1 行目 |
| 擬似値を独立な観測値だと信じる | 擬似値は同じデータから作られ、独立でない | 分散の公式は類推であって、定理は別に要る(thm-jk-consistency) |
補足
関連項目
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

