隠れMarkovモデル
概要
隠れMarkovモデル(hidden Markov model)とは、外から見えない状態の列が Markov 連鎖として移り、各時刻にその時刻の状態だけで分布の決まる観測が一つ出る確率モデルである。初期分布 $\pi$、推移行列 $A$、放出確率 $B$ で定まる。状態が $K$ 個、長さが $T$ のとき状態の列は $K^T$ 通りあるが、同時確率の積の形を使って和と最大化を時刻ごとに分配すると、観測の確率と各時刻の状態の事後確率は前向き・後ろ向きアルゴリズムで、最も確からしい状態の列は Viterbi アルゴリズムで、どちらも $O(TK^2)$ の手間で求まる。パラメータは Baum–Welch アルゴリズムで推定し、各反復で尤度は減らない。
隠れ Markov モデルは、外から見えない状態が Markov 連鎖として移り変わり、各時刻にその状態に応じた観測が一つ出る確率モデルである。さいころを時々こっそり取り替える賭場、話し言葉の音素と音声、遺伝子の領域と塩基の列などが典型で、観測の列から隠れた状態を推し量る。
状態の列は $K^T$ 通りあるので、素朴に足し上げると観測の確率すら計算できない。この記事の主題は、同時確率の積の形を使って和と最大化を時刻ごとに分配し、計算量を $O(TK^2)$ に落とす三つの手順――前向き・後ろ向きアルゴリズム(尤度と各時刻の状態の事後確率)、Viterbi アルゴリズム(最も確からしい状態の列)、Baum–Welch アルゴリズム(パラメータの推定)――である。
定義
状態は $\{1,\dots,K\}$、観測は有限集合 $\{1,\dots,M\}$ に値をとるとする(連続の観測でも $B_j(y)$ を密度に替えれば同じ議論が通る)。
隠れ Markov モデル(hidden Markov model、HMM)とは、確率変数の列 $Z_1,\dots,Z_T$(隠れ状態)と $Y_1,\dots,Y_T$(観測)で、同時確率が
$$
\Pr(Z_{1:T}=z_{1:T},\,Y_{1:T}=y_{1:T})=\pi_{z_1}B_{z_1}(y_1)\prod_{t=2}^{T}A_{z_{t-1}z_t}B_{z_t}(y_t)
$$
と書けるものをいう。ここで $z_{1:T}=(z_1,\dots,z_T)$ と略記し、パラメータ $\theta=(\pi,A,B)$ は
- 初期分布 $\pi_i=\Pr(Z_1=i)$($\pi_i\ge0$、$\sum_i\pi_i=1$)、
- 推移行列 $A_{ij}=\Pr(Z_{t+1}=j\mid Z_t=i)$(各行が確率ベクトルの 確率行列)、
- 放出確率 $B_j(m)=\Pr(Y_t=m\mid Z_t=j)$(各 $j$ で $m$ について確率ベクトル)
である。
$Y$ について和をとると、$Z$ は初期分布 $\pi$、推移行列 $A$ の Markov連鎖 である。また $Z_{1:T}$ を固定したとき $Y_1,\dots,Y_T$ は独立で、$Y_t$ の分布は $Z_t$ だけで決まる。この二つ(状態の Markov 性と観測の局所性)が以下の計算のすべての根拠であり、どちらかが満たされないと計算が成り立たない(反例の表)。
以下、観測の列 $y_{1:T}$ を固定し、$\theta$ のもとでの確率を $\Pr$ と書く。目標は次の三つの量である。
| 問題 | 求める量 | 素朴な計算 |
|---|---|---|
| 評価 | 尤度 $L(\theta)=\Pr(Y_{1:T}=y_{1:T})$ | $K^T$ 個の経路の和 |
| 平滑化 | $\gamma_t(j)=\Pr(Z_t=j\mid Y_{1:T}=y_{1:T})$ | 同上 |
| 復号 | $\Pr(Z_{1:T}=z_{1:T}\mid Y_{1:T}=y_{1:T})$ を最大にする $z_{1:T}$ | $K^T$ 個の経路の比較 |
主定理:前向き・後ろ向きアルゴリズム
$t=1,\dots,T$ と状態 $i,j$ について
$$
\alpha_t(j)=\Pr(Y_{1:t}=y_{1:t},\,Z_t=j),\qquad
\beta_t(i)=\sum_{z_{t+1},\dots,z_T}\ \prod_{s=t+1}^{T}A_{z_{s-1}z_s}B_{z_s}(y_s)\quad(z_t=i)
$$
と置く。$\beta_T(i)=1$(空の積)とする。$\Pr(Z_t=i)>0$ なら $\beta_t(i)=\Pr(Y_{t+1:T}=y_{t+1:T}\mid Z_t=i)$ である(thm-hmm-fb の証明の段 2)。
def-hmm の隠れ Markov モデルで、観測の列 $y_{1:T}$ を固定する。
- 前向き:$\alpha_1(j)=\pi_jB_j(y_1)$、$\displaystyle\alpha_{t+1}(j)=B_j(y_{t+1})\sum_{i=1}^{K}\alpha_t(i)A_{ij}$。
- 後ろ向き:$\beta_T(i)=1$、$\displaystyle\beta_t(i)=\sum_{j=1}^{K}A_{ij}B_j(y_{t+1})\beta_{t+1}(j)$。
- 尤度:どの $t$ でも $\displaystyle L(\theta)=\sum_{j}\alpha_t(j)\beta_t(j)$。特に $L(\theta)=\sum_j\alpha_T(j)$。
- 事後確率:$L(\theta)>0$ なら
$$ \gamma_t(j)=\frac{\alpha_t(j)\beta_t(j)}{L(\theta)},\qquad \xi_t(i,j):=\Pr(Z_t=i,Z_{t+1}=j\mid Y_{1:T}=y_{1:T})=\frac{\alpha_t(i)A_{ij}B_j(y_{t+1})\beta_{t+1}(j)}{L(\theta)}. $$
1・2 のどちらの漸化式も一段あたり $K^2$ 回の積で済むので、全体の計算量は $O(TK^2)$ である。
同時確率を $p(z_{1:T})$ と書く($y_{1:T}$ は固定)。def-hmm の積を時刻 $t$ で二つに分けると
$$
p(z_{1:T})=f_t(z_{1:t})\,g_t(z_{t:T}),\qquad
f_t(z_{1:t})=\pi_{z_1}B_{z_1}(y_1)\prod_{s=2}^{t}A_{z_{s-1}z_s}B_{z_s}(y_s),\quad
g_t(z_{t:T})=\prod_{s=t+1}^{T}A_{z_{s-1}z_s}B_{z_s}(y_s)
$$
となる。$f_t$ は $z_{1:t}$ だけ、$g_t$ は $z_{t:T}$ だけに依存し、共通の変数は $z_t$ だけである。
段 1(前向き変数の和の表示):$\Pr(Y_{1:t}=y_{1:t},Z_{1:t}=z_{1:t})$ は $p(z_{1:T})$ を $z_{t+1:T}$ と $y_{t+1:T}$ について足したものである。$y_{s}$($s>t$)についての和を後ろから順にとると、$\sum_{m}B_{z_s}(m)=1$、続いて $\sum_{z_s}A_{z_{s-1}z_s}=1$ で因子が一つずつ消えるので、これは $f_t(z_{1:t})$ に等しい。よって
$$
\alpha_t(j)=\sum_{z_{1:t-1}}f_t(z_{1:t-1},j).
$$
段 2(尤度の分解と $\beta$ の意味):$z_t=j$ を固定して $p$ を残りの変数で足すと、変数が分かれているので分配法則により
$$
\Pr(Y_{1:T}=y_{1:T},Z_t=j)=\sum_{z_{1:t-1}}\sum_{z_{t+1:T}}f_t(z_{1:t-1},j)\,g_t(j,z_{t+1:T})=\alpha_t(j)\beta_t(j).
$$
$j$ について足せば 3 が出る。この式を $\Pr(Y_{1:t}=y_{1:t},Z_t=j)=\alpha_t(j)$ と比べると、$\alpha_t(j)>0$ のとき $\beta_t(j)=\Pr(Y_{t+1:T}=y_{t+1:T}\mid Y_{1:t}=y_{1:t},Z_t=j)$ であり、$y_{1:t}$ についても足し上げれば($\beta_t(j)$ は $y_{1:t}$ によらない)$\Pr(Z_t=j)>0$ のとき $\beta_t(j)=\Pr(Y_{t+1:T}=y_{t+1:T}\mid Z_t=j)$ を得る。
段 3(漸化式):$f_{t+1}(z_{1:t+1})=f_t(z_{1:t})\,A_{z_tz_{t+1}}B_{z_{t+1}}(y_{t+1})$ なので、段 1 の表示で $z_{t+1}=j$ とし、$z_{1:t-1}$ についての和を先にとれば
$$
\alpha_{t+1}(j)=\sum_{i}\Bigl(\sum_{z_{1:t-1}}f_t(z_{1:t-1},i)\Bigr)A_{ij}B_j(y_{t+1})=B_j(y_{t+1})\sum_i\alpha_t(i)A_{ij}.
$$
同様に $g_t(i,z_{t+1:T})=A_{iz_{t+1}}B_{z_{t+1}}(y_{t+1})\,g_{t+1}(z_{t+1:T})$ から、$z_{t+2:T}$ の和を先にとって 2 を得る。$\alpha_1(j)=f_1(j)=\pi_jB_j(y_1)$。
段 4(事後確率):$\gamma_t$ は段 2 の式を $L(\theta)$ で割ったものである。$\xi_t$ は、$z_t=i,z_{t+1}=j$ を固定して残りを足すと、$p=f_t(z_{1:t-1},i)\,A_{ij}B_j(y_{t+1})\,g_{t+1}(j,z_{t+2:T})$ の三つの因子の変数が分かれているので、和は $\alpha_t(i)A_{ij}B_j(y_{t+1})\beta_{t+1}(j)$ になる。これを $L(\theta)$ で割る。
計算量:1 では各 $j$ について $K$ 項の和、これを $K$ 個の $j$ と $T-1$ 段で行うので $O(TK^2)$。2 も同じである。□
$\alpha_t(j)/\sum_k\alpha_t(k)=\Pr(Z_t=j\mid Y_{1:t}=y_{1:t})$ は時刻 $t$ までの観測だけによる推定で、フィルタと呼ぶ。$\gamma_t$(平滑化)はその後の観測も使う。Kalmanフィルタ は状態と観測が連続で線形・正規の場合の同じ計算である。
尺度化
$\alpha_t(j)$ は $t$ について指数的に小さくなり、数百段で浮動小数点の範囲を下回る。そこで各段で和が $1$ になるよう割る。
$L(\theta)>0$ とする。$\hat\alpha_1(j)=\pi_jB_j(y_1)/c_1$、$\hat\alpha_{t+1}(j)=B_j(y_{t+1})\sum_i\hat\alpha_t(i)A_{ij}/c_{t+1}$ で、$c_t$ を $\sum_j\hat\alpha_t(j)=1$ となる正規化の定数とする。このとき
$$
c_t=\Pr(Y_t=y_t\mid Y_{1:t-1}=y_{1:t-1}),\qquad \hat\alpha_t(j)=\Pr(Z_t=j\mid Y_{1:t}=y_{1:t}),\qquad \log L(\theta)=\sum_{t=1}^{T}\log c_t.
$$
証明を開く
帰納法で $\hat\alpha_t(j)=\alpha_t(j)/(c_1\cdots c_t)$ を示す。$t=1$ は定義そのもの。$t$ で成り立てば、thm-hmm-fb の 1 の右辺に代入して $\hat\alpha_{t+1}(j)=\alpha_{t+1}(j)/(c_1\cdots c_{t+1})$。$j$ について足すと $c_1\cdots c_t=\sum_j\alpha_t(j)=\Pr(Y_{1:t}=y_{1:t})$ なので、$c_t$ はその比 $\Pr(Y_{1:t}=y_{1:t})/\Pr(Y_{1:t-1}=y_{1:t-1})$ で、$\hat\alpha_t$ はフィルタである。$t=T$ で積の対数をとる。後ろ向きも $\hat\beta_t=\beta_t/(c_{t+1}\cdots c_T)$ と置けば $\gamma_t(j)=\hat\alpha_t(j)\hat\beta_t(j)$ となる。□
Viterbi アルゴリズム
$\delta_t(j)=\max_{z_{1:t-1}}\Pr(Z_{1:t-1}=z_{1:t-1},Z_t=j,Y_{1:t}=y_{1:t})$ と置く。
- $\delta_1(j)=\pi_jB_j(y_1)$、$\displaystyle\delta_{t+1}(j)=B_j(y_{t+1})\max_i\delta_t(i)A_{ij}$。
- 各 $t\ge2$、$j$ について $\psi_t(j)$ を $\delta_{t-1}(i)A_{ij}$ を最大にする $i$ の一つとする。$z_T^\star$ を $\delta_T(j)$ を最大にする $j$ とし、$z_{t-1}^\star=\psi_t(z_t^\star)$ と後ろへたどると、$z_{1:T}^\star$ は同時確率 $\Pr(Z_{1:T}=z_{1:T},Y_{1:T}=y_{1:T})$(したがって $L(\theta)>0$ なら事後確率)を最大にし、最大値は $\max_j\delta_T(j)$ である。計算量は $O(TK^2)$。
prf-hmm-fb の記号で、$\Pr(Z_{1:t}=z_{1:t},Y_{1:t}=y_{1:t})=f_t(z_{1:t})$ であり(段 1)、$f_{t+1}(z_{1:t},j)=f_t(z_{1:t})A_{z_tj}B_j(y_{t+1})$。非負の数の最大は $\max_{u,v}a(u)b(u,v)$ を $\max_u\bigl(\max_v\ldots\bigr)$ と順に分けられるので、
$$
\delta_{t+1}(j)=\max_{i}\Bigl(\max_{z_{1:t-1}}f_t(z_{1:t-1},i)\Bigr)A_{ij}B_j(y_{t+1})=B_j(y_{t+1})\max_i\delta_t(i)A_{ij}
$$
となり 1 が出る($\delta_t(i)$ を達成する $z_{1:t-1}$ と $i$ をつなげれば右辺が達成される)。
2 を示す。帰納法で「各 $t$ と $j$ について、$\psi$ を $j$ から後ろへたどった列 $w^{(t,j)}=(w_1,\dots,w_{t-1},j)$ は $f_t(w^{(t,j)})=\delta_t(j)$ をみたす」ことを示す。$t=1$ は明らか。$t+1$ では $i=\psi_{t+1}(j)$ とすると $w^{(t+1,j)}=(w^{(t,i)},j)$ なので、帰納法の仮定と 1 から $f_{t+1}(w^{(t+1,j)})=\delta_t(i)A_{ij}B_j(y_{t+1})=\delta_{t+1}(j)$。$z^\star_{1:T}=w^{(T,z_T^\star)}$ であり、任意の経路 $z_{1:T}$ について $f_T(z_{1:T})\le\delta_T(z_T)\le\delta_T(z_T^\star)=f_T(z^\star_{1:T})$。事後確率は同時確率を正の定数 $L(\theta)$ で割ったものなので、最大にする列は同じである。□
Viterbi アルゴリズムは 動的計画法 の典型例で、$\delta_t$ は「時刻 $t$ に状態 $j$ で終わる最良の部分経路の値」にあたる。実装では積が小さくなりすぎるので、$\log\delta_t$ を使って積を和に替える。同じ再帰は、畳み込み符号の最尤復号にも使われる(畳み込み符号 の定理「Viterbi 復号」)。
Baum–Welch アルゴリズム
パラメータ $\theta$ が未知のとき、尤度 $L(\theta)$ を最大にしたい。状態の列が見えていれば推移と放出の回数を数えるだけで最尤推定が求まるが、見えないので、その回数を現在の $\theta$ での事後確率による期待値に替えて反復する。これは EMアルゴリズム の HMM の場合で、次の定理は同記事の定理「EMアルゴリズムの単調性」の特別な場合にあたる。
$L(\theta)>0$ とし、$\gamma_t,\xi_t$ を $\theta$ で計算する(thm-hmm-fb)。すべての状態 $i,j$ について $\sum_{t=1}^{T-1}\gamma_t(i)>0$ と $\sum_{t=1}^{T}\gamma_t(j)>0$ を仮定して
$$
\pi'_i=\gamma_1(i),\qquad A'_{ij}=\frac{\sum_{t=1}^{T-1}\xi_t(i,j)}{\sum_{t=1}^{T-1}\gamma_t(i)},\qquad B'_j(m)=\frac{\sum_{t:\,y_t=m}\gamma_t(j)}{\sum_{t=1}^{T}\gamma_t(j)}
$$
と置くと、$\theta'=(\pi',A',B')$ はパラメータであり、$L(\theta')\ge L(\theta)$。
$p_\theta(z)=\Pr_\theta(Z_{1:T}=z,Y_{1:T}=y_{1:T})$、$q(z)=p_\theta(z)/L(\theta)$(事後分布)とし、$Q(\theta'')=\sum_{z}q(z)\log p_{\theta''}(z)$ と置く($q(z)>0$ の $z$ だけで足し、$\log0=-\infty$)。
段 1(下界):$q(z)>0$ の $z$ の上で、$\log$ は凹なので Jensenの不等式 により
$$
\log\frac{L(\theta'')}{L(\theta)}\ge\log\sum_{q(z)>0}q(z)\frac{p_{\theta''}(z)}{p_\theta(z)}\ge\sum_{q(z)>0}q(z)\log\frac{p_{\theta''}(z)}{p_\theta(z)}=Q(\theta'')-Q(\theta).
$$
(最初の不等号は、$q(z)>0$ でない $z$ の項を捨てたことによる。)よって $Q(\theta')\ge Q(\theta)$ を示せば $L(\theta')\ge L(\theta)$。
段 2($Q$ の分解):$\log p_{\theta''}(z)=\log\pi''_{z_1}+\sum_{t=1}^{T-1}\log A''_{z_tz_{t+1}}+\sum_{t=1}^T\log B''_{z_t}(y_t)$ を $q$ で平均すると、$\gamma,\xi$ が周辺の事後確率であることから
$$
Q(\theta'')=\sum_i\gamma_1(i)\log\pi''_i+\sum_{i}\sum_j n_{ij}\log A''_{ij}+\sum_j\sum_m e_{jm}\log B''_j(m),
$$
$n_{ij}=\sum_{t=1}^{T-1}\xi_t(i,j)$(推移 $i\to j$ の期待回数)、$e_{jm}=\sum_{t:y_t=m}\gamma_t(j)$(状態 $j$ で $m$ を出す期待回数)。ここで $\sum_jn_{ij}=\sum_{t=1}^{T-1}\gamma_t(i)$、$\sum_me_{jm}=\sum_t\gamma_t(j)$ である。
段 3(各項の最大化):非負の $w_1,\dots,w_r$(和 $W>0$)と確率ベクトル $p$ について、$\sum_kw_k\log p_k$ は $p_k=w_k/W$ で最大になる。実際 $\hat p_k=w_k/W$ とすると、$w_k>0$ の $k$ の上で再び Jensen の不等式から
$$
\sum_kw_k\log p_k-\sum_kw_k\log\hat p_k=W\sum_{w_k>0}\hat p_k\log\frac{p_k}{\hat p_k}\le W\log\sum_{w_k>0}p_k\le0.
$$
$\theta'$ の各行はちょうどこの $\hat p$ なので(仮定から分母は正)、段 2 の各項は $\theta''=\theta'$ で最大になり、$Q(\theta')\ge Q(\theta)$。□
尤度は増えるが、大域的な最大に届く保証はない(反例の表の最後の行)。また状態の番号を付け替えても尤度は変わらないので、付け替えで $\theta$ が変わる限り最尤推定は一つに定まらない。
公式の表
| 量 | 式 | 根拠 |
|---|---|---|
| 同時確率 | $\pi_{z_1}B_{z_1}(y_1)\prod_{t\ge2}A_{z_{t-1}z_t}B_{z_t}(y_t)$ | def-hmm |
| 前向き | $\alpha_{t+1}(j)=B_j(y_{t+1})\sum_i\alpha_t(i)A_{ij}$ | thm-hmm-fb |
| 後ろ向き | $\beta_t(i)=\sum_jA_{ij}B_j(y_{t+1})\beta_{t+1}(j)$ | thm-hmm-fb |
| 尤度 | $L=\sum_j\alpha_T(j)=\sum_j\alpha_t(j)\beta_t(j)$ | thm-hmm-fb |
| 平滑化 | $\gamma_t(j)=\alpha_t(j)\beta_t(j)/L$($L>0$) | thm-hmm-fb |
| 2 時刻の事後確率 | $\xi_t(i,j)=\alpha_t(i)A_{ij}B_j(y_{t+1})\beta_{t+1}(j)/L$($L>0$) | thm-hmm-fb |
| 対数尤度(尺度化) | $\log L=\sum_t\log c_t$ | prop-hmm-scale |
| Viterbi | $\delta_{t+1}(j)=B_j(y_{t+1})\max_i\delta_t(i)A_{ij}$ | thm-hmm-viterbi |
| Baum–Welch | $A'_{ij}=\sum_t\xi_t(i,j)/\sum_{t\le T-1}\gamma_t(i)$ など($L>0$、分母が正) | thm-hmm-bw |
計算の手順
- 尺度化した前向き計算で $\hat\alpha_t$ と $c_t$ を求める。$\sum_t\log c_t$ が対数尤度。
- 同じ $c_t$ で割りながら後ろ向きに $\hat\beta_t$ を求め、$\gamma_t=\hat\alpha_t\hat\beta_t$、$\xi_t(i,j)=\hat\alpha_t(i)A_{ij}B_j(y_{t+1})\hat\beta_{t+1}(j)/c_{t+1}$。
- 状態の列が要るなら、対数で Viterbi を回して後ろへたどる。
- 学習では 2 の $\gamma,\xi$ で thm-hmm-bw の更新を行い、対数尤度の増え方が小さくなるまで 1 から繰り返す。初期値を変えて何度か走らせ、尤度の最も大きい結果をとる。
例題
以下、状態 $1$ は公正な硬貨、状態 $2$ は表の出やすい硬貨で、
$$
\pi=(\tfrac12,\tfrac12),\qquad A=\begin{pmatrix}\frac34&\frac14\\ \frac14&\frac34\end{pmatrix},\qquad B_1(\text{表})=B_1(\text{裏})=\tfrac12,\quad B_2(\text{表})=\tfrac34,\ B_2(\text{裏})=\tfrac14
$$
とし、観測を $y_{1:3}=(\text{表},\text{表},\text{裏})$ とする。
尤度 $L$ と $\gamma_t(2)$ を求める。
使う公式:thm-hmm-fb。
答え:$\alpha_1=(\frac14,\frac38)$、$\alpha_2=(\frac9{64},\frac{33}{128})$、$\alpha_3=(\frac{87}{1024},\frac{117}{2048})$ より $L=\frac{291}{2048}\approx0.14209$。$\beta_2=(\frac7{16},\frac5{16})$、$\beta_1=(\frac{57}{256},\frac{59}{256})$ で、$\gamma_t(2)=\frac{59}{97},\frac{55}{97},\frac{39}{97}\approx0.608,\,0.567,\,0.402$。
途中の計算を開く
$\alpha_2(1)=\frac12(\frac14\cdot\frac34+\frac38\cdot\frac14)=\frac9{64}$、$\alpha_2(2)=\frac34(\frac14\cdot\frac14+\frac38\cdot\frac34)=\frac{33}{128}$、$\alpha_3(1)=\frac12(\frac9{64}\cdot\frac34+\frac{33}{128}\cdot\frac14)=\frac{87}{1024}$、$\alpha_3(2)=\frac14(\frac9{64}\cdot\frac14+\frac{33}{128}\cdot\frac34)=\frac{117}{2048}$。$\beta_2(1)=\frac34\cdot\frac12+\frac14\cdot\frac14=\frac7{16}$、$\beta_2(2)=\frac14\cdot\frac12+\frac34\cdot\frac14=\frac5{16}$。どの $t$ でも $\sum_j\alpha_t(j)\beta_t(j)=\frac{291}{2048}$(例えば $t=1$:$\frac14\cdot\frac{57}{256}+\frac38\cdot\frac{59}{256}$)。尺度化の定数は $c=(\frac58,\frac{51}{80},\frac{97}{272})$ で積が $L$。フィルタ $\Pr(Z_t=2\mid y_{1:t})$ は $\frac35,\frac{11}{17},\frac{39}{97}$。
同じ観測で Viterbi の経路を求める。
使う公式:thm-hmm-viterbi。
答え:$\delta_1=(\frac14,\frac38)$、$\delta_2=(\frac3{32},\frac{27}{128})$、$\delta_3=(\frac9{256},\frac{81}{2048})$。最大は $\delta_3(2)$ で、たどると $(2,2,2)$、事後確率は $\frac{81}{2048}/\frac{291}{2048}=\frac{27}{97}\approx0.278$。時刻 3 だけを見ると $\gamma_3(1)=\frac{58}{97}>\frac12$ なのに、経路としては状態 2 が選ばれる。
同じ $\theta$ と観測から thm-hmm-bw の $\theta'$ を求め、尤度を比べる。使う公式:thm-hmm-fb の 4($\gamma_t$、$\xi_t$)、thm-hmm-bw。
答え:推移の期待回数は $n=\frac1{97}\begin{pmatrix}64&16\\36&78\end{pmatrix}$ で、$A'=\begin{pmatrix}\frac45&\frac15\\ \frac6{19}&\frac{13}{19}\end{pmatrix}$、$B'_1(\text{表})=\frac{40}{69}$、$B'_2(\text{表})=\frac{38}{51}$、$\pi'=(\frac{38}{97},\frac{59}{97})$。尤度は $0.14209$ から $0.15426$ に増える。
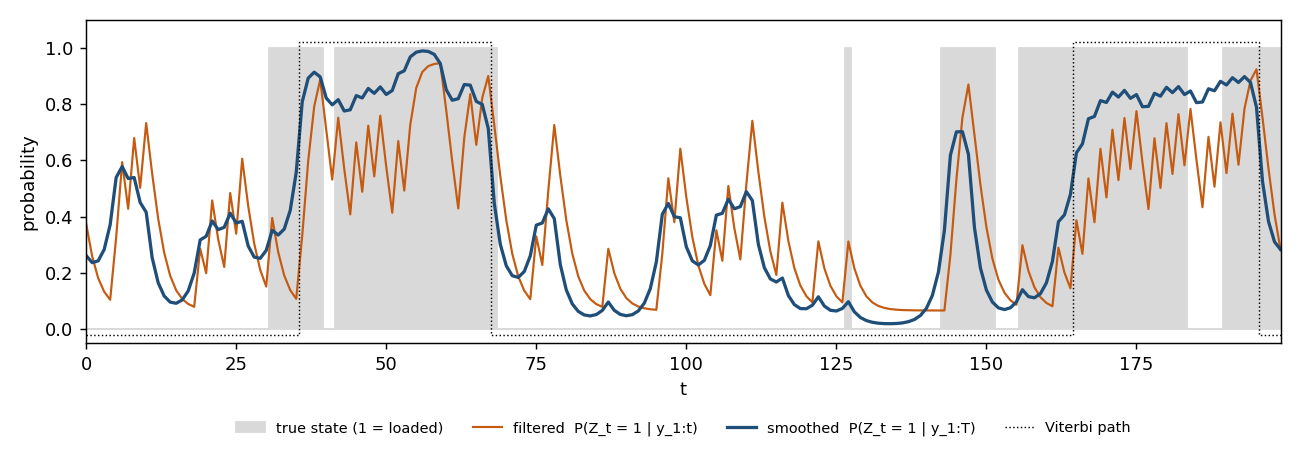 図: 公正なさいころ(状態 0)と 6 が確率 1/2 で出るさいころ(状態 1)を、状態 0 から 0.05、状態 1 から 0.10 の確率で切り替える HMM から 200 回の目を作り、真の状態(灰色の帯)、フィルタ P(Z_t=1|y_1:t)(橙)、平滑化 P(Z_t=1|y_1:T)(青)、Viterbi の経路(点線)を重ねた。平滑化はフィルタより揺れが小さく、真の状態の当たる割合はフィルタ 73%、平滑化 82.5%、Viterbi 81.5%。
使える条件と反例
各行は def-hmm の仮定か、Baum–Welch に期待される性質の前提を 1 つだけ外す。
| 外す条件 | 例 | 成り立たなくなること |
|---|---|---|
| 観測は現在の状態だけで決まる | $K=1$、$Y_1$ は $\{0,1\}$ 上の一様分布、$Y_2=Y_1$ | 真の $\Pr(Y_{1:2}=(0,0))=\frac12$ だが、放出 $B=(\frac12,\frac12)$ で前向き計算すると $\frac14$ |
| 状態は 1 次の Markov 連鎖 | $Z$ は $1,1,2,2,1,1,\dots$ を一様な位相から始めた列、$Y_t=Z_t$ | 1 次の推移は $A_{ij}=\frac12$ と推定されるが、そのモデルでは $\Pr(1,1,1)=\frac18$(真は $0$)、$\Pr(1,1,2)=\frac18$(真は $\frac14$) |
| 初期値で状態が区別される | $\pi=(\frac12,\frac12)$、$A$ の対角 $\frac23$・対角の外 $\frac13$ で、放出の 2 行が等しい初期値、観測 $(\text{表}^3\text{裏}^3)^2$ | $\gamma_t$ が観測によらず、$\theta'=\theta$ の不動点に止まる(尤度 $2^{-12}\approx0.000244$)。同じ $\pi,A$ で放出の行を $(\frac35,\frac25)$、$(\frac25,\frac35)$ にした初期値から 40 回反復すると $0.00180$ まで増える |
反例の確かめ
1 行目:$K=1$ なら前向き計算は $L=\prod_tB(y_t)$ で、観測の依存を表せない。2 行目:真の過程で長さ 3 の列は $(1,1,2),(1,2,2),(2,2,1),(2,1,1)$ が各 $\frac14$。$Z_1=1$ のとき $Z_2=1$ となる確率は $\frac12$ なので 1 次の推移は全部 $\frac12$ になり、どの列も $\frac18$。3 行目:$\pi$ と $A$ が状態の入れ替えで不変で $B_1=B_2$ なら、$\Pr(z_{1:T},y_{1:T})=\Pr(z_{1:T})\prod_tB_1(y_t)$ で事後分布は事前分布に一致する。よって $\xi_t,\gamma_t$ は事前の値で、$A'=A$、$\pi'=\pi$、$B'_j(m)$ は両方の $j$ で観測の相対頻度 $\frac12$ になる。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 各時刻で $\gamma_t$ が最大の状態を並べて「最も確からしい列」とする | 列の最大は Viterbi で求める | $\pi=(\frac25,\frac3{10},\frac3{10})$、$A$ の行を $(0,0,1),(0,1,0),(0,1,0)$、放出を一定とすると、時刻ごとの最大は $(1,2)$ で確率 $0$、Viterbi は $(1,3)$(確率 $\frac25$) |
| $\alpha_t$ をそのまま計算する | 尺度化するか対数で計算する | 例えば $T=400$ で $L\approx1.4\times10^{-306}$ となり、倍精度の範囲の端に達する |
| フィルタと平滑化を混同する | フィルタは $y_{1:t}$、平滑化は $y_{1:T}$ による | 例題 ex-hmm-forward で時刻 2 のフィルタ $\frac{11}{17}\approx0.647$ と平滑化 $\frac{55}{97}\approx0.567$ は違う |
| Baum–Welch の結果を最尤推定とみなす | 尤度は増えるが局所的な値に止まりうる | 反例の表の 3 行目 |
| $\xi_t$ の分母を $\sum_{t=1}^{T}\gamma_t(i)$ にする | 推移の回数なので $t\le T-1$ | 時刻 $T$ からの推移はない |
補足
Baum–Welch アルゴリズムは Baum らの 1970 年の論文(Mur25 §29.4.1)、Viterbi アルゴリズムは Viterbi(1967)による(Mur25 §9.2.6)。この記事の $\alpha_t$ は Rabiner(1989)の解説の定義(Mur25 §9.2.3.4 の式 (9.30))で、Mur25 は正規化したフィルタを $\alpha_t$ と書く。格子状の図(トレリス)の上の和と最大の計算として見る説明は Mac03 §25.3 にある。thm-hmm-bw の段 1 の不等式は EM アルゴリズム一般の単調性(ESL17 §8.5.2、式 (8.47))の HMM の場合である。
関連項目
- 前提: Markov連鎖, 条件付き確率, Bayesの定理, 最尤推定
- 道具: 動的計画法, Jensenの不等式, 確率行列
- 比較: Kalmanフィルタ
- 発展: EMアルゴリズム, Kullback–Leiblerダイバージェンス
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

