統計的学習理論
概要
統計的学習理論(statistical learning theory)とは、データの分布を知らないまま有限個の標本から予測の規則を選ぶときの誤りを、確率の不等式で評価する理論である。過剰リスクは近似誤差と推定誤差に分かれ、推定誤差は一様な偏差で抑えられる。2 値分類では、VC 次元の有限性、一様収束性、PAC 学習可能性が同値になる。
前提知識: 確率空間, 独立性(確率論), Hoeffdingの不等式
100 個のデータに合う規則を見つけても、次のデータに当たるとは限らない。規則の候補を増やせば訓練データにはいくらでも合うが、未知のデータでの成績はかえって悪くなることがある。データの数、候補の豊かさ、未知のデータでの誤りの 3 つの間には、どんな関係があるのか。
統計的学習理論(statistical learning theory)は、データの分布を知らないまま、有限個の標本から予測の規則を選ぶときの誤りを、確率の不等式で評価する理論である。分布について仮定を置かず、仮説の集合の大きさだけで評価することが多い。この記事は分野の地図にあたり、柱の定理の証明はそれぞれの記事に置く。
この記事で証明するのは次のものである。
- 分布を知っていれば達成できる最良の誤りは Bayes 分類器で実現する(thm-slt-bayes)。
- 過剰リスクは近似誤差と推定誤差に分かれ、推定誤差は一様な偏差で抑えられる(prop-slt-decomposition)。
- どの学習アルゴリズムにも失敗する分布がある(thm-slt-nfl)。
- 仮説ごとに重みを配ると、複雑さに応じた誤差の上界が得られる(thm-slt-occam)。
- 汎化ギャップの期待値は、標本を 1 個入れ替えたときの変化に等しい(thm-slt-stability)。
- 2 乗損失の予測誤差は雑音・バイアス・バリアンスの和になる(thm-slt-bias-variance)。
定義と全体の地図
標本空間を $\mathcal Z$ とする。分類や回帰では $\mathcal Z=\mathcal X\times\mathcal Y$ である。
$\mathcal D$ を $\mathcal Z$ 上の確率分布、$\mathcal H$ を仮説の集合、$\ell\colon\mathcal H\times\mathcal Z\to[0,\infty)$ を可測な損失とする。
$$
L_{\mathcal D}(h):=\mathbb E_{z\sim\mathcal D}[\ell(h,z)]
$$
を $h$ の リスク、標本 $S=(z_1,\dots,z_m)$ について
$$
L_S(h):=\frac1m\sum_{i=1}^m\ell(h,z_i)
$$
を 経験リスク という。$L_S(h)$ を最小にする $h\in\mathcal H$ を返す規則を 経験リスク最小化(ERM)という。
標本 $S$ から仮説を返す写像 $A$ を 学習アルゴリズム といい、$L_{\mathcal D}(A(S))-L_S(A(S))$ を 汎化ギャップ という。
2 値分類では $\mathcal Y=\{0,1\}$、$\ell(h,(x,y))=\mathbf 1[h(x)\ne y]$(0-1 損失)である。回帰では $\ell(h,(x,y))=(h(x)-y)^2$ を使うことが多い。
分野の問いと道具を並べる。
| 問い | 道具 | 証明の置き場 |
|---|---|---|
| 2 値分類のクラスは学習できるか | VC 次元が有限かどうか | VC次元 |
| 例はいくつ要るか | 有限クラスの和集合の評価、標本複雑度 | PAC学習 |
| データに即した上界はあるか | ランダムな符号との相関 | Rademacher複雑度 |
| 成長関数はどれだけ小さいか | 組合せの補題 | Sauer–Shelahの補題 |
| 偏差の確率はどう抑えるか | 独立和の裾 | Hoeffdingの不等式、McDiarmidの不等式 |
| 弱い規則を強くできるか | 重みの更新 | ブースティング |
| マージンで汎化を説明できるか | 再生核のノルムの正則化 | サポートベクターマシン、カーネル法 |
| 正則化はなぜ効くか | 標本の入れ替えへの安定性 | この記事と Tikhonov正則化 |
公式の表
$\mathcal D$ は未知、$S\sim\mathcal D^m$ とする。
| 量 | 式 | 条件 |
|---|---|---|
| Bayes リスク | $L^*=\mathbb E[\min(\eta(X),1-\eta(X))]$ | 0-1 損失、$\eta(x)=P(Y=1\mid X=x)$ |
| 過剰リスクの分解 | $L_{\mathcal D}(h)-L^*=(\inf_{\mathcal H}L_{\mathcal D}-L^*)+(L_{\mathcal D}(h)-\inf_{\mathcal H}L_{\mathcal D})$ | $h\in\mathcal H$ |
| ERM の推定誤差 | $\le2\sup_{h\in\mathcal H}\lvert L_S(h)-L_{\mathcal D}(h)\rvert$ | ERM |
| 単一の仮説の偏差 | $P(\lvert L_S(h)-L_{\mathcal D}(h)\rvert>\varepsilon)\le2e^{-2m\varepsilon^2}$ | 損失が $[0,1]$、$h$ は $S$ と無関係 |
| 有限クラスの偏差 | $\sqrt{\log(2\lvert\mathcal H\rvert/\delta)/(2m)}$ | 確率 $1-\delta$ 以上で全 $h$ に |
| VC 次元による偏差 | $2\sqrt{2d\log(em/d)/m}+\sqrt{\log(1/\delta)/(2m)}$ | 片側、$1\le d\le m$ |
| 重みつきの偏差 | $\sqrt{(\log(1/w(h))+\log(2/\delta))/(2m)}$ | $\sum_h w(h)\le1$、可算 |
| 安定性 | $\mathbb E[\text{汎化ギャップ}]=\mathbb E[\ell(A(S^{(i)}),z_i)-\ell(A(S),z_i)]$ | $i$ は一様、$S^{(i)}$ は 1 個入れ替え |
| バイアス・バリアンス | $\mathrm{Err}(x_0)=\sigma^2+\mathrm{Bias}^2+\mathrm{Var}$ | 2 乗損失、雑音は平均 0 |
VC 次元による偏差の行は、Rademacher複雑度 の系「VC 次元による評価」の形である。
達成できる最良の誤り
分布を完全に知っていても、$X$ から $Y$ が決まらなければ誤りは残る。その下限を求める。
$(X,Y)\sim\mathcal D$、$Y\in\{0,1\}$、$\eta(x):=P(Y=1\mid X=x)$ とし、$h^*(x):=\mathbf 1[\eta(x)\ge1/2]$ とおく(Bayes 分類器)。0-1 損失について、可測な $h\colon\mathcal X\to\{0,1\}$ はすべて
$$
L_{\mathcal D}(h)-L_{\mathcal D}(h^*)=\mathbb E\bigl[\lvert2\eta(X)-1\rvert\,\mathbf 1[h(X)\ne h^*(X)]\bigr]\ge0
$$
を満たす。特に $L^*:=L_{\mathcal D}(h^*)=\mathbb E[\min(\eta(X),1-\eta(X))]$ が最小のリスクである。
$X=x$ を固定すると、$h(x)=0$ なら誤りの条件付き確率は $\eta(x)$、$h(x)=1$ なら $1-\eta(x)$ である。$h(x)=h^*(x)$ の点では $h$ と $h^*$ の差は 0 である。$h(x)\ne h^*(x)$ の点では、$h^*$ の誤りは $\min(\eta,1-\eta)$、$h$ の誤りは $\max(\eta,1-\eta)$ で、差は $\lvert2\eta(x)-1\rvert$ である。$X$ について期待値をとると式を得る。∎
過剰リスクの分解
学習の成績は、$L^*$ との差で測る。
$h\in\mathcal H$ について
$$
L_{\mathcal D}(h)-L^*=\underbrace{\inf_{g\in\mathcal H}L_{\mathcal D}(g)-L^*}_{\text{近似誤差}}+\underbrace{L_{\mathcal D}(h)-\inf_{g\in\mathcal H}L_{\mathcal D}(g)}_{\text{推定誤差}}
$$
である。$h_S$ が ERM の出力なら、推定誤差は $2\sup_{g\in\mathcal H}\lvert L_S(g)-L_{\mathcal D}(g)\rvert$ 以下である。
等式は項を足し引きしただけである。$\Delta:=\sup_{g\in\mathcal H}\lvert L_S(g)-L_{\mathcal D}(g)\rvert$ とおく。どの $g\in\mathcal H$ についても
$$
L_{\mathcal D}(h_S)\le L_S(h_S)+\Delta\le L_S(g)+\Delta\le L_{\mathcal D}(g)+2\Delta
$$
である。真ん中の不等号は $h_S$ が $L_S$ の最小点であることによる。$g$ について下限をとる。∎
近似誤差は $\mathcal H$ を大きくすると減り、標本には関係しない。推定誤差は標本を増やすと減るが、$\mathcal H$ を大きくすると増えやすい。この綱引きが分野を貫く主題である。
推定誤差の評価は prop-slt-decomposition により一様な偏差 $\Delta$ に帰着する。2 値分類では、これが次の同値に行き着く。
$\mathcal H\subset\{0,1\}^{\mathcal X}$、損失を 0-1 損失とする。次は同値である。
- $\mathcal H$ の VC 次元は有限である。
- $\mathcal H$ は一様収束性をもつ。
- ERM は $\mathcal H$ の不可知 PAC 学習アルゴリズムである。
- $\mathcal H$ は不可知 PAC 学習可能である。
- $\mathcal H$ は PAC 学習可能である。
VC 次元が $d$ のとき、不可知の場合の標本複雑度は定数倍を除いて $(d+\log(1/\delta))/\varepsilon^2$ である。
例題 1(各項の数値)。 $X\sim U[0,1]$、$\eta(x)=0.2$($x< 1/2$)、$\eta(x)=0.9$($x\ge1/2$)とする。Bayes 分類器は $\mathbf 1[x\ge1/2]$ で、$L^*=\frac12\cdot0.2+\frac12\cdot0.1=0.15$ である。
| 仮説の集合 | 最良のリスク | 近似誤差 |
|---|---|---|
| 定数 $\{0,1\}$ | $h\equiv1$ で $0.45$($h\equiv0$ は $0.55$) | $0.30$ |
| 閾値 $\mathbf 1[x\ge t]$ | $t=1/2$ で $0.15$ | $0$ |
閾値のクラスのリスクは、$t\le1/2$ で $0.45-0.6t$、$t\ge1/2$ で $0.8t-0.25$ である。
例題 2(上界と実際)。 例題 1 の閾値のクラスは VC 次元 1 である。prop-slt-decomposition と公式の表から、公式の表の式は片側なので両側に $\delta=0.025$ ずつ配ると(逆向きは損失を $1-\ell$ に替えて同じ式になる)、過剰リスクは確率 $0.95$ 以上で $2(2\sqrt{2\log(em)/m}+\sqrt{\log40/(2m)})$ 以下になる。一方、種を固定して ERM を 2000 回試すと次のようになる。
| $m$ | 上界 | 実際の 95% 点 | 実際の平均 |
|---|---|---|---|
| $100$ | $1.61$(自明) | $0.039$ | $0.0112$ |
| $1000$ | $0.59$ | $0.0043$ | $0.0012$ |
| $10000$ | $0.208$ | $0.00042$ | $0.00011$ |
上界は $1/\sqrt m$ の程度で減るのに対し、この分布では実際は $1/m$ の程度で減る。$\eta$ が $1/2$ の近くを通らないため速く、上界のほうはどの分布にも効く形である代わりに大きい。上界が小さいなら保証になるが、上界が大きくても失敗するとは限らない。
例を増やしても避けられない失敗
どんな学習アルゴリズムにも苦手な分布がある。PAC学習 の定理「No-Free-Lunch 定理」には筋だけを述べたので、ここに証明を置く。
$A$ を 2 値分類の決定的な学習アルゴリズム、$m$ を $m\le\lvert\mathcal X\rvert/2$ を満たす自然数とする。$\mathcal X\times\{0,1\}$ 上の分布 $\mathcal D$ で次を満たすものがある。
- ある $f\colon\mathcal X\to\{0,1\}$ について $L_{\mathcal D}(f)=0$ である。
- $S\sim\mathcal D^m$ について $P(L_{\mathcal D}(A(S))\ge1/8)\ge1/7$ である。
$\lvert C\rvert=2m$ となる $C\subset\mathcal X$ をとる。$f\colon C\to\{0,1\}$ について、$\mathcal D_f$ を「$x$ を $C$ から一様に選び、ラベルを $f(x)$ とする」分布とする。$f$ は $\mathcal X$ へ適当に延ばしておけばよく、$L_{\mathcal D_f}(f)=0$ である。
$f$ を $2^{2m}$ 個の関数から一様に選び、独立に $x=(x_1,\dots,x_m)\in C^m$ を一様に選ぶ。標本を $S_f:=((x_i,f(x_i)))_i$ と書き、$\hat h:=A(S_f)$ とおく。$V:=C\setminus\{x_1,\dots,x_m\}$ は見ていない点の集合で、$\lvert V\rvert\ge m$ である。
$$
L_{\mathcal D_f}(\hat h)=\frac1{2m}\sum_{v\in C}\mathbf 1[\hat h(v)\ne f(v)]\ge\frac1{2m}\sum_{v\in V}\mathbf 1[\hat h(v)\ne f(v)]
$$
である。$x$ と $f$ の $\{x_i\}$ への制限を固定する。$\hat h$ はこれらだけで決まる。一方、$v\in V$ での値 $f(v)$ は一様で、これらと独立である。したがって $v\in V$ について $P(\hat h(v)\ne f(v)\mid x,\,f|_{\{x_i\}})=1/2$ である。よって
$$
\mathbb E_{f,x}\bigl[L_{\mathcal D_f}(\hat h)\bigr]\ge\frac1{2m}\cdot\mathbb E\lvert V\rvert\cdot\frac12\ge\frac14
$$
である。平均が $1/4$ 以上なので、ある $f$ について $\mathbb E_x[L_{\mathcal D_f}(\hat h)]\ge1/4$ である。
この $f$ について $p:=P(L_{\mathcal D_f}(\hat h)\ge1/8)$ とおく。$L\le1$ なので $1/4\le\mathbb E[L]\le p+(1-p)/8$ であり、$p\ge1/7$ を得る。$\mathcal D:=\mathcal D_f$ とすればよい。∎
この定理は SSBD14 Theorem 5.1 の主張で、$\mathcal H$ を制限しないと学習できないことを述べる。条件 1 により、失敗の原因は雑音ではない。
$x$ は $16$ 通り、$f$ も $16$ 通りである。「見た点は記憶し、未見の点は 0 と答える」規則 $A$ を考える。異なる点を $2$ 個見る確率は $3/4$、$1$ 個だけ見る確率は $1/4$ なので $\mathbb E\lvert V\rvert=2.25$ である。$f$ について平均すると $\mathbb E[L]=\frac14\cdot\frac12\cdot2.25=0.28125\ge\frac14$ である。
最悪の $f\equiv1$ では未見の点がすべて誤りで、$\mathbb E[L]=2.25/4=0.5625$ である。$f\equiv0$ なら $L=0$ である。「未見の点は見た点の多数決」と変えても、$f$ の平均は $0.28125$ のままで、苦手な $f$ が移るだけである。
複雑さに応じた上界
一様な上界は、$\mathcal H$ のすべての仮説に同じ余裕を要求する。仮説ごとに余裕を変えると、VC 次元が無限のクラスでも評価が得られる。
$\mathcal H$ は可算、損失は $[0,1]$ に値をとり、$w\colon\mathcal H\to(0,1]$ は $\sum_{h\in\mathcal H}w(h)\le1$ を満たすとする。$\delta\in(0,1)$ について、確率 $1-\delta$ 以上で、すべての $h\in\mathcal H$ について同時に
$$
\lvert L_{\mathcal D}(h)-L_S(h)\rvert\le\varepsilon_h:=\sqrt{\frac{\log(1/w(h))+\log(2/\delta)}{2m}}
$$
が成り立つ。
$h$ は $S$ と無関係に固定されているので、Hoeffdingの不等式 により
$$
P(\lvert L_{\mathcal D}(h)-L_S(h)\rvert>\varepsilon_h)\le2e^{-2m\varepsilon_h^2}=2\cdot w(h)\cdot\frac\delta2=w(h)\delta
$$
である。可算個の事象の和の確率は和以下であり、$\sum_hw(h)\delta\le\delta$ である。∎
$h$ を長さ $\lvert h\rvert$ ビットの接頭符号で書くと、Kraft の不等式により $w(h)=2^{-\lvert h\rvert}$ が条件を満たす(Occam の剃刀の式、SSBD14 Theorem 7.7)。短く書ける仮説ほど余裕が小さい。
$\mathcal H$ を $\bigcup_n\mathcal H_n$ と分け、各 $\mathcal H_n$ の一様な偏差に $w(n)$ を配る形は構造的リスク最小化(SRM)と呼ばれる(SSBD14 Theorem 7.4)。$h_S:=\arg\min_h(L_S(h)+\varepsilon_h)$ とおく。$\varepsilon_h\to\infty$($w$ の和が有限)と $L_S\ge0$ より最小点はある。thm-slt-occam の事象の上で、どの $g\in\mathcal H$ についても
$$
L_{\mathcal D}(h_S)\le L_S(h_S)+\varepsilon_{h_S}\le L_S(g)+\varepsilon_g\le L_{\mathcal D}(g)+2\varepsilon_g
$$
である。必要な標本数が比較相手 $g$ に依存することが、PAC 学習との違いである。
例題 3(符号の長さと余裕)。 $\delta=0.05$ とする。
| $\lvert h\rvert$(ビット) | $m=1000$ の $\varepsilon_h$ | $m=10000$ の $\varepsilon_h$ |
|---|---|---|
| $10$ | $0.0729$ | $0.0230$ |
| $100$ | $0.191$ | $0.0604$ |
| $1000$ | $0.590$ | $0.187$ |
$w(h)=2^{-\lvert h\rvert}$ なので $\log(1/w(h))=\lvert h\rvert\log2$ である。たとえば $\lvert h\rvert=10$、$m=1000$ では $\sqrt{(6.93+3.69)/2000}=0.0729$ となる。
$\mathcal X=\mathbb N$、$\mathcal H$ を有限部分集合 $A$ の指示関数の全体とする。どの有限集合も打ち砕かれるので VC 次元は無限で、thm-slt-fundamental により PAC 学習はできない。一方 $\mathcal H$ は可算なので、$A_1,A_2,\dots$ と番号を付け $w(A_n)=2^{-n}$ とおける。$g=\mathbf 1_{A_n}$ に対して $m\ge2(n\log2+\log(2/\delta))/\varepsilon^2$ なら $2\varepsilon_g\le\varepsilon$ である。比較相手ごとに標本数が決まり、全体に共通の標本数はない。
安定性による見方
偏差を $\mathcal H$ の全体で抑える代わりに、アルゴリズム自身を見ることもできる。
$z_1,\dots,z_m,z'$ を $\mathcal D$ に独立に従う標本、$S=(z_1,\dots,z_m)$ とし、$S^{(i)}$ を $S$ の $z_i$ を $z'$ に入れ替えたものとする。$\ell(A(S),z')$ と各 $\ell(A(S),z_i)$ が可積分で $A$ が可測なら、$\{1,\dots,m\}$ の上で一様に独立に選んだ $i$ について
$$
\mathbb E\bigl[L_{\mathcal D}(A(S))-L_S(A(S))\bigr]=\mathbb E\bigl[\ell(A(S^{(i)}),z_i)-\ell(A(S),z_i)\bigr]
$$
である。
$z'$ は $S$ と独立なので $\mathbb E[L_{\mathcal D}(A(S))]=\mathbb E[\ell(A(S),z')]$ である。$(S,z')$ と $(S^{(i)},z_i)$ は同じ分布に従うので、これは各 $i$ で $\mathbb E[\ell(A(S^{(i)}),z_i)]$ に等しい。また $\mathbb E[L_S(A(S))]=\frac1m\sum_i\mathbb E[\ell(A(S),z_i)]$ は $i$ についての平均である。両者を引く。∎
これは SSBD14 Theorem 13.2 である。標本を 1 個変えても出力があまり変わらないアルゴリズムは、期待値の意味で過学習しない。正則化項を足すと損失が強凸になって安定性が増すので、VC 次元に触れずに上界が得られる(SSBD14 §13.3)。
$z\in\mathbb R$ の分布は平均 $0$、分散 $\sigma^2$ で、$\ell(h,z)=(h-z)^2$、$A(S)=\bar z$(ERM)とする。
直接の計算では、$\mathbb E[L_{\mathcal D}(\bar z)]=\sigma^2/m+\sigma^2$、$\mathbb E[L_S(\bar z)]=(m-1)\sigma^2/m$ なので、ギャップの期待値は $2\sigma^2/m$ である。
thm-slt-stability の右辺では、$A(S^{(i)})=\bar z+(z'-z_i)/m$ から
$$
\mathbb E\Bigl[\frac{z'-z_i}m\Bigl(2(\bar z-z_i)+\frac{z'-z_i}m\Bigr)\Bigr]=\frac2m\Bigl(\sigma^2-\frac{\sigma^2}m\Bigr)+\frac{2\sigma^2}{m^2}=\frac{2\sigma^2}m
$$
となり一致する。$z\sim U[-1,1]$、$m=5$ なら $\sigma^2=1/3$ で、ギャップは $2/15\approx0.1333$ である。
2 乗損失の分解
回帰では、誤差の内訳を直接書ける。
$y=f(x_0)+\epsilon$、$\mathbb E\epsilon=0$、$\mathrm{Var}\,\epsilon=\sigma^2$ とする。推定量 $\hat f$ は訓練データで決まり、$\hat f(x_0)$ は 2 乗可積分で $\epsilon$ と独立とする。このとき
$$
\mathbb E[(y-\hat f(x_0))^2]=\sigma^2+\bigl(\mathbb E\hat f(x_0)-f(x_0)\bigr)^2+\mathrm{Var}\,\hat f(x_0)
$$
である。
$y-\hat f=\epsilon+(f-\mathbb E\hat f)+(\mathbb E\hat f-\hat f)$(値はすべて $x_0$)と分ける。2 乗して期待値をとる。$\epsilon$ は平均 0 で残りと独立、$\mathbb E\hat f-\hat f$ は平均 0 で $f-\mathbb E\hat f$ は定数なので、交差項はすべて消える。∎
式は ESL17 §7.3 の (7.9) の形である。線形の最小 2 乗で計画点 $x_1,\dots,x_n$ を固定し、$p$ 次元の空間へ射影 $P$ で当てはめると、計画点の上の平均は次のように計算できる。
$$
\frac1n\sum_i\mathrm{Var}\,\hat f(x_i)=\frac{\sigma^2\operatorname{tr}P}n=\frac{\sigma^2p}n,\qquad\frac1n\sum_i\mathrm{Bias}^2(x_i)=\frac{\|(I-P)f\|^2}n
$$
例題 4(次数の選択)。 $f(x)=\sin2\pi x$、$x_i=(i-\frac12)/30$($n=30$)、$\sigma=0.3$ として次数 $d$ の多項式を当てはめる。$p=d+1$ である。
| $d$ | 平均 $\mathrm{Bias}^2$ | 平均 $\mathrm{Var}$ | $\sigma^2$ との和 |
|---|---|---|---|
| $0$ | $0.5000$ | $0.0030$ | $0.5930$ |
| $1$ | $0.1946$ | $0.0060$ | $0.2906$ |
| $3$ | $0.0042$ | $0.0120$ | $0.1062$ |
| $5$ | $0.00002$ | $0.0180$ | $0.1080$ |
| $9$ | $0.0000$(小数 4 桁まで) | $0.0300$ | $0.1200$ |
最小は $d=3$ の $0.1062$ である。$f$ は計画の中心について奇関数なので、偶数次の項は当てはめに寄与せず、$d=2$ のバイアスは $d=1$ と同じである。
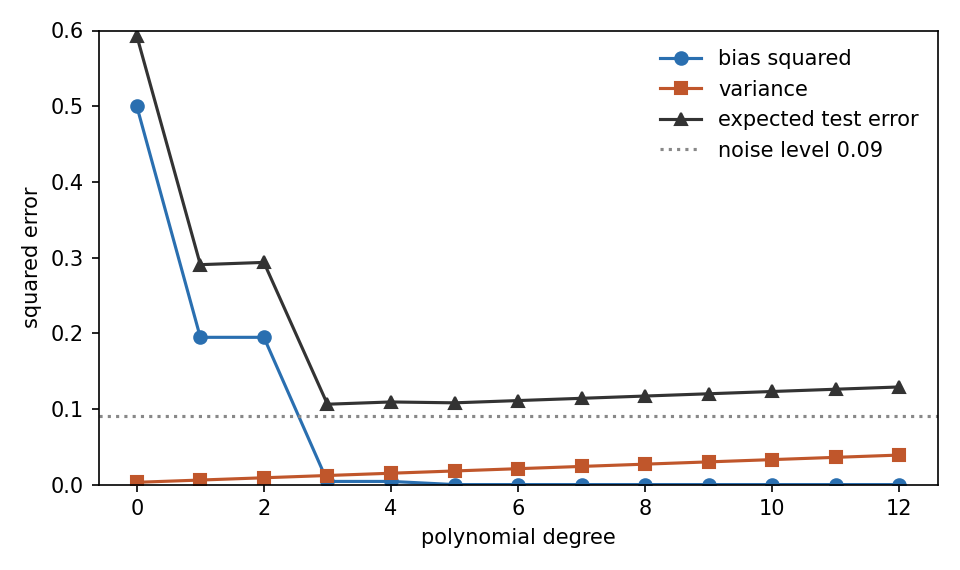 多項式の次数に対するバイアスの2乗、バリアンス、期待予測誤差の変化
計算の手順
具体的な $\mathcal H$ の推定誤差を見積もる手順は次のとおりである。
- 損失の範囲を確かめる。 $[0,1]$ でなければ、幅 $B$ で割って Hoeffding の評価を $B$ 倍する。有界でなければこの節の上界は使えない。
- クラスの大きさを測る。 有限なら $\lvert\mathcal H\rvert$、2 値なら VC 次元 $d$、実数値なら Rademacher の量を使う。
- 上界を書く。 公式の表の式に $m,\delta$ を入れる。
- 推定誤差に直す。 ERM なら偏差を 2 倍する(prop-slt-decomposition)。
- 標本数に解く。 偏差 $\le\varepsilon$ となる $m$ を求める。有限クラスなら $m\ge\log(2\lvert\mathcal H\rvert/\delta)/(2\varepsilon^2)$ である。
- 近似誤差と比べる。 クラスを広げて近似誤差がどれだけ減るかと、増えた偏差を比べる。
たとえば $\lvert\mathcal H\rvert=1000$、$\delta=0.05$、$\varepsilon=0.05$ では $m\ge\log(40000)/0.005\approx2120$ である。
適用条件と反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 標本の独立性 | すべての $z_i$ が $z_1$ に等しい | 偏差の評価。$m$ を増やしても $\lvert L_S-L_{\mathcal D}\rvert=1/2$ |
| 損失の有界性 | $P(z=m^2)=1/m^2$、それ以外は $z=0$、$\ell(h,z)=z$ | 単一の仮説の偏差。確率 $1-1/m$ 以上で $L_{\mathcal D}-L_S=1$ |
| 重みの和が 1 以下 | $w\equiv1$、$\mathbb N$ の有限部分集合のクラス | thm-slt-occam の上界。偏差は $1/2$ 以上なのに上界は $0$ へ |
| VC 次元が有限 | $\mathbb N$ の部分集合全体のクラス | thm-slt-fundamental の 2〜5。ERM の経験リスクが 0 でリスクが $1/2$ 以上 |
1 行目:$Y$ は公平な硬貨、$X$ は定数、$h\equiv1$ とする。$L_{\mathcal D}(h)=1/2$ だが、すべての $z_i$ が等しいと $L_S(h)\in\{0,1\}$ である。
2 行目:$\mathbb E z=1$ である。$m\ge2$ で全標本が $0$ となる確率は $(1-1/m^2)^m\ge1-1/m$ で、そのとき $L_S=0$ である。$m$ ごとに分布を選ぶので、分布によらない $m$ の評価はない。
3 行目:$\mathcal X=\mathbb N$、$\mathcal H$ を有限部分集合 $A$ の指示関数の全体(可算)、$\mathcal D$ を「$x$ が $\{1,\dots,2m\}$ の上で一様、$y\equiv1$」とする。$A=\{x_1,\dots,x_m\}$ なら $L_S(\mathbf 1_A)=0$、$L_{\mathcal D}(\mathbf 1_A)\ge1/2$ である。一方 $w\equiv1$ で式を形式的に書くと $\sqrt{\log(2/\delta)/(2m)}\to0$ となり、確率 1 で成り立たない。このとき $\sum_hw(h)=\infty$ である。
4 行目:$\mathcal X=\mathbb N$、$\mathcal H$ を部分集合の指示関数の全体とする(VC 次元は無限)。$\mathcal D$ を「$x$ が $\{1,\dots,2m\}$ の上で一様、$y\equiv1$」とすると、最良のリスクは $h\equiv1$ の $0$ である。標本の点を $1$、それ以外を $0$ と答える仮説は ERM の出力になり、経験リスクは $0$、リスクは $1/2$ 以上である。$m$ を増やしても、$m$ に合わせて分布を選べば同じことが起きる。4・5 が成り立たないことは thm-slt-nfl による(この $\mathcal H$ はどの $f$ も含む)。
よくある誤り
| 誤り | 正しくは | 根拠 |
|---|---|---|
| ERM の $L_S(h_S)$ は $L_{\mathcal D}(h_S)$ の不偏推定である | $h_S$ が $S$ に依存するので下に偏る | ex-slt-mean-gap |
| 単一の仮説の Hoeffding の評価をそのまま $h_S$ に使う | $h_S$ は $S$ と独立でない。一様な評価が要る | thm-slt-occam |
| 上界が大きいので学習に失敗する | 上界は最悪の分布向けで、実際はずっと小さいことがある | 例題 2 |
| 学習は分布によらずいつでもできる | クラスを制限しないと失敗する分布がある | thm-slt-nfl |
| 次数を上げるとリスクはいつも下がる | バリアンスが増える | 例題 4 |
| パラメータの数が複雑さを決める | VC 次元はパラメータの数と一致しないことがある | PAC学習 |
関連項目
- 前提: Hoeffdingの不等式, 確率空間, 独立性(確率論)
- 柱の記事: VC次元, PAC学習, Rademacher複雑度
- 道具: Sauer–Shelahの補題, McDiarmidの不等式, 経験過程
- 手法: ブースティング, サポートベクターマシン, カーネル法, Tikhonov正則化
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

