普遍近似定理
概要
普遍近似定理(universal approximation theorem)とは、隠れ層 1 つのニューラルネットワークが、ユニットの数を十分に増やせば、コンパクト集合の上の任意の連続関数をいくらでもよく一様に近似できるという定理の総称である。代表的な形では、活性化関数が連続で、正の無限大で 1、負の無限大で 0 に近づくとき、その 1 次式との合成の 1 次結合の全体が連続関数の空間で稠密になる。証明は Hahn–Banach の定理と測度による汎関数の表示を使う方法と、Stone–Weierstrass の定理と 1 変数の構成による方法があり、ReLU や双曲線正接にも広がるが、活性化関数が多項式なら成り立たない。
前提知識: Hahn–Banachの定理, Stone–Weierstrassの定理, Riesz–Markov–角谷の表現定理, ニューラルネットワーク
普遍近似定理(universal approximation theorem)は、隠れ層 1 つの ニューラルネットワーク が、ユニットの数さえ十分にあれば、コンパクト集合の上の任意の連続関数をいくらでもよく一様に近似できる、という定理の総称である。代表的な形は次のとおりである:$K\subset\mathbb{R}^d$ をコンパクト集合、$\sigma\colon\mathbb{R}\to\mathbb{R}$ を連続で $\sigma(t)\to1$($t\to+\infty$)、$\sigma(t)\to0$($t\to-\infty$)となる関数とすると、
$$
g(x)=\sum_{j=1}^N\alpha_j\,\sigma(w_j\cdot x+\theta_j)\qquad(N\ge1,\ \alpha_j,\theta_j\in\mathbb{R},\ w_j\in\mathbb{R}^d)
$$
の形の関数の全体は、最大値ノルム について $C(K)$ で 稠密 である。この形の定理は Cybenko(1989)に始まる(KL20 §1 は Cybenko、Hornik、Pinkus の文献を古典的な普遍近似定理の出典に挙げる)。
Weierstrassの近似定理 が多項式で、三角多項式が周期的な連続関数を一様に近似するのと同じく、この定理は「1 次式 $w\cdot x+\theta$ に 1 変数の関数 $\sigma$ を合成したもの(リッジ関数)の和」で近似できることを述べる。ただし主張は存在だけで、必要なユニット数 $N$ や、学習でそのパラメータが見つかるかについては何も言わない。
この記事では、Hahn–Banach の定理と測度による汎関数の表示を使う Cybenko 型の証明と、Stone–Weierstrass の定理と 1 変数の構成を組み合わせる構成的な証明の 2 つを与え、ReLU などへの拡張、1 変数での誤差の評価、仮定を外したときの反例を述べる。
定義
$K\subset\mathbb{R}^d$ をコンパクト集合とし、$C(K)$ を $K$ 上の実数値連続関数の全体に最大値ノルム $\|f\|_\infty:=\max_{x\in K}\lvert f(x)\rvert$ を入れた Banach空間 とする。
関数 $\sigma\colon\mathbb{R}\to\mathbb{R}$ が シグモイド型 であるとは、
$$
\lim_{t\to+\infty}\sigma(t)=1,\qquad\lim_{t\to-\infty}\sigma(t)=0
$$
となることをいう。連続とも単調とも仮定しない。
ロジスティック関数 $\varsigma(t)=1/(1+e^{-t})$、ReLU($\rho(t)=\max\{t,0\}$)から作る $\rho(t)-\rho(t-1)$($t\le0$ で $0$、$0\le t\le1$ で $t$、$t\ge1$ で $1$)、Heaviside関数 $H$(この記事では $t>0$ で $1$、$t\le0$ で $0$ とする)はシグモイド型である。最初の 2 つは連続、$H$ は連続でない。
関数 $\sigma\colon\mathbb{R}\to\mathbb{R}$ と $K\subset\mathbb{R}^d$ について、
$$
\mathcal{N}_\sigma(K):=\Bigl\{x\mapsto\sum_{j=1}^N\alpha_j\,\sigma(w_j\cdot x+\theta_j)\ \Big|\ N\ge1,\ \alpha_j,\theta_j\in\mathbb{R},\ w_j\in\mathbb{R}^d\Bigr\}
$$
(関数を $K$ に制限したもの)とおく。これは ニューラルネットワーク の定義「順伝播型ニューラルネットワーク」の構造 $(d,N,1)$、活性化関数 $\sigma$ で出力の偏りを $0$ としたネットワークの関数の全体であり、$\mathbb{R}$ 上の線形空間である。
$\sigma$ がシグモイド型なら、$\sigma(\theta)\ne0$ となる $\theta$ があり、定数関数 $\alpha\sigma(0\cdot x+\theta)$ は $\mathcal{N}_\sigma(K)$ に入る。したがって出力の偏りを許しても族は変わらない。
主定理
主定理(thm-uat-main)の証明のために 2 つの補題を用意する。1 つ目は指数関数による近似、2 つ目は「シグモイド型関数の積分が一致する 2 つの測度は、連続関数の積分も一致する」という主張である。
$K\subset\mathbb{R}^d$ をコンパクト集合とする。$\mathcal{E}:=\operatorname{span}\{x\mapsto e^{w\cdot x}\mid w\in\mathbb{R}^d\}$ は $C(K)$ で稠密である。
$e^{w\cdot x}e^{v\cdot x}=e^{(w+v)\cdot x}$ なので $\mathcal{E}$ は積で閉じ、実数上の関数の代数である。$w=0$ のとき定数関数 $1$ が入るので、どの点でも消えない。$x\ne y$ なら $w:=x-y$ について $w\cdot x-w\cdot y=\|x-y\|^2>0$、指数関数は単射なので $e^{w\cdot x}\ne e^{w\cdot y}$ であり、$\mathcal{E}$ は点を分離する。Stone–Weierstrassの定理 の定理「Stone–Weierstrassの定理(実数値)」により $\mathcal{E}$ は $C(K)$ で稠密である。$\square$
$\sigma$ を有界な Borel 可測のシグモイド型関数、$\mu_1,\mu_2$ を $K$ 上の有限な Borel 測度とし、すべての $w\in\mathbb{R}^d$、$\theta\in\mathbb{R}$ について
$$
\int_K\sigma(w\cdot x+\theta)\,d\mu_1(x)=\int_K\sigma(w\cdot x+\theta)\,d\mu_2(x)
$$
とする。このとき、すべての $g\in C(K)$ について $\int_Kg\,d\mu_1=\int_Kg\,d\mu_2$ である。
有限な符号付きの集合関数 $\nu(A):=\mu_1(A)-\mu_2(A)$ を使って書く。$M:=\sup\lvert\sigma\rvert<\infty$ とする。
段階 1(半空間):$w\in\mathbb{R}^d$、$\theta,\varphi\in\mathbb{R}$ を固定し、$\lambda>0$ について仮定を $w$ を $\lambda w$、$\theta$ を $\lambda\theta+\varphi$ に替えて使うと、$\int\sigma(\lambda(w\cdot x+\theta)+\varphi)\,d\mu_1=\int\sigma(\lambda(w\cdot x+\theta)+\varphi)\,d\mu_2$ である。$\lambda\to\infty$ のとき被積分関数は各点で
$$
\gamma(x)=\begin{cases}1&(w\cdot x+\theta>0)\\\sigma(\varphi)&(w\cdot x+\theta=0)\\0&(w\cdot x+\theta<0)\end{cases}
$$
に収束し、絶対値は $M$ 以下で、$\mu_i$ は有限なので、Lebesgueの優収束定理 により両辺の極限をとってよい。$\Pi^+:=\{x\in K:w\cdot x+\theta>0\}$、$\Pi^0:=\{x\in K:w\cdot x+\theta=0\}$ とおくと
$$
\nu(\Pi^+)+\sigma(\varphi)\,\nu(\Pi^0)=0
$$
がすべての $\varphi$ について成り立つ。$\nu(\Pi^+)$、$\nu(\Pi^0)$ は $\varphi$ によらないので、$\varphi\to-\infty$ とすると $\sigma(\varphi)\to0$ より $\nu(\Pi^+)=0$ である。$\theta=-a$ と書き直すと、すべての $w$ と $a\in\mathbb{R}$ について $\mu_1(\{x\in K:w\cdot x>a\})=\mu_2(\{x\in K:w\cdot x>a\})$ である。
段階 2(直線への押し出し):$w$ を固定し、$\pi(x):=w\cdot x$ による $\mathbb{R}$ 上の Borel 測度 $\tau_i(B):=\mu_i(\pi^{-1}(B)\cap K)$ を考える。段階 1 から $\tau_1((a,\infty))=\tau_2((a,\infty))$(すべての $a$)である。$a<\min_K\pi$ とすれば $\tau_1(\mathbb{R})=\tau_2(\mathbb{R})<\infty$ であり、$\tau_i((a,b])=\tau_i((a,\infty))-\tau_i((b,\infty))$ から半開区間の上でも一致する。半開区間(と空集合)の全体は共通部分で閉じた族(π 系)で、$\mathbb{R}$ の Borel 集合族を生成するので、Dynkinのπ-λ定理 の定理「π系の上で一致する測度の一意性」の 1 により $\tau_1=\tau_2$ である。
段階 3(指数関数):$\pi(K)$ はコンパクトなので $t\mapsto e^t$ は $\tau_i$ が載る集合の上で有界であり、像測度の積分の変数変換により
$$
\int_Ke^{w\cdot x}\,d\mu_1(x)=\int_{\mathbb{R}}e^t\,d\tau_1(t)=\int_{\mathbb{R}}e^t\,d\tau_2(t)=\int_Ke^{w\cdot x}\,d\mu_2(x)
$$
である。$w$ は任意なので、$\Lambda(g):=\int g\,d\mu_1-\int g\,d\mu_2$ は $\mathcal{E}$ の上で $0$ になる。$\lvert\Lambda(g)\rvert\le(\mu_1(K)+\mu_2(K))\|g\|_\infty$ なので $\Lambda$ は $C(K)$ 上の連続線形汎関数であり、lem-uat-exp により稠密な $\mathcal{E}$ の上で $0$ だから $C(K)$ 全体で $0$ である。$\square$
$K\subset\mathbb{R}^d$ をコンパクト集合、$\sigma$ を連続なシグモイド型関数とする。このとき $\mathcal{N}_\sigma(K)$ は $C(K)$ で稠密である。すなわち、任意の $f\in C(K)$ と $\varepsilon>0$ について、$N$ と $\alpha_j,\theta_j\in\mathbb{R}$、$w_j\in\mathbb{R}^d$ で
$$
\max_{x\in K}\Bigl\lvert f(x)-\sum_{j=1}^N\alpha_j\,\sigma(w_j\cdot x+\theta_j)\Bigr\rvert<\varepsilon
$$
となるものがある。
$\sigma$ は連続なので $\mathcal{N}_\sigma(K)\subset C(K)$ である。また $\sigma$ は連続で両側に有限の極限をもつので有界である。$\mathcal{N}_\sigma(K)$ が稠密でないとすると、Hahn–Banachの定理 の系「稠密性の判定」により、$\mathcal{N}_\sigma(K)$ の上で $0$ になる $0$ でない連続線形汎関数 $\Lambda\colon C(K)\to\mathbb{R}$ がある。$K$ はコンパクト距離空間なので、$\Lambda$ は 2 つの正値線形汎関数の差に書け(Bass24 Proposition 17.7)、Riesz–Markov–角谷の表現定理 により、有限な Borel 測度 $\mu_1,\mu_2$ で
$$
\Lambda(g)=\int_Kg\,d\mu_1-\int_Kg\,d\mu_2\qquad(g\in C(K))
$$
となるものがある(Bass24 Theorem 17.8)。$\Lambda$ は各 $x\mapsto\sigma(w\cdot x+\theta)$ で $0$ なので、$\mu_1,\mu_2$ は lem-uat-discriminatory の仮定を満たし、$\Lambda=0$ となって矛盾する。$\square$
lem-uat-discriminatory は $\sigma$ の連続性を使わない。連続性は、ネットワークの関数が $C(K)$ に入るためにだけ使った。
構成的な証明と誤差
Cybenko 型の証明は背理法で、近似するネットワークを与えない。1 変数の場合を手で作り、それを lem-uat-exp と組み合わせると、同じ定理の構成的な証明が得られる。
関数 $f\colon[a,b]\to\mathbb{R}$ の 連続の度合い を $\omega_f(h):=\sup\{\lvert f(s)-f(t)\rvert:s,t\in[a,b],\ \lvert s-t\rvert\le h\}$ と書く。$f$ が連続なら 一様連続 なので $\omega_f(h)\to0$($h\to0$)である。
$\sigma$ を連続なシグモイド型関数、$M:=\sup_t\lvert\sigma(t)\rvert$ とする。$f\in C([a,b])$、$N\ge1$、$h:=(b-a)/N$ とすると、$N+1$ 項の和 $g\in\mathcal{N}_\sigma([a,b])$ で
$$
\max_{a\le t\le b}\lvert f(t)-g(t)\rvert\le(M+3)\,\omega_f(h)
$$
となるものがある。具体的には、$t_k:=a+kh$、$s_k:=t_k-\frac h2$、$\Delta_k:=f(t_k)-f(t_{k-1})$ とし、$\lambda>0$ を十分大きくとって
$$
g(t)=f(a)+\sum_{k=1}^N\Delta_k\,\sigma\bigl(\lambda(t-s_k)\bigr)
$$
とすればよい(定数 $f(a)$ は $\sigma(\theta_0)\ne0$ となる $\theta_0$ により $\frac{f(a)}{\sigma(\theta_0)}\sigma(0\cdot t+\theta_0)$ と書く)。
$G(t):=f(a)+\sum_{k=1}^N\Delta_kH(t-s_k)$ とおく。$t\in[a,b]$ について、$s_k< t$ となる $k$ の個数を $j$ とすると $G(t)=f(a)+\sum_{k\le j}\Delta_k=f(t_j)$ で、$j$ の決め方から $\lvert t-t_j\rvert\le\frac h2$ である($s_j< t\le s_{j+1}$、ただし $s_0:=-\infty$、$s_{N+1}:=b$)。よって $\lvert f(t)-G(t)\rvert\le\omega_f(h)$ である。
次に $\eta(R):=\sup_{\lvert u\rvert\ge R}\lvert\sigma(u)-H(u)\rvert$ とおくと、$\sigma$ がシグモイド型なので $\eta(R)\to0$($R\to\infty$)である。$\delta:=h/4$ とし、$N\eta(\lambda\delta)\le1$ となる $\lambda$ をとる。$H(t-s_k)=H(\lambda(t-s_k))$ なので
$$
\lvert g(t)-G(t)\rvert\le\sum_{k=1}^N\lvert\Delta_k\rvert\,\bigl\lvert\sigma(\lambda(t-s_k))-H(\lambda(t-s_k))\bigr\rvert
$$
である。$\lvert\Delta_k\rvert\le\omega_f(h)$ で、$\lvert t-s_k\rvert\ge\delta$ となる項は $\omega_f(h)\eta(\lambda\delta)$ 以下である。$s_k$ どうしの間隔は $h>2\delta$ なので、$\lvert t-s_k\rvert<\delta$ となる $k$ は高々 1 つで、その項は $\omega_f(h)(M+1)$ 以下である。合わせて $\lvert g-G\rvert\le\omega_f(h)(N\eta(\lambda\delta)+M+1)\le\omega_f(h)(M+2)$ で、三角不等式から主張を得る。$\square$
証明を開く
$f\in C(K)$、$\varepsilon>0$ とする。lem-uat-exp により $\|f-\sum_{i=1}^rc_ie^{v_i\cdot x}\|_\infty< \varepsilon/2$ となる $c_i\in\mathbb{R}$、$v_i\in\mathbb{R}^d$ がある($c_i\ne0$ としてよい)。$I_i$ を $v_i\cdot x$($x\in K$)の値を含む有界閉区間とする($K$ はコンパクトなので取れる)。lem-uat-1d を $I_i$ 上の $e^t$ に、$\omega$ が十分小さくなる $N$ で使い、$\max_{t\in I_i}\lvert e^t-g_i(t)\rvert< \varepsilon/(2r\lvert c_i\rvert)$ となる $g_i(t)=\sum_j\alpha_{ij}\sigma(\lambda_{ij}t+\beta_{ij})$ を作る。$G(x):=\sum_ic_ig_i(v_i\cdot x)=\sum_{i,j}c_i\alpha_{ij}\,\sigma((\lambda_{ij}v_i)\cdot x+\beta_{ij})$ は $\mathcal{N}_\sigma(K)$ に属し、$\|\sum_ic_ie^{v_i\cdot x}-G\|_\infty\le\sum_i\lvert c_i\rvert\frac{\varepsilon}{2r\lvert c_i\rvert}=\frac\varepsilon2$ なので $\|f-G\|_\infty< \varepsilon$ である。$\square$
この証明は Hahn–Banach の定理も測度による表示も使わない。ただし $N$ の評価は、指数関数の 1 次結合で近似する段階に評価がないので得られない。入力が 1 次元なら、ReLU で次の明示的な評価がある。
$f\in C([a,b])$、$N\ge1$、$h:=(b-a)/N$、$t_k:=a+kh$ とする。点 $(t_k,f(t_k))$ を順に結ぶ折れ線 $g$($[a,b]$ の外へは両端の線分を延ばす)は、ユニット $N+1$ 個以下の $\mathcal{N}_\rho(\mathbb{R})$ の元であり、$\max_{[a,b]}\lvert f-g\rvert\le\omega_f(h)$ である。
$g$ の折れ目は $t_1,\dots,t_{N-1}$ の $N-1$ 個以下なので、ニューラルネットワーク の命題「1 変数の連続区分線形関数の表示」により $g$ は隠れ層 1 つ・ユニット $N$ 個以下の ReLU ネットワークで、出力の偏りの定数を $\rho(0\cdot t+1)$ の倍で書けば $\mathcal{N}_\rho(\mathbb{R})$ の $N+1$ 項以下の元である($N=1$ なら $g$ はアフィンで、傾き $s$ が $0$ なら定数 $f(a)\rho(0\cdot t+1)$、$s\ne0$ なら $p:=a-f(a)/s$ として $g(t)=s\rho(t-p)-s\rho(p-t)$ と 2 項以下で書ける)。$t\in[t_k,t_{k+1}]$ を $t=(1-s)t_k+st_{k+1}$($0\le s\le1$)と書くと $g(t)=(1-s)f(t_k)+sf(t_{k+1})$ なので
$$
\lvert f(t)-g(t)\rvert\le(1-s)\lvert f(t)-f(t_k)\rvert+s\lvert f(t)-f(t_{k+1})\rvert\le\omega_f(h)
$$
である。$\square$
ReLU などへの拡張
$K\subset\mathbb{R}^d$ をコンパクト集合とする。次の $\sigma$ について $\mathcal{N}_\sigma(K)$ は $C(K)$ で稠密である。
- ReLU $\rho$。
- $\tanh$。
- 連続で、$t\to\pm\infty$ で有限の極限 $A$、$B$ をもち、$A\ne B$ となる任意の $\sigma$。
証明を開く
3:$\tilde\sigma:=(\sigma-B)/(A-B)$ は連続なシグモイド型関数である。$A\ne B$ なので $\sigma$ は恒等的に $0$ ではなく、$\sigma(\theta_0)\ne0$ となる $\theta_0$ について定数 $1=\sigma(0\cdot x+\theta_0)/\sigma(\theta_0)$ は $\mathcal{N}_\sigma(K)$ に属する。よって $\tilde\sigma(w\cdot x+\theta)\in\mathcal{N}_\sigma(K)$ で、$\mathcal{N}_{\tilde\sigma}(K)\subset\mathcal{N}_\sigma(K)$ となり、thm-uat-main から稠密である。2 は 3 で $A=1$、$B=-1$ の場合である。1:$\tilde\rho(t):=\rho(t)-\rho(t-1)$ は連続なシグモイド型関数で、$\tilde\rho(w\cdot x+\theta)=\rho(w\cdot x+\theta)-\rho(w\cdot x+\theta-1)$ なので $\mathcal{N}_{\tilde\rho}(K)\subset\mathcal{N}_\rho(K)$ であり、thm-uat-main から稠密である。$\square$
活性化関数が多項式なら結論は成り立たない。
$\sigma$ を次数 $m$ の多項式、$K\subset\mathbb{R}^d$ を無限集合であるコンパクト集合とする。このとき $\mathcal{N}_\sigma(K)$ は $C(K)$ で稠密でない。
$\sigma(w\cdot x+\theta)$ は $x$ の $m$ 次以下の多項式なので、$\mathcal{N}_\sigma(K)$ は $m$ 次以下の多項式を $K$ に制限したものの全体 $\mathcal{P}_m$ に含まれ、$\mathcal{P}_m$ は有限次元である。有限次元の部分空間はノルム空間で閉じているので、$\overline{\mathcal{N}_\sigma(K)}\subset\mathcal{P}_m$ である。一方 $K$ は無限集合なので、$\dim\mathcal{P}_m$ より多い相異なる点 $p_1,\dots,p_q\in K$ がとれる。$\eta>0$ を点どうしの距離の最小値の半分とし、$\phi_i(x):=\max\{0,1-\|x-p_i\|/\eta\}$ とおくと、$\phi_i\in C(K)$ で $\phi_i(p_k)=\delta_{ik}$ なので $\phi_1,\dots,\phi_q$ は 1 次独立である。よって $C(K)$ の次元は $\dim\mathcal{P}_m$ より大きく、$\overline{\mathcal{N}_\sigma(K)}\ne C(K)$ である。$\square$
逆に、$\sigma$ が連続で多項式でなければ、$\mathcal{N}_\sigma(K)$ はコンパクト集合 $K$ の上で稠密である。KL20 Theorem 1.1 は、この主張を Cybenko、Hornik、Pinkus の文献を挙げて古典的な普遍近似定理として述べている(この記事では証明しない)。たとえば $\sigma(t)=e^t$ はシグモイド型でも多項式でもないが、$e^{w\cdot x+\theta}=e^\theta e^{w\cdot x}$ なので $\mathcal{N}_\sigma(K)$ は lem-uat-exp の $\mathcal{E}$ そのものであり、稠密である。
例
$f(t)=t^2$、$[a,b]=[0,1]$、$N=10$ とする。区間 $[\frac k{10},\frac{k+1}{10}]$ での折れ線の傾きは $\frac{(k+1)^2-k^2}{10}=\frac{2k+1}{10}$ なので、ニューラルネットワーク の命題「1 変数の連続区分線形関数の表示」から
$$
g(t)=0.1\,\rho(t)+\sum_{k=1}^{9}0.2\,\rho\bigl(t-\tfrac k{10}\bigr)
$$
である(ユニット 10 個)。$[t_k,t_k+h]$ の上で $g(t)-t^2=(t-t_k)(t_k+h-t)$ なので、誤差の最大は区間の中点での $\frac{h^2}4=0.0025$ である。prop-uat-relu-1d の一般の上界 $\omega_f(0.1)=1-0.81=0.19$ より 2 桁小さい。
$f(t)=t^2$ を $[0,1]$ で、$\sigma=\varsigma$(ロジスティック関数、$M=1$)、$N=20$ として lem-uat-1d の構成に当てはめる。$h=0.05$、$\delta=h/4=0.0125$ で、$\eta(R)=\varsigma(-R)=1/(1+e^R)$ なので $N\eta(\lambda\delta)\le1$ は $e^{\lambda\delta}\ge19$、すなわち $\lambda\ge\ln19/0.0125\approx235.6$ である。$\lambda=236$ とすると、上界は $(M+3)\,\omega_f(0.05)=4\times0.0975=0.39$ である。実際の誤差の最大は数値計算で約 $0.0214$ で、階段関数 $G$ の誤差 $\omega_f(h/2)=0.049375$ より小さい($g$ は段差をなめらかにつなぐので)。
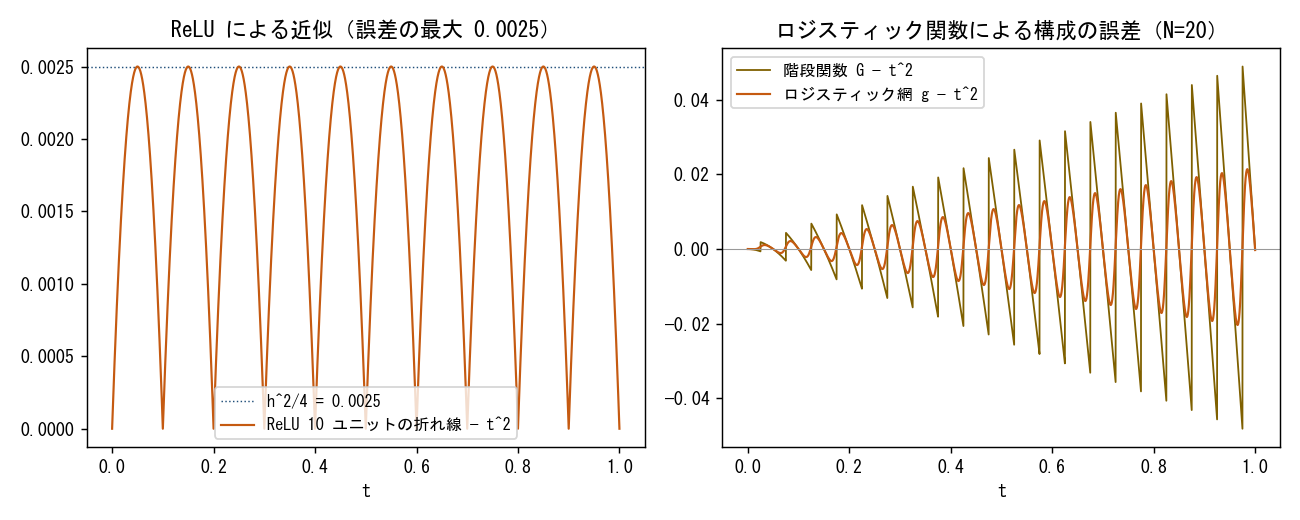 図: 左は区間 0 から 1 で、ReLU 10 ユニットの折れ線から t の 2 乗を引いた差のグラフで、10 個の山がどれも高さ 0.0025 に達する。右は同じ区間で、階段関数から t の 2 乗を引いた差(のこぎり状で振れ幅が右へ行くほど大きく、最大約 0.049)と、ロジスティック関数のネットワークから t の 2 乗を引いた差(なめらかに振動し、最大約 0.021)のグラフ。
$x_1x_2=\frac14\bigl((x_1+x_2)^2-(x_1-x_2)^2\bigr)$ は、1 次式 $x_1+x_2$、$x_1-x_2$ に 1 変数の関数を合成したもの(リッジ関数)の和である。$[0,1]^2$ の上では $u=x_1+x_2\in[0,2]$、$v=x_1-x_2\in[-1,1]$ で、それぞれの区間を $N=10$ 等分して $u^2$、$v^2$ を折れ線 $g_+$、$g_-$ で近似する(刻み $h=0.2$、誤差は ex-uat-relu-square と同じ計算で $\frac{h^2}4=0.01$ 以下)。$G(x)=\frac14\bigl(g_+(x_1+x_2)-g_-(x_1-x_2)\bigr)$ は $\rho(\pm x_1\pm x_2+c)$ の形の項の和で、ユニット 22 個以下の $\mathcal{N}_\rho([0,1]^2)$ の元であり、$\max\lvert x_1x_2-G\rvert\le\frac14(0.01+0.01)=0.005$ である(実際の最大は $0.0025$)。prf-uat-constructive は、指数関数を使って同じことを一般の連続関数で行う。
仮定を外したときの反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| $K$ がコンパクト | $K=\mathbb{R}$、$f(t)=\sin t$、$\sigma=\varsigma$ | どの $g\in\mathcal{N}_\varsigma(\mathbb{R})$ も $\sup\lvert f-g\rvert\ge1$ |
| 近似する関数が連続 | $[-1,1]$ 上の符号関数 $\operatorname{sgn}$ | 連続関数 $g$ はどれも $\sup\lvert\operatorname{sgn}-g\rvert\ge1$ |
| $\sigma$ がシグモイド型 | $\sigma(t)=t^2$、$K=[-1,1]$ | $\mathcal{N}_\sigma(K)$ は 2 次以下の多項式で、$x^3$ との距離は $\frac14$ 以上 |
| ユニットの数 $N$ に上限がない | $N=1$ に限る、$\sigma=\varsigma$、$K=[-1,1]$、$f(x)=x^2$ | $\sup\lvert f-g\rvert\ge\frac12$ |
確かめを開く
1 行目:$g=\sum\alpha_j\varsigma(w_jt+\theta_j)$ の各項は $t\to+\infty$ で極限($w_j>0$ なら $\alpha_j$、$w_j< 0$ なら $0$、$w_j=0$ なら $\alpha_j\varsigma(\theta_j)$)をもつので、$g(t)\to c$ となる $c$ がある。$\sin t=1$ となる $t$ と $\sin t=-1$ となる $t$ はいくらでも大きくとれるので、$\sup\lvert\sin-g\rvert\ge\max\{\lvert1-c\rvert,\lvert1+c\rvert\}\ge1$ である。2 行目:$\varepsilon:=\sup\lvert\operatorname{sgn}-g\rvert$ とすると、$t>0$ で $g(t)\ge1-\varepsilon$、$t< 0$ で $g(t)\le-1+\varepsilon$ で、$t\to0$ として $1-\varepsilon\le g(0)\le-1+\varepsilon$、よって $\varepsilon\ge1$ である。ネットワークの関数はすべて連続なので、近似の誤差は $1$ 未満にならない。3 行目:prop-uat-poly の場合で、$a_0+a_1x+a_2x^2$ について $x=\pm1,\pm\frac12$ での値を比べる。$p(x):=x^3-(a_0+a_1x+a_2x^2)$ とおくと $p(1)-p(-1)-2\bigl(p(\frac12)-p(-\frac12)\bigr)=2-\frac12-2a_1+2a_1=\frac32$ なので、$\lvert p\rvert$ の最大を $\varepsilon$ とすれば $6\varepsilon\ge\frac32$、$\varepsilon\ge\frac14$ である。4 行目:$\varsigma$ は単調増加なので $g(x)=\alpha\varsigma(wx+\theta)$ は単調である。単調非減少なら $g(-1)\le g(0)$ で、$\varepsilon:=\sup\lvert x^2-g\rvert$ について $1-\varepsilon\le g(-1)\le g(0)\le\varepsilon$ から $\varepsilon\ge\frac12$。単調非増加なら $g(0)\ge g(1)$ を使って同様である。
4 行目の $N=1$ の制限は深さを増やしても解消しない:幅 1 の層を何段重ねても、単調な関数の合成は単調だからである。これと対照的に、層の数を制限しなければ、幅を入力と出力の次元の和 $+2$ に固定しても稠密になる($\sigma$ が連続でアフィンでなく、ある 1 点で連続微分可能で微分係数が $0$ でないとき。KL20 Theorem 3.2。この記事では証明しない)。
補足
出力が多次元の場合:$f\colon K\to\mathbb{R}^m$ は成分ごとに近似すればよく、出力の層を $m$ 次元にしたネットワーク(隠れ層は各成分のユニットを並べたもの)で一様に近似できる。
ユニット数:定理は $N$ の評価を与えない。入力の次元 $n$ についての増え方は避けられず、ロジスティック関数のネットワークで $[-1,1]^n$ から $[-1,1]$ へのすべての 1-Lipschitz 関数を、固定した精度 $\varepsilon\in(0,1)$ で近似できる構造は、頂点(入力・ユニット・出力)の数が $n$ について指数的でなければならない(SSBD14 Theorem 20.5、p. 273。この記事では証明しない)。
厳密な表示:近似ではなく等式で多変数の連続関数を 1 変数の関数と和で書く定理として Kolmogorov–Arnoldの表現定理 がある。そこでは内側の関数の族を $f$ によらずに固定でき、$f$ に依存するのは外側の $2n+1$ 個の 1 変数関数だけである。
学習との関係:定理が保証するのは近似するパラメータの存在である。データからパラメータを選ぶ手順は 誤差逆伝播法 と 確率的勾配降下法 を、表せる関数の構造は ニューラルネットワーク を見よ。
関連項目
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

