標本平均の分散
概要
標本平均の分散(variance of the sample mean)とは、確率変数 $X_1,\dots,X_n$ の平均 $\bar X=\frac1n(X_1+\cdots+X_n)$ の分散であり、どの 2 つも無相関(特に独立)で同じ期待値 $\mu$ と分散 $\sigma^2$ をもつなら $E[\bar X]=\mu$、$V(\bar X)=\frac{\sigma^2}n$ が成り立つ。証明には和の分散の公式 $V(X+Y)=V(X)+V(Y)+2\mathrm{Cov}(X,Y)$ と $V(cX)=c^2V(X)$ を使う。平均の標準偏差は $\frac{\sigma}{\sqrt n}$ でしか減らないので、精度を 2 倍にするには回数を 4 倍にする必要がある。無相関の仮定を外すと分散は減らず、分散をもたない Cauchy 分布では平均しても広がりが変わらない。
高校での出発点:平均をとるとばらつきが減る
同じ実験を何回か独立にくり返して結果を平均すると、1 回だけの結果より真の値に近くなりやすい。この「近くなりやすさ」を分散で測る。確率変数 $X$ の期待値を $E[X]$、分散を $V(X)=E[(X-E[X])^2]$ と書く。$V(X)=E[X^2]-(E[X])^2$ でも計算できる(平均値と二乗誤差)。
表なら $1$、裏なら $0$ をとる確率変数を $X_1,X_2$ とし、2 枚の公正な硬貨を独立に投げる。1 枚について $E[X_i]=\frac12$、$V(X_i)=\frac12\cdot\bigl(\frac12\bigr)^2+\frac12\cdot\bigl(\frac12\bigr)^2=\frac14$ である。
平均 $M=\frac{X_1+X_2}2$ は、$0,\frac12,1$ をそれぞれ確率 $\frac14,\frac12,\frac14$ でとる。
- $E[M]=0\cdot\frac14+\frac12\cdot\frac12+1\cdot\frac14=\frac12$。
- $E[M^2]=0+\frac14\cdot\frac12+1\cdot\frac14=\frac38$ なので、$V(M)=\frac38-\frac14=\frac18$。
1 枚の分散 $\frac14$ の半分になった。
公正なさいころの目 $X$ は $E[X]=\frac72$、$V(X)=\frac{35}{12}$ である。2 個を独立に振り、目の平均 $M$ の分布を 36 通りから数えると次のようになる(確率は $\frac1{36}$ を単位とする)。
| $M$ | 1 | 1.5 | 2 | 2.5 | 3 | 3.5 | 4 | 4.5 | 5 | 5.5 | 6 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 確率 $\times36$ | 1 | 2 | 3 | 4 | 5 | 6 | 5 | 4 | 3 | 2 | 1 |
| $(M-3.5)^2$ | 6.25 | 4 | 2.25 | 1 | 0.25 | 0 | 0.25 | 1 | 2.25 | 4 | 6.25 |
$E[M]=\frac72$ で、分散は左右対称に組にして
$$
V(M)=\frac{2(6.25\cdot1+4\cdot2+2.25\cdot3+1\cdot4+0.25\cdot5)}{36}=\frac{2\cdot26.25}{36}=\frac{35}{24}
$$
である。これも 1 個の分散 $\frac{35}{12}$ の半分である。
ここで次の問いが生じる。
- $n$ 個の平均をとると、分散はいつも $\frac1n$ 倍になるのか。→ thm-vsm-main
- 「独立に」という条件は、どこで何のために使うのか。→ lem-vsm-sum、ex-vsm-same
- 平均をとってもばらつきが減らない例はあるか。→ ex-vsm-same、ex-vsm-cauchy
高校の計算 この記事の言葉 大学の言葉 2 つの確率変数の関係の強さ 共分散 $\mathrm{Cov}(X,Y)$ 確率変数の内積 独立なら $V(X+Y)=V(X)+V(Y)$ 無相関なら分散が足し算になる 直交するベクトルのピタゴラスの定理 標本平均の分散 $\frac{\sigma^2}n$ thm-vsm-main 直交する $n$ 本の和の長さ 標準偏差 $\frac{\sigma}{\sqrt n}$ 精度を 2 倍にするには 4 倍の回数 $\sqrt n$ の法則
共分散と無相関
以下、確率変数はすべて $E[X^2]$ が有限であるとする(値が有限個ならつねにそうである)。
確率変数 $X,Y$ に対して
$$
\mathrm{Cov}(X,Y):=E\bigl[(X-E[X])(Y-E[Y])\bigr]
$$
を $X$ と $Y$ の共分散という。$\mathrm{Cov}(X,Y)=0$ のとき、$X$ と $Y$ は無相関であるという。
確率変数 $X,Y,Z$ と実数 $c,d$ について、次が成り立つ。
(1) $\mathrm{Cov}(X,X)=V(X)$。
(2) $\mathrm{Cov}(X,Y)=\mathrm{Cov}(Y,X)$。
(3) $\mathrm{Cov}(X,Y)=E[XY]-E[X]E[Y]$。
(4) $\mathrm{Cov}(cX+Z+d,\ Y)=c\,\mathrm{Cov}(X,Y)+\mathrm{Cov}(Z,Y)$。
$\mu:=E[X]$、$\nu:=E[Y]$、$\lambda:=E[Z]$ とおく。
(1) 定義で $Y=X$ とおくと $E[(X-\mu)^2]$ で、これは分散の定義である。
(2) 掛け算の順序を入れ替えても積は変わらないので、定義の式は $X$ と $Y$ について対称である。
(3) 積を展開すると $(X-\mu)(Y-\nu)=XY-\nu X-\mu Y+\mu\nu$ である。期待値の線形性により期待値をとると $E[XY]-\nu\mu-\mu\nu+\mu\nu=E[XY]-\mu\nu$ である。
(4) $W:=cX+Z+d$ とおくと、線形性により $E[W]=c\mu+\lambda+d$ で、$W-E[W]=c(X-\mu)+(Z-\lambda)$ である(定数 $d$ は打ち消し合う)。よって
$$
\mathrm{Cov}(W,Y)=E\bigl[\bigl(c(X-\mu)+(Z-\lambda)\bigr)(Y-\nu)\bigr]=c\,E[(X-\mu)(Y-\nu)]+E[(Z-\lambda)(Y-\nu)]
$$
であり、右辺は $c\,\mathrm{Cov}(X,Y)+\mathrm{Cov}(Z,Y)$ である。$\square$
- と (4) を合わせると、右側の変数についても同じ計算ができる。共分散は、ベクトルの内積と同じ性質(対称性と線形性)をもつ。
$X$ を公正な硬貨(表 $1$、裏 $0$)とする。$V(X)=\frac14$ である。
- $\mathrm{Cov}(X,X)=V(X)=\frac14$。
- $\mathrm{Cov}(1-X,X)$:(4) で $c=-1$、$Z=0$、$d=1$ とすると $-\mathrm{Cov}(X,X)=-\frac14$。直接でも、$X(1-X)$ はつねに $0$ なので $E[X(1-X)]-E[X]E[1-X]=0-\frac12\cdot\frac12=-\frac14$。
- 独立な 2 枚 $X,Y$:$XY=1$ となるのは 2 枚とも表のときで確率 $\frac14$ なので、$E[XY]=\frac14$ である。(3) より $\mathrm{Cov}(X,Y)=\frac14-\frac12\cdot\frac12=0$。
最後の例のように、独立な確率変数は無相関である。
$X,Y$ が独立ならば $E[XY]=E[X]E[Y]$ であり、したがって $\mathrm{Cov}(X,Y)=0$ である。
$X$ のとる値を $v_1,\dots,v_k$、$Y$ のとる値を $w_1,\dots,w_l$ とする。$XY$ の期待値は、組 $(X,Y)=(v_j,w_m)$ ごとに値 $v_jw_m$ と確率を掛けて足したものである。独立性により $P(X=v_j,\,Y=w_m)=P(X=v_j)P(Y=w_m)$ なので
$$
E[XY]=\sum_{j=1}^k\sum_{m=1}^lv_jw_m\,P(X=v_j)P(Y=w_m)=\Bigl(\sum_{j=1}^kv_jP(X=v_j)\Bigr)\Bigl(\sum_{m=1}^lw_mP(Y=w_m)\Bigr)=E[X]E[Y]
$$
である(2 重の和を、$j$ だけの和と $m$ だけの和の積に分けた)。prop-vsm-cov-properties の (3) から $\mathrm{Cov}(X,Y)=0$ である。値が無限個の場合や密度関数をもつ場合も結論は同じであるが、ここでは証明しない(GS06 Theorem 6.4、Theorem 6.12)。$\square$
逆は成り立たない(ex-vsm-uncorrelated-dependent)。
確率変数 $X,Y$ と実数 $c$ について
$$
V(X+Y)=V(X)+V(Y)+2\,\mathrm{Cov}(X,Y),\qquad V(cX)=c^2V(X)
$$
が成り立つ。さらに $n$ 個の確率変数について
$$
V(X_1+\cdots+X_n)=\sum_{i=1}^nV(X_i)+2\sum_{i< j}\mathrm{Cov}(X_i,X_j)
$$
が成り立つ。
段 1。prop-vsm-cov-properties の (1) により $V(X+Y)=\mathrm{Cov}(X+Y,X+Y)$ である。(4) で左側を分けると $\mathrm{Cov}(X,X+Y)+\mathrm{Cov}(Y,X+Y)$、さらに (2) と (4) で右側も分けると
$$
\mathrm{Cov}(X,X)+\mathrm{Cov}(X,Y)+\mathrm{Cov}(Y,X)+\mathrm{Cov}(Y,Y)=V(X)+2\,\mathrm{Cov}(X,Y)+V(Y)
$$
である。
段 2。同じく $V(cX)=\mathrm{Cov}(cX,cX)=c\cdot c\,\mathrm{Cov}(X,X)=c^2V(X)$ である。
段 3($n$ 個)。$n$ についての数学的帰納法で示す。$n=1$ では両辺とも $V(X_1)$ である。$n-1$ 個で成り立つとし、$S:=X_1+\cdots+X_{n-1}$ とおく。段 1 により
$$
V(S+X_n)=V(S)+V(X_n)+2\,\mathrm{Cov}(S,X_n)
$$
である。(4) をくり返し使うと $\mathrm{Cov}(S,X_n)=\sum_{i=1}^{n-1}\mathrm{Cov}(X_i,X_n)$ である。$V(S)$ に帰納法の仮定を使えば、$i< j\le n-1$ の組と $j=n$ の組を合わせて主張の式になる。$\square$
さいころの目 $X$($V(X)=\frac{35}{12}$)について 3 つの場合を比べる。
- 独立なもう 1 個 $Y$ と足す:$\mathrm{Cov}=0$ なので $V(X+Y)=\frac{35}{12}+\frac{35}{12}=\frac{35}6$。
- 同じ $X$ と足す:$V(X+X)=V(2X)=4\cdot\frac{35}{12}=\frac{35}3$。補題の式でも $\frac{35}{12}+\frac{35}{12}+2\cdot\frac{35}{12}=\frac{35}3$。
- 裏の目 $7-X$ と足す:$X+(7-X)=7$ は定数なので分散は $0$。補題の式でも $\mathrm{Cov}(X,7-X)=-\frac{35}{12}$ から $\frac{35}{12}+\frac{35}{12}-2\cdot\frac{35}{12}=0$。
主定理:標本平均の分散
確率変数 $X_1,\dots,X_n$ が、どの 2 つも無相関(特に、独立)で、同じ期待値 $\mu$ と同じ分散 $\sigma^2$ をもつとする。標本平均 $\bar X:=\frac1n(X_1+\cdots+X_n)$ について
$$
E[\bar X]=\mu,\qquad V(\bar X)=\frac{\sigma^2}n
$$
が成り立つ。したがって $\bar X$ の標準偏差は $\frac{\sigma}{\sqrt n}$ である。
方針:まず和 $X_1+\cdots+X_n$ の分散を lem-vsm-sum で求め、次に $\frac1n$ 倍する。
段 1(期待値)。期待値の線形性により $E[X_1+\cdots+X_n]=n\mu$ なので、$E[\bar X]=\frac1n\cdot n\mu=\mu$ である。
段 2(和の分散)。lem-vsm-sum により
$$
V(X_1+\cdots+X_n)=\sum_{i=1}^nV(X_i)+2\sum_{i< j}\mathrm{Cov}(X_i,X_j)
$$
である。仮定により $V(X_i)=\sigma^2$ で、$i\ne j$ なら $\mathrm{Cov}(X_i,X_j)=0$ である(独立なら prop-vsm-independent による)。よって右辺は $n\sigma^2$ である。
段 3($\frac1n$ 倍)。lem-vsm-sum の $V(cX)=c^2V(X)$ を $c=\frac1n$ として使うと
$$
V(\bar X)=\frac1{n^2}V(X_1+\cdots+X_n)=\frac1{n^2}\cdot n\sigma^2=\frac{\sigma^2}n
$$
である。標準偏差はその正の平方根 $\frac{\sigma}{\sqrt n}$ である。$\square$
この結果と Chebyshev の不等式から大数の法則を導く話は 大数の法則とさいころの平均 で扱う。
独立な場合の同じ結果は GS06 Theorem 6.9 にもある。この定理では独立性の全部は使わず、「どの 2 つも無相関」だけを使っている。
さいころ($\sigma^2=\frac{35}{12}$)を独立に $n$ 個振った目の平均について、定理は $V(\bar X)=\frac{35}{12n}$ を主張する。
- $n=2$:$\frac{35}{24}$。ex-vsm-dice2 で 36 通りを数えた値と一致する。
- $n=3$:$\frac{35}{36}$。216 通りを数え上げても同じ値になる。
- $n=4$:$\frac{35}{48}$、標準偏差は $\sqrt{35/48}=0.85\ldots$ で、1 個のときの $\sqrt{35/12}=1.70\ldots$(約 $1.71$)のちょうど半分である。
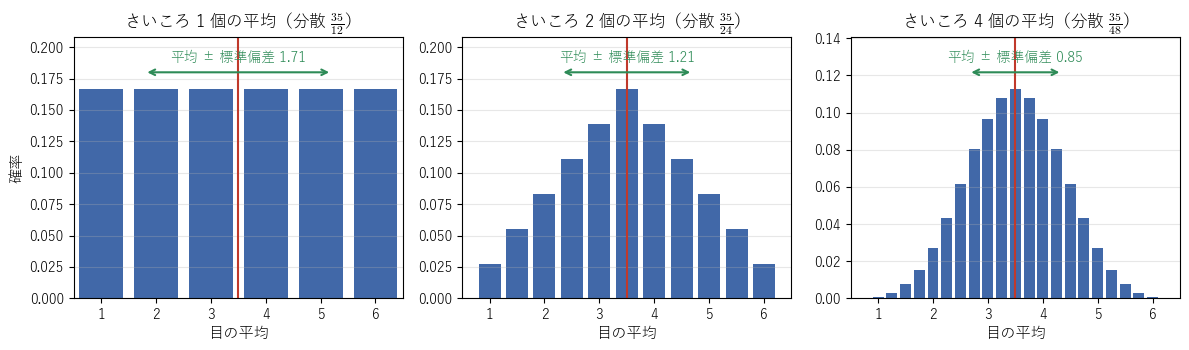 さいころ 1 個・2 個・4 個の目の平均の分布。個数を増やすと分布は平均 3.5 のまわりに集まり、標準偏差はおよそ 1.71、1.21、0.85 と小さくなる。
1 回の測定の誤差の標準偏差が $\sigma=10$ の測定器で、独立に $n$ 回測って平均する。
- $n=25$:平均の標準偏差は $\frac{10}{\sqrt{25}}=2$。
- $n=100$:$\frac{10}{\sqrt{100}}=1$。
標準偏差を半分にするには、回数を 4 倍にしなければならない。$\frac{\sigma}n$ ではなく $\frac{\sigma}{\sqrt n}$ でしか減らないからである。
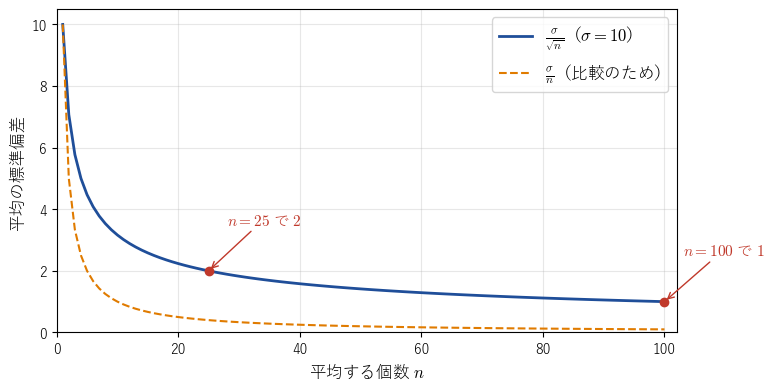 平均の標準偏差 σ/√n(σ = 10)。n = 25 で 2、n = 100 で 1。比較のため σ/n も破線で示した。
共分散を内積、標準偏差を長さとみると、lem-vsm-sum は $\|\boldsymbol a+\boldsymbol b\|^2=\|\boldsymbol a\|^2+\|\boldsymbol b\|^2+2\langle\boldsymbol a,\boldsymbol b\rangle$ に当たり、無相関は直交に当たる(相関係数(高校数学) の記事のデータのベクトルと同じ見方)。互いに直交する長さ $\sigma$ のベクトルを $n$ 本足すと、ピタゴラスの定理により長さの 2 乗は $n\sigma^2$、長さは $\sqrt n\,\sigma$ である。同じ向きのベクトルを $n$ 本足せば長さは $n\sigma$ になるのと比べて、直交するベクトルの和は短い。$n$ で割ると $\frac{\sigma}{\sqrt n}$ で、これが平均をとるとばらつきが減る理由である。
例と反例
| 外した仮定 | 崩れる主張 | ボックス |
|---|---|---|
| どの 2 つも無相関(正の相関がある) | $V(\bar X)=\frac{\sigma^2}n$ | ex-vsm-same |
| どの 2 つも無相関(負の相関がある) | $V(\bar X)=\frac{\sigma^2}n$ | ex-vsm-antithetic |
| 分散が有限 | 平均をとるとばらつきが減る | ex-vsm-cauchy |
| (逆向きの主張) | 無相関ならば独立 | ex-vsm-uncorrelated-dependent |
$X$ を分散 $\sigma^2>0$ の確率変数とし、$X_1=X_2=\cdots=X_n=X$ とする。どれも期待値と分散は同じだが、$\mathrm{Cov}(X_i,X_j)=\sigma^2\ne0$ で無相関ではない。このとき $\bar X=X$ なので $V(\bar X)=\sigma^2$ であり、$\frac{\sigma^2}n$ にはならない。同じ測定器の同じ癖を $n$ 回拾っても、精度は上がらない。
さいころの目 $X$ と、その裏の目 $X_2:=7-X$ を考える。どちらも期待値 $\frac72$、分散 $\frac{35}{12}$ である。$\mathrm{Cov}(X,7-X)=-\frac{35}{12}$(ex-vsm-sum)で、無相関ではない。平均 $\frac{X+(7-X)}2=\frac72$ はつねに一定なので、分散は $0$ であり、定理の $\frac{35}{24}$ より小さい。無相関の仮定を外すと、分散は $\frac{\sigma^2}n$ より大きくも小さくもなりうる。
$X$ が $-1,0,1$ を確率 $\frac13$ ずつとり、$Y:=X^2$ とする。$E[X]=0$、$E[XY]=E[X^3]=\frac{-1+0+1}3=0$ なので、$\mathrm{Cov}(X,Y)=0-0\cdot E[Y]=0$ で無相関である。しかし $P(X=0,\,Y=0)=\frac13$ に対し $P(X=0)P(Y=0)=\frac13\cdot\frac13=\frac19$ なので、独立ではない。prop-vsm-independent の逆「無相関ならば独立」はこの例で破れる。thm-vsm-main は独立性ではなく無相関だけを仮定しているので、独立でない確率変数の組でも、どの 2 つも無相関で期待値と分散がそろっていれば使える(この $X,Y$ は期待値も分散も違うので、定理の仮定は満たさない)。
さらに先へ
- $V(\bar X)=\frac{\sigma^2}n\to0$ と Chebyshev の不等式を合わせると、$\bar X$ が $\mu$ の近くに集中するという大数の弱法則が得られる(大数の法則)。
- $\frac{\bar X-\mu}{\sigma/\sqrt n}$ の分布が標準正規分布に近づくことが中心極限定理である(ここでは証明しない)。
- データから $\sigma^2$ を推定するときは、偏差の 2 乗の和を $n$ ではなく $n-1$ で割る不偏分散が使われる(分散)。
関連項目
- 案内: 平均・中央値・分散
- 前提: 確率変数, 期待値, 分散, 独立性(確率論)
- 前に読む: 期待値の線形性と数え上げ
- 次に読む: 大数の法則とさいころの平均, 区間推定(高校数学)
- 関連(高校数学): 二項分布から正規分布へ
- 発展: 大数の法則, 中心極限定理
- 比較: 平均値と二乗誤差, 相関係数(高校数学)
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

