Kolmogorov–Smirnov検定
概要
Kolmogorov–Smirnov検定(Kolmogorov–Smirnov test)とは、独立で同じ分布に従うデータの経験分布関数と、前もって完全に決めた分布関数 $F_0$ との縦の差の最大値 $D_n$ を統計量にして、データが $F_0$ に従うかを確かめる検定である。経験分布関数は真の分布関数に一様に近づく(Glivenko–Cantelli の定理)ので、仮説が誤りなら $D_n$ は正の値に近づき、標本が大きければ見分けられる。$F_0$ が連続なら分位点変換によって $D_n$ の分布は $F_0$ によらず、$\sqrt n D_n$ は Kolmogorov 分布に近づくので、1 つの数表で検定できる。$F_0$ が不連続なら検定は保守的になり、母数をデータから推定すると数表は使えない。
ある機械の部品の寿命を 10 個測り、寿命が平均 1 の 指数分布 に従うという仮説を確かめたいとする。平均や分散だけを比べるのでは、分布の形の違いを見落とす。そこで、データから作った 経験分布関数($x$ 以下のデータの割合)を、仮説の分布関数と丸ごと比べ、両者の縦の差の最大値を測る。この最大値が Kolmogorov–Smirnov 統計量 であり、それが大きすぎるときに仮説を棄てるのが Kolmogorov–Smirnov 検定(KS 検定)である。
この検定の要点は、仮説の分布関数が連続なら、統計量の分布が その分布関数によらない ことである。正規分布の検定にも指数分布の検定にも同じ数表が使える。この記事では、経験分布関数が真の分布関数に一様に近づくこと(Glivenko–Cantelli の定理)と、統計量の分布が連続な分布関数によらないこと(主定理)を証明する。不連続な分布関数では検定が保守的になることも同じ証明から従う。統計量の極限分布(Kolmogorov 分布)は主張と出典を示し、計算の公式・例題・反例で使い方を示す。
定義と使える条件
$X_1,\dots,X_n$ を実数値の確率変数とする。
$$
F_n(x):=\frac1n\#\{i\le n\mid X_i\le x\}\qquad(x\in\mathbb R)
$$
を $X_1,\dots,X_n$ の 経験分布関数(empirical distribution function)という。$F_n$ はデータの各点で高さ $\frac1n$ ずつ(同じ値が $m$ 個あれば $\frac mn$)跳ぶ右連続の階段関数である。
- 1 標本の検定:分布関数 $F_0$ を 1 つ定め、帰無仮説を「$X_1,\dots,X_n$ は独立で、どれも分布関数 $F_0$ に従う」とする。
$$ D_n:=\sup_{x\in\mathbb R}\lvert F_n(x)-F_0(x)\rvert $$
を Kolmogorov–Smirnov 統計量 といい、$\sqrt nD_n>c$ のとき帰無仮説を棄てる検定を Kolmogorov–Smirnov 検定という。$c$ は有意水準 $\alpha$ に対して帰無仮説のもとで $P(\sqrt nD_n>c)\le\alpha$ となるように選ぶ。 - 2 標本の検定:$X_1,\dots,X_m$ と $Y_1,\dots,Y_n$ の経験分布関数を $F_m$、$G_n$ とし、帰無仮説を「$m+n$ 個はすべて独立で、同じ分布関数に従う」とする。
$$ D_{m,n}:=\sup_{x\in\mathbb R}\lvert F_m(x)-G_n(x)\rvert $$
が大きいとき帰無仮説を棄てる。
KS 検定を使ってよい条件は次のとおりである。
- (i) データは独立で同じ分布に従う。
- (ii) $F_0$ は連続である(2 標本では共通の分布関数が連続)。
- (iii) $F_0$ はデータを見る前に完全に決まっている(母数をデータから推定しない)。
- (iv) 漸近の臨界値(thm-ks-limit)を使うときは $n$ が大きい。小さい $n$ では正確な分布を使う。
(ii) がないと統計量の分布が $F_0$ に依存し、決まった数表は使えない。それでも検定は保守的で、棄却の確率は $\alpha$ 以下に収まる(thm-ks-free の 1)。(iii) を外すと、実際の有意水準が名目より大きく下がる(反例の表)。
公式の表
| 量 | 式 | 使える条件 | 根拠 |
|---|---|---|---|
| 経験分布関数の一様収束 | $\sup_x\lvert F_n(x)-F(x)\rvert\to0$(確率 $1$) | (i) | thm-ks-gc |
| 統計量の計算 | $D_n=\max_{1\le i\le n}\max\bigl(\tfrac in-u_i,\ u_i-\tfrac{i-1}n\bigr)$、$u_i:=F_0(X_{(i)})$ | $F_0$ が連続 | prop-ks-formula |
| 分布によらないこと | $D_n\overset{d}{=}\sup_{0\le u\le1}\lvert G_n(u)-u\rvert$($G_n$ は一様分布の標本の経験分布関数) | (i)(ii) と帰無仮説 | thm-ks-free |
| 不連続な $F_0$ | $P(D_n>c)\le P(\sup_u\lvert G_n(u)-u\rvert>c)$ | (i) と帰無仮説 | thm-ks-free |
| $n=1$ の正確な分布 | $P(D_1\le x)=2x-1$($\frac12\le x\le1$) | (ii) | ex-ks-n1 |
| 極限分布 | $P(\sqrt nD_n\le x)\to1-2\sum_{k\ge1}(-1)^{k-1}e^{-2k^2x^2}$ | (i)(ii) と帰無仮説 | thm-ks-limit(証明しない) |
| 漸近の臨界値 | 有意水準 $10\%,5\%,1\%$ で $c=1.2238,\ 1.3581,\ 1.6276$ | 同上、$n$ が大きい | 計算 |
| 2 標本の統計量 | 分布は共通の連続分布によらない | (i)(ii) と帰無仮説 | prop-ks-two-sample |
Glivenko–Cantelli の定理
KS 検定が意味をもつのは、帰無仮説が正しければ $D_n$ が $0$ に近づくからである。
$X_1,X_2,\dots$ が独立で同じ分布関数 $F$ に従うとき、確率 $1$ で
$$
\sup_{x\in\mathbb R}\lvert F_n(x)-F(x)\rvert\to0\qquad(n\to\infty)
$$
である。$F$ の連続性は仮定しない。
各点の収束。 $x$ を固定すると、$\mathbf 1_{\{X_i\le x\}}$($i=1,2,\dots$)は独立で同じ分布に従い期待値 $F(x)$ なので、強大数の法則 により確率 $1$ で $F_n(x)\to F(x)$ である。同様に $\mathbf 1_{\{X_i< x\}}$ の期待値は $F(x-0)=P(X_1< x)$ なので、$F_n(x-0)=\frac1n\#\{i\le n\mid X_i< x\}\to F(x-0)$ である。
分点を選ぶ。 整数 $k\ge2$ と $1\le j\le k-1$ について、$F$ の分位点関数 $Q$(分位点 の定義「分位点関数」)を使って $x_{j,k}:=Q(j/k)$ とし、$x_{0,k}:=-\infty$、$x_{k,k}:=+\infty$ とおく。$F(-\infty):=0$、$F(+\infty-0):=1$ などと読む。分位点 の定理「分位点関数の切り替え規則」の 2 により
$$
F(x_{j,k}-0)\le\frac jk\le F(x_{j,k})\qquad(1\le j\le k-1)
$$
であり、この式は $j=0$(右側)、$j=k$(左側)でも成り立つ。よって $F(x_{j,k}-0)-F(x_{j-1,k})\le\frac jk-\frac{j-1}k=\frac1k$($1\le j\le k$)である。
一様な評価。 分点は可算個なので、各点の収束が分点のすべてと左極限で同時に成り立つ確率 $1$ の事象がある。その上で $k$ を固定すると、$N$ を大きくとれば $n\ge N$ で、すべての $j$ について
$$
\lvert F_n(x_{j,k})-F(x_{j,k})\rvert< \frac1k,\qquad\lvert F_n(x_{j,k}-0)-F(x_{j,k}-0)\rvert< \frac1k
$$
である(端の $x_{0,k},x_{k,k}$ では両辺が $0$ と $1$ で一致する)。$x$ が分点のどれかに等しければ $\lvert F_n(x)-F(x)\rvert< \frac1k$ である。そうでなければ $x_{j-1,k}< x< x_{j,k}$ となる $j$ があり、$F_n$ と $F$ の単調性から
$$
F_n(x)\le F_n(x_{j,k}-0)\le F(x_{j,k}-0)+\tfrac1k\le F(x_{j-1,k})+\tfrac2k\le F(x)+\tfrac2k,
$$
$$
F_n(x)\ge F_n(x_{j-1,k})\ge F(x_{j-1,k})-\tfrac1k\ge F(x_{j,k}-0)-\tfrac2k\ge F(x)-\tfrac2k
$$
である。よって $n\ge N$ で $\sup_x\lvert F_n(x)-F(x)\rvert\le\frac2k$ である。$k$ は任意なので結論を得る。$\square$
この証明は Dur19 Theorem 2.4.9(p. 79)の証明の筋に沿い、分点を分位点関数で与えた。帰無仮説のもとでは $D_n\to0$、帰無仮説が誤りで真の分布関数 $F$ が $F_0$ と異なれば $D_n\to\sup_x\lvert F(x)-F_0(x)\rvert>0$ である。後者は $\lvert D_n-\sup_x\lvert F-F_0\rvert\rvert\le\sup_x\lvert F_n-F\rvert$ から従う。したがって、$c$ を固定したとき $\sqrt nD_n>c$ となる確率は $1$ に近づき、どんな対立仮説もいずれ見分けられる。
主定理:統計量の分布は分布関数によらない
$X_1,\dots,X_n$ は独立で同じ分布関数 $F$ に従うとし、$D_n:=\sup_x\lvert F_n(x)-F(x)\rvert$ とおく。$U_1,\dots,U_n$ を独立で $(0,1)$ 上の一様分布に従う確率変数、$G_n$ をその経験分布関数とし、$D_n^U:=\sup_{0\le u\le1}\lvert G_n(u)-u\rvert$ とおく。
- $D_n$ は $\sup_{u\in F(\mathbb R)}\lvert G_n(u)-u\rvert$ と同じ分布に従う。とくに、すべての $c$ について $P(D_n>c)\le P(D_n^U>c)$ である。
- $F$ が連続なら、$D_n$ は $D_n^U$ と同じ分布に従う。とくに $D_n$ の分布は $F$ によらない。
$F$ の分位点関数を $Q$ とし、$X_i':=Q(U_i)$ とおく。分位点 の定理「分位点変換と確率積分変換」の 1 により、各 $X_i'$ の分布関数は $F$ であり、$U_1,\dots,U_n$ が独立なので $X_1',\dots,X_n'$ も独立である。よって $(X_1',\dots,X_n')$ は $(X_1,\dots,X_n)$ と同じ同時分布に従う。$D_n$ はデータの関数であり($F_n$ と $F$ は右連続なので、$\sup$ を有理数 $x$ だけでとっても同じ値になり、可測である)、データを $X_i'$ に替えても分布は変わらない。以下、$X_i=Q(U_i)$ として示す。
経験分布関数の書き直し。 分位点 の定理「分位点関数の切り替え規則」の 1 により、すべての $x$ と $i$ について
$$
X_i=Q(U_i)\le x\iff U_i\le F(x)
$$
である。両辺の個数を数えれば、すべての $x$ で
$$
F_n(x)=\frac1n\#\{i\mid U_i\le F(x)\}=G_n\bigl(F(x)\bigr)
$$
である。
1 の証明。 上の式から
$$
D_n=\sup_{x\in\mathbb R}\bigl\lvert G_n(F(x))-F(x)\bigr\rvert=\sup_{u\in F(\mathbb R)}\lvert G_n(u)-u\rvert
$$
である($x$ が $\mathbb R$ を動くとき $u=F(x)$ はちょうど $F(\mathbb R)$ を動く)。$F(\mathbb R)\subset[0,1]$ なので右辺は $D_n^U$ 以下であり、$P(D_n>c)\le P(D_n^U>c)$ を得る。
2 の証明。 $F$ が連続なら、$F(x)\to0$($x\to-\infty$)と $F(x)\to1$($x\to\infty$)と中間値の定理により $(0,1)\subset F(\mathbb R)\subset[0,1]$ である。$U_i\in(0,1)$ なので $G_n(0)=0$、$G_n(1)=1$ であり、端点 $u=0,1$ では $\lvert G_n(u)-u\rvert=0$ である。よって
$$
\sup_{u\in F(\mathbb R)}\lvert G_n(u)-u\rvert=\sup_{0< u< 1}\lvert G_n(u)-u\rvert=\sup_{0\le u\le1}\lvert G_n(u)-u\rvert=D_n^U
$$
であり、1 の前半と合わせて $D_n$ と $D_n^U$ は同じ分布に従う。$\square$
証明の核心は、分位点変換 $X=Q(U)$ によって「$X\le x$」という事象が「$U\le F(x)$」に移ることである。縦軸の値 $F(x)$ だけが効き、横軸の目盛り(データの単位や分布の形)は消える。$F$ が連続なら縦軸の値は $(0,1)$ を埋め尽くすので、どの $F$ でも同じ $\sup$ になる。$F$ に跳びがあると縦軸の値に隙間ができ、$\sup$ をとる範囲が狭まるので $D_n$ は小さくなる。これが 1 の不等式で、不連続な $F_0$ で連続の場合の臨界値を使うと、検定は保守的(棄却の確率が $\alpha$ 以下)になる。
次の命題は $D_n$ を有限回の計算で求める公式である。
$F_0$ を連続な分布関数とし、データを小さい順に並べたもの(順序統計量)を $X_{(1)}\le\cdots\le X_{(n)}$、$u_i:=F_0(X_{(i)})$ とおく。このとき
$$
D_n=\max_{1\le i\le n}\max\Bigl(\frac in-u_i,\ u_i-\frac{i-1}n\Bigr)
$$
である。
要点:$F_n$ は隣り合う順序統計量の間で一定なので、各区間での差の最大は端で決まる。
詳しい証明を開く
$X_{(0)}:=-\infty$、$X_{(n+1)}:=+\infty$、$u_0:=0$、$u_{n+1}:=1$ とおく。$X_{(i)}< X_{(i+1)}$ となる $0\le i\le n$ について、区間 $I_i:=[X_{(i)},X_{(i+1)})$($i=0$ では $(-\infty,X_{(1)})$)の上では $x$ 以下のデータはちょうど $i$ 個なので $F_n=\frac in$ である。$F_0$ は非減少で連続なので、$I_i$ の上の $F_0$ の下限は $u_i$、上限は $u_{i+1}$ であり、$\sup_{x\in I_i}\lvert\frac in-F_0(x)\rvert=\max(\frac in-u_i,\ u_{i+1}-\frac in)$ である($i=0$ の第 1 項は $0$、$i=n$ の第 2 項は $0$ で、どちらも $0$ 以上の他項を超えない)。これらの区間は $\mathbb R$ を覆うので、$D_n$ は $\frac in-u_i$($1\le i\le n$)と $u_{i+1}-\frac in=u_{i'}-\frac{i'-1}n$($i'=i+1$)の最大値以下で、空でない区間から来る値の最大に等しい。同じ値のデータがあって $I_i$ が空のときも、$F_n(X_{(i)})\ge\frac in$ から $\frac in-u_i\le F_n(X_{(i)})-F_0(X_{(i)})\le D_n$、$F_n(X_{(i)}-0)\le\frac{i-1}n$ と $F_0(X_{(i)}-0)=u_i$ から $u_i-\frac{i-1}n\le D_n$ なので、すべての項が $D_n$ 以下である。よって等式が成り立つ。$\square$
極限分布と 2 標本の場合
$n$ が大きいときの臨界値は、次の極限から得られる。
$X_1,X_2,\dots$ が独立で同じ連続な分布関数 $F_0$ に従うとき、$x>0$ について
$$
P(\sqrt nD_n\le x)\to K(x):=1-2\sum_{k=1}^\infty(-1)^{k-1}e^{-2k^2x^2}\qquad(n\to\infty)
$$
である。$K$ は Brown 橋 $B_t-tB_1$($B$ は Brown運動)の絶対値の最大値 $\max_{0\le t\le1}\lvert B_t-tB_1\rvert$ の分布関数である。
この記事では証明しない。thm-ks-free により一様分布の場合に帰着し、$\sqrt nD_n$ が $\max_{0\le t\le1}\lvert B_t-tB_1\rvert$ に分布収束することは Dur19 Theorem 8.4.3(p. 412)、その最大値の分布の級数表示は同書 (8.4.12)(p. 416)にある(収束は Donskerの定理 による)。$K$ は連続なので、すべての $x>0$ で分布関数が収束する。
$K$ の上側の分位点は、有意水準 $10\%,5\%,1\%$ に対して $1.2238,\ 1.3581,\ 1.6276$ である。級数は速く収束し、$x=1$ でも初めの 2 項 $1-2(e^{-2}-e^{-8})$ で $K(1)\approx0.7300$ が得られる。
$X_1,\dots,X_m,Y_1,\dots,Y_n$ がすべて独立で、同じ連続な分布関数 $F$ に従うとき、$D_{m,n}$ の分布は $F$ によらない。
$U_1,\dots,U_m,V_1,\dots,V_n$ を独立で $(0,1)$ 上の一様分布に従うものとし、$X_i=Q(U_i)$、$Y_j=Q(V_j)$ としてよい(prf-ks-free の最初の段落と同じ)。$U$ と $V$ の経験分布関数を $G_m^U$、$G_n^V$ とすると、prf-ks-free と同じく $F_m(x)=G_m^U(F(x))$、$G_n(x)=G_n^V(F(x))$ であり、$D_{m,n}=\sup_{u\in F(\mathbb R)}\lvert G_m^U(u)-G_n^V(u)\rvert$ である。$(0,1)\subset F(\mathbb R)$ で、端点 $u=0,1$ では差が $0$ なので、これは $\sup_{0\le u\le1}\lvert G_m^U(u)-G_n^V(u)\rvert$ に等しく、その分布は $F$ によらない。$\square$
帰無仮説のもとでは、$m+n$ 個を小さい順に並べたとき、どの $m$ 個が $X$ の側かは $\binom{m+n}m$ 通りが等確率になる(Wilcoxon検定 の補題「順位は一様に分布する」)。$D_{m,n}$ はこの並び方だけで決まるので、正確な分布は数え上げで求まる(ex-ks-two-sample)。大きい標本での 2 標本の統計量の極限分布は、この記事では扱わない。
計算の手順
1 標本の KS 検定は次の手順で行う。
- 仮説の分布関数 $F_0$ を、データを見る前に母数まで決める(条件 (iii))。
- データを小さい順に並べ、$u_i=F_0(X_{(i)})$ を計算する。
- prop-ks-formula で $D_n=\max_i\max(\frac in-u_i,\ u_i-\frac{i-1}n)$ を求める。
- 臨界値と比べる。$n$ が小さいときは $D_n$ の正確な分布(一様分布の場合に帰着した数表、thm-ks-free)を使い、$n$ が大きいときは $\sqrt nD_n$ を $1.3581$(有意水準 $5\%$)などと比べる(thm-ks-limit)。
- $p$ 値を報告するときは、正確な分布か $1-K(\sqrt nD_n)$ を使う。$F_0$ が不連続なら、得た $p$ 値は真の値以上(保守的)と注記する(thm-ks-free の 1)。
場合 やること 結果の形 $F_0$ が連続で完全に決まっている 上の手順 正確な有意水準 $F_0$ が不連続 同じ臨界値を使ってよい 保守的な検定 母数をデータから推定した KS の数表は使えない。その推定法に合わせた分布を別に求める 名目の水準と一致しない 2 標本 合わせたデータの並びで $D_{m,n}$ を計算し、並び方の数え上げで $p$ 値 正確な有意水準
例題
使う公式:thm-ks-free、prop-ks-formula。
答え:$n=1$ では $u=F_0(X_1)$ として $D_1=\max(1-u,\ u)$ で、$F_0$ が連続なら $u$ は一様分布に従うので $P(D_1\le x)=P(1-x\le u\le x)=2x-1$($\frac12\le x\le1$)。たとえば $P(D_1\le0.75)=0.5$。有意水準 $5\%$ の臨界値は $2x-1=0.95$ を解いて $x=0.975$ である。
途中の計算を開く
prop-ks-formula で $n=1$、$i=1$ とすると $\max(1-u_1,\ u_1-0)$。$D_1\ge\frac12$ はいつも成り立つ。$P(D_1>0.975)=P(u>0.975)+P(u< 0.025)=0.05$。
10 個の部品の寿命 $0.12,\ 0.27,\ 0.41,\ 0.66,\ 0.88,\ 1.10,\ 1.46,\ 1.85,\ 2.70,\ 3.90$ が、分布関数 $F_0(x)=1-e^{-x}$($x\ge0$)の指数分布に従うかを有意水準 $5\%$ で検定する。
使う公式:prop-ks-formula、thm-ks-limit。
答え:$D_{10}\approx0.185217$($i=5$、$x=0.88$ で $u_5-\frac4{10}$ が最大)。$\sqrt{10}D_{10}\approx0.5857< 1.3581$ なので棄却しない。正確な $5\%$ の臨界値は $D_{10}>0.40925$ で、漸近の臨界値 $1.3581/\sqrt{10}\approx0.42947$ より少し小さい。正確な $p$ 値は $0.8228$、漸近の $p$ 値は $1-K(0.5857)\approx0.8826$。
途中の計算を開く
$u_i=1-e^{-X_{(i)}}$ は $0.1131,0.2366,0.3363,0.4831,0.5852,0.6671,0.7678,0.8428,0.9328,0.9798$。$\frac in-u_i$ の最大は $i=10$ の $0.0202$、$u_i-\frac{i-1}n$ は $0.1131,0.1366,0.1363,0.1831,0.1852,0.1671,0.1678,0.1428,0.1328,0.0798$ で、最大は $i=5$ の $0.5852-0.4=0.1852$。
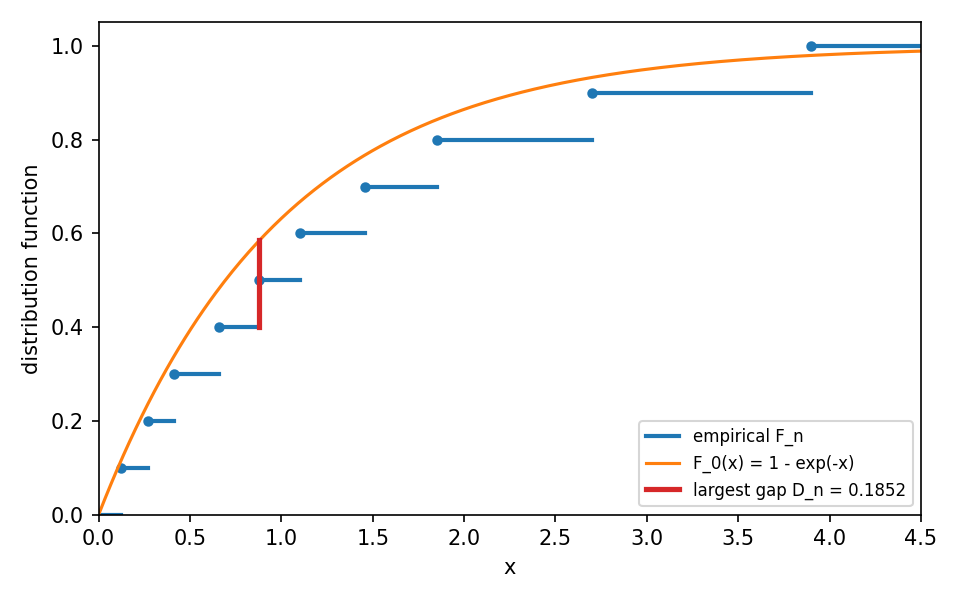 図: 例題 [ex-ks-exp] のデータの経験分布関数(階段)と仮説の分布関数 1 − exp(−x)(曲線)。最大のずれは x = 0.88 の直前で、縦の線分の長さ 0.1852 が統計量の値である。
$X$:$1.2,\ 2.3,\ 2.9,\ 3.4,\ 4.1$($m=5$)と $Y$:$3.0,\ 3.8,\ 4.4,\ 5.2,\ 5.9,\ 6.5$($n=6$)が同じ分布から来たかを検定する。
使う公式:prop-ks-two-sample と並び方の数え上げ。
答え:$D_{5,6}=\frac23$($x=4.1$ で $F_5=1$、$G_6=\frac26$)。帰無仮説のもとで $11$ 個の並び方 $\binom{11}5=462$ 通りのうち $D_{5,6}\ge\frac23$ となるのは $50$ 通りで、$p$ 値は $\frac{50}{462}\approx0.108225$。有意水準 $5\%$ では棄却しない。
途中の計算を開く
合わせた並びは $X,X,X,Y,X,Y,X,Y,Y,Y,Y$。各点までの $(F_5,G_6)$ は $(\frac15,0),(\frac25,0),(\frac35,0),(\frac35,\frac16),(\frac45,\frac16),(\frac45,\frac26),(1,\frac26),\dots$ で、差の最大は $1-\frac26=\frac23$。462 通りすべてについて同じ計算をして数える。
使う公式:thm-ks-free(正確な分布)、thm-ks-limit(極限)。
答え:有意水準 $5\%$ の正確な臨界値を $\sqrt n$ 倍したものは、$n=5,10,20,50,100$ で $1.2595,\ 1.2941,\ 1.3151,\ 1.3322,\ 1.3403$ で、極限の $1.3581$ に下から近づく。$n=5$ で漸近の臨界値 $1.3581/\sqrt5\approx0.6074$ を使うと、実際の有意水準は $0.0270$ で、名目の $5\%$ よりかなり小さい。
使える条件と反例
各行は条件 (i)〜(iii) のうち 1 つだけを外し、臨界値 $\sqrt nD_n>1.3581$(名目の有意水準 $5\%$)の検定の実際の棄却の確率が $5\%$ からずれることを示す。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| (ii) $F_0$ が連続 | $F_0$ は値 $0,1$ を確率 $\frac12$ ずつとる分布(公平な硬貨)、データもこの分布 | $D_n=\lvert F_n(0)-\frac12\rvert$ で、$\sqrt nD_n$ は $\frac12\lvert Z\rvert$($Z$ は標準正規)に近づく。棄却の確率は $P(\lvert Z\rvert>2.7162)\approx0.0066$ に近づき、$5\%$ よりずっと小さい(thm-ks-free の 2 が成り立たず、1 の不等式だけが残る) |
| (iii) $F_0$ を前もって決める | データは標準正規分布、$n=50$。$F_0$ を標本平均と標本標準偏差の正規分布にする | 棄却の確率は約 $0.0001$(母数を既知とすれば約 $0.043$)。分布によらない性質が失われる |
| (i) 独立 | $X_t=0.8X_{t-1}+\sqrt{1-0.8^2}\,\varepsilon_t$($\varepsilon_t$ は独立な標準正規、$X_1$ も標準正規)で、各 $X_t$ は標準正規分布。$F_0$ は標準正規、$n=100$ | 棄却の確率は約 $0.52$ で、帰無仮説の分布が正しいのに半分以上を棄却する |
反例の確かめを開く
1 行目:$F_0$ は $x< 0$ で $0$、$0\le x< 1$ で $\frac12$、$x\ge1$ で $1$。$F_n$ も同じ点でだけ跳ぶので、差が $0$ でないのは $[0,1)$ の上だけで、そこでは $F_n(0)-\frac12$。$nF_n(0)$ は二項分布 $B(n,\frac12)$ に従うので、中心極限定理 により $\sqrt n(F_n(0)-\frac12)$ は分散 $\frac14$ の正規分布に近づく。$\frac12\lvert Z\rvert>1.3581$ は $\lvert Z\rvert>2.7162$ と同値。$n=100$ での模擬(2 万回)の棄却率は $0.0063$。2 行目:標本から推定した平均と分散でデータを標準化すると、経験分布関数が $F_0$ に寄せられ、$D_n$ が小さくなる。2 万回の模擬による値。分布によらない性質が失われることは、模擬によらず $n=2$ で分かる。標準化した 2 個のデータは $\pm a$(標準偏差を $n$ で割れば $a=1$、$n-1$ で割れば $a=\frac1{\sqrt2}$)に決まるので、$\Phi$ を標準正規分布の分布関数として $D_2=\max(\frac12-\Phi(-a),\ \Phi(-a))$ は $\frac12$ 未満の定数である。一方 $D_2^U\ge1-\max(U_1,U_2)$ なので $P(D_2^U>\frac12)\ge P(U_1< \frac12,\ U_2< \frac12)=\frac14$ であり、$D_2$ と $D_2^U$ は同じ分布に従わない。3 行目:正の相関があると、データが平均の片側にまとまりやすく、経験分布関数が大きく揺れる。1 万回の模擬による値。極端な場合 $X_t=X_1$(すべての $t$)では、各 $X_t$ は標準正規分布に従うが、$F_n$ は $X_1$ で $0$ から $1$ に跳ぶので $D_n=\max(\Phi(X_1),\ 1-\Phi(X_1))\ge\frac12$ であり、$n\ge8$ なら $\sqrt nD_n\ge\frac{\sqrt8}2\approx1.414>1.3581$ で必ず棄却する(模擬によらない)。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| $D_n$ を $\sqrt n$ 倍せずに $1.3581$ と比べる | $\sqrt nD_n$ と比べるか、$D_n$ を $1.3581/\sqrt n$ と比べる | thm-ks-limit は $\sqrt nD_n$ の極限 |
| 平均と分散を推定してから正規分布と KS 検定する | その推定法に合わせた別の数表を使う | 反例の表の 2 行目 |
| $D_n$ を $F_n(X_{(i)})-F_0(X_{(i)})$ の最大だけで計算する | 跳ぶ直前の $u_i-\frac{i-1}n$ も比べる | ex-ks-exp では最大はこちらの側 |
| 小さい $n$ で漸近の臨界値を使う | 正確な分布を使う | ex-ks-small-n で $n=5$ の実際の水準は $2.7\%$ |
| 棄却されないことを「$F_0$ に従う」と読む | 「データは $F_0$ と矛盾しない」というだけ | 検出力は $n$ と対立仮説で決まる(仮説検定) |
補足
$F_n-F_0$ の正の側だけを見る片側の統計量 $D_n^+:=\sup_x(F_n(x)-F_0(x))$ も、thm-ks-free と同じ証明で分布が連続な $F_0$ によらない。差の最大値の代わりにずれの 2 乗を積分する統計量もある(Cramér–von Mises検定)。寿命のデータに打ち切りがあるときは経験分布関数の代わりに 生存解析 の Kaplan–Meier 推定量を使う(打ち切りがなければ両者は一致する)。経験分布関数の揺れ(経験過程)の極限が Brown 橋になることは Donskerの定理 の応用として述べられている。
関連項目
- 前提: 累積分布関数, 分位点, 仮説検定
- 理論: 強大数の法則, Donskerの定理, Brown運動
- 比較: Wilcoxon検定, p値
- 発展: 生存解析, ブートストラップ法
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

