中央値と絶対誤差
概要
中央値と絶対誤差(median and absolute error)とは、データの中央値を「ずれの絶対値の和を最小にする値」と見る見方である。データ $x_1,\dots,x_n$ について $L(a)=\sum_i|x_i-a|$ を最小にする $a$ 全体は、$a$ より真に小さいデータも真に大きいデータも全体の半分を超えない $a$ の集合(中央値の集合)に一致する。$x_{(1)}\le\dots\le x_{(n)}$ と並べると、$n=2m+1$ なら $x_{(m+1)}$ のみ、$n=2m$ なら $[x_{(m)},x_{(m+1)}]$ 全体で、高校の中央値はその中点である。最小値は両端から組にした差の和 $\sum_{k=1}^{\lfloor n/2\rfloor}(x_{(n+1-k)}-x_{(k)})$ である。中央値は外れ値に強いが、和とは両立しない。
高校での出発点:中央値
データ $x_1,x_2,\dots,x_n$ を小さい順に並べ替えたものを
$$
x_{(1)}\le x_{(2)}\le\cdots\le x_{(n)}
$$
と書く。$x_{(k)}$ は「小さい方から $k$ 番目の値」である。高校では、データの中心を表すもう 1 つの代表値として中央値を習う。
- $n$ が奇数 $2m+1$ のとき、中央値は真ん中の値 $x_{(m+1)}$ である。
- $n$ が偶数 $2m$ のとき、中央値は真ん中の 2 つの値の平均 $\frac12\bigl(x_{(m)}+x_{(m+1)}\bigr)$ である。
データ $1,2,3,4,10$ は $n=5=2\cdot2+1$ なので $m=2$ で、中央値は $x_{(3)}=3$ である。平均値は $4$ である。
最後の値 $10$ を $100$ に変えると、並べ替えたときの 3 番目は $3$ のままなので、中央値は $3$ のままである。一方、平均値は $\frac{1+2+3+4+100}5=22$ に跳ね上がる。
データ $7,1,4,2$ を並べ替えると $1,2,4,7$ である。$n=4=2\cdot2$ なので $m=2$ で、真ん中の 2 つは $x_{(2)}=2$ と $x_{(3)}=4$ である。中央値は $\frac{2+4}2=3$ である。平均値は $\frac{1+2+4+7}4=3.5$ である。
ここで次の問いが生じる。
- 中央値は、どういう意味でデータの「中心」なのか。→ thm-mae-main
- 偶数個のとき、真ん中の 2 つの平均をとるのはなぜか。$2$ と $4$ の間の別の値ではいけないのか。→ prop-mae-interval、thm-mae-main
- 平均値と中央値は何が違うのか。→ ex-mae-mean-not-min、rem-mae-which
平均値と二乗誤差 の記事では、平均値が「ずれの 2 乗の和」を最小にする値であることを示した。この記事では、ずれを 2 乗の代わりに絶対値で測る。高校の計算 この記事の言葉 大学の言葉 中央値(奇数個) ずれの絶対値の和 $L(a)$ をただ 1 つの点で最小にする値 絶対値の和の距離($L^1$)で最も近い定数 中央値(偶数個) $L(a)$ を最小にする区間 $[x_{(m)},x_{(m+1)}]$ の中点 最小点の集合から 1 点を選ぶ約束 「真ん中」という言い方 左右のデータの個数が半分を超えない 分位点(割合 $\frac12$ の場合) 外れ値に強い $L(a)$ はずれの大きさに比例してしか増えない 頑健な代表値
ずれの絶対値の和
データ $x_1,\dots,x_n$ と実数 $a$ について
$$
L(a):=\sum_{i=1}^n|x_i-a|=|x_1-a|+|x_2-a|+\cdots+|x_n-a|
$$
とおき、$L(a)$ を $a$ に対する絶対誤差の和という。$|x_i-a|$ は数直線の上での $x_i$ と $a$ の距離なので、$L(a)$ は「点 $a$ から各データまでの距離の合計」である。
データ $1,2,3$ では
- $L(1)=0+1+2=3$、$L(2)=1+0+1=2$、$L(3)=2+1+0=3$、
- $L(2.5)=1.5+0.5+0.5=2.5$
で、中央値 $2$ で最も小さい。データ $1,2,4,7$ では - $L(1)=0+1+3+6=10$、$L(2)=1+0+2+5=8$、$L(3)=2+1+1+4=8$、
- $L(4)=3+2+0+3=8$、$L(5)=4+3+1+2=10$
で、$a=2,3,4$ のどれでも同じ値 $8$ になる。偶数個のときは、最小にする点が 1 つに決まらないように見える。
証明の部品として、2 点までの距離の和を調べる。
$p\le q$ とする。すべての実数 $a$ について
$$
|p-a|+|q-a|\ge q-p
$$
が成り立つ。等号が成り立つのは $p\le a\le q$ のときであり、そのときに限る。
$a$ が $p$ の左、$p$ と $q$ の間、$q$ の右のどこにあるかで分ける。
- $a< p$ のとき:$p-a>0$、$q-a>0$ なので、左辺は $(p-a)+(q-a)$ である。これを $(q-p)+2(p-a)$ と書き直すと、$2(p-a)>0$ なので左辺は $q-p$ より真に大きい。
- $p\le a\le q$ のとき:$a-p\ge0$、$q-a\ge0$ なので、左辺は $(a-p)+(q-a)=q-p$ で、等号が成り立つ。
- $a>q$ のとき:$a-p>0$、$a-q>0$ なので、左辺は $(a-p)+(a-q)=(q-p)+2(a-q)$ で、$2(a-q)>0$ なので $q-p$ より真に大きい。
3 つの場合のどれでも不等式が成り立ち、等号は 2 番目の場合だけである。$\square$
$p=2$、$q=5$ とすると、$q-p=3$ である。
- $a=3$(間にある):$|2-3|+|5-3|=1+2=3$ で、等号。
- $a=6$(右にある):$|2-6|+|5-6|=4+1=5=3+2\cdot(6-5)$。
- $a=0$(左にある):$|2-0|+|5-0|=2+5=7=3+2\cdot(2-0)$。
2 点の間にいる限り距離の和は 2 点間の距離 $3$ に等しく、外に出ると外に出た分の 2 倍だけ増える。
この補題は、三角不等式 $|u|+|v|\ge|u-v|$ を $u=q-a$、$v=p-a$ に使った形でもある。
$|x-a|$ の和を場合分けせずに扱う三角不等式は 絶対値と三角不等式 で扱う。
中央値の集合
偶数個のときに最小点が 1 つに決まらないことを正確に扱うため、中央値を「個数の釣り合い」で定義し直す。
実数 $a$ がデータ $x_1,\dots,x_n$ の中央値の集合に属するとは、
$$
\#\{i : x_i< a\}\le\frac n2\quad\text{かつ}\quad\#\{i : x_i>a\}\le\frac n2
$$
が成り立つことをいう。ここで $\#\{\cdots\}$ は条件を満たす番号 $i$ の個数である。言葉で言えば、「$a$ より真に小さいデータの個数」も「$a$ より真に大きいデータの個数」も、全体の半分を超えないということである。
データ $1,2,4,7$($\frac n2=2$)について調べる。
- $a=3$:$3$ より小さいのは $1,2$ の 2 個、大きいのは $4,7$ の 2 個。どちらも $2$ 以下なので属する。
- $a=2$:小さいのは $1$ の 1 個、大きいのは $4,7$ の 2 個。属する。$a=4$ も同様に属する。
- $a=5$:小さいのは $1,2,4$ の 3 個で、$2$ を超える。属さない。
- $a=1.5$:大きいのは $2,4,7$ の 3 個で、属さない。
データ $1,2,3,4,10$($\frac n2=2.5$)では、$a=3$ は小さいもの 2 個・大きいもの 2 個で属する。$a=3.5$ は小さいものが $1,2,3$ の 3 個で、属さない。
$x_{(1)}\le\cdots\le x_{(n)}$ を並べ替えたデータとする。中央値の集合は
- $n=2m+1$(奇数)なら 1 点 $\{x_{(m+1)}\}$、
- $n=2m$(偶数)なら閉区間 $[x_{(m)},x_{(m+1)}]$
である。
方針:候補の点が条件を満たすことと、それより左や右の点が条件を破ることを、並べ替えたデータの番号で数えて示す。
段 1(偶数 $n=2m$、区間の点は属する)。$\frac n2=m$ である。$x_{(m)}\le a\le x_{(m+1)}$ とする。番号 $k\ge m+1$ のデータは $x_{(k)}\ge x_{(m+1)}\ge a$ なので、$a$ より真に小さくない。よって $a$ より真に小さいデータは $x_{(1)},\dots,x_{(m)}$ の中にしかなく、多くても $m$ 個である。同じように、番号 $k\le m$ のデータは $x_{(k)}\le x_{(m)}\le a$ なので $a$ より真に大きくなく、$a$ より真に大きいデータは多くても $x_{(m+1)},\dots,x_{(n)}$ の $m$ 個である。したがって $a$ は中央値の集合に属する。
段 2(偶数、区間の外の点は属さない)。$a< x_{(m)}$ なら、$x_{(m)},x_{(m+1)},\dots,x_{(n)}$ はすべて $a$ より真に大きい。その個数は $n-m+1=m+1$ で、$m$ を超える。$a>x_{(m+1)}$ なら、$x_{(1)},\dots,x_{(m+1)}$ の $m+1$ 個が $a$ より真に小さい。どちらも条件を破る。
段 3(奇数 $n=2m+1$)。$\frac n2=m+\frac12$ で、個数は整数なので、条件は「小さいもの・大きいものがそれぞれ $m$ 個以下」と同じである。$a=x_{(m+1)}$ なら、$a$ より真に小さいデータは番号 $k\le m$ のものに限られ、真に大きいデータは番号 $k\ge m+2$ のものに限られるので、どちらも $m$ 個以下である。$a< x_{(m+1)}$ なら $x_{(m+1)},\dots,x_{(n)}$ の $m+1$ 個が $a$ より大きく、$a>x_{(m+1)}$ なら $x_{(1)},\dots,x_{(m+1)}$ の $m+1$ 個が $a$ より小さいので、条件を破る。$\square$
偶数個のときに高校で中央値とする $\frac12(x_{(m)}+x_{(m+1)})$ は、この区間の中点である。区間から 1 点を選ぶための約束と考えればよい。ただし、区間が 1 点につぶれることもある。
データ $1,2,2,5$ では $x_{(2)}=x_{(3)}=2$ なので、中央値の集合は $[2,2]=\{2\}$ で、1 点である。実際 $a=2$ では小さいもの 1 個・大きいもの 1 個で条件を満たし、$a=1.5$ では大きいものが 3 個、$a=2.5$ では小さいものが 3 個で条件を破る。
主定理:中央値は絶対誤差の和を最小にする
$L(a)=\sum_{i=1}^n|x_i-a|$ を最小にする $a$ 全体は、中央値の集合に一致する。すなわち、$n=2m+1$ なら $a=x_{(m+1)}$ ただ 1 つ、$n=2m$ なら閉区間 $[x_{(m)},x_{(m+1)}]$ 全体である。最小値は
$$
\sum_{k=1}^{\lfloor n/2\rfloor}\bigl(x_{(n+1-k)}-x_{(k)}\bigr)
$$
(大きい方から $k$ 番目と小さい方から $k$ 番目の差の和)である。ここで $\lfloor n/2\rfloor$ は $\frac n2$ を超えない最大の整数である。
方針:いちばん小さい値といちばん大きい値、2 番目に小さい値と 2 番目に大きい値、…と組にし、各組に lem-mae-pair を使う。
段 1(並べ替える)。$L(a)$ は足す順序によらないので、$L(a)=\sum_{k=1}^n|x_{(k)}-a|$ と並べ替えたデータで書ける。
段 2(偶数 $n=2m$ の下からの評価)。$k=1,\dots,m$ について、$x_{(k)}$ と $x_{(n+1-k)}$ を組にする。$k\le m< m+1\le n+1-k$ なので $x_{(k)}\le x_{(n+1-k)}$ である。$n$ 個の項はちょうど $m$ 組に分かれるので
$$
L(a)=\sum_{k=1}^m\Bigl(|x_{(k)}-a|+|x_{(n+1-k)}-a|\Bigr)
$$
である。各組に lem-mae-pair を $p=x_{(k)}$、$q=x_{(n+1-k)}$ として使うと、各組は $x_{(n+1-k)}-x_{(k)}$ 以上である。足し合わせて
$$
L(a)\ge C,\qquad C:=\sum_{k=1}^m\bigl(x_{(n+1-k)}-x_{(k)}\bigr)
$$
を得る。$C$ は $a$ によらない定数である。
段 3(偶数の等号)。$L(a)-C$ は、各組の「左辺 $-$ 右辺」を足したもので、どれも $0$ 以上である。$0$ 以上の数の和が $0$ になるのは、すべてが $0$ のときに限る。よって $L(a)=C$ となるのは、すべての組で等号が成り立つとき、すなわち lem-mae-pair により、$a$ がすべての区間 $I_k:=[x_{(k)},x_{(n+1-k)}]$($k=1,\dots,m$)に属するときに限る。$x_{(k)}\le x_{(k+1)}$ かつ $x_{(n-k)}\le x_{(n+1-k)}$ なので $I_1\supset I_2\supset\cdots\supset I_m$ であり、これらすべてに属することは、最も内側の $I_m=[x_{(m)},x_{(m+1)}]$ に属することと同じである。$I_m$ は空でないので、$L$ の最小値は $C$ であり、最小にする $a$ 全体は $[x_{(m)},x_{(m+1)}]$ である。
段 4(奇数 $n=2m+1$)。真ん中の $x_{(m+1)}$ は組にならずに残るので
$$
L(a)=\sum_{k=1}^m\Bigl(|x_{(k)}-a|+|x_{(n+1-k)}-a|\Bigr)+|x_{(m+1)}-a|\ge C+0
$$
である($C$ は段 2 と同じ式。$m=0$ なら空の和で $C=0$)。等号は、$a$ がすべての $I_k$ に属し、かつ $|x_{(m+1)}-a|=0$ のときに限る。後者は $a=x_{(m+1)}$ を意味する。$k\le m+1\le n+1-k$ なので $x_{(m+1)}$ はすべての $I_k$ に属する。よって最小値は $C$ で、最小にする $a$ は $x_{(m+1)}$ ただ 1 つである。
段 5(まとめ)。$\lfloor n/2\rfloor=m$ なので、最小値は主張の式に一致する。最小にする $a$ の集合は、prop-mae-interval により中央値の集合に一致する。$\square$
データ $1,2,3,4,10$($m=2$)では、組は $(1,10)$ と $(2,4)$ で、真ん中の $3$ が残る。最小値の式は $(10-1)+(4-2)=9+2=11$ である。実際 $L(3)=2+1+0+1+7=11$、$L(4)=3+2+1+0+6=12$ であり、最小点は中央値 $3$ だけである。
データ $1,2,4,7$ では、組は $(1,7)$ と $(2,4)$ で、最小値の式は $6+2=8$ である。ex-mae-l-values で見たとおり、$L(2)=L(3)=L(4)=8$ であり、区間の外では $L(1.5)=L(4.5)=9$、$L(1)=L(5)=10$ と大きくなる。
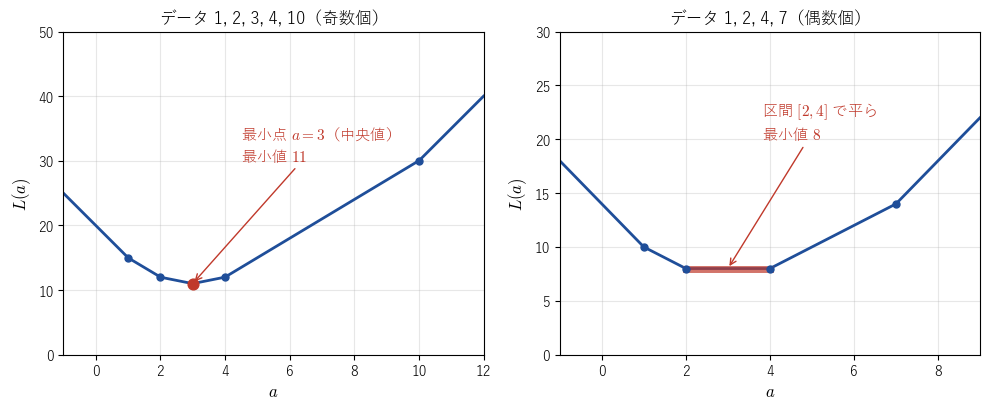 L(a) のグラフ。左はデータ 1, 2, 3, 4, 10 で a = 3 だけで最小、右はデータ 1, 2, 4, 7 で区間 [2, 4] 全体で最小値 8 をとる。
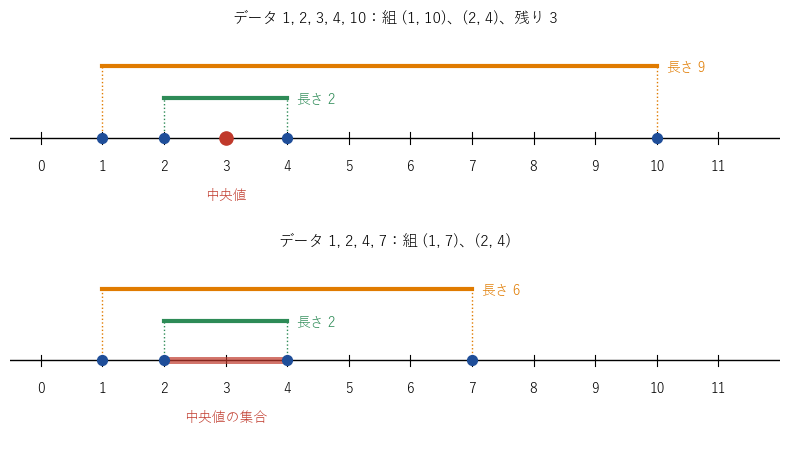 両端から組にした区間は入れ子になる。上は奇数個(真ん中の 3 が残る)、下は偶数個(最も内側の区間 [2, 4] が中央値の集合)。
傾きで見る
図 1 の折れ線の形は、傾きを数えるとわかる。
$a$ がどのデータとも異なるとき、$a$ の近くでは各項 $|x_i-a|$ は 1 次式である。$x_i< a$ なら $|x_i-a|=a-x_i$ で傾き $+1$、$x_i>a$ なら $|x_i-a|=x_i-a$ で傾き $-1$ である。足し合わせると、$L$ の傾きは
$$
\#\{i : x_i< a\}-\#\{i : x_i>a\}
$$
である。$a$ を左から右へ動かすと、データの値を 1 つ通り過ぎるたびに、その値に等しいデータの個数の $2$ 倍だけ傾きが増える(どの値も 1 回ずつしか現れなければ $2$ ずつ増える。$1,2,2,5$ で $a=2$ を通るときは $2\cdot2=4$ 増える)。傾きが負のうちは右へ動くと $L$ が減り、正になると増える。傾きが負から正へ変わる点、または傾きが $0$ になる区間が、左右の個数が釣り合う中央値である。
データ $1,2,4,7$ では、区間ごとの傾きは次のとおりである。
| $a$ の範囲 | 左の個数 | 右の個数 | 傾き |
|---|---|---|---|
| $a<1$ | 0 | 4 | $-4$ |
| $1< a<2$ | 1 | 3 | $-2$ |
| $2< a<4$ | 2 | 2 | $0$ |
| $4< a<7$ | 3 | 1 | $2$ |
| $a>7$ | 4 | 0 | $4$ |
たとえば $L(1)=10$、$L(2)=8$ で、$1$ から $2$ へ進むと $L$ は $2$ 減るので傾きは $-2$ である。$L(4)=8$、$L(7)=6+5+3+0=14$ で、$4$ から $7$ へ $3$ 進むと $6$ 増えるので傾きは $2$ である。
例と反例
| 外した仮定・変えたこと | 崩れる主張 | ボックス |
|---|---|---|
| データの個数が奇数 | $L$ の最小点がただ 1 つ | ex-mae-even-not-unique |
| ずれを絶対値で測る(2 乗で測る) | 最小点が中央値である(平均値になる) | ex-mae-mean-not-min |
| 平均値を中央値に替える | 合計の代表値が代表値の合計になる | ex-mae-nonadditive |
データ $1,2,4,7$ では、$L$ は区間 $[2,4]$ のすべての点で最小値 $8$ をとる(ex-mae-main-check)。「絶対誤差の和を最小にする点はただ 1 つ」という主張は、奇数個という仮定を外すと成り立たない。高校で中央値を $\frac{2+4}2=3$ と決めるのは、この区間から中点を選ぶ約束である。ただし ex-mae-duplicates のように、偶数個でも真ん中の 2 つが等しければ 1 点になる。
データ $1,2,3,10$ の平均値は $\frac{16}4=4$ で、$L(4)=3+2+1+6=12$ である。中央値の集合は $[2,3]$ で、最小値は $(10-1)+(3-2)=10$ である。実際 $L(2)=1+0+1+8=10$、$L(2.5)=1.5+0.5+0.5+7.5=10$ である。平均値は $L$ を最小にしない。ex-mae-even-median のデータ $1,2,4,7$ では平均値 $3.5$ が区間 $[2,4]$ に入っていたが、それは偶然である。
3 人の 2 回のテストの点数を $\boldsymbol x=(0,0,1)$、$\boldsymbol y=(1,0,0)$ とする。$\boldsymbol x$ の中央値は $0$、$\boldsymbol y$ の中央値も $0$ である。しかし合計点 $\boldsymbol x+\boldsymbol y=(1,0,1)$ の中央値は $1$ である。平均値なら $\overline{x+y}=\bar x+\bar y$ がつねに成り立つが、中央値では「合計の中央値 $=$ 中央値の合計」が成り立たない。
データ $1,2,3,4,100$ では中央値は $3$ のままで、$L$ の最小値は $(100-1)+(4-2)=101$ である。$L(3)=2+1+0+1+97=101$ で一致する。外れ値 $100$ は $L$ の値を大きくするが、最小点の位置は動かさない。最小点を決めるのは「各データが $a$ のどちら側にあるか」だけで、どれだけ離れているかではないからである(rem-mae-slope)。
ずれの 2 乗は大きなずれを重く数えるので、平均値は外れ値に引っぱられる。ずれの絶対値はずれに比例してしか増えないので、中央値は外れ値の大きさを見ず、どちら側にあるかだけを見る。平均値は足し算と両立し、分散などの計算がきれいに進む。中央値は計算の道具が少ない代わりに、外れ値に強い。どちらが正しい中心かではなく、ずれをどう測るかの選択である。
さらに先へ
- 確率変数についても、$E|X-a|$ を最小にするのは中央値である。その定義と証明は 確率分布の中央値 で扱う。
- $0<\tau<1$ について、ずれ $u=x_i-a$ を、$u\ge0$ なら $\tau u$、$u<0$ なら $(\tau-1)u$ で測って足すと、その和を最小にするのは小さい方から割合 $\tau$ の位置にある値(分位点。中央値と同じく 1 点とは限らない)になる。$\tau=\frac12$ なら測り方は $\frac12|u|$ で、中央値に戻る。rem-mae-slope と同じように数えると、傾きは $(1-\tau)\#\{i : x_i< a\}-\tau\#\{i : x_i>a\}$ であり、これが負から正に変わる点を調べればよい。
- 2 乗の和の平方根は $\mathbb{R}^n$ の長さ($L^2$ ノルム)、絶対値の和は別の長さ($L^1$ ノルム)であり、平均値と中央値の違いは「最も近い定数」を測る長さの違いとして一般化される(Lp空間)。
関連項目
- 案内: 平均・中央値・分散
- 前提: 絶対値, 平均値と二乗誤差
- 次に読む: 確率分布の中央値
- 関連(高校数学): 絶対値と三角不等式, 2次関数の最大・最小, 絶対値を含む関数のグラフ
- 発展: 分位点, Lp空間
- 比較: 相関係数(高校数学), 標本平均の分散
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

