F分布
概要
F 分布(F distribution)とは、独立な 2 つのカイ二乗分布の変数を自由度で割った比の分布である。自由度 $(a,b)$ の密度はベータ分布の変数変換から得られ、$b/2$ 次未満の積率は $\Gamma$ 関数で書ける。逆数は $F(b,a)$ に従い、$t$ 分布の変数の 2 乗は $F(1,b)$ に従う。2 つの母分散の比の推定、分散分析、回帰の $F$ 検定で使う。
F 分布(F distribution)は、独立な 2 つの カイ二乗分布 の変数を自由度で割った比の分布である。統計では、2 つのばらつきの大きさを比べるときに現れる。ばらつきの推定量は未知の分散を尺度として含むが、比をとると尺度が消え、分布が自由度だけで決まる。2 つの母分散の比較と 回帰分析 の $F$ 検定、群の平均の比較である分散分析は、すべてこの性質を使う。
この記事では次のことを示す。
- 密度と分布関数(thm-fd-density)。ベータ分布への帰着が計算の中心である。
- 逆数、$t$ 分布、Cauchy 分布との関係と、下側の点の求め方(prop-fd-relations)。
- 積率の閉じた式(thm-fd-moments)と、$b/2$ 次より上の積率がないこと。
- 自由度が大きいときの極限(thm-fd-limits)。
- 母分散の比の推定(thm-fd-variance-ratio)と分散分析(thm-fd-anova)。
- 正規性・等分散性を外すとどう成り立たなくなるか(反例の表)。
平均と分散の値は 確率分布の一覧 の表に、密度の別の導出は 確率変数の変換 の例「F 分布の密度」にある。入れ子の線形モデルの比較は 回帰分析 が持つので、ここでは最も簡単な場合である一元配置を扱う。
定義
$a,b>0$ とし、$U\sim\chi^2_a$、$V\sim\chi^2_b$ を独立な確率変数とする。
$$
X:=\frac{U/a}{V/b}
$$
の分布を 自由度 $(a,b)$ の F 分布 といい、$F(a,b)$ と書く。$a$ を第 1 自由度(分子の自由度)、$b$ を第 2 自由度(分母の自由度)という。
$a,b$ が正の整数なら、独立な標準正規分布の変数 $Z_i,W_j$ によって $X=\frac{(Z_1^2+\dots+Z_a^2)/a}{(W_1^2+\dots+W_b^2)/b}$ と書ける(ER10 Definition 4.6.3、p. 241)。定義は 回帰分析 の定義「F 分布と上側の点」と同じで、正の実数の自由度にも広げてある。
$0< \alpha< 1$ について、$P(X>c)=\alpha$ となる $c$ を $F_{a,b}(\alpha)$ と書き、上側 $100\alpha\%$ 点 という。
密度と分布関数
$X\sim F(a,b)$ とする。
(1) $B:=\dfrac{aX}{b+aX}=\dfrac U{U+V}$ は $\mathrm{Beta}(\frac a2,\frac b2)$ に従う。
(2) $X$ の密度は $x>0$ で
$$
f_{a,b}(x)=\frac{(a/b)^{a/2}}{B(\frac a2,\frac b2)}\,x^{a/2-1}\Bigl(1+\frac{ax}b\Bigr)^{-\frac{a+b}2}
$$
である。
(3) $P(X\le x)=I_{ax/(b+ax)}\bigl(\frac a2,\frac b2\bigr)$ である。$I_w(p,q)$ は $\mathrm{Beta}(p,q)$ の分布関数(正則化された不完全ベータ関数)である。
$\chi^2_\nu=\mathrm{Gamma}(\frac\nu2,\frac12)$ である(カイ二乗分布)。ベータ分布 の定理「ガンマ分布の割合と和」により $U/(U+V)\sim\mathrm{Beta}(\frac a2,\frac b2)$ である。$X=\frac{bU}{aV}$ から $\frac{aX}{b+aX}=\frac{U}{U+V}$ なので (1) を得る。
$\beta(x):=\frac{ax}{b+ax}$ は $(0,\infty)$ から $(0,1)$ への増加する全単射なので、(3) が従う。$\beta'(x)=\frac{ab}{(b+ax)^2}$、$1-\beta=\frac b{b+ax}$ だから、$p=\frac a2$、$q=\frac b2$ とおくと密度は
$$
\frac{\beta^{p-1}(1-\beta)^{q-1}}{B(p,q)}\,\beta'=\frac{(ax)^{p-1}b^{q-1}\,ab}{B(p,q)\,(b+ax)^{p+q}}=\frac{a^pb^q\,x^{p-1}}{B(p,q)\,(b+ax)^{p+q}}
$$
である。$(b+ax)^{p+q}=b^{p+q}(1+\frac{ax}b)^{p+q}$ で割り直すと (2) になる。$\square$
これは ER10 Theorem 4.6.9(p. 241)の密度である。(1) により、F 分布の計算はすべてベータ分布の計算に移せる。
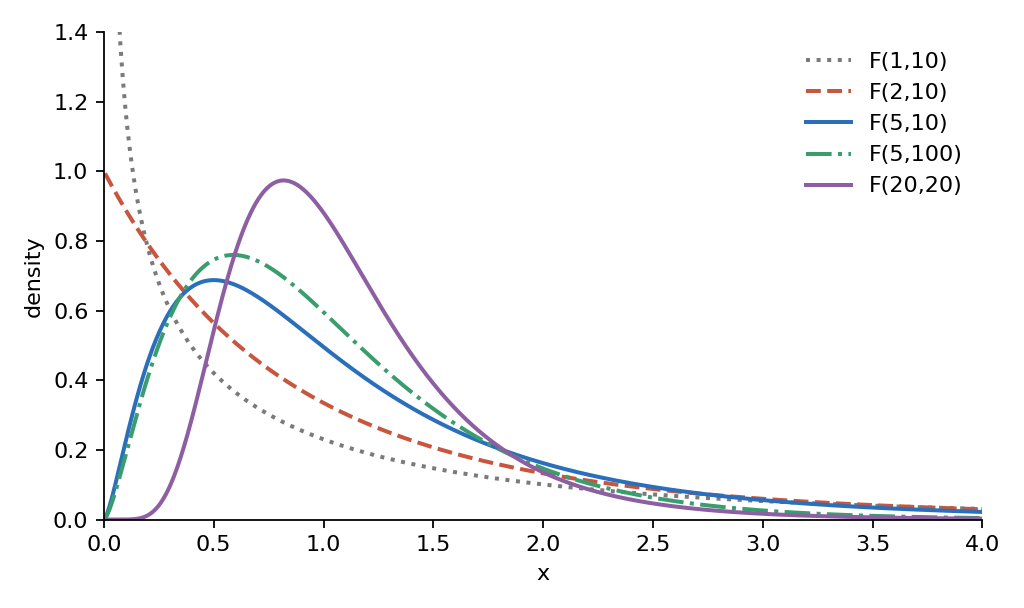 横軸 x が 0 から 4 の範囲で、自由度 (1,10)、(2,10)、(5,10)、(5,100)、(20,20) の密度を重ねた図。(1,10) は原点で発散し、(2,10) は原点で値 1 をとって減少する。(5,10) と (5,100) は原点で 0 から山をもち、(20,20) は 1 の近くに集まる。
図のとおり、密度の形は $a$ で 3 通りに分かれる。$a< 2$ なら原点で発散し、$a=2$ なら $f(0)=1$ で減少し、$a>2$ なら $f(0)=0$ で山を 1 つもつ。山の位置(最頻値)は、$\log f$ を微分して $0$ とおくと
$$
\frac{a-2}a\cdot\frac b{b+2}\qquad(a>2)
$$
である。これは $1$ より小さい。
他の分布との関係
- $X\sim F(a,b)$ なら $1/X\sim F(b,a)$ である。したがって $F_{a,b}(1-\alpha)=\dfrac1{F_{b,a}(\alpha)}$ である。
- $T\sim t_b$ なら $T^2\sim F(1,b)$ である。したがって $F_{1,b}(\alpha)=t_b(\alpha/2)^2$ である。$F(1,1)$ は標準 Cauchy 分布の変数の 2 乗の分布である。
- $F(2,b)$ については $P(X>x)=\bigl(1+\frac{2x}b\bigr)^{-b/2}$ である。$F(a,2)$ については $P(X\le x)=\bigl(\frac{ax}{2+ax}\bigr)^{a/2}$ である。
- $F(a,a)$ の中央値は $1$ である。
- 定義の分数の上下を入れ替えると $1/X$ は $F(b,a)$ の形である。$c:=F_{a,b}(1-\alpha)$ とすると $P(X>c)=1-\alpha$、すなわち $P(1/X>1/c)=\alpha$($X$ は連続分布)なので $1/c=F_{b,a}(\alpha)$ である。
- t分布 の定理「$t$ 分布の密度」により、$T$ は $Z/\sqrt{W/b}$($Z\sim N(0,1)$ と $W\sim\chi^2_b$ が独立)と同じ分布に従い、$Z^2\sim\chi^2_1$ である。$P(T^2>c)=2P(T>\sqrt c)$ から点の関係を得る。$t_1$ は標準 Cauchy 分布である。
- $a=2$ のとき $B(1,\frac b2)=\frac2b$ なので $f_{2,b}(x)=(1+\frac{2x}b)^{-1-b/2}$ で、積分すると第 1 式を得る。第 2 式は (1) と第 1 式から $P(X\le x)=P(1/X\ge1/x)=(1+\frac2{ax})^{-a/2}$ である。
-
- により $X$ と $1/X$ は同じ分布なので $P(X< 1)=P(X>1)$ で、$X$ は連続分布である。$\square$
- と (2) は ER10 Theorem 4.6.10、4.6.12(pp. 241–242)である。数表の多くが上側の点だけを載せているのは (1) による。
積率と裾
$X\sim F(a,b)$ とする。実数 $r$ について、$E[X^r]< \infty$ であることと $-\frac a2< r< \frac b2$ は同値で、そのとき
$$
E[X^r]=\Bigl(\frac ba\Bigr)^r\frac{\Gamma(\frac a2+r)\,\Gamma(\frac b2-r)}{\Gamma(\frac a2)\,\Gamma(\frac b2)}
$$
である。$x\to\infty$ で $f_{a,b}(x)$ は $x^{-b/2-1}$ の定数倍に漸近する。
$U\sim\chi^2_\nu$ の密度から、$r>-\frac\nu2$ なら $E[U^r]=2^r\Gamma(\frac\nu2+r)/\Gamma(\frac\nu2)$ で、$r\le-\frac\nu2$ なら密度の原点の $u^{\nu/2-1}$ により $E[U^r]=\infty$ である。独立性から $E[X^r]=(\frac ba)^rE[U^r]E[V^{-r}]$ であり(値は $[0,\infty]$ で考える)、$r>-\frac a2$ と $-r>-\frac b2$ の両方が必要十分である。代入すると $2^r2^{-r}=1$ で主張の式になる。
裾は thm-fd-density の (2) の式で $(1+\frac{ax}b)^{-\frac{a+b}2}\sim(\frac{ax}b)^{-\frac{a+b}2}$ とすればよい。$\square$
この式は、$X$ の Mellin 変換 $E[X^{s-1}]$ を与えている(Mellin変換 の命題「積の分布と一意性」)。$(1+t)^{-\rho}$ の変換の行と同じ形である。
$b>2$ なら $E[X]=\dfrac b{b-2}$ である。$b>4$ なら $\mathrm{Var}(X)=\dfrac{2b^2(a+b-2)}{a(b-2)^2(b-4)}$ である。
$r=1$ で $\Gamma(\frac a2+1)/\Gamma(\frac a2)=\frac a2$、$\Gamma(\frac b2-1)/\Gamma(\frac b2)=\frac2{b-2}$ なので $E[X]=\frac ba\cdot\frac a2\cdot\frac2{b-2}=\frac b{b-2}$ である。$r=2$ で同様に $E[X^2]=\frac{b^2(a+2)}{a(b-2)(b-4)}$ で、$E[X]^2$ を引いて通分すると分散の式を得る。$\square$
平均は第 1 自由度によらない。また $b\le2$ なら平均がなく、$b\le4$ なら分散がない。$b$ の小さい F 分布は裾が重く、thm-fd-limits の近似は上側の点で悪くなる。
自由度が大きいとき
- $a$ を固定して $b\to\infty$ とすると、$X_b\sim F(a,b)$ について $aX_b$ は $\chi^2_a$ に分布収束する。
- $b$ を固定して $a\to\infty$ とすると、$X_a\sim F(a,b)$ について $b/X_a$ は $\chi^2_b$ に分布収束する。
- 正の整数 $a,b$ を $a,b\to\infty$ とすると(速さの関係は問わない)、$X\sim F(a,b)$ について
$$ \sqrt{\frac{ab}{2(a+b)}}\,\log X $$
は標準正規分布に分布収束する。
- $V_b\sim\chi^2_b$ は平均 $b$、分散 $2b$ なので、Chebyshevの不等式 により $V_b/b\to1$(確率収束)である。$aX_b=U/(V_b/b)$ で、$U$ の分布は $b$ によらない。Slutsky の補題から主張を得る(ER10 Theorem 4.6.11、p. 242)。
-
- と prop-fd-relations の (1) による。
- $L_\nu:=\sqrt{\nu/2}\,\log(V_\nu/\nu)$ とおく。カイ二乗分布 の命題「正規分布による近似」により $\sqrt{\nu/2}\,(V_\nu/\nu-1)$ は標準正規分布に分布収束し、$V_\nu/\nu\to1$ である。$\log y=(y-1)(1+o(1))$($y\to1$)から $L_\nu$ も標準正規分布に分布収束する。
$c:=\frac b{a+b}$、$d:=\frac a{a+b}$ とおくと $c+d=1$ で、主張の変数は $\sqrt c\,L_a-\sqrt d\,L_b'$($L_b'$ は $L_a$ と独立で $L_b$ と同分布)に等しい。実際 $\sqrt{\frac{ab}{2(a+b)}}=\sqrt c\sqrt{\frac a2}=\sqrt d\sqrt{\frac b2}$ である。
$a,b\to\infty$ の任意の列から、$c\to c_*\in[0,1]$ となる部分列をとる。その部分列で、Slutsky の補題により $\sqrt c\,L_a$ は $N(0,c_*)$ に、$\sqrt d\,L_b'$ は $N(0,1-c_*)$ に分布収束する。分布収束から特性関数の各点収束が従うので(Dur19 Theorem 3.3.17 の (i)、p. 132)、独立性から $\sqrt c\,L_a-\sqrt d\,L_b'$ の特性関数は
$$ e^{-c_*\tau^2/2}\,e^{-(1-c_*)\tau^2/2}=e^{-\tau^2/2} $$
に収束する。特性関数(確率論) の定理「Lévy の連続性定理」により、部分列の上で標準正規分布に分布収束する。どの部分列からも同じ極限をもつ部分列がとれるので、全体が収束する。$\square$
- から $\frac12\log X$ は、平均がほぼ $0$、分散がほぼ $\frac12(\frac1a+\frac1b)$ の正規分布に近い。$X$ そのものより対数の方が正規分布に近く、分母と分子の役割も対称になる。
統計での使い方
2 つの母分散の比
$Y_1,\dots,Y_m\sim N(\mu_1,\sigma_1^2)$、$Y_1',\dots,Y_n'\sim N(\mu_2,\sigma_2^2)$ がすべて独立で、$m,n\ge2$ とする。標本分散を $S_1^2,S_2^2$ とすると
$$
R:=\frac{S_1^2/\sigma_1^2}{S_2^2/\sigma_2^2}\sim F(m-1,n-1)
$$
である。したがって、$\rho:=\sigma_1^2/\sigma_2^2$ の信頼係数 $1-\alpha$ の信頼区間は
$$
\Bigl[\frac{S_1^2/S_2^2}{F_{m-1,n-1}(\alpha/2)},\ \frac{S_1^2}{S_2^2}\,F_{n-1,m-1}(\alpha/2)\Bigr]
$$
である。
t分布 の定理「Student の定理」により $(m-1)S_1^2/\sigma_1^2\sim\chi^2_{m-1}$、$(n-1)S_2^2/\sigma_2^2\sim\chi^2_{n-1}$ で、2 つは独立である。自由度で割って比をとると $R$ である。
$q_+:=F_{m-1,n-1}(\alpha/2)$、$q_-:=F_{m-1,n-1}(1-\alpha/2)$ とすると $P(q_-\le R\le q_+)=1-\alpha$ である。$r:=S_1^2/S_2^2$ とすると $R=r/\rho$ なので、この事象は $r/q_+\le\rho\le r/q_-$ と同じである。prop-fd-relations の (1) から $1/q_-=F_{n-1,m-1}(\alpha/2)$ である。$\square$
$\sigma_1=\sigma_2$ の検定では $\rho=1$ として $r$ を $F(m-1,n-1)$ の点と比べる。信頼区間の考え方は 信頼区間 にある。
一元配置の分散分析
$k\ge2$ 個の群があり、群 $i$ に $n_i$ 個の観測 $Y_{i1},\dots,Y_{in_i}$ があるとする。$N:=\sum_in_i>k$ とする。群の平均を $\bar Y_i$、全体の平均を $\bar Y$ とし、
$$
\mathrm{SSB}:=\sum_in_i(\bar Y_i-\bar Y)^2,\qquad\mathrm{SSW}:=\sum_i\sum_j(Y_{ij}-\bar Y_i)^2
$$
をそれぞれ群間平方和、群内平方和という。全平方和 $\sum_{i,j}(Y_{ij}-\bar Y)^2$ は $\mathrm{SSB}+\mathrm{SSW}$ に等しい。
$Y_{ij}$ がすべて独立で $Y_{ij}\sim N(\mu_i,\sigma^2)$ とする。$\mu_1=\dots=\mu_k$ なら
$$
\frac{\mathrm{SSB}/(k-1)}{\mathrm{SSW}/(N-k)}\sim F(k-1,N-k)
$$
である。
共通の平均を $\mu$ とする。t分布 の定理「Student の定理」を各群に使うと、$\sum_j(Y_{ij}-\bar Y_i)^2/\sigma^2\sim\chi^2_{n_i-1}$ で、これは $\bar Y_i$ と独立である($n_i=1$ の群では和は $0$ である)。群どうしは独立なので、t分布 の定理「カイ二乗分布の再生性」から $\mathrm{SSW}/\sigma^2\sim\chi^2_{N-k}$ で、これは $(\bar Y_1,\dots,\bar Y_k)$ と独立である。
$Z_i:=\sqrt{n_i}(\bar Y_i-\mu)/\sigma$ とおくと、$Z=(Z_1,\dots,Z_k)$ の成分は独立で $N(0,1)$ に従う。単位ベクトル $e:=(\sqrt{n_i/N})_i$ について $Z\cdot e=\sqrt N(\bar Y-\mu)/\sigma$ である。したがって
$$
\frac{\mathrm{SSB}}{\sigma^2}=\sum_iZ_i^2-\frac{N(\bar Y-\mu)^2}{\sigma^2}=\lvert Z\rvert^2-(Z\cdot e)^2
$$
は $Z$ の $e^\perp$ への直交射影の長さの 2 乗である。$e$ を第 1 列とする直交行列で $Z$ を回転すると、成分はまた独立に $N(0,1)$ に従うので(t分布 の定理「Student の定理」の証明の回転と同じ)、$\mathrm{SSB}/\sigma^2\sim\chi^2_{k-1}$ である。$\mathrm{SSW}$ と $\mathrm{SSB}$ が独立なので、定義から主張を得る。$\square$
$k=2$ のときこの統計量は 2 標本の $t$ 統計量の 2 乗で、prop-fd-relations の (2) と合う。一元配置の群の平均のモデルは 回帰分析 の定理の特別な場合でもある(群の指示変数を列にもつ計画行列)。同じ手順は ER10 §10.4.1(p. 577)に述べられている。
平均が等しくないとき、$\mathrm{SSB}/\sigma^2$ は自由度 $k-1$、非心度 $\lambda=\sum_in_i(\mu_i-\bar\mu)^2/\sigma^2$($\bar\mu=\sum_in_i\mu_i/N$)の非心カイ二乗分布に従う。回転の議論で $Z$ に平均がつくだけである。この場合の統計量の分布を 非心 F 分布 という。$E[\text{非心}\chi^2_a(\lambda)]=a+\lambda$ と独立性から、その平均は $b>2$ で $\frac{b(a+\lambda)}{a(b-2)}$ である。検出力はこの分布の上側確率で計算する(分散分析 の系「一元配置の検出力」)。
例
prop-fd-relations の (3) から、$F(2,10)$ の上側 $5\%$ 点は $(1+\frac x5)^{-5}=0.05$ を解いて $x=5(0.05^{-1/5}-1)\approx4.1028$ である。$F(10,2)$ では $P(X\le3)=(\frac{30}{32})^5\approx0.72420$ である。
$F_{10,5}(0.05)\approx4.7351$ なので、$F_{5,10}(0.95)=1/4.7351\approx0.21119$ である。$t_{10}(0.025)\approx2.22814$ なので、$F_{1,10}(0.05)=2.22814^2\approx4.9646$ である。
$F(5,10)$ の最頻値は $\frac35\cdot\frac{10}{12}=0.5$、中央値は約 $0.9319$、平均は $1.25$、分散は $\frac{2\cdot100\cdot13}{5\cdot64\cdot6}\approx1.3542$ である。最頻値、中央値、平均の順に大きく、右に長い分布である。$r=3$ の積率はあるが、$r=5$ の積率はない。
$m=11$、$n=16$、$S_1^2=9$、$S_2^2=4$ とする。$r=2.25$ である。$F_{10,15}(0.025)\approx3.0602$、$F_{15,10}(0.025)\approx3.5217$ なので、$\rho$ の信頼係数 $95\%$ の信頼区間は
$$
\Bigl[\frac{2.25}{3.0602},\ 2.25\cdot3.5217\Bigr]\approx[0.7352,\ 7.9238]
$$
である。区間は $1$ を含むので、$\sigma_1=\sigma_2$ は水準 $5\%$ の両側検定で棄却されない。両側の $p$ 値は $2P(F(10,15)>2.25)\approx0.1515$ である。
3 群の観測が $\{4,6,5,7\}$、$\{7,9,8\}$、$\{3,5,4,4,4\}$ であるとする。$k=3$、$N=12$ である。群の平均は $5.5,\ 8,\ 4$、全体の平均は $5.5$ である。
$$
\mathrm{SSB}=4\cdot0^2+3\cdot2.5^2+5\cdot1.5^2=30,\qquad\mathrm{SSW}=5+2+2=9
$$
である。統計量は $\frac{30/2}{9/9}=15$ で、$F_{2,9}(0.05)\approx4.2565$ より大きい。$p$ 値は $P(F(2,9)>15)\approx0.00136$ である。
反例:条件を外すと成り立たないこと
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| def-fd-main の独立性 | $U=V\sim\chi^2_a$、$a=b$ | $X\equiv1$ で、F 分布でない |
| def-fd-main の自由度で割ること | $a\ne b$ の $U/V$ | $U/V=\frac abX$ で、$a=6$、$b=10$ なら平均は $F(6,10)$ の $1.25$ でなく $0.75$ である |
| cor-fd-mean-var の $b>2$ | $F(5,2)$ | 平均が $\infty$ である |
| thm-fd-variance-ratio の正規性 | Laplace 分布の標本($m=n$) | 名目 $5\%$ の両側検定の実際の棄却率が約 $21.5\%$ に近づく |
| thm-fd-anova の等分散性 | 2 群、$n_1=n_2=3$、$\sigma_1=1$、$\sigma_2=0$ | 統計量は $F(1,4)$ でなく $F(1,2)$ に従い、名目 $5\%$ の棄却率は約 $10.9\%$ である |
| prop-fd-relations の (1) の添字の入れ替え | $F_{5,10}(0.95)$ を $1/F_{5,10}(0.05)$ とする | $1/3.3258\approx0.3007$ で、正しい値 $0.2112$ と違う |
Laplace 分布:平均 $0$、尖度 $\kappa=E[Y^4]/E[Y^2]^2$ の分布の標本では、$n\to\infty$ で $\mathrm{Var}(S^2)\approx\sigma^4(\kappa-1)/n$ である。正規分布の $\kappa=3$ では $2\sigma^4/n$ で、thm-fd-limits の (3) の分散はこれに基づく。Laplace 分布は $\kappa=6$ なので、$\log(S_1^2/S_2^2)$ の分散は $\frac{\kappa-1}2=2.5$ 倍になる。棄却率の極限は、分散 $2.5$ の正規変数 $W$ について $P(\lvert W\rvert>1.96)\approx0.215$ で、$m=n$ を大きくしても $5\%$ に戻らない。標本の平均の検定と違い、分散比の検定では大標本でも正規性の影響が残る。
等分散でない 2 群:第 2 群は定数なので $\bar Y_2=\mu$ で、$\mathrm{SSW}$ は第 1 群だけから来る。$\bar Y_1-\mu\sim N(0,\frac13)$ から $\mathrm{SSB}=\frac32(\bar Y_1-\mu)^2=\frac12Z^2$($Z\sim N(0,1)$)、$\mathrm{SSW}\sim\chi^2_2$ で独立である。統計量は $\frac{Z^2/2}{\mathrm{SSW}/4}=\frac{Z^2}{\mathrm{SSW}/2}\sim F(1,2)$ である。$F_{1,4}(0.05)\approx7.7086$ で、$P(F(1,2)>7.7086)\approx0.1089$ である。$\sigma_2=0$ は極端な場合だが、$\sigma_2$ が小さい場合はこれに近い。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| $F(a,b)$ と $F(b,a)$ を同じとする | 逆数の関係で、一般に別の分布 | prop-fd-relations の (1) |
| 平均を $1$ とする | $\frac b{b-2}$ で $1$ より大きく、$a$ によらない | cor-fd-mean-var |
| 分散比の検定を、平均の検定のように頑健と考える | 大標本でも非正規性の影響が残る | ex-fd-counterexamples |
| 分子と分母に自由度の割り算を忘れる | 平方和でなく、平方和を自由度で割った平均平方の比をとる | def-fd-main |
| 分散分析で有意なら全部の群が違うとする | 否定されるのは「すべて等しい」だけ | thm-fd-anova の帰無仮説。個別の比較は 多重検定 |
補足
- 尤度比検定:thm-fd-anova の統計量は、平均がすべて等しいというモデルの尤度比の単調な関数である(回帰分析 の入れ子のモデルの $F$ 統計量と同じ形)。一般論は 尤度比検定 にある。
- 決定係数:$\mathrm{SSB}/(\mathrm{SSB}+\mathrm{SSW})$ は thm-fd-density の (1) の形で、帰無仮説のもとで $\mathrm{Beta}(\frac{k-1}2,\frac{N-k}2)$ に従う。
関連項目
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

