正規分布(高校数学)
概要
正規分布(normal distribution)とは、密度関数 $\frac1{\sqrt{2\pi}\sigma}e^{-(x-\mu)^2/(2\sigma^2)}$ をもつ分布 $N(\mu,\sigma^2)$ であり、確率は標準化と正規分布表で計算する。$X$ が $N(\mu,\sigma^2)$ に従えば、$a\ne0$ のとき $aX+b$ は $N(a\mu+b,a^2\sigma^2)$ に従い、特に標準化 $Z=(X-\mu)/\sigma$ は標準正規分布 $N(0,1)$ に従うので、1 枚の表と左右対称ですべての確率が求まる。平均から標準偏差の $1,2,3$ 倍以内に入る確率は約 $68\%$、$95\%$、$99.7\%$ で、正規分布に特有の値である。独立な正規分布の和は正規分布だが、独立でないと、どちらも正規分布でも和が正規分布にならないことがある。
前提知識: 確率密度関数と連続型確率変数, Gauss積分(高校数学), 置換積分, 確率変数の期待値と分散
高校での出発点:正規分布表で確率を求める
身長や、同じものを何度も測ったときの測定値のばらつきを度数分布にすると、平均のあたりが高く左右になだらかに下がる、釣鐘の形になることが多い。この形を表す分布が 正規分布 である。数学 B では、確率変数 $X$ が平均 $\mu$、標準偏差 $\sigma$ の正規分布 $N(\mu,\sigma^2)$ に従うとき、次の手順で確率を求める。
- 標準化する:$Z=\dfrac{X-\mu}\sigma$ とおく。$Z$ は標準正規分布 $N(0,1)$ に従う。
- 正規分布表で $u(z)=P(0\le Z\le z)$ の値を読み、グラフの左右対称を使って組み合わせる。
この記事で使う表の値(小数第 4 位まで)を先に並べておく。値の出どころは rem-nrm-table-values で述べる。まず 2 つの例で手順を確かめる。$z$ $0.5$ $1$ $1.28$ $1.5$ $1.645$ $1.96$ $2$ $2.58$ $3$ $u(z)$ $0.1915$ $0.3413$ $0.3997$ $0.4332$ $0.4500$ $0.4750$ $0.4772$ $0.4951$ $0.4987$
ある集団の身長 $X$(cm)が、平均 $170$、標準偏差 $6$ の正規分布 $N(170,6^2)$ に従うとする。
- $179$ cm 以上の人の割合。$Z=\frac{X-170}6$ とすると、$X\ge179$ は $Z\ge\frac{179-170}6=1.5$ と同じである。$Z\ge0$ の確率は $0.5$ なので
$$ P(X\ge179)=P(Z\ge1.5)=0.5-u(1.5)=0.5-0.4332=0.0668 $$
で、約 $6.7\%$ である。 - $164$ cm 以上 $182$ cm 以下の割合。$\frac{164-170}6=-1$、$\frac{182-170}6=2$ なので、$P(-1\le Z\le2)$ を求める。$-1\le Z\le0$ の部分の確率は、左右対称により $u(1)$ に等しい。よって
$$ P(164\le X\le182)=u(1)+u(2)=0.3413+0.4772=0.8185 $$
である。 - 上位 $10\%$ の境目。$P(Z\ge c)=0.1$ となる $c$ は $u(c)=0.5-0.1=0.4$ を満たす。表では $u(1.28)=0.3997$ なので $c\approx1.28$ で、境目は $X=170+6\times1.28=177.68$、約 $177.7$ cm である。
$Z$ が標準正規分布に従うとき、$-1.96\le Z\le1.96$ となる確率は、左右の部分がどちらも $u(1.96)$ なので
$$
P(-1.96\le Z\le1.96)=2u(1.96)=2\times0.4750=0.95
$$
である。区間推定(高校数学) で信頼度 $95\%$ の区間に $1.96$ が現れるのは、この計算による。同じように $2u(1)=0.6826$、$2u(2)=0.9544$、$2u(3)=0.9974$ で、表から求めた値は、正確な値 $0.6827$、$0.9545$、$0.9973$(小数第 5 位を四捨五入)と最後の桁がずれる(表の値が四捨五入されているため)。
ここで次の問いが出てくる。
- 平均も標準偏差も違う正規分布が、なぜ 1 枚の表で済むのか。→ thm-nrm-linear
- 表には $z\ge0$ の値しかないのに、なぜ負の $z$ も扱えるのか。→ prop-nrm-symmetry
- $\mu$ と $\sigma$ は、グラフのどこに現れるのか。→ prop-nrm-shape、prop-nrm-moments
- 「平均 $\pm$ 標準偏差の中に約 $68\%$」は、どんな分布でも成り立つのか。→ cor-nrm-sigma-rule、ex-nrm-counter-uniform
- 正規分布に従う量を足すと、また正規分布になるのか。→ thm-nrm-sum、ex-nrm-counter-dependent
高校の計算 この記事での見方 ボックス $N(\mu,\sigma^2)$ の釣鐘形の曲線 密度関数 $\frac1{\sqrt{2\pi}\sigma}e^{-(x-\mu)^2/(2\sigma^2)}$、変曲点が $\mu\pm\sigma$ def-nrm-normal、prop-nrm-shape 標準化 $Z=\frac{X-\mu}\sigma$ 正規分布は 1 次式で変換しても正規分布 thm-nrm-linear 表は $z\ge0$ だけ 密度関数が偶関数 prop-nrm-symmetry $68$–$95$–$99.7$ の目安 $P(\lvert X-\mu\rvert\le k\sigma)$ は $\mu$、$\sigma$ によらない cor-nrm-sigma-rule 平均 $\mu$、分散 $\sigma^2$ 部分積分による計算 prop-nrm-moments 正規分布の和 独立なら正規分布(引用) thm-nrm-sum
正規分布の定義
密度関数と連続型確率変数の考え方は 確率密度関数と連続型確率変数 で扱った。区間に入る確率が、密度関数のグラフの下の面積で与えられる確率変数である。
$$
\varphi(x):=\frac1{\sqrt{2\pi}}e^{-x^2/2}
$$
を密度関数とする分布を 標準正規分布 といい、$N(0,1)$ と書く。実数 $\mu$ と正の数 $\sigma$ について
$$
f(x):=\frac1{\sqrt{2\pi}\,\sigma}\,e^{-\frac{(x-\mu)^2}{2\sigma^2}}=\frac1\sigma\varphi\Bigl(\frac{x-\mu}\sigma\Bigr)
$$
を密度関数とする分布を、平均 $\mu$、分散 $\sigma^2$ の 正規分布 といい、$N(\mu,\sigma^2)$ と書く。$Z$ が $N(0,1)$ に従うとき、$z\ge0$ に対して
$$
u(z):=P(0\le Z\le z)=\int_0^z\varphi(x)\,dx
$$
とおく。正規分布表は $u(z)$ の値の表である。
「平均 $\mu$、分散 $\sigma^2$」という呼び名が正しいこと、つまり $N(\mu,\sigma^2)$ に従う確率変数の期待値と分散が本当に $\mu$ と $\sigma^2$ であることは、prop-nrm-moments で示す。また、$\varphi$ と $f$ が密度関数の条件($0$ 以上で、全体の積分が $1$)を満たすことは次の命題で確かめる。
$\displaystyle\int_{-\infty}^{\infty}\varphi(x)\,dx=1$ であり、すべての $\mu$、$\sigma>0$ について $\displaystyle\int_{-\infty}^{\infty}\frac1\sigma\varphi\Bigl(\frac{x-\mu}\sigma\Bigr)dx=1$ である。
方針:Gauss 積分 $\int_{-\infty}^{\infty}e^{-t^2}\,dt=\sqrt\pi$ に、置換積分で帰着させる。
準備(対称な区間から両側の広義積分へ)。この記事の広義積分 $\int_{-\infty}^{\infty}$ は、$\int_{-\infty}^0$ と $\int_0^\infty$ がそれぞれ収束するときの和である(確率密度関数と連続型確率変数)。被積分関数 $g$ が $0$ 以上のときは、ある点 $a$ を中心とする区間の積分 $\int_{a-R}^{a+R}g$ が $R\to\infty$ で有限の値 $L$ に近づけば、$\int_a^{a+R}g$ と $\int_{a-R}^{a}g$ はどちらも $R$ について増加し、$L$ 以下に押さえられるので収束し(上に有界な増加関数は収束する。本記事では証明しない)、両側の和は $L$ になる。区切りの点を $a$ から $0$ に変えても値は変わらない。以下の段 1〜3、prf-nrm-symmetry の段 2、prf-nrm-moments の分散の段では、被積分関数がどれも $0$ 以上なので、対称な区間の極限から $\int_{-\infty}^{\infty}$ の値を出してよい。
段 1(Gauss 積分)。Gauss積分(高校数学) で $\int_0^\infty e^{-t^2}\,dt=\frac{\sqrt\pi}2$ を証明している。$e^{-t^2}$ は偶関数なので、$t=-s$ と置換すると $\int_{-R}^0e^{-t^2}\,dt=\int_0^Re^{-s^2}\,ds$ である。よって $\int_{-\infty}^{\infty}e^{-t^2}\,dt=2\cdot\frac{\sqrt\pi}2=\sqrt\pi$ である。
段 2($\varphi$ の積分)。$x=\sqrt2\,t$ と置換すると、$dx=\sqrt2\,dt$、$\frac{x^2}2=t^2$ なので
$$
\int_{-R}^{R}e^{-x^2/2}\,dx=\sqrt2\int_{-R/\sqrt2}^{R/\sqrt2}e^{-t^2}\,dt
$$
である。$R\to\infty$ とすると右辺は $\sqrt2\cdot\sqrt\pi=\sqrt{2\pi}$ に近づく。両辺を $\sqrt{2\pi}$ で割って $\int_{-\infty}^{\infty}\varphi(x)\,dx=1$ を得る。
段 3(一般の $\mu$、$\sigma$)。$x=\mu+\sigma t$ と置換すると、$dx=\sigma\,dt$、$\frac{x-\mu}\sigma=t$ なので
$$
\int_{\mu-\sigma R}^{\mu+\sigma R}\frac1\sigma\varphi\Bigl(\frac{x-\mu}\sigma\Bigr)dx=\int_{-R}^{R}\varphi(t)\,dt
$$
であり、$R\to\infty$ として段 2 から $1$ を得る。$\square$
- $\varphi(0)=\frac1{\sqrt{2\pi}}=0.3989\ldots$、$\varphi(1)=\frac{e^{-1/2}}{\sqrt{2\pi}}=0.2419\ldots$、$\varphi(2)=\frac{e^{-2}}{\sqrt{2\pi}}=0.0539\ldots$、$\varphi(3)=\frac{e^{-9/2}}{\sqrt{2\pi}}=0.0044\ldots$ である。$0$ から離れると、指数の $-\frac{x^2}2$ のために急に小さくなる。
- ex-nrm-height の $N(170,6^2)$ の密度の最大値は $f(170)=\frac16\varphi(0)=0.0664\ldots$ である。$\sigma$ が大きいほど山は低く、横に広がる(全体の面積はいつも $1$)。
グラフの形
- $\varphi$ は 偶関数 で、$x<0$ で増加、$x>0$ で減少し、$x=0$ で最大値 $\frac1{\sqrt{2\pi}}$ をとる。変曲点は $x=\pm1$ である。
- $N(\mu,\sigma^2)$ の密度 $f$ のグラフは直線 $x=\mu$ について対称で、$x=\mu$ で最大値 $\frac1{\sqrt{2\pi}\sigma}$ をとり、変曲点は $x=\mu\pm\sigma$ である。
方針:$\varphi'(x)=-x\varphi(x)$、$\varphi''(x)=(x^2-1)\varphi(x)$ を計算し、$\varphi(x)>0$ を使って符号を調べる。2 は 1 を平行移動と拡大で移したものとして扱う。
段 1(1 階微分)。$(e^{-x^2/2})'=-xe^{-x^2/2}$(連鎖律(高校数学))なので $\varphi'(x)=-x\varphi(x)$ である。$\varphi(x)>0$ だから、$\varphi'(x)$ の符号は $-x$ の符号と同じで、$x<0$ で正、$x>0$ で負である。よって $\varphi$ は $x<0$ で増加、$x>0$ で減少し、$x=0$ で最大値 $\varphi(0)=\frac1{\sqrt{2\pi}}$ をとる。$\varphi(-x)=\varphi(x)$ は $(-x)^2=x^2$ から出る。
段 2(2 階微分)。積の微分により $\varphi''(x)=-\varphi(x)-x\varphi'(x)=-\varphi(x)+x^2\varphi(x)=(x^2-1)\varphi(x)$ である。符号は $x^2-1$ と同じで、$|x|>1$ で正(下に凸)、$|x|<1$ で負(上に凸)である。$x=\pm1$ の前後で符号が変わるので、変曲点は $x=\pm1$ である。
段 3($N(\mu,\sigma^2)$)。$f(x)=\frac1\sigma\varphi(s)$、$s=\frac{x-\mu}\sigma$ である。$\frac{ds}{dx}=\frac1\sigma$ なので、$f'(x)=\frac1{\sigma^2}\varphi'(s)$、$f''(x)=\frac1{\sigma^3}\varphi''(s)$ である。$\sigma>0$ なので $f'$、$f''$ の符号はそれぞれ $\varphi'(s)$、$\varphi''(s)$ と同じである。段 1・段 2 から、$f$ は $s<0$($x<\mu$)で増加、$s>0$($x>\mu$)で減少し、変曲点は $s=\pm1$、すなわち $x=\mu\pm\sigma$ である。対称性は $f(\mu+d)=\frac1\sigma\varphi\bigl(\frac d\sigma\bigr)=\frac1\sigma\varphi\bigl(-\frac d\sigma\bigr)=f(\mu-d)$ から出る。$\square$
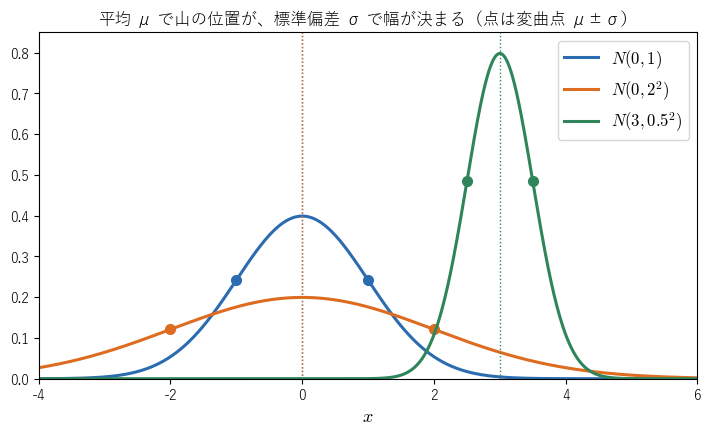 3 つの正規分布の密度。点は変曲点 $\mu\pm\sigma$ を表す。平均 $\mu$ で山の位置が、標準偏差 $\sigma$ で山の幅と高さが決まることを見る図。
標準偏差 $\sigma$ は、グラフの上では「山の中心から変曲点までの距離」である(図1)。$\sigma$ を $2$ 倍にすると、山の幅は $2$ 倍、高さは $\frac12$ 倍になる。
主定理:1 次式で変換しても正規分布
正規分布表が 1 枚で済むのは、どの正規分布も、標準正規分布を伸ばして平行移動したものだからである。
$X$ が $N(\mu,\sigma^2)$ に従い、$a\ne0$、$b$ が定数ならば、$aX+b$ は $N(a\mu+b,\ a^2\sigma^2)$ に従う。特に
- $Z=\dfrac{X-\mu}\sigma$ は $N(0,1)$ に従う(標準化)。
- 逆に、$Z$ が $N(0,1)$ に従えば、$X=\mu+\sigma Z$ は $N(\mu,\sigma^2)$ に従う。
- $X$ が $N(\mu,\sigma^2)$ に従うとき、$c\le d$ について
$$ P(c\le X\le d)=P\Bigl(\frac{c-\mu}\sigma\le Z\le\frac{d-\mu}\sigma\Bigr) $$
である(右辺の $Z$ は $N(0,1)$ に従う確率変数)。
方針:まず $a>0$ の場合に、$c\le aX+b\le d$ を $X$ の不等式に直して置換積分し、$aX+b$ の密度を求める。$a<0$ の場合は、$-X$ が $N(-\mu,\sigma^2)$ に従うことを示して $a>0$ の場合に帰着させる。$f$ を $N(\mu,\sigma^2)$ の密度とする。
段 1($a>0$)。$c\le d$ とする。$a>0$ なので、$c\le aX+b\le d$ は $\frac{c-b}a\le X\le\frac{d-b}a$ と同じであり
$$
P(c\le aX+b\le d)=\int_{(c-b)/a}^{(d-b)/a}f(x)\,dx
$$
である。$x=\frac{y-b}a$ と置換すると、$dx=\frac1a\,dy$ で、積分区間は $c\le y\le d$ に変わる。
$$
\frac{y-b}a-\mu=\frac{y-(a\mu+b)}a
$$
なので、$f\bigl(\frac{y-b}a\bigr)=\frac1{\sqrt{2\pi}\sigma}\exp\Bigl(-\frac{(y-(a\mu+b))^2}{2a^2\sigma^2}\Bigr)$ である。よって
$$
P(c\le aX+b\le d)=\int_c^d\frac1{\sqrt{2\pi}\,a\sigma}\exp\Bigl(-\frac{(y-(a\mu+b))^2}{2(a\sigma)^2}\Bigr)dy
$$
となる。被積分関数は、平均 $a\mu+b$、標準偏差 $a\sigma$ の正規分布の密度である(def-nrm-normal の $\mu$ を $a\mu+b$、$\sigma$ を $a\sigma>0$ に替えたもの)。したがって $aX+b$ は $N(a\mu+b,a^2\sigma^2)$ に従う。
段 2($-X$)。$c\le-X\le d$ は $-d\le X\le-c$ と同じなので、$x=-y$ と置換して
$$
P(c\le-X\le d)=\int_{-d}^{-c}f(x)\,dx=\int_c^df(-y)\,dy
$$
である($dx=-dy$ で、積分の上端と下端が入れ替わる分の符号と打ち消し合う)。$(-y-\mu)^2=(y-(-\mu))^2$ なので、$f(-y)=\frac1{\sqrt{2\pi}\sigma}\exp\bigl(-\frac{(y-(-\mu))^2}{2\sigma^2}\bigr)$ は $N(-\mu,\sigma^2)$ の密度である。よって $-X$ は $N(-\mu,\sigma^2)$ に従う。
段 3($a<0$)。$aX+b=(-a)(-X)+b$ で、$-a>0$ である。段 2 から $-X$ は $N(-\mu,\sigma^2)$ に従うので、段 1 を $-X$ と $-a$ に使うと、$aX+b$ は $N\bigl((-a)(-\mu)+b,\ (-a)^2\sigma^2\bigr)=N(a\mu+b,a^2\sigma^2)$ に従う。
段 4(1〜3)。1 は $a=\frac1\sigma$、$b=-\frac\mu\sigma$ の場合で、$a\mu+b=0$、$a^2\sigma^2=1$ である。2 は $a=\sigma$、$b=\mu$ を $Z$($N(0,1)$、つまり平均 $0$、標準偏差 $1$)に使った場合で、$a\cdot0+b=\mu$、$a^2\cdot1=\sigma^2$ である。3 は、$\sigma>0$ なので $c\le X\le d$ と $\frac{c-\mu}\sigma\le\frac{X-\mu}\sigma\le\frac{d-\mu}\sigma$ が同じ事象であることと、1 による。$\square$
一般の密度関数について、$aX+b$ の密度が $\frac1{|a|}f\bigl(\frac{y-b}a\bigr)$ になることは 確率密度関数と連続型確率変数 で示した。正規分布の特別な点は、その結果がまた正規分布の密度の形をしていることである。
- テストの点数 $X$ が $N(62,12^2)$ に従うとする。$80$ 点の人は $\frac{80-62}{12}=1.5$ なので、$P(X\ge80)=P(Z\ge1.5)=0.5-0.4332=0.0668$ で、上位約 $6.7\%$ である。
- $T=50+10\cdot\frac{X-\mu}\sigma$ を 偏差値 という。thm-nrm-linear により、$X$ が正規分布に従えば $T$ は $N(50,10^2)$ に従う。1 の $80$ 点の偏差値は $50+10\times1.5=65$ で、偏差値 $65$ 以上の割合はやはり $P(Z\ge1.5)=0.0668$ である。
- $X$ が $N(1,2^2)$ に従うとき、$Y=2X+3$ は $N(2\cdot1+3,\ 2^2\cdot2^2)=N(5,4^2)$ に従う。$Y=-X$ なら $N(-1,2^2)$ である。
データの標準化と偏差値(データの分析での扱い)は 相関係数(高校数学) の例にもある。そこではデータの平均と標準偏差を使い、分布が正規分布かどうかは問わない。
正規分布表の使い方
左右対称
$Z$ が $N(0,1)$ に従うとき、$z\ge0$ について
$$
P(-z\le Z\le0)=u(z),\qquad P(Z\le-z)=P(Z\ge z)=0.5-u(z),\qquad P(-z\le Z\le z)=2u(z)
$$
が成り立つ。
方針:$\varphi$ が偶関数であることを、置換 $x=-t$ で積分に使う。
段 1($-z$ から $0$ まで)。$x=-t$ と置換すると $dx=-dt$ で、$x=-z$ のとき $t=z$、$x=0$ のとき $t=0$ なので
$$
P(-z\le Z\le0)=\int_{-z}^0\varphi(x)\,dx=\int_z^0\varphi(-t)(-dt)=\int_0^z\varphi(t)\,dt=u(z)
$$
である($\varphi(-t)=\varphi(t)$ を使った)。
段 2(半分ずつ)。段 1 と同じ置換を $-R\le x\le0$ で行うと $\int_{-R}^0\varphi=\int_0^R\varphi$ であり、prop-nrm-total から両方を足した $R\to\infty$ の極限は $1$ なので、$P(Z\le0)=P(Z\ge0)=0.5$ である。
段 3(はしの部分)。$P(Z\ge z)=P(Z\ge0)-P(0\le Z< z)=0.5-u(z)$ である(1 点の確率は $0$ なので、$<$ と $\le$ は区別しなくてよい)。$P(Z\le-z)=P(Z\le0)-P(-z< Z\le0)=0.5-u(z)$ である。最後の式は、$P(-z\le Z\le z)=P(-z\le Z\le0)+P(0< Z\le z)=u(z)+u(z)$ である(第 1 項は段 1、第 2 項は $u(z)$ の定義による)。$\square$
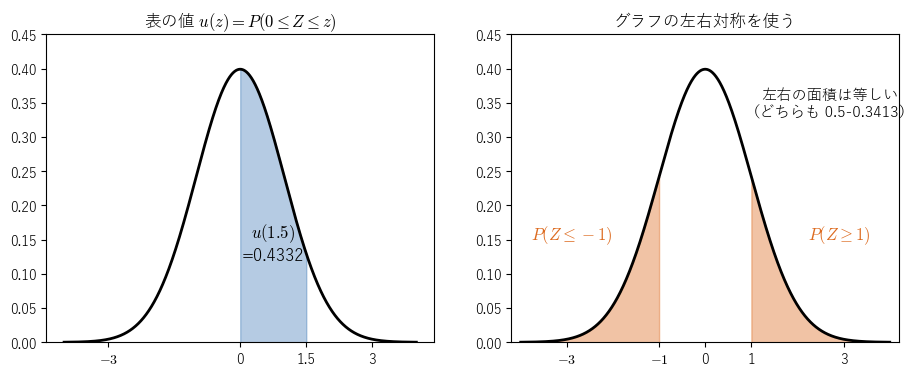 正規分布表の読み方。左は表の値 $u(1.5)=P(0\le Z\le1.5)$ の面積。右は左右対称により $P(Z\le-1)=P(Z\ge1)=0.5-u(1)$ となることを見る図。
$Z$ は $N(0,1)$ に従うとする。
- $P(Z\le-0.5)=0.5-u(0.5)=0.5-0.1915=0.3085$。
- $P(-1.5\le Z\le0.5)=u(1.5)+u(0.5)=0.4332+0.1915=0.6247$($0$ をまたぐので足す)。
- $P(0.5\le Z\le1.5)=u(1.5)-u(0.5)=0.4332-0.1915=0.2417$(同じ側なので引く)。
- 逆に確率から $z$ を求める。$P(Z\ge c)=0.05$ となる $c$ は、$u(c)=0.45$ から $c\approx1.645$ である。$P(-c\le Z\le c)=0.99$ となる $c$ は、$2u(c)=0.99$、$u(c)=0.495$ から $c\approx2.58$ である。
$u(z)=\int_0^z\varphi(x)\,dx$ の $\varphi$ の原始関数は、初等関数(多項式・指数関数・三角関数などを組み合わせた関数)では書けないことが知られている(初等関数で表せない原始関数)。表の値は、区分求積や級数展開による数値計算で作られる。この記事の表の値は数値積分で計算し、小数第 5 位を四捨五入したものである(たとえば $u(1.96)=0.47500\ldots$、$u(3)=0.49865\ldots$)。
平均から標準偏差の何倍以内か
$X$ が $N(\mu,\sigma^2)$ に従うとき、$k>0$ について
$$
P(\mu-k\sigma\le X\le\mu+k\sigma)=2u(k)
$$
であり、この値は $\mu$ と $\sigma$ によらない。$k=1,2,3$ では、それぞれ約 $0.6827$、$0.9545$、$0.9973$ である。
thm-nrm-linear の 3 で $c=\mu-k\sigma$、$d=\mu+k\sigma$ とすると、$\frac{c-\mu}\sigma=-k$、$\frac{d-\mu}\sigma=k$ なので、左辺は $P(-k\le Z\le k)$ である。prop-nrm-symmetry により、これは $2u(k)$ に等しい。$\mu$、$\sigma$ は途中で消えている。数値は $u(1)=0.341344\ldots$、$u(2)=0.477249\ldots$、$u(3)=0.498650\ldots$(数値積分)の 2 倍である。$\square$
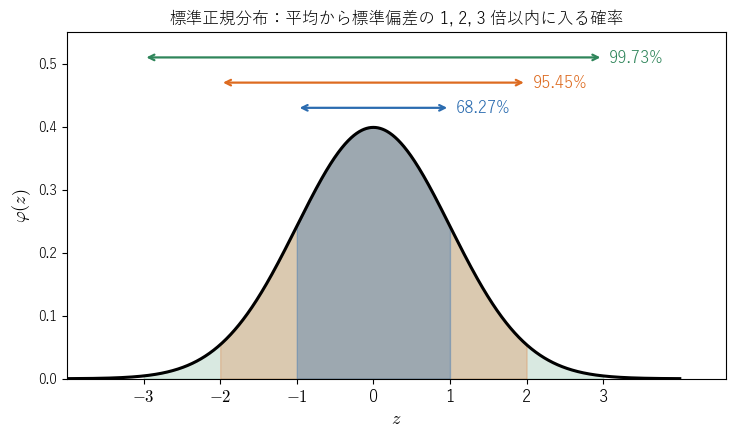 標準正規分布で、平均から標準偏差の 1 倍・2 倍・3 倍以内に入る確率。どの正規分布でも同じ割合になることを見る図。
ex-nrm-height の $N(170,6^2)$ では、
- $164$ cm 以上 $176$ cm 以下($170\pm6$)に約 $68.3\%$、
- $158$ cm 以上 $182$ cm 以下($170\pm12$)に約 $95.4\%$、
- $152$ cm 以上 $188$ cm 以下($170\pm18$)に約 $99.7\%$
が入る。$188$ cm を超える人は、残りの $0.27\%$ の半分、約 $0.13\%$ である。
分散が定まるどんな分布でも成り立つ評価として、Chebyshev の不等式(Chebyshevの不等式)$P(|X-\mu|\le k\sigma)\ge1-\frac1{k^2}$ がある(大数の法則とさいころの平均 で証明している)。$k=2$ で $0.75$ 以上、$k=3$ で $0.889$ 以上しか保証しない。正規分布の $0.9545$、$0.9973$ はそれよりずっと大きく、これは正規分布の裾(平均から遠い部分)が非常に速く小さくなることによる。
平均と分散
$Z$ が $N(0,1)$ に従うとき $E(Z)=0$、$V(Z)=1$ である。したがって $X$ が $N(\mu,\sigma^2)$ に従うとき、$E(X)=\mu$、$V(X)=\sigma^2$ である。
方針:$x\varphi(x)$ には原始関数 $-\varphi(x)$ がある(prop-nrm-shape の証明の段 1 の $\varphi'=-x\varphi$)。これで $E(Z)$ を計算し、$V(Z)$ は部分積分で $\int\varphi=1$ に帰着させる。広義積分なので、$[-R,R]$ で計算してから $R\to\infty$ とする。
段 1($R\varphi(R)\to0$)。$y\ge0$ のとき $e^y\ge1+y$(曲線の凹凸と接線 の接線の不等式)なので、$y=\frac{R^2}2$ として $e^{R^2/2}\ge1+\frac{R^2}2>\frac{R^2}2$ である。よって $R>0$ で
$$
0< R\,e^{-R^2/2}< R\cdot\frac2{R^2}=\frac2R
$$
であり、$R\to\infty$ で $R\varphi(R)=\frac{Re^{-R^2/2}}{\sqrt{2\pi}}\to0$ である(はさみうちの原理)。$\varphi(R)\to0$ も同じ評価から出る。
段 2(期待値)。$(-\varphi)'=x\varphi$ なので、$\int_0^Rx\varphi(x)\,dx=\varphi(0)-\varphi(R)$ であり、$R\to\infty$ で $\varphi(0)$ に近づく。$x\varphi(x)$ は 奇関数 なので $\int_{-R}^0x\varphi(x)\,dx=-(\varphi(0)-\varphi(R))$ で、両方の広義積分が収束し、和は $0$ である。よって $E(Z)=0$ である。
段 3(分散)。$E(Z)=0$ なので $V(Z)=\int x^2\varphi(x)\,dx$ である。$x^2\varphi(x)=x\cdot x\varphi(x)$ と見て、$x\varphi(x)=(-\varphi(x))'$ を使って 部分積分 すると
$$
\int_{-R}^Rx^2\varphi(x)\,dx=\Bigl[-x\varphi(x)\Bigr]_{-R}^R+\int_{-R}^R\varphi(x)\,dx=-2R\varphi(R)+\int_{-R}^R\varphi(x)\,dx
$$
である($\varphi(-R)=\varphi(R)$ を使った)。$R\to\infty$ とすると、段 1 と prop-nrm-total から右辺は $0+1=1$ に近づく。よって $V(Z)=1$ である。
段 4(一般の場合)。thm-nrm-linear の 2 により、$X$ は $\mu+\sigma Z$ と同じ分布に従う。期待値と分散は分布だけで決まるので、1 次式の期待値と分散の公式(確率密度関数と連続型確率変数 で証明)から $E(X)=\mu+\sigma\cdot0=\mu$、$V(X)=\sigma^2\cdot1=\sigma^2$ である。$\square$
同じ計算は 二項分布から正規分布へ にもあり、そこでは正規分布が二項分布の極限として現れる理由を扱っている。
独立な正規分布の和
2 つの確率変数 $X$、$Y$ が独立であるとは、$X$ についての事象と $Y$ についての事象が、いつも互いに独立であることをいう(値がとびとびの場合は 確率変数の期待値と分散 で扱った)。独立な確率変数の和について、期待値は $E(X+Y)=E(X)+E(Y)$、分散は $V(X+Y)=V(X)+V(Y)$ となる。これは分布の形によらない性質で、値がとびとびの場合は 確率変数の期待値と分散 で証明した(密度をもつ場合は GS06 Theorem 6.10、6.16)。正規分布の場合は、さらに和の分布の形も正規分布のままである。
$X$ が $N(\mu_1,\sigma_1^2)$ に、$Y$ が $N(\mu_2,\sigma_2^2)$ に従い、$X$ と $Y$ が独立ならば、$X+Y$ は $N(\mu_1+\mu_2,\ \sigma_1^2+\sigma_2^2)$ に従う。
本記事ではこの定理を証明しない(GS06 Example 7.5、Example 10.17)。平均が $\mu_1+\mu_2$、分散が $\sigma_1^2+\sigma_2^2$ になることは上に述べた一般の性質から出る。証明が要るのは「和の分布がまた正規分布の形をしている」という部分で、和の密度を積分(畳み込み)で計算するか、rem-nrm-mgf の積率母関数を使う。
- 部品 A の長さが $N(30,0.3^2)$、部品 B の長さが $N(20,0.4^2)$ に従い、独立に作られるとする。つなげた長さ $L$ は、thm-nrm-sum により $N(50,\ 0.3^2+0.4^2)=N(50,0.5^2)$ に従う。$P(49\le L\le51)=P(-2\le Z\le2)=2u(2)=0.9544$ である。標準偏差は $0.3+0.4=0.7$ ではなく $\sqrt{0.09+0.16}=0.5$ で、足すのは分散である。
- 標準偏差 $2$ の正規分布に従う測定を、独立に $4$ 回くり返して平均 $\bar X=\frac{X_1+X_2+X_3+X_4}4$ をとる。thm-nrm-sum を 3 回使うと和は $N(4\mu,\ 4\cdot2^2)$ に従い(2 回目以降は、別々の測定から作った $X_1+X_2$ と $X_3$、$X_1+X_2+X_3$ と $X_4$ も独立であることを使う。この事実は本記事では証明しない)、thm-nrm-linear で $\frac14$ 倍すると、$\bar X$ は $N\bigl(\mu,\ \frac{16}{16}\bigr)=N(\mu,1^2)$ に従う。標準偏差は $2$ から $1$ に半分になる。一般に、$N(\mu,\sigma^2)$ に従う独立な $n$ 個の平均は $N\bigl(\mu,\frac{\sigma^2}n\bigr)$ に従い、これが 区間推定(高校数学) で使う事実の 1 つである。
例と反例
「正規分布ならではの性質」と「どの分布でも成り立つ性質」を区別するために、仮定を外した例を並べる。
| 外した仮定 | 崩れる主張 | ボックス |
|---|---|---|
| 分布が正規分布 | $P(\lvert X-\mu\rvert\le\sigma)\approx0.68$ など 68–95–99.7 の値 | ex-nrm-counter-uniform |
| 分布が正規分布 | 標準化すれば標準正規分布になる | ex-nrm-counter-uniform |
| $X$ と $Y$ が独立 | 和の分散が $\sigma_1^2+\sigma_2^2$ | ex-nrm-counter-dependent |
| $X$ と $Y$ が独立 | 和が正規分布に従う | ex-nrm-counter-dependent、ex-nrm-counter-not-normal |
| $a\ne0$ | $aX+b$ が正規分布に従う | ex-nrm-counter-dependent の 2 |
$X$ が $[0,1]$ 上の一様分布に従うとする。確率密度関数と連続型確率変数 の計算から $\mu=\frac12$、$\sigma=\frac1{2\sqrt3}=0.2886\ldots$ である。
- $P(|X-\mu|\le\sigma)$ は、長さ $2\sigma$ の区間の確率なので $2\sigma=\frac1{\sqrt3}=0.5773\ldots$ である。正規分布の $0.6827$ とは違う。
- $2\sigma=0.577\ldots>\frac12$ なので、$\mu\pm2\sigma$ は $[0,1]$ 全体を含み、$P(|X-\mu|\le2\sigma)=1$ である。正規分布の $0.9545$ とは違う。
- 標準化した $Z'=\frac{X-\mu}\sigma$ は、平均 $0$、分散 $1$ だが、区間 $[-\sqrt3,\sqrt3]$ 上の一様分布に従い(確率密度関数と連続型確率変数 の 1 次式の変換)、標準正規分布ではない(図4)。標準化は位置と尺度をそろえるだけで、分布の形は変えない。
満たす性質:平均と分散をもつ。満たさない性質:正規分布であること。崩れる主張:68–95–99.7 の値と、「標準化すると $N(0,1)$」。
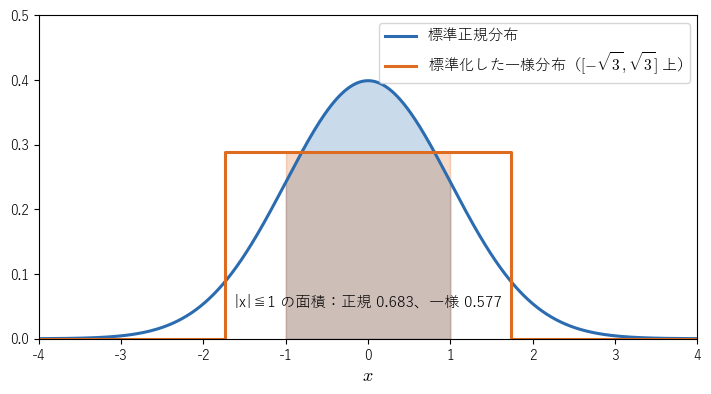 標準正規分布(青)と、標準化した一様分布(橙)。どちらも平均 0、分散 1 だが、$|x|\le1$ の部分の面積は 0.683 と 0.577 で違うことを見る図。
$X$ が $N(\mu,\sigma^2)$ に従うとする。
- $Y=X$ とすると、$Y$ も $N(\mu,\sigma^2)$ に従うが、$X$ と独立ではない。$X+Y=2X$ は thm-nrm-linear により $N(2\mu,4\sigma^2)$ に従い、分散は $\sigma^2+\sigma^2=2\sigma^2$ ではなく $4\sigma^2$ である。
- $Y=-X$ とすると、$Y$ は $N(-\mu,\sigma^2)$ に従う(thm-nrm-linear で $a=-1$)。$X+Y=0$ はいつも $0$ で、正規分布ではない。これは $0\cdot X+0$ でもあり、thm-nrm-linear の仮定 $a\ne0$ を外した例にもなっている。
満たす性質:$X$、$Y$ はどちらも正規分布に従う。満たさない性質:独立性。崩れる主張:thm-nrm-sum の分散の式と、和が正規分布であること。
2 の $X+Y=0$ は分散 $0$ で、「幅 $0$ の正規分布」とみなせなくもない。しかし、次の例では和が正規分布とは言えない形になる。
$Z$ が $N(0,1)$ に従うとし、
$$
Y=\begin{cases}Z&(|Z|\le1\text{ のとき})\\-Z&(|Z|>1\text{ のとき})\end{cases}
$$
とする。
段 1($Y$ も $N(0,1)$ に従う)。$c\le d$ とする。事象「$c\le Y\le d$」を、$|Z|\le1$ の場合と $|Z|>1$ の場合に分けると
$$
P(c\le Y\le d)=P(c\le Z\le d,\ |Z|\le1)+P(c\le-Z\le d,\ |Z|>1)
$$
である。$\varphi$ が偶関数なので、$-Z$ も $N(0,1)$ に従い(thm-nrm-linear で $a=-1$)、しかも条件 $|Z|>1$ は $Z$ を $-Z$ に替えても変わらない。そこで第 2 項は $P(c\le Z\le d,\ |Z|>1)$ に等しい(どちらも、$\varphi$ を「$c\le x\le d$ かつ $|x|>1$」の範囲で積分した値である)。2 つを合わせて $P(c\le Y\le d)=P(c\le Z\le d)$ となる。
段 2(和は正規分布でない)。$|Z|>1$ のとき $Z+Y=Z-Z=0$ なので
$$
P(Z+Y=0)\ge P(|Z|>1)=1-2u(1)=0.3173\ldots
$$
である。密度関数をもつ確率変数では 1 点の確率は $0$ である(確率密度関数と連続型確率変数)から、$Z+Y$ は密度関数をもたず、正規分布(分散が正のもの)に従わない。$|Z|\le1$ のときは $Z+Y=2Z$ で、和は $-2$ から $2$ までの値しかとらないことからも、正規分布でないことが分かる。
満たす性質:$Z$ も $Y$ も標準正規分布に従う。満たさない性質:独立性($Y$ は $Z$ で決まる)。崩れる主張:「正規分布に従う 2 つの量の和は正規分布」。thm-nrm-sum の独立性の仮定は外せない。
大学数学で見る
確率変数 $X$ について、実数 $t$ の関数 $M_X(t):=E(e^{tX})$ を 積率母関数 という。標準正規分布では、指数の部分を平方完成すると
$$
tx-\frac{x^2}2=\frac{t^2}2-\frac{(x-t)^2}2
$$
なので、$e^{tx}\varphi(x)=e^{t^2/2}\varphi(x-t)$ である。$\varphi(x-t)$ は $N(t,1)$ の密度なので全体の積分は $1$ であり(prop-nrm-total)
$$
M_Z(t)=\int_{-\infty}^{\infty}e^{tx}\varphi(x)\,dx=e^{t^2/2}
$$
となる。$X=\mu+\sigma Z$ なら $M_X(t)=E\bigl(e^{t\mu}e^{t\sigma Z}\bigr)=e^{\mu t}M_Z(\sigma t)=e^{\mu t+\sigma^2t^2/2}$ である。
$X$、$Y$ が独立なら、独立な確率変数の積の期待値は期待値の積になるので(GS06 Theorem 6.12)$E(e^{t(X+Y)})=E(e^{tX})E(e^{tY})$ であり、thm-nrm-sum の状況では
$$
M_{X+Y}(t)=e^{\mu_1t+\sigma_1^2t^2/2}\,e^{\mu_2t+\sigma_2^2t^2/2}=e^{(\mu_1+\mu_2)t+(\sigma_1^2+\sigma_2^2)t^2/2}
$$
となり、これは $N(\mu_1+\mu_2,\sigma_1^2+\sigma_2^2)$ の積率母関数である。積率母関数が一致すれば分布も一致するという大学の確率論の定理(本記事では証明しない。GS06 §10.3 は値が有界な場合を Theorem 10.4 で述べ、Example 10.17 で正規分布の和にこの考え方を当てはめている)と合わせると、thm-nrm-sum が得られる。指数の肩の 2 次式が、足し算でも 2 次式のままであることが、正規分布が和で保たれる理由になっている。
正規分布があちこちに現れるのは、中心極限定理 による。分散が有限の独立で同じ分布に従う確率変数を $n$ 個足して標準化すると、元の分布が何であっても、$n$ を大きくすると標準正規分布に近づく。二項分布の場合(de Moivre–Laplace の定理)は 二項分布から正規分布へ で証明している。身長や測定誤差が正規分布に近いのは、多くの小さな独立な要因の和と考えられるからである。一方、ex-nrm-counter-not-normal のように独立性がないと、正規分布どうしの和でさえ正規分布にならない。
さらに先へ
正規分布は、区間推定(高校数学) と 仮説検定(高校数学) の計算の土台になる。母標準偏差を標本から見積もるときには、正規分布の代わりに $t$ 分布を使う(t分布)。2 つ以上の量を同時に扱う多変量正規分布では、分散の代わりに分散共分散行列が現れ、1 次式での変換は行列の掛け算になる(多変量正規分布)。
関連項目
- 前提: 確率密度関数と連続型確率変数, Gauss積分(高校数学), 置換積分, 確率変数の期待値と分散
- 前に読む: 確率密度関数と連続型確率変数, 二項分布から正規分布へ
- 次に読む: 区間推定(高校数学), 仮説検定(高校数学)
- 関連(高校数学): 相関係数(高校数学), 大数の法則とさいころの平均, 母集団と標本, 曲線の凹凸と接線
- 発展: 正規分布, 中心極限定理, 積率母関数, 特性関数
- 比較: 二項分布, Chebyshevの不等式
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

