算術符号化
概要
算術符号化(arithmetic coding)とは、長さ $n$ の記号の列 $x$ に区間 $[0,1)$ の中の長さ $P(x)$ の小区間を辞書式の順に割り当て、その小区間に収まる 2 進の区間を表す 0 と 1 の列を符号語にするデータ圧縮の方法である。符号語の長さは $\log_2(1/P(x))+2$ より短い接頭符号になり、平均の長さは列全体のエントロピーとの差が 2 bit 未満である。区間は条件付き確率を使って列を先頭から読みながら縮めていけるので、符号表を作る必要がなく、確率を学習しながら符号化するモデルとも組み合わせられる。
確率 $0.9$ で $0$、$0.1$ で $1$ を独立に出す情報源の出力を 0 と 1 の列に直すことを考える。Huffman符号 のように記号を 1 つずつ符号語に置き換える方法では、どの符号語も 1 文字以上なので 1 記号あたり 1 bit より短くならない。一方、この情報源のエントロピーは $h(0.9)\approx0.468996$ bit である。記号を $n$ 個ずつまとめて Huffman 符号を作れば差は縮むが、$2^n$ 個の列すべての符号表を作る必要がある。
算術符号化(arithmetic coding)は、長さ $n$ の列 $x$ 全体に、区間 $[0,1)$ の中の長さ $P(x)$ の小区間を対応させ、その小区間に収まる 2 進の区間を表す列を符号語にする方法である。符号表を作らず、列を先頭から読みながら区間を順に縮めていくだけで符号語が決まる。しかも符号語の長さは列ごとに $\log_2\frac{1}{P(x)}+2$ より短く、平均では列全体のエントロピーとの差が 2 bit 未満になる。この記事では、区間と符号語の対応を定め、この長さの評価と接頭符号であることを完全に証明し、区間を逐次に計算する式、復号の手順、確率を学習しながら符号化する例を述べる。
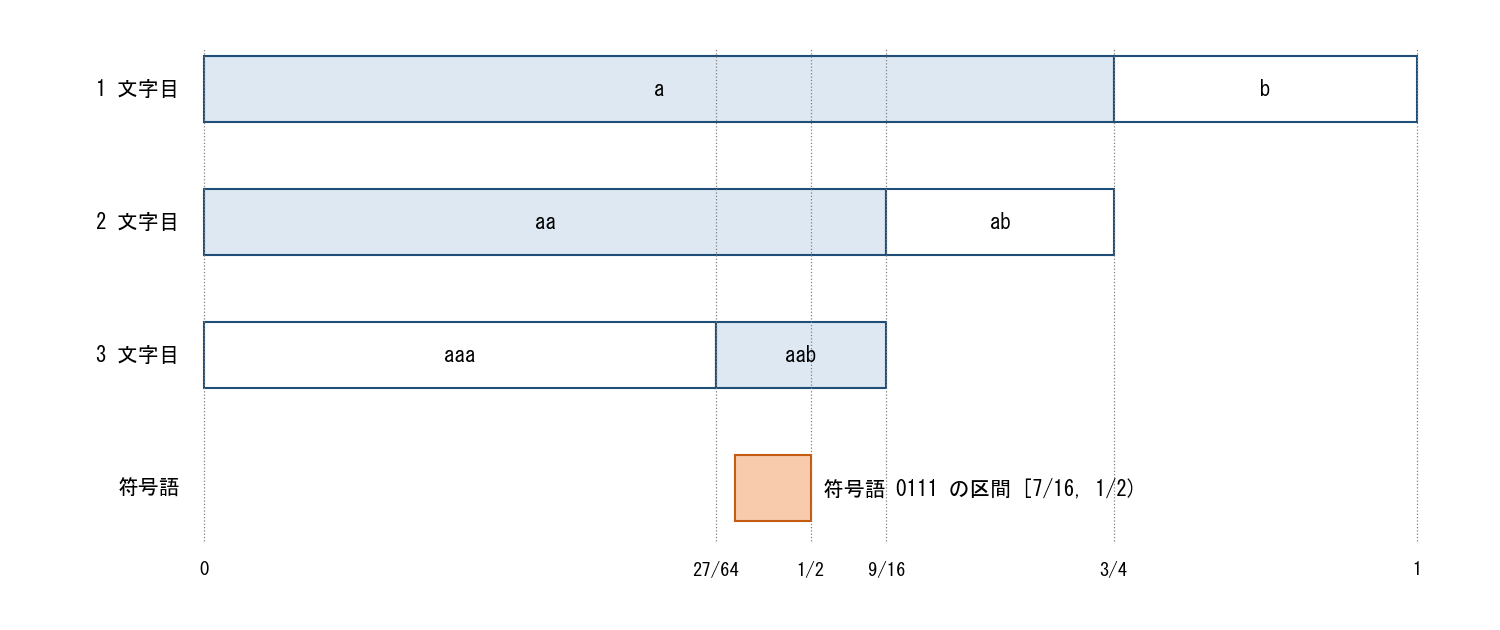 図: 確率 3/4 で a、1/4 で b を出す情報源で、列 aab の区間が縮んでいく様子。1 文字目で区間 a は 0 から 3/4、2 文字目で aa は 0 から 9/16、3 文字目で aab は 27/64 から 9/16 になる。その中に符号語 0111 が表す区間 7/16 から 1/2 が収まっている。
定義と使える条件
以下、記号の集合 $\mathcal A=\{a_1,\dots,a_m\}$($m\ge2$)に順序 $a_1< a_2<\cdots< a_m$ を固定し、長さ $n$ の列の集合 $\mathcal A^n$ には辞書式順序を入れる(先頭から比べて最初に異なる位置の記号で大小を決める)。$P$ を $\mathcal A^n$ 上の確率分布とし、すべての $x\in\mathcal A^n$ で $P(x)>0$ と仮定する。
$x\in\mathcal A^n$ について
$$
F(x):=\sum_{y\in\mathcal A^n,\ y< x}P(y),\qquad J(x):=[F(x),\,F(x)+P(x))
$$
とおき、$J(x)$ を $x$ の 区間 という。
区間 $J(x)$($x\in\mathcal A^n$)は互いに交わらず、その和集合は $[0,1)$ である。
証明を開く
$\mathcal A^n$ の元を小さい順に $x^{(1)}<\cdots< x^{(N)}$($N=m^n$)と並べると、定義から $F(x^{(1)})=0$、$F(x^{(i+1)})=F(x^{(i)})+P(x^{(i)})$ であり、$F(x^{(N)})+P(x^{(N)})=\sum_yP(y)=1$ である。よって $J(x^{(i)})$ は $[0,1)$ を左から順に隙間なく覆う半開区間で、互いに交わらない。$\square$
0 と 1 の列 $w=w_1\cdots w_\ell$ について、$\mathrm{val}(w):=\sum_{i=1}^\ell w_i2^{-i}$、$I(w):=[\mathrm{val}(w),\,\mathrm{val}(w)+2^{-\ell})$ とおき、$I(w)$ を $w$ の 2 進の区間 という。$I(w)$ は、2 進展開($1$ が無限に続かないほうをとる)の先頭 $\ell$ 桁が $w$ である $[0,1)$ の数の全体である。
列 $w,w'$ について、$w$ が $w'$ の接頭辞(先頭部分。$w$ 自身も含む)であることと $I(w')\subset I(w)$ は同値である。どちらも他方の接頭辞でなければ $I(w)\cap I(w')=\emptyset$ である。
証明を開く
def-ac-dyadic の言い換えによる。$w$ が $w'$ の接頭辞なら、先頭が $w'$ の数は先頭が $w$ なので $I(w')\subset I(w)$ である。逆に $I(w')\subset I(w)$ なら $\mathrm{val}(w')\in I(w)$ で、$\mathrm{val}(w')$ の展開は $w'$ のあとに $0$ が続くものである。$\lvert w'\rvert<\lvert w\rvert$ なら $I(w')$ の長さ $2^{-\lvert w'\rvert}$ が $I(w)$ の長さより大きくなり包含に反するので $\lvert w\rvert\le\lvert w'\rvert$ で、展開の先頭 $\lvert w\rvert$ 桁を比べて $w$ は $w'$ の接頭辞である。どちらも接頭辞でなければ、最初に異なる位置 $i\le\min(\lvert w\rvert,\lvert w'\rvert)$ があり、$I(w)$ と $I(w')$ の数は展開の第 $i$ 桁が異なるので、共通の数はない。$\square$
$x\in\mathcal A^n$ について、中点 $\bar F(x):=F(x)+\frac12P(x)$ と長さ
$$
\ell(x):=\Bigl\lceil\log_2\frac{1}{P(x)}\Bigr\rceil+1
$$
を定める。$\bar F(x)$ の 2 進展開の先頭 $\ell(x)$ 桁を $c(x)$ とする。すなわち $c(x)$ は $\mathrm{val}(c(x))=\lfloor\bar F(x)2^{\ell(x)}\rfloor2^{-\ell(x)}$ となる長さ $\ell(x)$ の列である。写像 $x\mapsto c(x)$ を $P$ の 算術符号 といい、$c(x)$ を求めることを 算術符号化 という。
$n=1$ のときは記号ごとの符号である。$n$ が大きいとき、$c(x)$ は列全体に 1 つの符号語を割り当てるが、thm-ac-sequential により $F(x)$ と $P(x)$ は列を先頭から読みながら計算できる。これが「算術」の名の由来で、構成は Mac03 §6.2(pp. 111–116)と PW25 §13.1(pp. 245–246)にある。PW25 の (13.1) は中点を切り捨てる代わりに $J(x)$ に含まれる最も長い 2 進の区間を選ぶ。その区間は $I(c(x))$ 以上の長さをもつので、下の thm-ac-main の長さの評価はそちらでも成り立つ。
使える条件:
- (i) 符号化する列 $x$ の確率が正である($P(x)>0$)。
- (ii) 符号化する側と復号する側が、同じ分布 $P$(または同じ条件付き確率の計算規則)を使う。
- (iii) 列の長さ $n$ を復号する側が知っている。知らないなら終わりを表す記号を記号の集合に加える。
- (iv) 区間の端点を正確に(有理数として)計算する。有限の桁で計算する実装は補足で述べる。
主定理
def-ac-code の符号 $c$ について、次が成り立つ。
- すべての $x\in\mathcal A^n$ で $I(c(x))\subset J(x)$ である。
- $c$ は $\mathcal A^n$ 上の接頭符号である。すなわち $x\ne y$ なら $c(x)$ は $c(y)$ の接頭辞でない。
- 長さは $\ell(x)<\log_2\frac{1}{P(x)}+2$ を満たす。
- 平均の長さ $L:=\sum_xP(x)\ell(x)$ は $L< H(P)+2$ を満たす。ここで $H(P):=-\sum_xP(x)\log_2P(x)$ である。$P$ が独立同分布の列の分布(各記号の分布 $p$)なら $H(P)=nH(p)$ なので、1 記号あたり $L/n< H(p)+\frac2n$ である。
$x$ を固定し、$p:=P(x)$、$\ell:=\ell(x)$、$z:=\mathrm{val}(c(x))=\lfloor\bar F(x)2^\ell\rfloor2^{-\ell}$ とおく。
- 切り捨ての定義から $\bar F(x)-2^{-\ell}< z\le\bar F(x)$ である。$\ell\ge\log_2\frac1p+1$ なので $2^{-\ell}\le\frac p2$ である。よって
$$ z>\bar F(x)-2^{-\ell}\ge F(x)+\frac p2-\frac p2=F(x),\qquad z+2^{-\ell}\le\bar F(x)+\frac p2=F(x)+p $$
となり、$I(c(x))=[z,z+2^{-\ell})\subset[F(x),F(x)+p)=J(x)$ である。 - $x\ne y$ とする。1 と lem-ac-partition から $I(c(x))\subset J(x)$、$I(c(y))\subset J(y)$、$J(x)\cap J(y)=\emptyset$ なので、$I(c(x))\cap I(c(y))=\emptyset$ である。$c(x)$ が $c(y)$ の接頭辞なら lem-ac-prefix により $I(c(y))\subset I(c(x))$ となり、空でない $I(c(y))$ が両方に含まれて矛盾する。よって $c(x)$ は $c(y)$ の接頭辞でない。
- $\lceil t\rceil< t+1$ より $\ell=\lceil\log_2\frac1p\rceil+1<\log_2\frac1p+2$ である。
- 3 に $P(x)$ を掛けて和をとると $L<\sum_xP(x)\log_2\frac1{P(x)}+2=H(P)+2$ である。独立同分布なら $\log_2\frac1{P(x)}=\sum_{k=1}^n\log_2\frac1{p(x_k)}$ で、期待値をとると $H(P)=nH(p)$ となる。$\square$
接頭符号の平均の長さは $H(P)$ 以上である(エントロピー の定理「記号ごとの符号の平均の長さ」を $\mathcal A^n$ を記号の集合とみて使う)。よって算術符号は、列全体を 1 つの記号とみた最適な符号と比べて、平均で 2 bit 未満しか長くない。$\mathcal A^n$ に Huffman 符号を作れば差は 1 bit 未満になるが、$m^n$ 個の符号語の表が要る。算術符号は表を作らず、符号化したい列 1 つについて区間を計算すればよい。
2 の論法は、2 進の区間が列の区間に収まることだけを使っている。区間 $[0.26,0.74)$(長さ $0.48$)のように端点の位置が悪いと、含まれる最長の 2 進の区間は $[0.375,0.5)$ などの長さ $\frac18$ で、$\log_2\frac1{0.48}+1\approx2.06$ より長い $3$ 桁が要る。長さに $+1$ を足すのはこのずれを吸収するためである(Mac03 の Exercise 6.1、p. 115、解答 pp. 127–128 は終端の手間が 2 bit 以下であることを同じ考えで示す)。
区間の逐次計算と復号
$P$ が条件付き確率 $P(a\mid x_1\cdots x_{k-1})$($a\in\mathcal A$、$k=1,\dots,n$)から $P(x)=\prod_{k=1}^nP(x_k\mid x_1\cdots x_{k-1})$ で与えられているとする。長さ $k$ の列 $x^k=x_1\cdots x_k$ の確率を $P(x^k):=\prod_{j\le k}P(x_j\mid x^{j-1})$ とし、$F_k(x^k):=\sum_{y\in\mathcal A^k,\,y< x^k}P(y)$、$J(x^k):=[F_k(x^k),F_k(x^k)+P(x^k))$ とおく(空列 $x^0$ では $F_0=0$、$P(x^0)=1$)。
$k=1,\dots,n$ について
$$
F_k(x^k)=F_{k-1}(x^{k-1})+P(x^{k-1})\sum_{a< x_k}P(a\mid x^{k-1}),\qquad P(x^k)=P(x^{k-1})\,P(x_k\mid x^{k-1})
$$
が成り立つ。とくに $J(x^k)\subset J(x^{k-1})$ であり、$a\in\mathcal A$ を動かした $J(x^{k-1}a)$ は $J(x^{k-1})$ を分割する。$k=n$ の $F_n$ は def-ac-interval の $F$ に等しい。
証明を開く
辞書式順序で $y< x^k$($y\in\mathcal A^k$)となるのは、(a) $y^{k-1}< x^{k-1}$ の場合と、(b) $y^{k-1}=x^{k-1}$ かつ $y_k< x_k$ の場合に分かれる。(a) の $y$ の確率の和は、$y^{k-1}$ を固定して $y_k$ について和をとると $\sum_{a}P(a\mid y^{k-1})=1$ なので $\sum_{y^{k-1}< x^{k-1}}P(y^{k-1})=F_{k-1}(x^{k-1})$ である。(b) の和は $P(x^{k-1})\sum_{a< x_k}P(a\mid x^{k-1})$ である。これで漸化式が出る。$x_k$ を $a_1,a_2,\dots,a_m$ と動かすと、$J(x^{k-1}a_i)$ の左端は $F_{k-1}+P(x^{k-1})\sum_{j< i}P(a_j\mid x^{k-1})$、長さは $P(x^{k-1})P(a_i\mid x^{k-1})$ なので、これらは $J(x^{k-1})$ を左から隙間なく分割する。$P$ は $\mathcal A^n$ 上の分布 $x\mapsto P(x^n)$ と同じものなので、$F_n=F$ である。$\square$
$n$ と条件付き確率の規則を知っている受け手が、受け取った $c(x)$ から $t:=\mathrm{val}(c(x))$ を計算し、$k=1,\dots,n$ の順に $t\in J(\hat x^{k-1}a)$ となる $a\in\mathcal A$ をとって $\hat x_k:=a$ とすると、$\hat x=x$ である。また、届いた列 $s$ の先頭が $c(x)$ のとき、$s$ の接頭辞 $w$ を短い順に見て、$\mathrm{val}(w)$ から同じ手順で得た $\hat x$ が $c(\hat x)=w$ を満たす最初の $w$ は $c(x)$ である。よって $\ell(x)$ を知らなくても符号語の終わりが分かる。
証明を開く
thm-ac-main の 1 と thm-ac-sequential から $t\in I(c(x))\subset J(x)\subset J(x^k)$($k\le n$)である。$k$ についての帰納法で $\hat x^{k}=x^{k}$ を示す。$\hat x^{k-1}=x^{k-1}$ とすると、$J(x^{k-1}a)$($a\in\mathcal A$)は $J(x^{k-1})$ を分割するので $t$ を含む $a$ はただ 1 つで、$t\in J(x^k)$ からそれは $x_k$ である。
後半:前半から $w=c(x)$ では $\hat x=x$、$c(\hat x)=w$ となる。$w$ が $c(x)$ の真の接頭辞で $c(\hat x)=w$ となったとすると、$\hat x\ne x$(長さが違う)で $c(\hat x)$ が $c(x)$ の接頭辞となり、thm-ac-main の 2 に反する。$\square$
公式の表
| 量 | 式 | 条件 | 根拠 |
|---|---|---|---|
| 列の区間 | $J(x)=[F(x),F(x)+P(x))$ | $P(x)>0$ | def-ac-interval |
| 符号語の長さ | $\ell(x)=\lceil\log_2\frac1{P(x)}\rceil+1<\log_2\frac1{P(x)}+2$ | 同上 | thm-ac-main |
| 符号語 | $\bar F(x)=F(x)+\frac12P(x)$ の先頭 $\ell(x)$ 桁 | 同上 | def-ac-code |
| 平均の長さ | $H(P)\le L< H(P)+2$ | 接頭符号の下界は エントロピー | thm-ac-main |
| 独立同分布 | $L/n< H(p)+\frac2n$ | 各記号が分布 $p$ | thm-ac-main |
| 漸化式 | $F_k=F_{k-1}+P(x^{k-1})\sum_{a< x_k}P(a\mid x^{k-1})$ | 条件付き確率で与えた $P$ | thm-ac-sequential |
| Laplace の規則での確率 | $P_{\mathrm L}(x)=\frac{n_a!\,n_b!}{(n+1)!}$ | 2 記号 | prop-ac-laplace |
| 違う分布 $Q$ で符号化 | 平均 $< n(H(p)+D(p\Vert q))+2$ | 独立同分布 | prop-ac-mismatch |
計算の手順
符号化($n$ と条件付き確率の規則を送り手と受け手が共有する):
- $F:=0$、$R:=1$($R$ は今の区間の長さ)とおく。
- $k=1,\dots,n$ の順に、$F:=F+R\sum_{a< x_k}P(a\mid x^{k-1})$、$R:=R\,P(x_k\mid x^{k-1})$ と更新する(thm-ac-sequential)。最後の $F,R$ が $F(x),P(x)$ である。
- $\ell:=\lceil\log_2\frac1R\rceil+1$ とし、$F+\frac R2$ の 2 進展開の先頭 $\ell$ 桁を出力する(def-ac-code)。
復号:
- 届いた列の先頭の $w$ から $t:=\mathrm{val}(w)$ を作り、$F:=0$、$R:=1$ とおく。
- $k=1,\dots,n$ の順に、$\mathcal A$ の記号を小さい順に見て、$F+R\sum_{a'< a}P(a'\mid\hat x^{k-1})\le t< F+R\sum_{a'\le a}P(a'\mid\hat x^{k-1})$ となる $a$ を $\hat x_k$ とし、符号化と同じ式で $F,R$ を更新する(prop-ac-decode)。
- 符号語の長さが分からないときは、$w$ を 1 桁ずつ延ばして 1・2 を繰り返し、$c(\hat x)=w$ となった時点で止める(prop-ac-decode の後半)。
検算:$I(c(x))\subset J(x)$ と $\ell(x)<\log_2\frac1{P(x)}+2$ を確かめる。
確率を学習しながら符号化する
thm-ac-sequential の条件付き確率は、それまでに読んだ記号に応じて変えてよい。送り手と受け手が同じ規則で計算する限り、thm-ac-main と prop-ac-decode はそのまま成り立つ。確率のモデルと符号化の操作が分かれていることが、算術符号化の大きな利点である(Mac03 p. 111)。
記号を $\{a,b\}$ とし、それまでに $a$ が $k_a$ 回、$b$ が $k_b$ 回現れたとき次の記号の確率を
$$
P_{\mathrm L}(a\mid x^{k})=\frac{k_a+1}{k+2},\qquad P_{\mathrm L}(b\mid x^{k})=\frac{k_b+1}{k+2}\quad(k=k_a+k_b)
$$
とする(Laplace の規則。Mac03 (6.7)、p. 116)。このとき $a$ を $n_a$ 回、$b$ を $n_b$ 回含む長さ $n$ の列 $x$ について
$$
P_{\mathrm L}(x)=\frac{n_a!\,n_b!}{(n+1)!}=\frac{1}{(n+1)\binom{n}{n_a}}
$$
であり、算術符号の長さは $\ell(x)<\log_2\bigl((n+1)\tbinom{n}{n_a}\bigr)+2$ である。
証明を開く
$k+1$ 番目の記号の確率の分母は $k+2$ なので、分母の積は $2\cdot3\cdots(n+1)=(n+1)!$ である。$a$ の $j$ 回目の出現($j=1,\dots,n_a$)の分子は、その時点の $k_a=j-1$ から $j$ で、積は $n_a!$ である。$b$ も同様で $n_b!$ になる。長さの評価は thm-ac-main の 3 による。$\square$
右辺は列の並び方によらず $a,b$ の個数だけで決まる。各記号が確率 $\theta$ で $a$ になる独立な列なら、$\theta$ を知らなくても、$\theta$ を知っていた場合の長さ $n_a\log_2\frac1\theta+n_b\log_2\frac1{1-\theta}$ との差は $\log_2(n+1)+2$ 程度に収まる($\binom{n}{n_a}\theta^{n_a}(1-\theta)^{n_b}\le1$ による)。
$X_1,\dots,X_n$ が分布 $p$ に従う独立な列で、すべての記号で正の分布 $q$ の独立同分布の算術符号で符号化すると、平均の長さ $L_q$ は
$$
n\bigl(H(p)+D(p\Vert q)\bigr)+1\le L_q< n\bigl(H(p)+D(p\Vert q)\bigr)+2
$$
を満たす。ここで $D(p\Vert q)=\sum_ap(a)\log_2\frac{p(a)}{q(a)}$ は 相対エントロピー である。
証明を開く
$\lceil t\rceil\ge t$ と thm-ac-main の 3 から $\log_2\frac1{Q(x)}+1\le\ell(x)<\log_2\frac1{Q(x)}+2$ である($Q$ は $q$ の積の分布)。$p$ についての期待値は $\mathbb E\log_2\frac1{Q(X)}=n\sum_ap(a)\log_2\frac1{q(a)}=n\bigl(H(p)+D(p\Vert q)\bigr)$ である。$\square$
例題
使う公式:thm-ac-sequential、def-ac-code。
問:$P(a)=\frac34$、$P(b)=\frac14$ の独立な情報源で、$n=3$ の列 aab を符号化せよ。
答え:$F$ は $0\to0\to0+\frac{9}{16}\cdot\frac34=\frac{27}{64}$、$R$ は $1\to\frac34\to\frac9{16}\to\frac9{64}$ と更新される(図)。$\ell=\lceil\log_2\frac{64}9\rceil+1=3+1=4$、中点 $\frac{27}{64}+\frac{9}{128}=\frac{63}{128}=0.0111111_{(2)}$ の先頭 4 桁で、符号語は 0111 である。$I(0111)=[\frac7{16},\frac12)\subset[\frac{27}{64},\frac{9}{16})$ で、$\ell=4<\log_2\frac{64}9+2\approx4.830075$ である。8 つの列すべての符号語は下の表のとおりで、平均の長さは $L=\frac{125}{32}=3.90625$、$H(P)=3h(\frac14)\approx2.433834$、上界 $H(P)+2\approx4.433834$ である。
| 列 | $P(x)$ | $F(x)$ | $\ell(x)$ | 符号語 |
|---|---|---|---|---|
| aaa | $27/64$ | $0$ | 3 | 001 |
| aab | $9/64$ | $27/64$ | 4 | 0111 |
| aba | $9/64$ | $36/64$ | 4 | 1010 |
| abb | $3/64$ | $45/64$ | 6 | 101110 |
| baa | $9/64$ | $48/64$ | 4 | 1101 |
| bab | $3/64$ | $57/64$ | 6 | 111010 |
| bba | $3/64$ | $60/64$ | 6 | 111101 |
| bbb | $1/64$ | $63/64$ | 7 | 1111111 |
使う公式:prop-ac-decode。
問:ex-ac-encode の情報源で、$n=3$ と知っている受け手が 0111 を受け取った。復号せよ。
答え:$t=\frac7{16}=0.4375$ である。1 文字目は $[0,\frac34)$ に入るので a、2 文字目は a の中の $[0,\frac9{16})$ に入るので a、3 文字目は aa の中の $[0,\frac{27}{64})$ に入らず $[\frac{27}{64},\frac9{16})$ に入るので b で、aab が得られる。
使う公式:thm-ac-main の 4。
問:$P(0)=0.9$、$P(1)=0.1$ の独立な列を長さ $n$ ごとに算術符号化したとき、1 記号あたりの平均の長さを求めよ。
答え:$n=1$ では符号語が 0 なら 2 桁、1 なら 5 桁で、$L=2.3$ である。記号ごとの Huffman 符号の 1 より長い。$n=10$ では全 $1024$ 個の列を数えて $L\approx6.070191$、$L/n\approx0.607019$、$n=12$ では $L/n\approx0.578421$ となる。上界 $H(p)+\frac2n$ は $n=100$ で $0.488996$、$n=1000$ で $0.470996$ で、$h(0.9)\approx0.468996$ に近づく。
使う公式:prop-ac-laplace、thm-ac-sequential。
問:Laplace の規則で、列 aaab を符号化せよ。
答え:$P_{\mathrm L}(\mathrm{aaab})=\frac12\cdot\frac23\cdot\frac34\cdot\frac15=\frac1{20}=\frac{3!\,1!}{5!}$ である。長さ 4 の列で aaab より小さいのは aaaa だけで、$F=P_{\mathrm L}(\mathrm{aaaa})=\frac12\cdot\frac23\cdot\frac34\cdot\frac45=\frac15$ である。$\ell=\lceil\log_220\rceil+1=6$、中点 $\frac15+\frac1{40}=\frac9{40}=0.225$ の先頭 6 桁は 001110 で、$I(001110)=[0.21875,0.234375)\subset[0.2,0.25)$ である。$n=100$、$n_a=90$ の列なら長さは $\log_2(101\binom{100}{90})+2\approx52.634908$ 未満で、確率 $0.9$ を知っていた場合の目安 $100h(0.9)\approx46.899559$ に近い。
使える条件と反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| (i) $P(x)>0$ | 確率 $0$ とした記号が実際に現れる | $J(x)$ が空で $\ell(x)$ が定まらず、$x$ は符号化できない |
| 長さの $+1$(def-ac-code) | 記号ごとに確率 $\frac14,\frac12,\frac14$ で $\ell=\lceil\log_2\frac1p\rceil$ とする | 符号語が 00, 1, 11 となり、1 が 11 の接頭辞である。thm-ac-main の 2 が成り立たない |
| (iii) 長さ $n$ を共有 | $P(a)=\frac34$ で、$n=1$ の a と $n=2$ の aa | どちらも符号語 01 で、長さを知らない受け手は区別できない |
| (ii) 同じ確率の規則 | ex-ac-encode の 0111 を、確率 $\frac12,\frac12$ の規則で復号する | 復号すると abb となり、prop-ac-decode の結論 $\hat x=x$ が成り立たない |
| 符号化の分布が真の分布 | 真の分布は $P(a)=\frac12$、符号化は $q(a)=0.9$ | 1 記号あたり $H(p)+D(p\Vert q)\approx1.736966$ bit かかり、$n=10$ で平均 $18.956055$ と、真の分布での上界 $H+2=12$ を超える(prop-ac-mismatch。$q$ に対しての評価は成り立つ) |
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 算術符号はいつも Huffman 符号より短い | 列が短いと長くなる。$P(0)=0.9$、$n=1$ で $2.3$ 対 $1$ | ex-ac-skewed。上界は $H+2$ で、Huffman は $H+1$ |
| 長さは $\lceil\log_2\frac1{P(x)}\rceil$ で足りる | $+1$ が要る | 反例の表の 2 行目 |
| 中点でなく左端 $F(x)$ を切り捨ててよい | 確率 $\frac13,\frac23$ の 2 番目の記号で $F=\frac13$ を 2 桁で切ると 01、区間 $[\frac14,\frac12)$ は $J=[\frac13,1)$ からはみ出し、$t=\frac14$ は 1 番目の記号に復号される | thm-ac-main の証明の 1 は中点を使う |
| 区間の端点は倍精度の浮動小数点数で計算すればよい | 確率 $0.1$ の記号が 400 個並ぶ列の確率 $10^{-400}$ は、倍精度の最小の正の数(約 $4.9\times10^{-324}$)より小さい | 補足の有限の桁での実装を使う |
| エントロピーより短くできる | 接頭符号の平均は $H(P)$ 以上 | エントロピー |
補足
区間の端点を正確な有理数で持つと、桁数は列の長さに比例して増える。実用の実装は、区間を固定した桁数の整数で表し、上位の桁が確定したら出力して区間を拡大し直す(再正規化)。この方法は Witten、Neal、Cleary(1987 年)によって実用化された(Mac03 p. 111)。丸めによって区間の長さがわずかに縮むので、符号語の長さは本記事の評価よりわずかに増える。整数の分母をもつ分布で区間を割り直す手間を減らす方法として、Duda の非対称数系(ANS)が広く使われている(PW25 p. 246)。この記事ではこれらの実装の誤差の評価は扱わない。
算術符号化は、記号ごとの Huffman符号 が 1 記号あたり 1 bit を切れない欠点を、列全体に符号語を割り当てることで解消する(Mac03 §6.2、p. 111)。性能はモデルの確率の良さで決まり、prop-ac-mismatch の $D(p\Vert q)$ がその損失である。確率を学習する prop-ac-laplace のような規則と組み合わせると、分布を知らない情報源でも 1 記号あたりの長さをエントロピーに近づけられる。圧縮の限界は エントロピー、誤りを許す圧縮の限界は レート歪み理論 が与える。
関連項目
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

