相関と因果
概要
相関と因果(correlation and causation)とは、2 つの変量の相関係数が $0$ でないことは、一方が他方の原因であることを意味しないという注意と、相関が生まれる仕組みの分析である。データが $x_i=z_i+u_i$、$y_i=z_i+v_i$ で、$z,u,v$ の 2 つずつの共分散がすべて $0$、$z$ の分散 $s_z^2$ が正なら、$x$ と $y$ の間に直接の関係がなくても相関係数は $\frac{s_z^2}{\sqrt{(s_z^2+s_u^2)(s_z^2+s_v^2)}}>0$ になる(共通の原因)。層ごとには相関係数が負なのに全体では正になるデータや、合計点で選ぶと関係のない 2 つの点数に負の相関が生まれる例もある。逆に $y=x^2$ のように関係があっても相関係数が $0$ になることがある。
前提知識: 相関係数(高校数学), 散布図と回帰直線
高校での出発点:アイスが売れる日はプールが混む
2 つの変量の間に強い相関があると、「一方が他方の原因だ」と考えたくなる。しかし、相関係数が $0$ でないことは、どちらかがもう一方の原因であることを意味しない。まず小さな例で、原因の関係がないのに相関が出る仕組みを見る。
ある町で 4 日間、その日の最高気温 $z$(度)、店のアイスの売上 $x$(百個)、プールの利用者 $y$(十人)を記録した(数は作ったものである)。
| 日 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| 気温 $z$ | $28$ | $28$ | $22$ | $22$ |
| アイス $x$ | $30$ | $26$ | $24$ | $20$ |
| プール $y$ | $30$ | $26$ | $20$ | $24$ |
$x$ と $y$ の平均はどちらも $25$ で、偏差は $x$ が $(5,1,-1,-5)$、$y$ が $(5,1,-5,-1)$ である。
- 共分散:$s_{xy}=\dfrac{5\cdot5+1\cdot1+(-1)(-5)+(-5)(-1)}4=\dfrac{25+1+5+5}4=9$。
- 分散:$s_x^2=\dfrac{25+1+1+25}4=13$、$s_y^2=\dfrac{25+1+25+1}4=13$。
- 相関係数:$r_{xy}=\dfrac9{\sqrt{13\cdot13}}=\dfrac9{13}=0.69\ldots$。
アイスの売上とプールの利用者には、かなり強い正の相関がある。
アイスを食べたからプールに行くわけでも、プールに行ったからアイスを買うわけでもないだろう。暑い日にはどちらも増える、と考える方が自然である。実際、このデータは
$$
x=z+u,\qquad y=z+v
$$
と分けて作ってある。$z$ の偏差は $(3,3,-3,-3)$、$u=x-z$ は $(2,-2,2,-2)$、$v=y-z$ は $(2,-2,-2,2)$ である。$u$ と $v$ は気温以外の、その日ごとの事情を表す。$x$ と $y$ の間に直接のつながりはなく、共通の $z$ だけが両方に入っている。
この記事では次の問いに答える。
- 共通の原因があると、相関係数はどれだけの値になるか。→ thm-cnc-common-cause
- グループに分けると、相関の符号が逆になることはあるか。→ prop-cnc-strata
- データの選び方だけで相関が生まれることはあるか。→ ex-cnc-selection
- 原因を確かめるには、どうすればよいか。→ rem-cnc-experiment
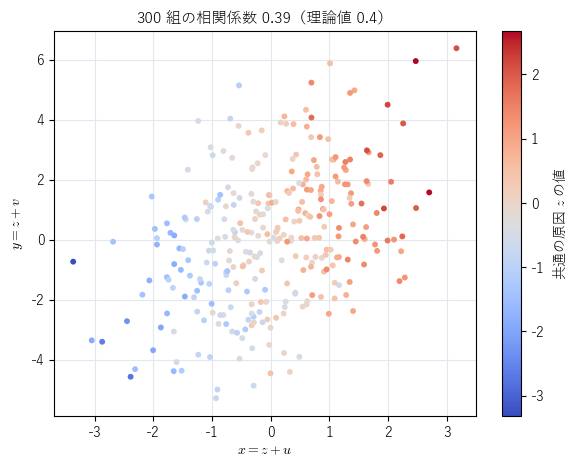 共通の原因 z から作ったデータ x = z + u、y = z + v の散布図。点の色は z の値で、z が大きい点ほど右上に集まり、全体として正の相関が出る
図 1 は、同じ仕組みで 300 組のデータを乱数で作った散布図である。点の色は $z$ の値を表す。赤い点($z$ が大きい)は右上に、青い点($z$ が小さい)は左下に集まり、全体として右上がりの傾向が出る。作り方から、$x$ と $y$ の間に直接の関係はない。実際、同じ色の点どうしだけを見ると、右上がりの傾向はほとんど見えない。
相関が生まれる理由には、少なくとも次の 4 つの型がある。相関係数だけを見ても、4 つの型のどれなのかは分からない。この記事では、3 つ目と 4 つ目の型が本当に相関を作ることを、式と例で確かめる。型 仕組み 例 直接の因果 $x$ が $y$ を変える 肥料の量と作物の収穫量 逆向きの因果 $y$ が $x$ を変える 「消防車が多く出た火事ほど被害が大きい」は、被害が大きいから消防車が多く出る 共通の原因 $z$ が $x$ と $y$ の両方を変える 気温とアイス・プール(ex-cnc-first、thm-cnc-common-cause) 選び方 データを選ぶ基準が $x$ と $y$ の両方にかかる 合格者だけの点数(ex-cnc-selection)
共分散の性質
共通の原因の計算には、共分散の次の性質を使う。$n$ 組のデータ $(x_i,y_i)$ の共分散を $s_{xy}=\dfrac1n\displaystyle\sum_{i=1}^n(x_i-\bar x)(y_i-\bar y)$、分散を $s_x^2=s_{xx}$ と書く(相関係数(高校数学))。
3 つの変量 $a$、$b$、$c$ の $n$ 個のデータについて、次が成り立つ。
(R1) 対称性:$s_{ab}=s_{ba}$。
(R2) 足し算について分けられる:変量 $a+b$($i$ 番目の値が $a_i+b_i$)について $s_{a+b,\,c}=s_{ac}+s_{bc}$。
(R3) 定数を足しても変わらない:定数 $k$ について、変量 $a+k$ と $c$ の共分散は $s_{ac}$ に等しい。
条件 (i):定義の式で積の順番を入れ替えただけである。
条件 (ii):変量 $a+b$ の平均は $\dfrac1n\displaystyle\sum_i(a_i+b_i)=\bar a+\bar b$ なので、偏差は $(a_i+b_i)-(\bar a+\bar b)=(a_i-\bar a)+(b_i-\bar b)$ である。偏差の和になるので
$$
s_{a+b,\,c}=\frac1n\sum_{i=1}^n\bigl((a_i-\bar a)+(b_i-\bar b)\bigr)(c_i-\bar c)=\frac1n\sum_{i=1}^n(a_i-\bar a)(c_i-\bar c)+\frac1n\sum_{i=1}^n(b_i-\bar b)(c_i-\bar c)=s_{ac}+s_{bc}
$$
である。
条件 (iii):変量 $a+k$ の平均は $\bar a+k$ で、偏差は $(a_i+k)-(\bar a+k)=a_i-\bar a$ と変わらない。共分散は偏差だけで決まるので変わらない。
条件 (ii) と条件 (i) を組み合わせると、右側の変量についても $s_{a,\,b+c}=s_{ab}+s_{ac}$ が成り立つ。1 次式で変換したときの共分散・相関係数の変わり方は 相関係数(高校数学) の例「変量の変換と標準化」にある。
ex-cnc-first で、$z$、$u$、$v$ の偏差は $(3,3,-3,-3)$、$(2,-2,2,-2)$、$(2,-2,-2,2)$ である。
- $s_{zz}=\dfrac{9\cdot4}4=9$、$s_{uu}=\dfrac{4\cdot4}4=4$、$s_{vv}=4$。
- $s_{zu}=\dfrac{6-6-6+6}4=0$、$s_{zv}=\dfrac{6-6+6-6}4=0$、$s_{uv}=\dfrac{4+4-4-4}4=0$。
lem-cnc-bilinear の条件 (ii) を 2 回使うと
$$ s_{xy}=s_{z+u,\,z+v}=s_{zz}+s_{zv}+s_{uz}+s_{uv}=9+0+0+0=9 $$
で、ex-cnc-first で直接計算した値と一致する。
主定理:共通の原因が相関を作る
ex-cnc-bilinear の計算を一般の形にすると、次の定理になる。
3 つの変量 $z$、$u$、$v$ の $n$ 個のデータについて、2 つずつの共分散がすべて $0$
$$
s_{zu}=s_{zv}=s_{uv}=0
$$
で、$z$ の分散が $s_z^2>0$ であるとする。$x_i=z_i+u_i$、$y_i=z_i+v_i$($i=1,\ldots,n$)とおくと、$x$ と $y$ の相関係数は
$$
r_{xy}=\frac{s_z^2}{\sqrt{(s_z^2+s_u^2)(s_z^2+s_v^2)}}
$$
であり、$r_{xy}>0$ である。
方針:lem-cnc-bilinear で共分散と分散を $z$、$u$、$v$ の分散に分け、相関係数の定義に入れる。
段 1(共分散).lem-cnc-bilinear の条件 (ii) を左側の変量と右側の変量について使うと
$$
s_{xy}=s_{z+u,\,z+v}=s_{zz}+s_{zv}+s_{uz}+s_{uv}
$$
である。仮定から $s_{zv}=s_{uv}=0$、条件 (i) と仮定から $s_{uz}=s_{zu}=0$ なので、$s_{xy}=s_{zz}=s_z^2$ である。
段 2(分散).同じく
$$
s_x^2=s_{z+u,\,z+u}=s_{zz}+s_{zu}+s_{uz}+s_{uu}=s_z^2+0+0+s_u^2=s_z^2+s_u^2
$$
で、$v$ についても同じ計算で $s_y^2=s_z^2+s_v^2$ である。$s_z^2>0$ なので $s_x^2>0$、$s_y^2>0$ で、相関係数が定義できる。
段 3(相関係数).相関係数の定義 $r_{xy}=\dfrac{s_{xy}}{s_xs_y}$ に段 1 と段 2 を入れると
$$
r_{xy}=\frac{s_z^2}{\sqrt{s_z^2+s_u^2}\,\sqrt{s_z^2+s_v^2}}=\frac{s_z^2}{\sqrt{(s_z^2+s_u^2)(s_z^2+s_v^2)}}
$$
である。分子 $s_z^2$ は正、分母も正なので $r_{xy}>0$ である。
$x$ と $y$ は、$u$ と $v$ の部分では互いに関係がない($s_{uv}=0$)。それでも共通の $z$ が入っているだけで、相関係数は正になる。相関の強さは、共通の部分の散らばり $s_z^2$ が、それぞれ固有の部分の散らばり $s_u^2$、$s_v^2$ に比べてどれだけ大きいかで決まる。
- ex-cnc-first では $s_z^2=9$、$s_u^2=s_v^2=4$ なので
$$ r_{xy}=\frac9{\sqrt{(9+4)(9+4)}}=\frac9{13} $$
で、直接計算した値と一致する。 - $s_z=1$、$s_u=0.5$、$s_v=2$ なら
$$ r_{xy}=\frac1{\sqrt{(1+0.25)(1+4)}}=\frac1{\sqrt{6.25}}=\frac1{2.5}=0.4 $$
である。図 1 は、$z$、$u$、$v$ をこの標準偏差の乱数で作ったデータである。乱数で作ったデータでは $s_{zu}$ などはちょうど $0$ にはならないので、定理はそのままは当てはまらないが、300 組での相関係数は $0.39$、20 万組では $0.398$ で、$0.4$ に近い。
定理の式から、次のことが読み取れる。
- $s_u$ と $s_v$ が $0$ に近いと、$r_{xy}$ は $1$ に近い。$x$ も $y$ もほとんど $z$ だけで決まるからである。
- $s_u$ や $s_v$ が大きいと、$r_{xy}$ は $0$ に近づくが、$s_z^2>0$ である限り $0$ にはならない。
相関係数は 2 つの偏差ベクトルのなす角の余弦である(相関係数(高校数学) の注意「相関係数は角の余弦」)。$x$ と $y$ の偏差ベクトルは、共通の成分 $z$ を持つので、同じ向きに傾き、なす角が $90^\circ$ より小さくなる。定理はそれを式で述べたものである。
層に分けると符号が逆になる
共通の原因は、相関を作るだけでなく、相関の向きを逆に見せることもある。
2 つの層に分かれたデータで、どちらの層の中でも相関係数が負なのに、層を合わせた全体では相関係数が正になるものがある。
例を 1 つ作れば示される。層 1 を $(1,4),(2,3),(3,2),(4,1)$、層 2 を $(7,12),(8,11),(9,10),(10,9)$ とする。
段 1(層 1).$x$ の平均は $\dfrac{10}4=\dfrac52$、$y$ の平均も $\dfrac52$ である。$x$ の偏差は $\left(-\dfrac32,-\dfrac12,\dfrac12,\dfrac32\right)$、$y$ の偏差はその符号を逆にしたものなので、$y$ の偏差ベクトルは $x$ の偏差ベクトルの $-1$ 倍である。したがって $r=-1$ である(相関係数(高校数学) の系「相関係数の範囲」の等号の場合)。
段 2(層 2).$x$ の平均は $\dfrac{34}4=\dfrac{17}2$、$y$ の平均は $\dfrac{42}4=\dfrac{21}2$ で、偏差は $x$ が $\left(-\dfrac32,-\dfrac12,\dfrac12,\dfrac32\right)$、$y$ が $\left(\dfrac32,\dfrac12,-\dfrac12,-\dfrac32\right)$ である。段 1 と同じく $r=-1$ である。
段 3(全体の和).8 個を合わせると、$x$ の和は $10+34=44$、$y$ の和は $10+42=52$ で、平均は $\bar x=\dfrac{11}2$、$\bar y=\dfrac{13}2$ である。2 乗の和と積の和を層ごとに計算すると
- 層 1:$\sum x_i^2=1+4+9+16=30$、$\sum y_i^2=16+9+4+1=30$、$\sum x_iy_i=4+6+6+4=20$。
- 層 2:$\sum x_i^2=49+64+81+100=294$、$\sum y_i^2=144+121+100+81=446$、$\sum x_iy_i=84+88+90+90=352$。
合わせて $\sum x_i^2=324$、$\sum y_i^2=476$、$\sum x_iy_i=372$ である。
段 4(全体の相関係数).「2 乗の平均 − 平均の 2 乗」「積の平均 − 平均の積」で分散と共分散を計算すると
$$ s_x^2=\frac{324}8-\Bigl(\frac{11}2\Bigr)^2=\frac{81}2-\frac{121}4=\frac{41}4,\qquad s_y^2=\frac{476}8-\Bigl(\frac{13}2\Bigr)^2=\frac{119}2-\frac{169}4=\frac{69}4, $$
$$ s_{xy}=\frac{372}8-\frac{11}2\cdot\frac{13}2=\frac{93}2-\frac{143}4=\frac{43}4 $$
である。よって
$$ r=\frac{43/4}{\sqrt{\dfrac{41}4\cdot\dfrac{69}4}}=\frac{43}{\sqrt{41\cdot69}}=\frac{43}{\sqrt{2829}}=0.808\ldots>0 $$
である。
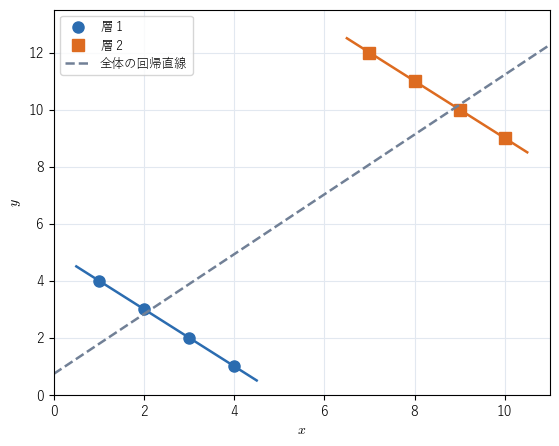 層 1(青)と層 2(橙)の散布図。各層の回帰直線は右下がりだが、全体の回帰直線(灰色の破線)は右上がりになる
図 2 に、各層の回帰直線 $y=5-x$、$y=19-x$ と、全体の回帰直線 $y=\dfrac{30}{41}+\dfrac{43}{41}x$ を描いた(回帰直線の求め方は 散布図と回帰直線)。各層の中では $x$ が大きいほど $y$ は小さいのに、層 2 は層 1 より $x$ も $y$ も大きい位置にあるので、全体では右上がりに見える。
層を表す変数(どちらの層か)を $z$ とみれば、これは冒頭の表の「共通の原因」の型である(thm-cnc-common-cause の仮定そのものは満たさない)。層 2 に属することが $x$ も $y$ も大きくしている。成功率について同じことが起こるのが Simpsonのパラドックス で、そこでは全体の率が層ごとの率の重み付きの平均になることから逆転を説明した。
prop-cnc-strata のデータをまとめると次のとおりである。
| 層 1 | 層 2 | 全体 | |
|---|---|---|---|
| $x$ の平均 | $2.5$ | $8.5$ | $5.5$ |
| $y$ の平均 | $2.5$ | $10.5$ | $6.5$ |
| 相関係数 | $-1$ | $-1$ | $0.808\ldots$ |
| 回帰直線の傾き | $-1$ | $-1$ | $\dfrac{43}{41}=1.04\ldots$ |
どちらの層でも「$x$ が $1$ 増えると $y$ が $1$ 減る」関係なのに、全体の回帰直線は「$x$ が $1$ 増えると $y$ が約 $1.05$ 増える」と言っている。全体の直線だけを見て「$x$ を増やせば $y$ が増える」と考えると、層の中での関係と逆の結論になる。
選び方が相関を作る
原因の関係がまったくなくても、データの選び方だけで相関が生まれることがある。
25 人が 2 科目の試験を受け、科目 1 の点数 $x$ と科目 2 の点数 $y$ は、どちらも $1$ から $5$ までの整数で、25 通りの組 $(x,y)$ がちょうど 1 人ずつだったとする(図 3 の左)。
(1) 25 人全員.$x$ の平均は $3$、$y$ の平均も $3$ である。偏差の積の和は
$$
\sum_{x=1}^5\sum_{y=1}^5(x-3)(y-3)=\Bigl(\sum_{x=1}^5(x-3)\Bigr)\Bigl(\sum_{y=1}^5(y-3)\Bigr)=0\cdot0=0
$$
なので、共分散は $0$、相関係数は $0$ である。2 科目の点数には関係がない。
(2) 合計点が $7$ 点以上の人だけを合格とする.$x+y\ge7$ となるのは
$$
(2,5),(3,4),(3,5),(4,3),(4,4),(4,5),(5,2),(5,3),(5,4),(5,5)
$$
の 10 人である。$x$ の和は $2+3\cdot2+4\cdot3+5\cdot4=40$、$y$ の和も同じく $40$ で、平均はどちらも $4$ である。偏差 $(x-4,\,y-4)$ は
$$
(-2,1),(-1,0),(-1,1),(0,-1),(0,0),(0,1),(1,-2),(1,-1),(1,0),(1,1)
$$
で、
- $x$ の偏差の 2 乗の和:$4+1+1+0+0+0+1+1+1+1=10$、よって $s_x^2=1$。$y$ も対称なので $s_y^2=1$。
- 偏差の積の和:$-2+0-1+0+0+0-2-1+0+1=-5$、よって $s_{xy}=-\dfrac12$。
- 相関係数:$r=\dfrac{-1/2}{1\cdot1}=-\dfrac12$。
合格者だけを見ると、「科目 1 ができる人ほど科目 2 ができない」ように見える。
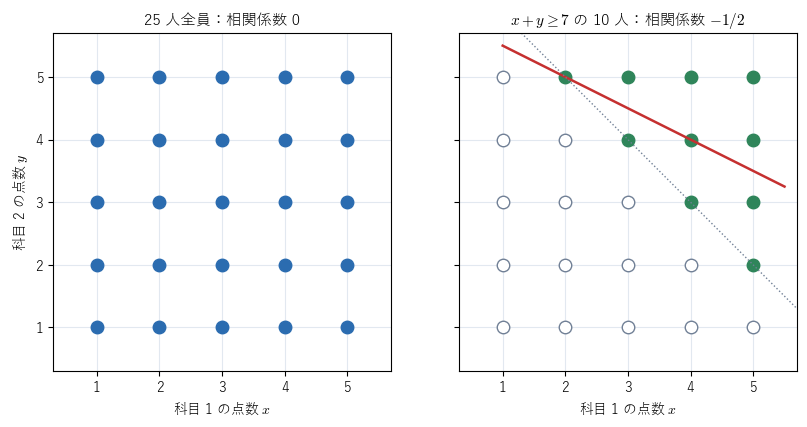 左は 25 人全員の点数で相関係数は 0、右は合計が 7 点以上の 10 人(緑)だけを選んだもので、選んだ点の回帰直線(赤)は右下がりになる
図 3 の右で、選ばれた 10 点は、直線 $x+y=7$(点線)の上か、それより右上にある。この境界が右下がりなので、$x$ が小さい人は $y$ が大きくないと選ばれず、$y$ が小さい人は $x$ が大きくないと選ばれない。その結果、選ばれた人の中では $x$ と $y$ が逆向きに動く。選ばれた 10 点の回帰直線は $y=6-\dfrac12x$ である。
この負の相関は、2 科目の力の間の関係ではなく、「合計で選んだ」という選び方から生まれたものである。データがどのように集められたか(誰が選ばれて表に載ったか)を確かめないと、相関を読み違える。標本の選び方の注意は 母集団と標本 でも扱う。
例と反例
相関係数について言われがちな 2 つの主張は、どちらも一般には成り立たない。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 関係が 1 次式に近い形である | ex-cnc-parabola($y=x^2$) | 相関係数が $0$ なら 2 つの変量は無関係 |
| $x$ と $y$ に共通の原因がない | ex-cnc-first(気温が共通の原因) | 相関があれば一方が他方の原因 |
| データの選び方が $x$、$y$ によらない | ex-cnc-selection(合計で選ぶ) | 選んだデータの相関は、全体の関係を表す |
| 層ごとの関係と全体の関係が同じ向き | prop-cnc-strata | 全体の回帰直線の傾きは、層の中での関係を表す |
$x=-2,-1,0,1,2$、$y=x^2$(つまり $y=4,1,0,1,4$)とすると、$y$ は $x$ で完全に決まるのに、相関係数は $0$ である。計算は 相関係数(高校数学) の例「反例:無相関でも無関係とは限らない」にある。相関係数が測るのは直線的な関係の強さだけで、放物線のような関係は $0$ になりうる。「相関がない」ことも「関係がない」ことを意味しない。
ex-cnc-first と thm-cnc-common-cause は 2 つ目の主張の反例である。$x$ と $y$ の固有の部分 $u$、$v$ は互いに関係がない(共分散 $0$)のに、共通の原因 $z$ があるだけで正の相関が出る。
原因を確かめるには
相関だけから原因の関係を決めることはできない。では、どうすればよいか。
「肥料 X が収穫を増やすか」を調べたいとする。どの畑に肥料 X を使うかを人が選ぶと、日当たりのよい畑を選びがちになるかもしれない。そうすると日当たり(共通の原因)が、肥料を使うかどうかと収穫の両方にかかわり、thm-cnc-common-cause と同じ仕組みで見かけの相関が出る。
そこで、肥料を使う畑を乱数で決める。すると、肥料を使うかどうかは日当たりと関係なく決まるので、日当たりのよい畑の割合は、肥料を使う畑と使わない畑でほぼ等しくなると期待できる。Simpsonのパラドックス の系「層の割合が同じなら逆転しない」の状況に近づき、共通の原因による見かけの差が起こりにくくなる。このように割り当てを乱数で決めて比べる実験を 無作為化比較実験 という。乱数の作り方は 乱数とシミュレーション で扱う。
乱数で割り当てても、偶然に偏ることはある。その偏りが偶然の範囲かどうかを確率で判断するのが、次に読む 仮説検定の考え方 である。
大学数学で見る:共通の原因を取り除いた相関
thm-cnc-common-cause の状況では、$x$ から $z$ の影響を取り除けば、$x$ と $y$ の相関は消えるはずである。これを式で確かめる。
$z$ の影響を取り除いた相関(偏相関の考え方)を開く
$x$ の $z$ への回帰直線の傾きは $\dfrac{s_{xz}}{s_z^2}$ である(散布図と回帰直線)。lem-cnc-bilinear より $s_{xz}=s_{zz}+s_{uz}=s_z^2$ なので、傾きは $1$ である。したがって、$x$ から「$z$ で説明できる部分」を引いた残り(残差)は、定数の違いを除いて $x-z=u$ である。同じく $y$ の残差は $v$ である。残差どうしの共分散は $s_{uv}=0$ なので、$z$ の影響を取り除いた相関は $0$ になる。
このように、第 3 の変量 $z$ の影響を回帰で取り除いたあとの残差どうしの相関係数を、$z$ を固定した 偏相関係数 という。thm-cnc-common-cause の状況では $r_{xz}=\dfrac{s_z^2}{s_z\sqrt{s_z^2+s_u^2}}$、$r_{yz}=\dfrac{s_z^2}{s_z\sqrt{s_z^2+s_v^2}}$ で、$r_{xy}=r_{xz}\,r_{yz}$ がちょうど成り立つ。ex-cnc-first では $r_{xz}=r_{yz}=\dfrac3{\sqrt{13}}$、$r_{xy}=\dfrac9{13}$ である。ただし、偏相関が $0$ になるのは、取り除いた $z$ が本当に共通の原因であり、関係が 1 次式で書けるときの話である。測っていない共通の原因は取り除けない。
確率変数 $X$、$Y$ についても、共分散 $\mathrm{cov}(X,Y)=E\bigl((X-E(X))(Y-E(Y))\bigr)$ と相関 $\rho(X,Y)=\dfrac{\mathrm{cov}(X,Y)}{\sqrt{V(X)V(Y)}}$ が定められ、$-1\le\rho(X,Y)\le1$ が成り立つ(GS06 §6.3 の演習問題 18)。同じ本の演習問題 17 は、$X$ と $Y$ が独立なら共分散が $0$ になること、そしてその逆は必ずしも成り立たないことを述べている。独立性については 独立性(確率論) で扱う。
さらに先へ
- 成功率について、層ごとの傾向と全体の傾向が逆になる現象は Simpsonのパラドックス で扱う。prop-cnc-strata はその相関係数版である。
- 相関係数の定義と、$-1\le r\le1$ の証明(Cauchy–Schwarz の不等式)は 相関係数(高校数学) にある。
- 確率変数の分散・共分散の計算は 確率変数の期待値と分散 で扱う。
関連項目
- 前提: 相関係数(高校数学), 散布図と回帰直線
- 前に読む: 相関係数(高校数学), 散布図と回帰直線, Simpsonのパラドックス
- 次に読む: 仮説検定の考え方
- 関連(高校数学): 平均・中央値・分散, 確率変数の期待値と分散, 乱数とシミュレーション, 母集団と標本
- 発展: 確率変数, 独立性(確率論)
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

