確率的勾配降下法
概要
確率的勾配降下法(stochastic gradient descent)とは、期待値や多数の項の平均で書かれた関数の最小点を、勾配の代わりに平均すると勾配に等しい乱数のベクトルを使って探す反復法で、各回で標本を 1 つ(または少数)選んでその勾配の方向に進むので、1 回の費用は項の数によらない。勾配の分散が有界で関数が凸かつ滑らかなら、反復の平均点の誤差の期待値は反復回数の平方根に反比例して減る。強凸なら、一定の刻み幅では刻み幅に比例する範囲まで等比数列の速さで近づき、刻み幅を反復回数に反比例して減らすと距離の 2 乗の期待値が反復回数に反比例して減る。機械学習の損失の最小化に広く使われる。
確率的勾配降下法(stochastic gradient descent, SGD)は、期待値や多数の項の平均で書かれた関数
$$
f(x)=\mathbb{E}\bigl[F(x,\xi)\bigr]\qquad\text{または}\qquad f(x)=\frac1N\sum_{i=1}^Nf_i(x)
$$
の最小点を、勾配そのものではなく、平均すると勾配に等しい乱数のベクトル を使って探す反復法である。各回で標本 $\xi$(または番号 $i$)を 1 つ選び、$x_{k+1}=x_k-\eta_k\nabla f_i(x_k)$ のように更新する。$N$ が大きいとき、勾配降下法 は 1 回の更新に $N$ 個の勾配の計算を要するが、確率的勾配降下法は 1 個で済む。機械学習の学習(損失の平均の最小化)は主にこの方法とその変種で行われる。
代償は雑音である。刻み幅 $\eta$ を一定にすると、反復は最小点に収束せず、$\eta$ に比例する大きさのゆらぎの中にとどまる。刻み幅を $1/k$ の程度で小さくすれば最小点に近づくが、速さは等比数列ではなく $1/k$ の程度になる。凸で滑らかな関数では、反復の平均点の誤差は反復回数 $K$ について $1/\sqrt K$ の程度で減る。
この記事では、勾配の不偏性と分散の上界を仮定して、凸で滑らかな関数の平均点の誤差の評価(主定理)、強凸な関数での一定の刻み幅と減らす刻み幅の評価、凸でない関数での勾配の評価、ミニバッチによる分散の減少を証明する。
定義と使える条件
$\|\cdot\|$ は Euclid ノルムとする。$\xi$ は確率変数で、$\xi_0,\xi_1,\dots$ はそれと同じ分布をもつ独立な列とする。
$f\colon\mathbb{R}^n\to\mathbb{R}$ を微分可能とする。可測な写像 $G\colon\mathbb{R}^n\times\Xi\to\mathbb{R}^n$($\Xi$ は $\xi$ の値の集合)が、すべての $x$ について
$$
\mathbb{E}\bigl[G(x,\xi)\bigr]=\nabla f(x),\qquad\mathbb{E}\bigl[\|G(x,\xi)-\nabla f(x)\|^2\bigr]\le\sigma^2
$$
を満たすとき、$G$ を 分散 $\sigma^2$ 以下の確率的勾配 という。初期値 $x_0$ と刻み幅 $\eta_0,\eta_1,\dots>0$ について
$$
x_{k+1}=x_k-\eta_k\,G(x_k,\xi_k)\qquad(k=0,1,2,\dots)
$$
で点列を作る方法を 確率的勾配降下法 という。$\bar x_K:=\frac1K\sum_{k=1}^Kx_k$ を 平均点 という。
有限和 $f=\frac1N\sum_if_i$ では、$\xi$ を $\{1,\dots,N\}$ の一様分布とし $G(x,i)=\nabla f_i(x)$ とすれば、$\mathbb{E}[G(x,\xi)]=\nabla f(x)$ である。$x_k$ は $\xi_0,\dots,\xi_{k-1}$ で決まり、$\xi_k$ はそれらと独立なので、$x_k$ を固定して $\xi_k$ について平均してよい(条件付き期待値)。この平均を $\mathbb{E}_k$ と書く。
$L$ 平滑性と $m$ 強凸性は 勾配降下法 の定義「L 平滑と m 強凸」のとおりである:すべての $x,y$ で $\|\nabla f(x)-\nabla f(y)\|\le L\|x-y\|$ のとき $L$ 平滑、$f(y)\ge f(x)+\nabla f(x)\cdot(y-x)+\frac m2\|y-x\|^2$ のとき $m$ 強凸 という。
この記事の評価を使う条件をまとめる。
- 不偏性:$\mathbb{E}[G(x,\xi)]=\nabla f(x)$(すべての $x$)。
- 分散の上界:$\mathbb{E}\|G(x,\xi)-\nabla f(x)\|^2\le\sigma^2$(すべての $x$ で同じ $\sigma^2$)。
- $L$ 平滑:$f$ は $L$ 平滑である。
- 凸性:$f$ は凸(主定理)、または $m$ 強凸(thm-sgd-strong)。凸でなければ prop-sgd-nonconvex だけが使える。
- 最小点:$f(x^*)=\min f$ となる $x^*$ がある。$f^*:=f(x^*)$ とおく。
- 刻み幅:$\eta_k\le1/L$。
条件 2 は、$x$ について一様な上界であることに注意する。最小二乗法の有限和のように、標本ごとの勾配のずれが $\|x\|$ とともに大きくなる問題では、全空間では成り立たない(節「補足」)。
公式の表
$R:=\|x_0-x^*\|$ とする。
| 設定 | 刻み幅 | 評価 | 根拠 |
|---|---|---|---|
| 凸、$L$ 平滑、分散 $\sigma^2$ | 一定 $\eta\le\frac1L$ | $\mathbb{E}f(\bar x_K)-f^*\le\dfrac{R^2}{2\eta K}+\eta\sigma^2$ | thm-sgd-convex |
| 同上 | $\eta=\min\bigl\{\frac1L,\frac R{\sigma\sqrt{2K}}\bigr\}$ | $\mathbb{E}f(\bar x_K)-f^*\le\dfrac{LR^2}{2K}+\dfrac{\sqrt2\,\sigma R}{\sqrt K}$ | thm-sgd-convex |
| $m$ 強凸、$L$ 平滑、分散 $\sigma^2$ | 一定 $\eta\le\frac1L$ | $\mathbb{E}\|x_k-x^*\|^2\le(1-\eta m)^kR^2+\dfrac{\eta\sigma^2}m$ | thm-sgd-strong |
| 同上 | $\eta_k=\frac\beta{k+\gamma}$、$\beta m>1$、$\frac\beta\gamma\le\frac1L$ | $\mathbb{E}\|x_k-x^*\|^2\le\dfrac{\nu}{k+\gamma}$、$\nu=\max\bigl\{\frac{\beta^2\sigma^2}{\beta m-1},\gamma R^2\bigr\}$ | thm-sgd-strong |
| $L$ 平滑、下に有界($f\ge f_{\inf}$) | 一定 $\eta\le\frac1L$ | $\dfrac1K\sum_{k=0}^{K-1}\mathbb{E}\|\nabla f(x_k)\|^2\le\dfrac{2(f(x_0)-f_{\inf})}{\eta K}+L\eta\sigma^2$ | prop-sgd-nonconvex |
| ミニバッチ $b$ 個の平均 | — | 分散 $\le\sigma^2/b$ | prop-sgd-minibatch |
| 凸、$\|G\|\le\rho$(確率 1)、$\|x^*\|\le B$、$x_1=0$ | 一定 $\eta=\frac B{\rho\sqrt T}$ | $\mathbb{E}f\bigl(\frac1T\sum_{t=1}^Tx_t\bigr)-f(x^*)\le\dfrac{B\rho}{\sqrt T}$ | 証明しない:SSBD14 Theorem 14.8(p. 192) |
最後の行は微分できない凸関数(劣勾配)でも成り立つ形で、添字は文献に合わせて $x_1$ から始めている。
主定理と証明
1 回の更新の評価
条件 1・2 を仮定し、$x_{k+1}=x_k-\eta G(x_k,\xi_k)$ とする。
- 任意の点 $z$ について $\mathbb{E}_k\|x_{k+1}-z\|^2\le\|x_k-z\|^2-2\eta\,\nabla f(x_k)\cdot(x_k-z)+\eta^2\|\nabla f(x_k)\|^2+\eta^2\sigma^2$。
- さらに条件 3 を仮定すると $\mathbb{E}_kf(x_{k+1})\le f(x_k)-\eta\bigl(1-\frac{L\eta}2\bigr)\|\nabla f(x_k)\|^2+\frac{L\eta^2\sigma^2}2$。$\eta\le1/L$ なら右辺は $f(x_k)-\frac\eta2\|\nabla f(x_k)\|^2+\frac{L\eta^2\sigma^2}2$ 以下である。
$g:=\nabla f(x_k)$、$G:=G(x_k,\xi_k)$ とおく。$\mathbb{E}_kG=g$ なので $\mathbb{E}_k\|G\|^2=\|g\|^2+2g\cdot\mathbb{E}_k(G-g)+\mathbb{E}_k\|G-g\|^2\le\|g\|^2+\sigma^2$ である。1:$\|x_{k+1}-z\|^2=\|x_k-z\|^2-2\eta\,G\cdot(x_k-z)+\eta^2\|G\|^2$ を $\mathbb{E}_k$ で平均すると、$x_k-z$ は固定されているので $\mathbb{E}_k[G\cdot(x_k-z)]=g\cdot(x_k-z)$ となり、上の評価と合わせて主張を得る。2:勾配降下法 の補題「降下補題」により $f(x_{k+1})\le f(x_k)-\eta\,g\cdot G+\frac{L\eta^2}2\|G\|^2$ で、平均すると $\mathbb{E}_kf(x_{k+1})\le f(x_k)-\eta\|g\|^2+\frac{L\eta^2}2(\|g\|^2+\sigma^2)$ である。$\eta\le1/L$ なら $1-\frac{L\eta}2\ge\frac12$ である。$\square$
ここで $\mathbb{E}\|x_k\|^2<\infty$ が帰納的に保たれることを使っている($\mathbb{E}_k\|G\|^2\le\|g\|^2+\sigma^2$ と $\|g\|\le\|\nabla f(x_0)\|+L\|x_k-x_0\|$ から分かる。最小点を仮定しない prop-sgd-nonconvex でも同じ)。
主定理:凸で滑らかな場合
条件 1〜3・5 を仮定し、$f$ は凸とする。一定の刻み幅 $0<\eta\le1/L$ で確率的勾配降下法を $K$ 回行うと、平均点 $\bar x_K$ について
$$
\mathbb{E}f(\bar x_K)-f^*\le\frac{\|x_0-x^*\|^2}{2\eta K}+\eta\sigma^2
$$
が成り立つ。とくに $\eta=\min\{1/L,\ R/(\sigma\sqrt{2K})\}$($R=\|x_0-x^*\|>0$)とすると
$$
\mathbb{E}f(\bar x_K)-f^*\le\frac{LR^2}{2K}+\frac{\sqrt2\,\sigma R}{\sqrt K}.
$$
$D_k:=\mathbb{E}\|x_k-x^*\|^2$ とおく。lem-sgd-step の 1 を $z=x^*$ で使って整理すると
$$
\nabla f(x_k)\cdot(x_k-x^*)\le\frac{\|x_k-x^*\|^2-\mathbb{E}_k\|x_{k+1}-x^*\|^2}{2\eta}+\frac\eta2\|\nabla f(x_k)\|^2+\frac{\eta\sigma^2}2
$$
である。$f$ は凸なので $f(x_k)-f^*\le\nabla f(x_k)\cdot(x_k-x^*)$ である(凸最適化 の補題「凸関数は接平面より上にある」)。lem-sgd-step の 2 と合わせると
$$
\mathbb{E}_kf(x_{k+1})-f^*\le\nabla f(x_k)\cdot(x_k-x^*)-\frac\eta2\|\nabla f(x_k)\|^2+\frac{L\eta^2\sigma^2}2\le\frac{\|x_k-x^*\|^2-\mathbb{E}_k\|x_{k+1}-x^*\|^2}{2\eta}+\frac{\eta\sigma^2}2(1+L\eta)
$$
で、$L\eta\le1$ より最後の項は $\eta\sigma^2$ 以下である。$\|\nabla f(x_k)\|^2$ の項が打ち消し合ったことに注意する。全体の期待値をとり $k=0,\dots,K-1$ について足すと、右辺の第 1 項は差の和なので
$$
\sum_{k=1}^K\bigl(\mathbb{E}f(x_k)-f^*\bigr)\le\frac{D_0-D_K}{2\eta}+K\eta\sigma^2\le\frac{\|x_0-x^*\|^2}{2\eta}+K\eta\sigma^2
$$
である。$f$ は凸なので $f(\bar x_K)\le\frac1K\sum_{k=1}^Kf(x_k)$ であり、両辺を $K$ で割れば最初の評価を得る。
刻み幅の選び方:$\eta=R/(\sigma\sqrt{2K})\le1/L$ の場合、2 つの項はどちらも $\sigma R/\sqrt{2K}$ で、和は $\sqrt2\,\sigma R/\sqrt K$ である。$\eta=1/L< R/(\sigma\sqrt{2K})$ の場合、第 1 項は $LR^2/(2K)$、第 2 項は $\sigma^2/L<\sigma R/\sqrt{2K}$ である。どちらの場合も主張の右辺以下である($\sigma=0$ なら $\eta=1/L$ とする)。$\square$
$\sigma=0$(勾配が正確)のとき評価は $LR^2/(2K)$ で、勾配降下法 の定理「凸の場合の評価」と同じ形になる。雑音があると、主要な項は $\sigma R/\sqrt K$ の程度になる。誤差を $\varepsilon$ 以下にするのに必要な反復の回数はおよそ $2\sigma^2R^2/\varepsilon^2$ で、勾配降下法の $LR^2/(2\varepsilon)$ より $\varepsilon$ への依存は悪いが、1 回の費用が $1/N$ なので、$N$ が大きく精度をそれほど求めない問題では有利になる。最適な $\eta$ は $R$ に依存し、実際には $R$ は分からないので、刻み幅は試行で決めることが多い。
強凸な場合
条件 1〜3・5 を仮定し、$f$ は $m$ 強凸とする。$D_k:=\mathbb{E}\|x_k-x^*\|^2$ とおく。
- 一定の刻み幅 $0<\eta\le1/L$ では $D_k\le(1-\eta m)^kD_0+\dfrac{\eta\sigma^2}m$。
- $\eta_k=\dfrac\beta{k+\gamma}$($\beta m>1$、$\gamma>0$、$\beta/\gamma\le1/L$)では $D_k\le\dfrac\nu{k+\gamma}$、$\nu:=\max\Bigl\{\dfrac{\beta^2\sigma^2}{\beta m-1},\ \gamma D_0\Bigr\}$。
どちらの場合も $\mathbb{E}f(x_k)-f^*\le\frac L2D_k$ である。
まず 2 つの不等式を用意する。(a) $L$ 平滑性と降下補題を $y=x-\nabla f(x)/L$ に使うと $f^*\le f(y)\le f(x)-\frac1{2L}\|\nabla f(x)\|^2$、すなわち $\|\nabla f(x)\|^2\le2L(f(x)-f^*)$。(b) 強凸性の不等式を $y=x^*$ に使うと $\nabla f(x)\cdot(x-x^*)\ge f(x)-f^*+\frac m2\|x-x^*\|^2$。
刻み幅 $\eta\le1/L$ の 1 回の更新について、lem-sgd-step の 1($z=x^*$)に (a)・(b) を代入すると
$$
\mathbb{E}_k\|x_{k+1}-x^*\|^2\le(1-\eta m)\|x_k-x^*\|^2-2\eta(1-L\eta)\bigl(f(x_k)-f^*\bigr)+\eta^2\sigma^2\le(1-\eta m)\|x_k-x^*\|^2+\eta^2\sigma^2
$$
である。全体の期待値をとって $D_{k+1}\le(1-\eta m)D_k+\eta^2\sigma^2$ を得る。ここで $m\le L$($x^*$ を基点に強凸性と降下補題を使い $\nabla f(x^*)=0$ とすると $\frac m2\|x-x^*\|^2\le f(x)-f^*\le\frac L2\|x-x^*\|^2$)なので $0\le1-\eta m<1$ である。
1:漸化式から $D_{k+1}-\frac{\eta\sigma^2}m\le(1-\eta m)\bigl(D_k-\frac{\eta\sigma^2}m\bigr)$ で、繰り返すと $D_k-\frac{\eta\sigma^2}m\le(1-\eta m)^k\bigl(D_0-\frac{\eta\sigma^2}m\bigr)\le(1-\eta m)^kD_0$ である。
2:$\eta_k\le\beta/\gamma\le1/L$ なので上の漸化式が各 $k$ で使える。$D_k\le\nu/(k+\gamma)$ を帰納法で示す。$k=0$ は $\nu\ge\gamma D_0$ による。$k$ で成り立つとし、$\hat k:=k+\gamma$ とおくと
$$
D_{k+1}\le\Bigl(1-\frac{\beta m}{\hat k}\Bigr)\frac\nu{\hat k}+\frac{\beta^2\sigma^2}{\hat k^2}=\frac{(\hat k-1)\nu}{\hat k^2}-\frac{(\beta m-1)\nu-\beta^2\sigma^2}{\hat k^2}\le\frac{(\hat k-1)\nu}{\hat k^2}\le\frac\nu{\hat k+1}
$$
である($1-\beta m/\hat k\ge0$ を使った。最後は $(\hat k-1)(\hat k+1)\le\hat k^2$)。
値の評価:$\nabla f(x^*)=0$ と降下補題から $f(x)-f^*\le\frac L2\|x-x^*\|^2$ である。$\square$
1 は、反復が等比数列の速さで半径 $\sqrt{\eta\sigma^2/m}$ ほどの範囲に入り、そこから先は小さくならないことを示す。刻み幅を半分にすると到達する範囲も半分になるが、縮む割合 $1-\eta m$ は 1 に近づく。2 は刻み幅を $1/k$ の程度で減らせば $D_k$ が $1/k$ の程度で $0$ に近づくことを示す。この形の評価は BCN18 Theorem 4.6・4.7(pp. 26–29)が関数値について述べている。
凸でない場合とミニバッチ
条件 1〜3 を仮定し、$f\ge f_{\inf}$ とする。一定の刻み幅 $0<\eta\le1/L$ で
$$
\frac1K\sum_{k=0}^{K-1}\mathbb{E}\|\nabla f(x_k)\|^2\le\frac{2(f(x_0)-f_{\inf})}{\eta K}+L\eta\sigma^2.
$$
証明を開く
lem-sgd-step の 2 の全体の期待値をとると $\frac\eta2\mathbb{E}\|\nabla f(x_k)\|^2\le\mathbb{E}f(x_k)-\mathbb{E}f(x_{k+1})+\frac{L\eta^2\sigma^2}2$ である。$k=0,\dots,K-1$ について足すと右辺の差の和は $f(x_0)-\mathbb{E}f(x_K)\le f(x_0)-f_{\inf}$ 以下で、$\frac{\eta K}2$ で割れば主張を得る(BCN18 Theorem 4.8、p. 32 に同じ形の評価がある)。$\square$
$G$ が分散 $\sigma^2$ 以下の確率的勾配なら、独立な $\xi^{(1)},\dots,\xi^{(b)}$ による平均 $G_b(x):=\frac1b\sum_{l=1}^bG(x,\xi^{(l)})$ は分散 $\sigma^2/b$ 以下の確率的勾配である。
証明を開く
不偏性は期待値の線形性による。$Z_l:=G(x,\xi^{(l)})-\nabla f(x)$ は独立で平均 $0$ なので、$l\ne l'$ で $\mathbb{E}[Z_l\cdot Z_{l'}]=\mathbb{E}Z_l\cdot\mathbb{E}Z_{l'}=0$ である。よって $\mathbb{E}\|G_b-\nabla f\|^2=\frac1{b^2}\sum_l\mathbb{E}\|Z_l\|^2\le\frac{\sigma^2}b$ である。$\square$
ミニバッチは 1 回の費用を $b$ 倍にして分散を $1/b$ 倍にする。thm-sgd-convex の主要な項 $\sigma R/\sqrt K$ に代入すると、同じ数の標本($bK$ 個)を使ったときの評価は変わらない。利点は並列計算と、雑音が小さいぶん大きな刻み幅($\eta\le1/L$ まで)を使える範囲が広がることにある。
計算の手順
- 確率的勾配を作る:有限和なら番号 $i$ を一様に選び $G=\nabla f_i$ とする。不偏性(条件 1)を確かめる。選ぶ確率が一様でなければ $\nabla f_i$ に重みを掛けて直す。
- 定数を見積もる:$L$(各 $f_i$ が $L_i$ 平滑なら $L\le\frac1N\sum L_i$)と $\sigma^2$($\|\nabla f_i\|\le\rho$ なら $\sigma^2\le\rho^2$、lem-sgd-step の証明の等式から)を求める。強凸なら $m$ も求める。
- 刻み幅を決める:凸なら公式の表の 2 行目、強凸で精度を上げたいなら 4 行目の形をとる。$\eta>1/L$ にしない。
- 反復して出力を選ぶ:凸なら平均点 $\bar x_K$、強凸なら最後の点 $x_K$ を出力する。
- 評価する:$f$ そのものを計算できるなら $f(\bar x_K)$ を見る。できなければ、別に取っておいた標本の平均で $f$ を見積もる。
例題
$\xi$ は平均 $3$、分散 $4$ の正規分布、$f(x)=\frac12\mathbb{E}(x-\xi)^2$、$G(x,\xi)=x-\xi$、$x_0=0$、$\eta_k=\frac1{k+1}$。
使う公式:def-sgd-method。
答え:$x_K=\frac1K\sum_{k=0}^{K-1}\xi_k$(標本平均)で、$\mathbb{E}(x_K-3)^2=\frac4K$。$K=100$ で $0.04$(乱数による 20000 回の平均は $0.03937$)。
途中の計算を開く
$f(x)=\frac12(x-3)^2+2$ なので $x^*=3$、$m=L=1$、$\sigma^2=\operatorname{Var}\xi=4$。$x_{k+1}=\frac k{k+1}x_k+\frac1{k+1}\xi_k$ から帰納的に $x_K$ は $\xi_0,\dots,\xi_{K-1}$ の平均で、その分散は $4/K$。$\beta=\gamma=1$ は $\beta m=1$ なので thm-sgd-strong の 2 の条件 $\beta m>1$ の境目にあたるが、この例では $1/K$ の速さが成り立つ。
$f(x)=\frac12(x_1^2+10x_2^2)$、$G(x,\xi)=\nabla f(x)+\xi$($\xi$ は平均 $0$、共分散 $\frac12I$ の正規分布、$\sigma^2=1$)、$x_0=(1,1)$。
使う公式:thm-sgd-strong、prop-sgd-minibatch。$m=1$、$L=10$、$D_0=2$。
答え:$D_k=\mathbb{E}\|x_k\|^2$ は
| 刻み幅 | 厳密な値 | 定理の上界 |
|---|---|---|
| $\eta=0.1$、$k\to\infty$ | $0.031316$ | $0.1$ |
| $\eta=0.01$、$k\to\infty$ | $0.002776$ | $0.01$ |
| $\eta_k=\frac2{k+20}$、$k=1000$ | $0.000705$ | $\frac{40}{1020}\approx0.0392$ |
| $\eta=0.1$、ミニバッチ $b=4$、$k\to\infty$ | $0.007829$ | $0.025$ |
途中の計算を開く
成分ごとに $x_{k+1,j}=(1-\eta h_j)x_{k,j}-\eta\xi_{k,j}$($h=(1,10)$)なので $\mathbb{E}x_{k+1,j}^2=(1-\eta h_j)^2\mathbb{E}x_{k,j}^2+\frac{\eta^2}2$。一定の $\eta$ の極限は $\sum_j\frac{\eta}{2h_j(2-\eta h_j)}$ で、$\eta=0.1$ では $\frac{0.1}{2\cdot1.9}+\frac{0.1}{20}=0.031316$。減らす刻み幅は $\beta=2$、$\gamma=20$ で $\beta m=2>1$、$\beta/\gamma=1/L$、$\nu=\max\{4,40\}=40$。$k=1000$ の値は漸化式から(乱数による 20000 回の平均は $0.000702$)。$kD_k$ は $k=100,1000,10000$ で $0.67,0.71,0.72$ で、$1/k$ の速さが見える。ミニバッチは分散 $1/4$ で極限も $1/4$ 倍。
8 個の点 $t_i=-2,-1,-0.5,0,0.5,1,1.5,2$、ラベル $y_i=-1,-1,1,-1,1,-1,1,1$、$a_i=(1,t_i)$ について $f(w)=\frac18\sum_{i=1}^8\log\bigl(1+e^{-y_ia_i\cdot w}\bigr)$ を、$w_0=0$ から $K=1000$ 回の確率的勾配降下法で最小化する。
使う公式:thm-sgd-convex、手順 2。
答え:$w^*\approx(-0.253318,\,1.151590)$、$f^*\approx0.521502$。$L\le0.6484$、$\sigma^2\le2.5938$、$R=\|w^*\|\approx1.179122$ から $\eta\approx0.016371$ で、上界は $0.085376$。乱数による 400 回の実行で $f(\bar w_K)-f^*$ の平均は $0.009371$、最大は $0.016712$。
途中の計算を開く
$\nabla f_i(w)=-y_is_ia_i$、$s_i=1/(1+e^{y_ia_i\cdot w})\in(0,1)$ で、$\|\nabla f_i\|\le\|a_i\|$。よって $\sigma^2\le\frac18\sum\|a_i\|^2=\frac{20.75}8=2.59375$。Hesse 行列は $\frac18\sum s_i(1-s_i)a_ia_i^{\mathsf T}\preceq\frac1{32}\sum a_ia_i^{\mathsf T}$ で、最大固有値は跡 $\frac{20.75}{32}=0.6484$ 以下。$\eta=\min\{1/L,R/(\sigma\sqrt{2000})\}=R/(\sigma\sqrt{2000})$。実際の誤差は上界より 1 桁小さい。
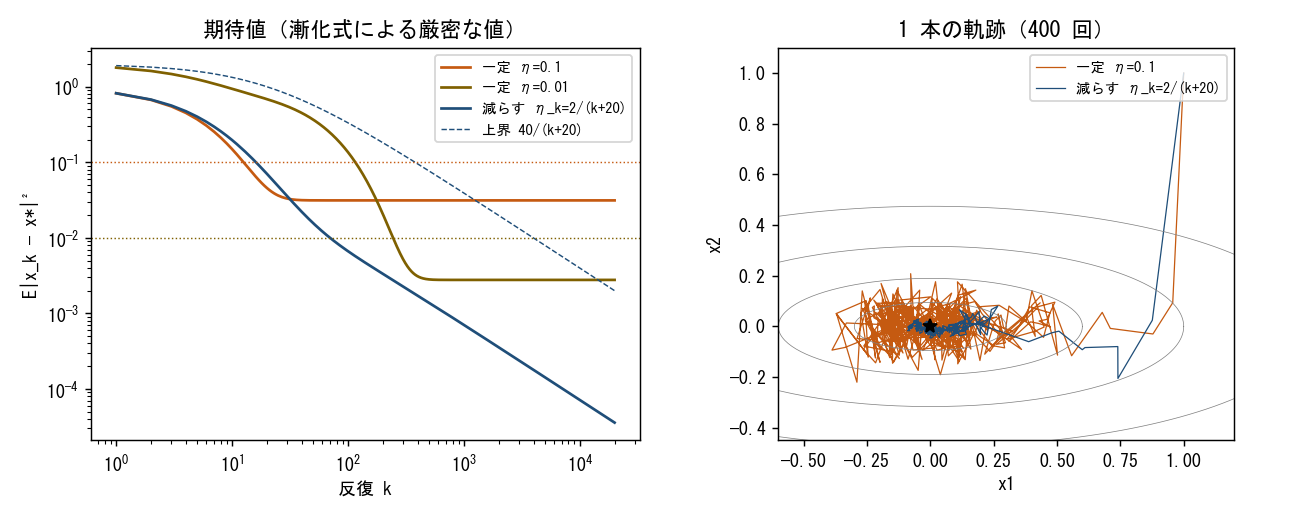 図: 左は例題「雑音のある 2 次関数」の E|x_k − x*|² を両対数で描いたもの。一定の刻み幅 0.1 と 0.01 の曲線はそれぞれ点線で示した上界 0.1、0.01 より下の高さで水平になり、刻み幅 2/(k+20) の曲線は傾き −1 の直線に沿って減り、破線の上界 40/(k+20) より下にある。右は 1 本の軌跡で、一定の刻み幅では最小点のまわりでゆらぎ続け、減らす刻み幅では最小点に近づく。
使える条件と反例
thm-sgd-convex・thm-sgd-strong の条件のうち 1 つだけを外した例を挙げる(1 次元、$x^*=0$)。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 刻み幅 $\eta\le1/L$ | $f=\frac12x^2$($L=1$)、雑音なし、$\eta=3$、$x_0=1$ | $x_k=(-2)^k$ で発散($x_5=-32$) |
| 不偏性 | $f=\frac12x^2$、$G=x+0.5$(雑音なし) | $0<\eta<2$ のどの一定の刻み幅でも $x_k\to-0.5$、誤差 $0.125$ が残る。条件 2 は $\sigma^2=0.25$ で成り立ち、$x_0\ne0$ なら thm-sgd-convex の 2 つ目の刻み幅では右辺が $0$ に近づくので評価が成り立たない(一定の $\eta$ では $\eta<\frac12$ のとき極限の上界 $\eta\sigma^2$ を超える) |
| 分散の上界 | $f=\frac12x^2$、$G=x+\xi$、$\xi$ は自由度 2 の $t$ 分布 | $\mathbb{E}x_1^2=+\infty$ |
| 凸性 | $f=x^2+10\sin^2x$($L=22$)、雑音なし、$\eta=\frac1{22}$、$x_0=2.5$ | $x_k\to2.839604$、$f\to8.947934$ で $f^*=0$ に近づかない |
| $\beta m>1$ | 例題「平均の推定」で $\eta_k=\frac1{4(k+1)}$ | $D_k$ は $k^{-1/2}$ の程度でしか減らず、$kD_k\to\infty$ |
確認を開く
1 行目:$x_{k+1}=(1-3)x_k$。2 行目:$x_{k+1}=x_k-\eta(x_k+0.5)$ の不動点は $-0.5$ で、$0<\eta<2$ なら収束する。$\mathbb{E}G=x+0.5\ne\nabla f$。3 行目:$\xi$ は平均 $0$ だが $\mathbb{E}\xi^2=\infty$ なので $\mathbb{E}x_1^2=(1-\eta)^2+\eta^2\mathbb{E}\xi^2=\infty$。4 行目:$f''=2+20\cos2x\in[-18,22]$ なので $L=22$。$x=2.839604$ は $f'=0$、$f''\approx18.46>0$ の極小点で、勾配降下はそこに収束する。$\sigma=0$ なら thm-sgd-convex の右辺は $LR^2/(2K)\to0$ のはずである。5 行目:$\mathbb{E}(x_k-3)^2$ の漸化式 $D_{k+1}=(1-\eta_k)^2D_k+4\eta_k^2$ から $D_{k+1}\ge(1-\eta_k)^2D_k$ を繰り返して $D_k\ge D_0\prod_{j=1}^{k}\bigl(1-\frac1{4j}\bigr)^2$($D_0=9$)である。$0\le t\le\frac14$ で $\log(1-t)\ge-t-t^2$、また $\sum_{j\le k}\frac1j\le1+\log k$ なので $D_k\ge9e^{-1/2-\pi^2/48}k^{-1/2}\approx4.44\,k^{-1/2}$ となり、$kD_k\to\infty$ である(漸化式の値は $k=10^6$ で $\sqrt kD_k\approx6.71$)。
刻み幅を速く減らしすぎても収束しない。雑音のない $f=\frac12x^2$ で $\eta_k=\frac1{(k+2)^2}$ とすると $x_k=x_0\prod_{j=2}^{k+1}(1-j^{-2})\to x_0/2$ で、最小点に届かない。刻み幅について $\sum_k\eta_k=\infty$、$\sum_k\eta_k^2<\infty$ を求める条件は Robbins–Monro の条件と呼ばれる(BCN18 (4.19)、p. 28)。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 一定の刻み幅で最小点に収束すると考える | $\eta$ に比例する範囲でゆらぎ続ける | thm-sgd-strong の 1、例題「雑音のある 2 次関数」 |
| 凸な場合に最後の点 $x_K$ の評価として主定理を使う | 主定理は平均点 $\bar x_K$ の評価 | 証明の最後で $f$ の凸性を平均に使った |
| 刻み幅を勾配降下法と同じ大きさにすれば速い | $\eta\le1/L$ の範囲でも、大きいほど雑音の項 $\eta\sigma^2$ が大きい | thm-sgd-convex の 2 つの項の釣り合い |
| 標本を選び直さずに同じ点を使い続ける | 各回で独立に選ぶ | 不偏性は $\xi_k$ が $x_k$ と独立なことに依存する |
| 最小二乗法にそのまま分散の上界を使う | 有界な範囲に制限するか、一般化した条件を使う | $\nabla f_i$ のずれが $\|x\|$ とともに増える |
補足
- 一般化した分散の条件:BCN18 Assumption 4.3(p. 24)は、分散が $M+M_V\|\nabla f(x)\|^2$ 以下という条件で同じ形の評価を与える。最小二乗法 の有限和は、強凸なら $\|x-x^*\|$ が $\|\nabla f(x)\|$ で抑えられるのでこの条件を満たす。
- 強凸で滑らかでない場合:$\mathbb{E}\|G\|^2\le\rho^2$ と凸集合への射影を仮定し $\eta_t=\frac1{mt}$ とすると、平均点の誤差は $\frac{\rho^2(1+\log T)}{2mT}$ 以下になる(SSBD14 Theorem 14.11、p. 195。この記事では証明しない)。
- 収束の意味:この記事の評価はすべて期待値についてのものである。確率 1 の収束は マルチンゲール の収束定理を使って示されるが、この記事では扱わない。
関連項目
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

