Chebyshevの不等式(高校数学)
概要
Chebyshevの不等式(Chebyshev's inequality)とは、データ $x_1,\dots,x_n$ の平均を $\bar x$、標準偏差を $s>0$ とするとき、正の実数 $k$ に対し $\lvert x_i-\bar x\rvert\ge ks$ を満たすデータの個数は $\frac n{k^2}$ 以下である、という不等式である。分散の定義の和を遠いデータとそれ以外に分けて評価すると示せ、とる値が有限個の確率変数 $X$(平均 $\mu$、標準偏差 $\sigma>0$)でも $P(\lvert X-\mu\rvert\ge k\sigma)\le\frac1{k^2}$ が成り立つ。等号になるデータの例があり、上界は一般には改良できないが、正規分布の確率と比べるとずっと粗い。Chebyshev の和の不等式とは別のものである。
前提知識: 平均値と二乗誤差, 確率変数の期待値と分散
高校での出発点:平均から遠いデータは何個あるか
テストの結果が「平均 65 点、標準偏差 13 点」と発表された。点数の分布の形は分からない。それでも、平均から遠く離れた点数をとった人が多すぎることはない、と言えるだろうか。たとえば、平均から標準偏差の 2 倍(26 点)以上離れた人は、全体の何割まででありうるか。
この記事では、データの分散を偏差の 2 乗の平均で定める。データ $x_1,\dots,x_n$ の平均を $\bar x$ とすると、分散は $s^2=\dfrac1n\sum_{i=1}^n(x_i-\bar x)^2$、標準偏差は $s=\sqrt{s^2}$ である。
20 人の得点が次のとおりだったとする。
$$
30,\ 46,\ 52,\ 55,\ 58,\ 60,\ 62,\ 63,\ 64,\ 65,\ 66,\ 67,\ 68,\ 70,\ 72,\ 74,\ 76,\ 80,\ 84,\ 88
$$
(1) 合計は $1300$ なので、平均は $\bar x=\dfrac{1300}{20}=65$ である。
(2) 偏差は順に $-35,-19,-13,-10,-7,-5,-3,-2,-1,0,1,2,3,5,7,9,11,15,19,23$ で、その 2 乗の和は
$$
1225+361+169+100+49+25+9+4+1+0+1+4+9+25+49+81+121+225+361+529=3348
$$
である。分散は $s^2=\dfrac{3348}{20}=167.4$、標準偏差は $s=\sqrt{167.4}=12.93\ldots$ である。
(3) 平均から $2s=25.87\ldots$ 以上離れているのは、偏差の絶対値が $25.87\ldots$ 以上のデータで、$30$(偏差 $-35$)の 1 個だけである。20 個のうちの 1 個で、割合は $\dfrac1{20}=5\%$ である。
この例では $2s$ 以上離れたデータは 1 個だった。では、データをどう選んでも、$2s$ 以上離れたデータが多くなることはないのだろうか。極端なデータで試してみる。
8 個のデータ $-1,\ 1,\ 0,\ 0,\ 0,\ 0,\ 0,\ 0$ を考える。平均は $\dfrac{-1+1}8=0$、偏差の 2 乗の和は $1+1=2$ なので、分散は $s^2=\dfrac28=\dfrac14$、標準偏差は $s=\dfrac12$ である。
平均 $0$ から $2s=1$ 以上離れているのは $-1$ と $1$ の 2 個で、割合は $\dfrac28=\dfrac14=25\%$ である。ex-chb-scores の $5\%$ よりずっと大きい。
この記事の主定理によれば、どんなデータでも、平均から $2s$ 以上離れたデータの割合は $\dfrac1{2^2}=\dfrac14$ 以下である。ex-chb-sharp-first はその上限にちょうど達する例になっている。この記事では次の問いに答える。
- 平均から標準偏差の $k$ 倍以上離れたデータの個数は、どこまで多くなりうるか。→ thm-chb-data
- その上限に達するのは、どんなデータか。→ prop-chb-equality
- 確率変数でも同じことが言えるか。→ thm-chb-rv
- 正規分布の「$2\sigma$ の外は約 $5\%$」とは、どう違うか。→ ex-chb-normalなお、「Chebyshev の不等式」という名前は、大小の順にそろえた 2 つの数列の積の和についての不等式(不等式の証明の技法 の定理「Chebyshev の和の不等式」)にも使われる。それはこの記事の不等式とは別のものである。
高校の計算 この記事の言葉 大学の言葉 分散 = 偏差の 2 乗の平均 偏差の 2 乗の和を「遠い」と「近い」に分ける 和の一部分を捨てる評価 平均から標準偏差の何倍離れているか 離れ具合 $k$ 標準化した値 正規分布の $2\sigma$・$3\sigma$ の確率 どんな分布でも使える上界 $\frac1{k^2}$ Chebyshev の不等式
言葉の準備:平均から遠いデータ
データ $x_1,\dots,x_n$ の平均を $\bar x$、標準偏差を $s$ とし、$s>0$ とする。正の実数 $k$ について、
$$
\lvert x_i-\bar x\rvert\ge ks
$$
を満たすデータ $x_i$ を、平均から $ks$ 以上離れたデータ という。その個数を $N_k$ と書く。
$\lvert x_i-\bar x\rvert\ge ks$ は、$x_i$ が区間 $\bar x-ks< x< \bar x+ks$ の外(端を含む)にあるということである。$s>0$ を仮定するのは、$s=0$(すべてのデータが等しい)のときには「標準偏差の何倍」という測り方が意味を失うからである(ex-chb-cx-zero)。
ex-chb-scores のデータ($\bar x=65$、$s=12.93\ldots$)で、$N_k$ を数える。
| $k$ | $ks$ | 平均から $ks$ 以上離れたデータ | $N_k$ |
|---|---|---|---|
| $1$ | $12.93\ldots$ | $30,\ 46,\ 52,\ 80,\ 84,\ 88$ | $6$ |
| $1.5$ | $19.40\ldots$ | $30,\ 88$ | $2$ |
| $2$ | $25.87\ldots$ | $30$ | $1$ |
| $3$ | $38.81\ldots$ | なし | $0$ |
たとえば $k=1.5$ では、区間 $45.59\ldots< x< 84.40\ldots$ の外にあるのは $30$ と $88$ である($46$ は区間の中にある)。
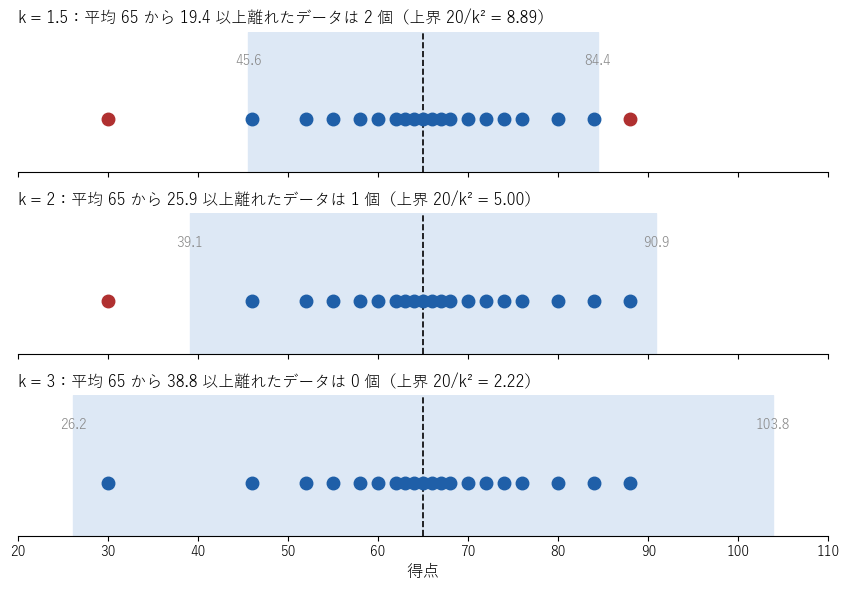 20 人の得点を数直線に並べた図。上から k = 1.5、2、3 で、色を塗った区間は平均 65 から ks 未満の範囲。区間の外(端を含む)にある赤い点が平均から ks 以上離れたデータ
主定理 1:データについての Chebyshev の不等式
データ $x_1,\dots,x_n$ の平均を $\bar x$、標準偏差を $s$ とし、$s>0$ とする。すべての正の実数 $k$ について、平均から $ks$ 以上離れたデータの個数 $N_k$ は
$$
N_k\le\frac{n}{k^2}
$$
を満たす。言いかえると、平均から $ks$ 以上離れたデータの割合 $\dfrac{N_k}n$ は $\dfrac1{k^2}$ 以下である。
方針:分散の定義の式 $ns^2=\sum_{i=1}^n(x_i-\bar x)^2$ の右辺の和を、「平均から $ks$ 以上離れたデータ」についての和と「それ以外のデータ」についての和に分ける。後者は $0$ 以上なので捨て、前者の各項は $k^2s^2$ 以上で押さえる。
段 1(和を 2 つに分ける)。平均から $ks$ 以上離れたデータの番号 $i$ の集まりを $A$、それ以外の番号の集まりを $B$ とする。$A$ の番号は $N_k$ 個ある。番号 $1,\dots,n$ は $A$ と $B$ のどちらか一方だけに入るので
$$
ns^2=\sum_{i=1}^n(x_i-\bar x)^2=\sum_{i\in A}(x_i-\bar x)^2+\sum_{i\in B}(x_i-\bar x)^2
$$
である。
段 2(近いデータの和を捨てる)。$B$ についての和は、2 乗の和なので $0$ 以上である。したがって
$$
ns^2\ge\sum_{i\in A}(x_i-\bar x)^2
$$
である。
段 3(遠いデータの各項を下から押さえる)。$i\in A$ なら $\lvert x_i-\bar x\rvert\ge ks$ で、両辺は $0$ 以上なので、2 乗しても大小は変わらず $(x_i-\bar x)^2\ge k^2s^2$ である。この不等式を $A$ の $N_k$ 個の番号について足すと
$$
\sum_{i\in A}(x_i-\bar x)^2\ge N_k\cdot k^2s^2
$$
である。
段 4(まとめる)。段 2 と段 3 から $ns^2\ge N_kk^2s^2$ である。$s>0$、$k>0$ なので $k^2s^2>0$ で、両辺を $k^2s^2$ で割ると $N_k\le\dfrac{n}{k^2}$ を得る。$\square$
証明の要は、段 1 で和を「遠いデータ」と「近いデータ」に分けたことである。データを合わせたときの平均と分散 では、偏差の 2 乗の和を群ごとに分けて、群内の分散と群間の分散の和に書いた。ここでも同じく和を分けるが、等式にするのではなく、一方を捨て、他方を小さい値に置き換えて不等式にしている。
ex-chb-count の表と、定理の上界 $\dfrac{20}{k^2}$ を比べる。
| $k$ | $N_k$ | 上界 $\frac{20}{k^2}$ | 割合 $\frac{N_k}{20}$ | 上界の割合 $\frac1{k^2}$ |
|---|---|---|---|---|
| $1$ | $6$ | $20$ | $0.30$ | $1$ |
| $1.5$ | $2$ | $8.88\ldots$ | $0.10$ | $0.444\ldots$ |
| $2$ | $1$ | $5$ | $0.05$ | $0.25$ |
| $3$ | $0$ | $2.22\ldots$ | $0$ | $0.111\ldots$ |
どの $k$ でも $N_k\le\dfrac{20}{k^2}$ が成り立っている。このデータでは、実際の個数は上界よりかなり少ない。
定理は「遠いデータの割合」の上界である。裏返すと「近いデータの割合」の下界になる。
thm-chb-data と同じ仮定のもとで、$\lvert x_i-\bar x\rvert< ks$ を満たすデータの個数は $n-\dfrac{n}{k^2}=n\Bigl(1-\dfrac1{k^2}\Bigr)$ 以上である。
$\lvert x_i-\bar x\rvert< ks$ を満たすデータの個数は、全体の個数 $n$ から、平均から $ks$ 以上離れたデータの個数 $N_k$ を引いた $n-N_k$ である。thm-chb-data より $N_k\le\dfrac n{k^2}$ なので、$n-N_k\ge n-\dfrac n{k^2}$ である。$\square$
冒頭の「平均 65 点、標準偏差 13 点」のテストで、平均から 26 点以上離れた人の割合は、$k=2$ として $\dfrac1{2^2}=\dfrac14$ 以下である。受験者が 200 人なら、そのような人は $\dfrac{200}4=50$ 人以下で、$39$ 点より大きく $91$ 点より小さい人は $150$ 人以上いる。分布の形について何も仮定せずに、平均と標準偏差だけから言えることである。
上界に達するデータ
ex-chb-sharp-first では $N_2=2=\dfrac8{2^2}$ で、定理の不等式が等号になっていた。等号になるのがどんなデータかは、証明のどこで不等号を使ったかを見ると分かる。
thm-chb-data と同じ仮定のもとで、$N_k=\dfrac n{k^2}$ が成り立つのは、どのデータ $x_i$ も「平均 $\bar x$ に等しい」か「平均からちょうど $ks$ 離れている($\lvert x_i-\bar x\rvert=ks$)」かのどちらかであるときに限る。
段 1(等号なら条件が成り立つ)。thm-chb-data の証明で不等号を使ったのは段 2 と段 3 の 2 か所である。$N_k=\dfrac n{k^2}$ なら $ns^2=N_kk^2s^2$ なので、段 2 と段 3 の不等式はどちらも等号である。段 2 が等号なので $\sum_{i\in B}(x_i-\bar x)^2=0$ で、$0$ 以上の数の和が $0$ だから、$B$ の各データは $x_i=\bar x$ を満たす。段 3 が等号なので、$A$ の各番号で $(x_i-\bar x)^2\ge k^2s^2$ の等号が成り立つ(1 つでも真に大きければ、和も真に大きくなる)。よって $\lvert x_i-\bar x\rvert=ks$ である。
段 2(条件が成り立てば等号)。どのデータも $\bar x$ に等しいか、$\bar x$ からちょうど $ks$ 離れているとする。$ks>0$ なので、平均から $ks$ 以上離れたデータは、ちょうど $ks$ 離れたデータのことで、その個数が $N_k$ である。分散の定義から
$$
ns^2=\sum_{i=1}^n(x_i-\bar x)^2=N_k\cdot k^2s^2+(n-N_k)\cdot0=N_kk^2s^2
$$
である。両辺を $k^2s^2\ (>0)$ で割って $N_k=\dfrac n{k^2}$ を得る。$\square$
- ex-chb-sharp-first のデータ $-1,1,0,0,0,0,0,0$ は、$k=2$、$ks=1$ で条件を満たす($0$ は平均に等しく、$\pm1$ は平均からちょうど $1$ 離れている)。$N_2=2=\dfrac84$ である。
- 10 個のデータ $-2,\ 2,\ 0,0,0,0,0,0,0,0$ では、平均は $0$、分散は $\dfrac{4+4}{10}=\dfrac45$、標準偏差は $s=\dfrac2{\sqrt5}$ である。$ks=2$ となるのは $k=\sqrt5$ のときで、このとき $N_{\sqrt5}=2=\dfrac{10}{(\sqrt5)^2}$ と等号になる。同じデータでも $k=2$ では $ks=\dfrac4{\sqrt5}=1.78\ldots$ で、$N_2=2<\dfrac{10}4=2.5$ と等号にならない($\pm2$ が平均からちょうど $ks$ の位置にないため)。
ex-chb-equality (1) と同じ作り方で、ほかの $n$ と $k$ でも等号の例が作れる。$k\ge1$ で $\dfrac n{k^2}$ が偶数 $2c$ のとき、$-1$ を $c$ 個、$1$ を $c$ 個、$0$ を $n-2c$ 個並べる($2c=\dfrac n{k^2}\le n$ なので並べられる)。平均は $0$、分散は $\dfrac{2c}n=\dfrac1{k^2}$、標準偏差は $s=\dfrac1k$ で、$ks=1$ である。どのデータも平均に等しいか、平均からちょうど $ks=1$ 離れているので、prop-chb-equality により $N_k=\dfrac n{k^2}$ となる。この意味で、定理の上界 $\dfrac n{k^2}$ は、一般にはこれ以上小さくできない。
$0< k\le1$ では $\dfrac n{k^2}\ge n$ なので、定理は「$N_k\le n$」以上のことを言わない。これは定理の仮定が破れているのではなく、結論が何も情報を含まないだけである。実際、$k=1$ では $N_1\ge1$ がいつも成り立つ。もしすべてのデータで $(x_i-\bar x)^2< s^2$ なら、足して $n$ で割ると $s^2< s^2$ となって矛盾するからである。
$\lvert x_i-\bar x\rvert> ks$ を満たすデータの個数は $N_k$ 以下なので、やはり $\dfrac n{k^2}$ 以下である。ただし ex-chb-equality (1) では、$\lvert x_i\rvert>1$ を満たすデータは $0$ 個になり、上界 $2$ に達しない。「より大きい」で数えた個数を $M$ とすると、いつも $M< \dfrac n{k^2}$ で、上界に達する例は作れない。実際、$M=0$ なら $0< \dfrac n{k^2}$ である。$M\ge1$ なら、thm-chb-data の証明の段 3 で、$M$ 個の各項が $k^2s^2$ より真に大きいので $ns^2> Mk^2s^2$ となり、$k^2s^2$ で割って $M< \dfrac n{k^2}$ である。
主定理 2:確率変数についての Chebyshev の不等式
数学 B では、値に確率が割り当てられた確率変数の平均(期待値)と分散を学ぶ。確率変数 $X$ のとる値が $v_1,\dots,v_m$ で、$P(X=v_j)=p_j$($p_j\ge0$、$p_1+\cdots+p_m=1$)のとき、平均は $\mu=\sum_jv_jp_j$、分散は $\sigma^2=\sum_j(v_j-\mu)^2p_j$、標準偏差は $\sigma=\sqrt{\sigma^2}$ である(確率変数の期待値と分散)。データのときの「$\dfrac1n$ ずつ」が「$p_j$ ずつ」に変わるだけで、同じ不等式が成り立つ。
とる値が有限個の確率変数 $X$ の平均を $\mu$、標準偏差を $\sigma$ とし、$\sigma>0$ とする。すべての正の実数 $k$ について
$$
P\bigl(\lvert X-\mu\rvert\ge k\sigma\bigr)\le\frac1{k^2}
$$
が成り立つ。
方針:thm-chb-data の証明で、和の各項に確率 $p_j$ を掛けた形にする。
段 1(和を 2 つに分ける)。$X$ のとる値を $v_1,\dots,v_m$、$p_j=P(X=v_j)$ とする。$\lvert v_j-\mu\rvert\ge k\sigma$ を満たす番号 $j$ の集まりを $A$、それ以外を $B$ とする。分散の定義から
$$
\sigma^2=\sum_{j=1}^m(v_j-\mu)^2p_j=\sum_{j\in A}(v_j-\mu)^2p_j+\sum_{j\in B}(v_j-\mu)^2p_j
$$
である。
段 2($B$ の和を捨てる)。$(v_j-\mu)^2\ge0$、$p_j\ge0$ なので $B$ の和は $0$ 以上で、$\sigma^2\ge\sum_{j\in A}(v_j-\mu)^2p_j$ である。
段 3($A$ の各項を下から押さえる)。$j\in A$ なら $(v_j-\mu)^2\ge k^2\sigma^2$ で、$p_j\ge0$ を掛けて $(v_j-\mu)^2p_j\ge k^2\sigma^2p_j$ である。$A$ について足すと
$$
\sum_{j\in A}(v_j-\mu)^2p_j\ge k^2\sigma^2\sum_{j\in A}p_j=k^2\sigma^2\,P\bigl(\lvert X-\mu\rvert\ge k\sigma\bigr)
$$
である。最後の等号は、事象 $\lvert X-\mu\rvert\ge k\sigma$ が「$X$ の値が $A$ の番号の値のどれかになる」ことで、それらは互いに排反だからである。
段 4(まとめる)。段 2・段 3 から $\sigma^2\ge k^2\sigma^2P\bigl(\lvert X-\mu\rvert\ge k\sigma\bigr)$ で、$k^2\sigma^2>0$ で割ると主張を得る。$\square$
データ $x_1,\dots,x_n$ から 1 つを等しい確率 $\dfrac1n$ で選んだ値を $X$ とすると、$\mu=\bar x$、$\sigma=s$ で、$P\bigl(\lvert X-\mu\rvert\ge k\sigma\bigr)=\dfrac{N_k}n$ である(同じ値が何個かあれば、その値の確率は個数 $\times\dfrac1n$ になる)。この場合、thm-chb-rv は thm-chb-data そのものである。
公正なさいころの目 $X$ は $1,\dots,6$ を確率 $\dfrac16$ ずつとる。平均は $\mu=\dfrac72$、分散は
$$
\sigma^2=\frac{\bigl(\frac52\bigr)^2+\bigl(\frac32\bigr)^2+\bigl(\frac12\bigr)^2+\bigl(\frac12\bigr)^2+\bigl(\frac32\bigr)^2+\bigl(\frac52\bigr)^2}{6}=\frac{\frac{25+9+1+1+9+25}4}{6}=\frac{70}{24}=\frac{35}{12}
$$
で、$\sigma=1.707\ldots$ である。$k=1.4$ とすると $k\sigma=2.39\ldots$ で、$\lvert X-3.5\rvert\ge2.39\ldots$ となるのは $X=1$ と $X=6$(ずれ $2.5$)だけなので、$P\bigl(\lvert X-\mu\rvert\ge1.4\sigma\bigr)=\dfrac26=\dfrac13$ である。定理の上界は $\dfrac1{1.4^2}=0.510\ldots$ で、確かに $\dfrac13\le0.510\ldots$ である。
公正な硬貨を 100 回投げて表の出る回数を $X$ とする。$X$ は二項分布 $B\bigl(100,\frac12\bigr)$ に従い、平均は $100\cdot\dfrac12=50$、分散は $100\cdot\dfrac12\cdot\dfrac12=25$、標準偏差は $5$ である(確率変数の期待値と分散)。
- $k=2$:$\lvert X-50\rvert\ge10$ の確率は、定理より $\dfrac14$ 以下である。二項分布の確率を足して正確に計算すると $0.0568\ldots$ である。
- $k=3$:$\lvert X-50\rvert\ge15$ の確率は、定理より $\dfrac19=0.111\ldots$ 以下である。正確な値は $0.00351\ldots$ である。
正確な値は計算機で $\sum\binom{100}{j}\big/2^{100}$ を足して求めた。定理の上界は正しいが、正確な値よりずっと大きい。
Chebyshev の不等式は、大数の法則とさいころの平均 で大数の法則を証明する道具として使われている。その記事では、系「Chebyshev の不等式」を、定理「Markov の不等式」から $P\bigl(\lvert X-\mu\rvert\ge\varepsilon\bigr)\le\dfrac{\sigma^2}{\varepsilon^2}$ の形で導いている。$\varepsilon=k\sigma$ とおけば thm-chb-rv の形になる。GS06 も、この不等式を Theorem 8.1 として $\varepsilon$ の形で述べ、$\varepsilon=k\sigma$ とおいた形を Example 8.1 に置いたうえで、大数の法則(Theorem 8.2)の証明に使っている。
正規分布との比べ方
正規分布(高校数学) では、正規分布に従う確率変数が平均から $2\sigma$ 以上離れる確率は約 $0.0455$、$3\sigma$ 以上離れる確率は約 $0.0027$ であることを学ぶ(その記事の系「68–95–99.7 の規則」の $0.9545$、$0.9973$ を $1$ から引いた値)。Chebyshev の不等式の上界と並べてみる。
| $k$ | Chebyshev の上界 $\frac1{k^2}$ | 正規分布で $k\sigma$ 以上離れる確率 | ex-chb-scores の割合 |
|---|---|---|---|
| $1.5$ | $0.444\ldots$ | $0.1336\ldots$ | $0.10$ |
| $2$ | $0.25$ | $0.0455\ldots$ | $0.05$ |
| $2.5$ | $0.16$ | $0.0124\ldots$ | $0.05$ |
| $3$ | $0.111\ldots$ | $0.0027\ldots$ | $0$ |
正規分布の確率は、標準正規分布の分布関数を数値計算して求めた。どの $k$ でも、正規分布の確率は Chebyshev の上界よりずっと小さい。Chebyshev の上界は分布の形を問わずに成り立つ代わりに、個々の分布に対しては粗い(図 2)。逆に、分布が正規分布だと分かっていないのに「$2\sigma$ 以上離れるのは約 $5\%$」と言うことはできない(ex-chb-cx-normal)。
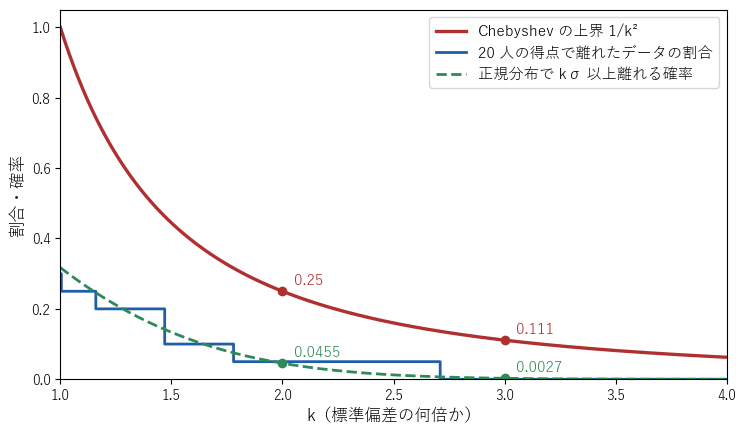 k を横軸にとり、Chebyshev の上界 1/k²(赤)、20 人の得点で平均から ks 以上離れたデータの割合(青の階段)、正規分布で kσ 以上離れる確率(緑の破線)を描いた図。赤の曲線はほかの 2 つより上にある
例と反例
thm-chb-data の仮定や、ばらつきの測り方を変えると何が崩れるかを表にする。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 標準偏差が正($s>0$) | ex-chb-cx-zero(5 個のデータがすべて $7$) | $N_k\le\frac n{k^2}$($k>1$ のとき) |
| ばらつきを標準偏差で測る(平均偏差に替える) | ex-chb-cx-mad | 平均偏差の $k$ 倍以上離れたデータの割合は $\frac1{k^2}$ 以下 |
| 分布が正規分布である(Chebyshev の不等式には不要な条件で、正規分布の確率の方が崩れる) | ex-chb-cx-normal | $2\sigma$ 以上離れるデータの割合は約 $4.55\%$ |
5 個のデータ $7,7,7,7,7$ は、平均 $7$、分散 $0$、標準偏差 $s=0$ である。このとき $ks=0$ で、$\lvert x_i-7\rvert\ge0$ はすべてのデータが満たすので、「平均から $ks$ 以上離れたデータ」の個数は $5$ になる。$k=2$ なら上界 $\dfrac5{4}=1.25$ を超えている。$s=0$ では thm-chb-data の証明の段 4 で $k^2s^2=0$ で割ることができず、結論が成り立たない。
偏差の絶対値の平均 $d=\dfrac1n\sum_{i=1}^n\lvert x_i-\bar x\rvert$ を 平均偏差 という。ばらつきを標準偏差の代わりに平均偏差で測り、「平均から $kd$ 以上離れたデータは $\dfrac n{k^2}$ 個以下」と主張すると、誤りになる。
8 個のデータ $-1,-1,1,1,0,0,0,0$ は、平均 $0$、平均偏差 $d=\dfrac48=\dfrac12$ である。$k=2$ とすると $kd=1$ で、平均から $1$ 以上離れたデータは $\pm1$ の 4 個ある。上界のつもりの $\dfrac8{2^2}=2$ を超えている。同じデータの標準偏差は $s=\sqrt{\frac48}=0.707\ldots$ で、$2s=1.41\ldots$ 以上離れたデータは $0$ 個だから、thm-chb-data とは矛盾しない。
平均偏差で測るときに正しく言えるのは、$\dfrac nk$ 個以下ということである。平均から $kd$ 以上離れたデータの個数を $L$ とすると、thm-chb-data の証明と同じく和を分けて
$$
nd=\sum_{i=1}^n\lvert x_i-\bar x\rvert\ge L\cdot kd
$$
となり、$d>0$ なら $L\le\dfrac nk$ である。上の例では $L=4=\dfrac82$ でちょうど等号になっている。2 乗の和を使う標準偏差だから、上界が $\dfrac1{k^2}$ と速く小さくなる。
「平均から $2\sigma$ 以上離れるのは約 $4.55\%$」は、分布が正規分布のときの値である。ex-chb-sharp-first のデータでは、平均から $2s$ 以上離れたデータの割合は $25\%$ で、$4.55\%$ よりずっと大きい。18 個のデータ $-1,1,0,\ldots,0$($0$ が 16 個)では、分散は $\dfrac2{18}=\dfrac19$、標準偏差は $s=\dfrac13$ で、平均から $3s=1$ 以上離れたデータの割合は $\dfrac2{18}=11.1\ldots\%$ である。正規分布の $0.27\%$ の 40 倍以上になる。分布の形が分からないときに保証されるのは、Chebyshev の不等式の $\dfrac1{k^2}$ だけである。
大学数学で見る:Markov の不等式から導く
thm-chb-data の証明は、次の形の不等式を 1 つ使っているとみることもできる。$0$ 以上の数のデータ $y_1,\dots,y_n$ の平均を $\bar y$ とし、$a>0$ とすると、$y_i\ge a$ を満たすデータは $\dfrac{n\bar y}{a}$ 個以下である。$n\bar y=\sum y_i$ の和で、$a$ 未満の項を捨て、残りの各項を $a$ で押さえればよい。これをデータ $y_i=(x_i-\bar x)^2$(平均は $s^2$)と $a=k^2s^2$ に当てはめると thm-chb-data になる。
確率変数の場合と、教科書・事典での扱いを開く
確率変数で同じ形の不等式 $P(X\ge a)\le\dfrac{E[X]}a$($X\ge0$)を Markov の不等式という。大数の法則とさいころの平均 は、定理「Markov の不等式」を証明し、そこから系「Chebyshev の不等式」を導いている。Wei26 も、Markov の不等式を $(x-\mu)^2$ に当てはめる形で Chebyshev の不等式を導き、$P(\lvert x-\mu\rvert\ge k\sigma)\le\dfrac1{k^2}$ の形を述べている。
この記事では、とる値が有限個の確率変数に限って証明した。確率密度関数をもつ確率変数(連続型)でも、分散が有限なら同じ不等式が成り立つ。和を積分に替えて同じ分け方をすればよい(この記事では証明しない。大学向けの 分散 の記事を参照)。
GS06 は、Theorem 8.1 の不等式が一般にはこれ以上よくできないことを、値 $\pm\varepsilon$ を確率 $\frac12$ ずつとる確率変数で示している。prop-chb-equality と同じ考え方である。
演習
50 人のテストで、平均が 60 点、標準偏差が 10 点だった。85 点以上または 35 点以下の人は、多くても何人か。分布の形は分からないものとする。
解答を開く
85 点以上または 35 点以下は、平均 60 点から 25 点以上離れていることで、$25=2.5\times10$ だから $k=2.5$ である。thm-chb-data より、そのような人は $\dfrac{50}{2.5^2}=\dfrac{50}{6.25}=8$ 人以下である。等号の例も作れる。8 人が 85 点と 35 点に 4 人ずつ、残り 42 人が 60 点なら、平均 60 点、分散 $\dfrac{8\cdot625}{50}=100$ で標準偏差 10 点になり、ちょうど 8 人である。
さいころを $n$ 回投げた目の平均を $\bar X$ とする。$\bar X$ の平均は $\dfrac72$、分散は $\dfrac{35}{12n}$ である(標本平均の分散)。$P\bigl(\lvert\bar X-3.5\rvert\ge0.5\bigr)\le0.1$ が thm-chb-rv から保証されるには、$n$ をいくつ以上にすればよいか。
解答を開く
$\bar X$ の標準偏差を $\sigma_n=\sqrt{\dfrac{35}{12n}}$ とし、$k\sigma_n=0.5$ となる $k=\dfrac{0.5}{\sigma_n}$ をとる。thm-chb-rv より $P\bigl(\lvert\bar X-3.5\rvert\ge0.5\bigr)\le\dfrac1{k^2}=\dfrac{\sigma_n^2}{0.25}=\dfrac{35}{12n}\cdot4=\dfrac{35}{3n}$ である($\bar X$ のとる値は有限個)。$\dfrac{35}{3n}\le0.1$ を解くと $n\ge\dfrac{350}3=116.6\ldots$ なので、$n\ge117$ ならよい。
さらに先へ
- 標本平均の分散が $\dfrac{\sigma^2}n$ に縮むことと Chebyshev の不等式を組み合わせると、標本平均が母平均の近くにある確率が $1$ に近づくこと(大数の法則)が分かる。証明は 大数の法則とさいころの平均 にある。
- 平均から遠い値を見つける別の基準として、四分位範囲を使う外れ値の基準がある(四分位数と箱ひげ図 の定義「箱ひげ図と外れ値の基準」)。Chebyshev の不等式が平均と標準偏差で割合を押さえるのに対し、そちらは四分位数を使う。
- 分布が正規分布に近いことが分かれば、中心極限定理(高校数学) と 正規分布(高校数学) の表を使って、Chebyshev の不等式よりずっと小さい確率の見積もりができる。
- 大学向けの Chebyshevの不等式 では、一般の確率変数について同じ不等式を扱う。
関連項目
- 前提: 平均値と二乗誤差, 確率変数の期待値と分散
- 前に読む: データを合わせたときの平均と分散, 四分位数と箱ひげ図, 確率変数の期待値と分散
- 次に読む: 順位相関係数(高校数学), 大数の法則とさいころの平均
- 関連(高校数学): 正規分布(高校数学), 中心極限定理(高校数学), 標本平均の分散
- 発展: Chebyshevの不等式, 分散
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

