Kalmanフィルタ
概要
Kalmanフィルタ(Kalman filter)とは、初期状態と雑音が独立な Gauss 分布に従う線形の状態方程式と観測式のモデルで、観測の列から見えない状態の条件付き平均と共分散を、予測と更新の交互の計算で逐次に求める算法である。このモデルでは推定値は観測のすべての関数の中で 2 乗誤差を最小にし、初期状態と雑音が無相関なだけならアフィン推定の中で最小にする。誤差共分散は Riccati 方程式を満たし、係数が時刻によらず観測雑音の共分散行列が正定値のとき、可検出性と可安定性のもとで初期値によらない極限に収束する。
Kalman フィルタ(Kalman filter)は、線形の状態方程式と線形の観測式に Gauss 雑音が加わるモデルで、観測の列から直接は見えない状態を逐次に推定する算法である。初期状態と雑音がすべて独立で Gauss 分布に従う線形モデルでは、時刻 $k$ までの観測のもとでの状態の条件付き分布は正規分布で、その平均と共分散行列は 1 ステップ前の値から有限回の行列計算で求まる。
2 つの段を交互に行う。予測 ではモデルで状態を 1 ステップ進める。更新 では新しい観測と予測の差(イノベーション)に利得を掛けて推定を直す。全ての過去の観測を保存しなくてよいことが、この算法の要点である。
この記事では、更新式を条件付き期待値の計算として証明し、2 乗誤差の最適性、Gauss 性を外したときに残る性質(アフィン推定の中での最適性)、誤差共分散の Riccati 方程式とその極限を扱う。
モデル
時刻 $k=0,1,2,\dots$ について、状態 $x_k\in\mathbb{R}^n$、観測 $y_k\in\mathbb{R}^m$ が
$$
x_{k+1}=A_kx_k+B_ku_k+w_k,\qquad y_k=C_kx_k+v_k
$$
に従うとする。$A_k,B_k,C_k$ は既知の行列、$u_k$ は既知の入力(確定的なベクトル)である。
$Y_k=(y_0,\dots,y_k)$ とし、$Y_{-1}$ は空の列とする。$j=k$ または $j=k-1$ について
$$
\hat x_{k|j}=E[x_k\mid Y_j],\qquad P_{k|j}=E\bigl[(x_k-\hat x_{k|j})(x_k-\hat x_{k|j})^{\mathsf T}\bigr]
$$
とおく(条件付き期待値)。問題は、$\hat x_{k|k}$ と $P_{k|k}$ を逐次に求めることである。
次の補題が基本の道具である。多変量正規分布 の定理「条件付き分布」と同じ内容だが、後の証明では独立な残差の形で使うので、その形で述べる。
$(X,E)$ は平均 $0$ の同時正規分布に従い、$S=\operatorname{Cov}(E)$ は正定値、$\Sigma=\operatorname{Cov}(X,E)=E[XE^{\mathsf T}]$ とする。$K=\Sigma S^{-1}$ とおくと、
$$
X=KE+Z
$$
で、$Z$ は $E$ と独立で $Z\sim N(0,\operatorname{Cov}(X)-KSK^{\mathsf T})$ である。
$Z=X-KE$ は $(X,E)$ の 1 次変換なので、$(Z,E)$ は同時正規分布に従う。$E[ZE^{\mathsf T}]=\Sigma-KS=0$ なので、$Z$ と $E$ は無相関であり、多変量正規分布 の定理「無相関なら独立」により独立である。$\operatorname{Cov}(X)=\operatorname{Cov}(Z)+KSK^{\mathsf T}$ から共分散を得る。$\square$
更新式
線形 Gauss モデルで、$\hat x_{0|-1}=m_0$、$P_{0|-1}=P_0$ から始めて、$k=0,1,\dots$ について
$$
S_k=C_kP_{k|k-1}C_k^{\mathsf T}+R_k,\qquad K_k=P_{k|k-1}C_k^{\mathsf T}S_k^{-1}
$$
とおく。すると次が成り立つ。
更新:
$$
\hat x_{k|k}=\hat x_{k|k-1}+K_k\bigl(y_k-C_k\hat x_{k|k-1}\bigr),\qquad P_{k|k}=P_{k|k-1}-K_kS_kK_k^{\mathsf T}
$$
予測:
$$
\hat x_{k+1|k}=A_k\hat x_{k|k}+B_ku_k,\qquad P_{k+1|k}=A_kP_{k|k}A_k^{\mathsf T}+Q_k
$$
さらに、$x_k$ の $Y_{k-1}$ のもとでの条件付き分布は $N(\hat x_{k|k-1},P_{k|k-1})$、$Y_k$ のもとでの条件付き分布は $N(\hat x_{k|k},P_{k|k})$ である。共分散行列 $P_{k|j}$ と利得 $K_k$ は観測の値によらない確定的な行列である。
$K_k$ を Kalman 利得 といい、$e_k=y_k-C_k\hat x_{k|k-1}$ を イノベーション という。
$k\ge0$ についての次の主張 $(\mathrm{I}_k)$ を帰納法で示す。
$(\mathrm{I}_k)$:$\hat x_{k|k-1}$ は上の漸化式で定まる $Y_{k-1}$ のアフィン関数で、$\tilde x_k=x_k-\hat x_{k|k-1}$ は $Y_{k-1}$ と独立で $\tilde x_k\sim N(0,P_{k|k-1})$ である。
$k=0$ では $\tilde x_0=x_0-m_0\sim N(0,P_0)$ で、$Y_{-1}$ は空なので成り立つ。
更新の段。 $(\mathrm{I}_k)$ を仮定する。$x_k$ と $Y_{k-1}$ は $x_0,w_0,\dots,w_{k-1},v_0,\dots,v_{k-1}$ の関数なので、$v_k$ はこれらと独立である。
$$
e_k=y_k-C_k\hat x_{k|k-1}=C_k\tilde x_k+v_k
$$
であり、$(\tilde x_k,v_k)$ は $Y_{k-1}$ と独立である。ゆえに $(\tilde x_k,e_k)$ は平均 $0$ の同時正規分布に従い $Y_{k-1}$ と独立で、
$$
\operatorname{Cov}(e_k)=C_kP_{k|k-1}C_k^{\mathsf T}+R_k=S_k,\qquad E[\tilde x_ke_k^{\mathsf T}]=P_{k|k-1}C_k^{\mathsf T}
$$
である。$R_k$ が正定値なので $S_k$ も正定値である。lem-kf-split により $\tilde x_k=K_ke_k+Z_k$ で、$Z_k\sim N(0,P_{k|k-1}-K_kS_kK_k^{\mathsf T})$ は $e_k$ と独立である。$Z_k$ は $(\tilde x_k,e_k)$ の関数なので $Y_{k-1}$ とも独立であり、$(e_k,Y_{k-1})$ の組と独立である。
$\hat x_{k|k-1}$ は $Y_{k-1}$ のアフィン関数なので、$(e_k,Y_{k-1})$ と $Y_k$ は互いに他のアフィン関数である。よって $Z_k$ は $Y_k$ と独立で、
$$
x_k=\underbrace{\hat x_{k|k-1}+K_ke_k}_{Y_k\text{ の関数}}+Z_k
$$
である。これは条件付き分布が $N(\hat x_{k|k-1}+K_ke_k,\,\operatorname{Cov}Z_k)$ であることを示し、更新の式を得る。
予測の段。 $w_k$ は $(x_k,Y_k)$ と独立なので、$(Z_k,w_k)$ は $Y_k$ と独立で、$Z_k$ と $w_k$ も独立である。
$$
x_{k+1}=\bigl(A_k\hat x_{k|k}+B_ku_k\bigr)+\bigl(A_kZ_k+w_k\bigr)
$$
で、第 1 項は $Y_k$ のアフィン関数、第 2 項は $Y_k$ と独立で $N(0,A_kP_{k|k}A_k^{\mathsf T}+Q_k)$ に従う。これは $(\mathrm{I}_{k+1})$ である。$\square$
証明から、次も分かる。
$e_0,e_1,\dots$ は独立で $e_k\sim N(0,S_k)$ である。特に、観測の同時密度は
$$
p(y_0,\dots,y_N)=\prod_{k=0}^N\frac1{\sqrt{\det(2\pi S_k)}}\exp\Bigl(-\frac12e_k^{\mathsf T}S_k^{-1}e_k\Bigr)
$$
である。
実際、$e_k$ は $Y_{k-1}$ と独立で、$e_0,\dots,e_{k-1}$ は $Y_{k-1}$ の関数である。密度の式は、$(y_0,\dots,y_N)\mapsto(e_0,\dots,e_N)$ が行列式 $1$ のアフィン写像であることによる。モデルの未知の定数の 最尤推定 では、この式で尤度を計算する。観測の冗長な部分を取り除いた白色の列が $e_k$ である(AM79 §5.3、Theorem 3.1)。
$P_{k|k}$ は
$$
P_{k|k}=(I-K_kC_k)P_{k|k-1}(I-K_kC_k)^{\mathsf T}+K_kR_kK_k^{\mathsf T}
$$
とも書ける($K_kS_kK_k^{\mathsf T}=P_{k|k-1}C_k^{\mathsf T}K_k^{\mathsf T}$ を使って展開すればよい)。右辺は半正定値の和の形なので、丸め誤差で対称性・半正定値性が失われにくい。また更新と予測を 1 本にまとめると
$$
\hat x_{k+1|k}=A_k\hat x_{k|k-1}+B_ku_k+A_kK_ke_k
$$
である(AM79 式 (1.6)・(1.8)、pp. 38–39 はこの形である)。
最適性
線形 Gauss モデルで、$\psi$ を $E\lvert\psi(Y_k)\rvert^2< \infty$ を満たす可測関数とする。このとき
$$
E\bigl[(x_k-\psi(Y_k))(x_k-\psi(Y_k))^{\mathsf T}\bigr]=P_{k|k}+E\bigl[(\hat x_{k|k}-\psi(Y_k))(\hat x_{k|k}-\psi(Y_k))^{\mathsf T}\bigr]
$$
である。特に $\hat x_{k|k}$ は、観測のすべての関数の中で誤差の共分散行列を半正定値の順序で最小にする。
$x_k-\psi=(x_k-\hat x_{k|k})+(\hat x_{k|k}-\psi)$ と分ける。prf-kf-main の $Z_k=x_k-\hat x_{k|k}$ は $Y_k$ と独立で平均 $0$ である。第 2 項は $Y_k$ の 2 乗可積分な関数なので、交差項の期待値は $0$ である。$\square$
Gauss 性を外しても、平均と共分散だけで決まる最適性が残る。
線形 Gauss モデルの仮定 (G) を次に弱める:$x_0,w_k,v_k$ は 2 乗可積分で、どの 2 つも無相関、平均と共分散行列は (G) と同じ、$R_k$ は正定値。このとき thm-kf-main の漸化式で作った $\hat x_{k|k}$ は、$y_0,\dots,y_k$ のアフィン関数 $\psi$ の中で $E[(x_k-\psi)(x_k-\psi)^{\mathsf T}]$ を最小にし、最小値は $P_{k|k}$ である。
$\psi$ がアフィンなら、$E[(x_k-\psi)(x_k-\psi)^{\mathsf T}]$ は $(x_k,Y_k)$ の平均と共分散だけで決まる。$(x_k,Y_k)$ は $x_0,w_j,v_j$ のアフィン関数なので、その平均と共分散は仮定の値だけで決まり、同じ平均・共分散をもつ Gauss の場合と一致する。$\hat x_{k|k}$ も同じ漸化式で定まる同じアフィン関数である。Gauss の場合は thm-kf-opt により最適なので、一般の場合も最適である。$\square$
幾何学的には、$\hat x_{k|k}$ は $L^2$ の中で $x_k$ を $\{1,y_0,\dots,y_k\}$ の張る部分空間へ 直交射影 したものであり、$e_k$ はこの部分空間の直交基底を与える Gram–Schmidt の手続きである。Kalman の論文はこの射影の見方で問題を解いた(Kal60 Theorem 2、p. 38。Gauss 過程か、線形の推定に制限した場合に最適な推定が射影になると述べる)。
線形 Gauss モデルの同時密度の対数は、状態の列 $x_0,\dots,x_N$ について
$$
J=(x_0-m_0)^{\mathsf T}P_0^{-1}(x_0-m_0)+\sum_k(x_{k+1}-A_kx_k-B_ku_k)^{\mathsf T}Q_k^{-1}(\cdots)+\sum_k(y_k-C_kx_k)^{\mathsf T}R_k^{-1}(\cdots)
$$
の $-\frac12$ 倍と定数の和である($P_0,Q_k$ が正定値のとき)。したがって Kalman フィルタは、この重みつき 最小二乗法 の問題の最後の状態の解を、データを保存せずに再帰的に求める方法とも読める。
公式の表
$\mathcal{R}$ は節「Riccati 方程式」の写像である。
| 量 | 式 | 使える条件 | 根拠 |
|---|---|---|---|
| 予測の平均 | $\hat x_{k+1\mid k}=A_k\hat x_{k\mid k}+B_ku_k$ | (G) | thm-kf-main |
| 予測の共分散 | $P_{k+1\mid k}=A_kP_{k\mid k}A_k^{\mathsf T}+Q_k$ | (G) | thm-kf-main |
| イノベーションの共分散 | $S_k=C_kP_{k\mid k-1}C_k^{\mathsf T}+R_k$ | (G)。$R_k$ が正定値なので $S_k$ は正定値 | thm-kf-main、cor-kf-innovation |
| 利得 | $K_k=P_{k\mid k-1}C_k^{\mathsf T}S_k^{-1}$ | (G) | thm-kf-main |
| 更新の平均 | $\hat x_{k\mid k}=\hat x_{k\mid k-1}+K_k(y_k-C_k\hat x_{k\mid k-1})$ | (G) | thm-kf-main |
| 更新の共分散 | $P_{k\mid k}=P_{k\mid k-1}-K_kS_kK_k^{\mathsf T}$ | (G) | thm-kf-main |
| 更新の共分散(和の形、Joseph 形) | $P_{k\mid k}=(I-K_kC_k)P_{k\mid k-1}(I-K_kC_k)^{\mathsf T}+K_kR_kK_k^{\mathsf T}$ | $K_k$ が上の利得のとき | rem-kf-forms |
| 2 段を 1 本にした式 | $\hat x_{k+1\mid k}=A_k\hat x_{k\mid k-1}+B_ku_k+A_kK_ke_k$ | (G) | rem-kf-forms |
| Riccati 方程式 | $P_{k+1\mid k}=A_kP_{k\mid k-1}A_k^{\mathsf T}+Q_k-A_kP_{k\mid k-1}C_k^{\mathsf T}S_k^{-1}C_kP_{k\mid k-1}A_k^{\mathsf T}$ | (G) | 上の式をまとめる |
| 定常の式 | $\bar P=\mathcal{R}(\bar P)$、$\bar L=A\bar PC^{\mathsf T}(C\bar PC^{\mathsf T}+R)^{-1}$ | 係数が定数、$R$ が正定値、$(A,C)$ が可検出、$(A,G)$ が可安定 | thm-kf-steady(証明しない。AM79 §4.4、p. 77) |
| アフィン推定として読むとき | 上の更新と予測の式 | (G) を 2 乗可積分・無相関に弱めてよい | thm-kf-blue |
計算の手順
- モデルを確かめる。 $A_k,C_k,Q_k,R_k,m_0,P_0$ を定め、$Q_k,P_0$ が対称で半正定値、$R_k$ が対称で正定値であることを確かめる。
- 初期化する。 $\hat x_{0\mid-1}=m_0$、$P_{0\mid-1}=P_0$、$k=0$ とする。最初の段は予測ではなく更新である。
- 利得を求める。 $S_k$ を作り、$K_kS_k=P_{k\mid k-1}C_k^{\mathsf T}$ を解く。$S_k$ の逆行列を作らず、Cholesky 分解で解くのがよい。
- 更新する。 $y_k$ から $e_k$ を作り、$\hat x_{k\mid k}$ と $P_{k\mid k}$ を求める。数値の安定には和の形を使い、$P_{k\mid k}$ を $\frac12(P_{k\mid k}+P_{k\mid k}^{\mathsf T})$ に置き換えて対称に保つ。
- 予測する。 $\hat x_{k+1\mid k}$ と $P_{k+1\mid k}$ を求める。
- 繰り返す。 次の観測があれば $k$ を $1$ 増やして 3 に戻り、なければ止める。thm-kf-steady の条件のもとでは、隣り合う $P_{k\mid k-1}$ の成分の差が許容誤差より小さくなったところで利得を固定してよい。
3 の Cholesky 分解は、厳密な計算では止まらない。$S_k\ge R_k$ なので $S_k$ の最小固有値は $R_k$ の最小固有値以上で、$S_k$ は正定値だからである。有限桁の計算で止まるのは、次のどちらかである。$R_k$ の最小固有値が $C_kP_{k\mid k-1}C_k^{\mathsf T}$ の大きさに比べて小さすぎて桁が落ちる場合か、丸め誤差で $P_{k\mid k-1}$ の半正定値性が失われた場合である。前者では観測の雑音のモデルと変数の尺度を見直し、後者では 4 の和の形と対称化を使う。
例題
$\theta\sim N(m,p)$ を未知の定数とし、$y_k=\theta+v_k$、$v_k\sim N(0,r)$ を観測する。$x_k=\theta$、$A=C=1$、$Q=0$、$R=r$ の場合である。$P_{k+1|k}=P_{k|k}=:p_k$ で、更新の式は $p_k=p_{k-1}-p_{k-1}^2/(p_{k-1}+r)$、すなわち
$$
\frac1{p_k}=\frac1{p_{k-1}}+\frac1r
$$
となる。よって $p_k=\bigl(\frac1p+\frac{k+1}r\bigr)^{-1}$ で、利得は $K_k=p_k/r$ である。推定値は事前の平均 $m$ と標本の和を精度で重みづけた平均
$$
\hat x_{k|k}=p_k\Bigl(\frac mp+\frac1r\sum_{j=0}^ky_j\Bigr)
$$
であり、$p\to\infty$ で標本平均になる。これは正規分布の共役事前分布による Bayesの定理 の計算と同じである。分散が既知の正規分布は 指数型分布族 の例で、この計算は同記事の命題「共役事前分布」の特別な場合である。
答え:$m=0$、$p=2$、$r=3$、$y_0=1$、$y_1=2$ なら $p_1=\frac67$、$\hat x_{1|1}=\frac67\approx0.8571$ である。
$x_{k+1}=x_k+w_k$、$y_k=x_k+v_k$、$w_k\sim N(0,q)$、$v_k\sim N(0,r)$($q,r>0$)とする。$p_k=P_{k|k-1}$ の漸化式は
$$
p_{k+1}=p_k+q-\frac{p_k^2}{p_k+r}
$$
である。不動点の方程式 $p^2-qp-qr=0$ の正の解は $p_\infty=\frac12\bigl(q+\sqrt{q^2+4qr}\bigr)$ で、節「Riccati 方程式」の結果により $p_k\to p_\infty$ である。利得の極限 $K=p_\infty/(p_\infty+r)$ を使うと、定常なフィルタは
$$
\hat x_{k|k}=(1-K)\hat x_{k-1|k-1}+Ky_k
$$
で、指数平滑 にほかならない。
答え:$q=r=1$ なら $p_\infty=(1+\sqrt5)/2\approx1.6180$、$K=(\sqrt5-1)/2\approx0.6180$ である。
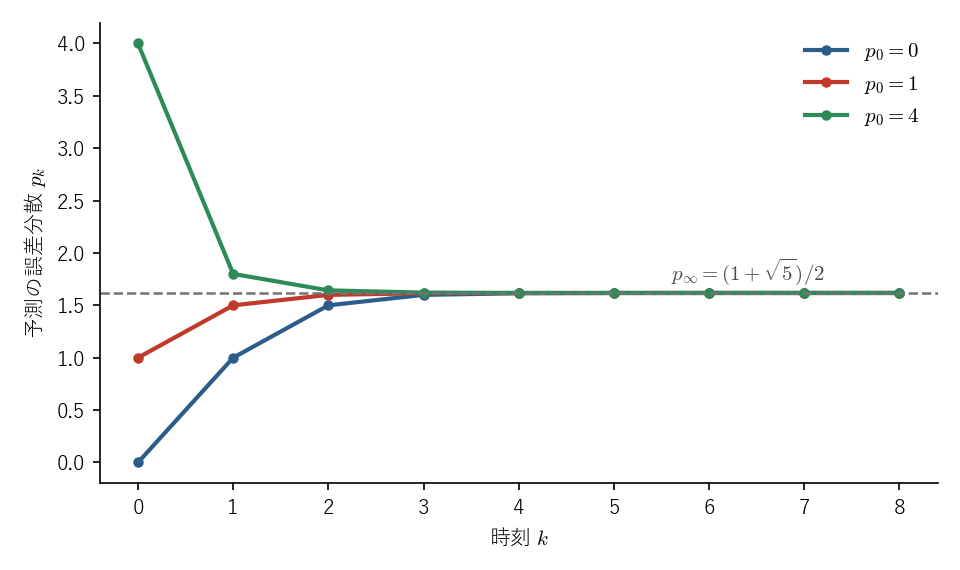 図: q=r=1 のランダムウォークのモデルで、予測の誤差分散 p_k を初期値 0、1、4 から反復した様子。横軸は時刻 k、縦軸は p_k。初期値 0 と 1 の列は下から増え、初期値 4 の列は上から減り、3 本とも k=8 までに点線の p_∞≈1.618 に重なる。
ex-kf-walk のモデルで $q=r=1$、$m_0=0$、$P_{0|-1}=1$ とし、観測 $y_0=1$、$y_1=2$、$y_2=1.5$ を順に処理する。
使う公式:節「公式の表」の利得、更新、予測の式で $A=C=1$ とおいたもの。
答え:
| $k$ | $y_k$ | $\hat x_{k\mid k-1}$ | $P_{k\mid k-1}$ | $S_k$ | $K_k$ | $e_k$ | $\hat x_{k\mid k}$ | $P_{k\mid k}$ |
|---|---|---|---|---|---|---|---|---|
| $0$ | $1$ | $0$ | $1$ | $2$ | $\frac12$ | $1$ | $0.5$ | $\frac12$ |
| $1$ | $2$ | $0.5$ | $\frac32$ | $\frac52$ | $\frac35$ | $1.5$ | $1.4$ | $\frac35$ |
| $2$ | $1.5$ | $1.4$ | $\frac85$ | $\frac{13}5$ | $\frac8{13}$ | $0.1$ | $\frac{19}{13}\approx1.4615$ | $\frac8{13}\approx0.6154$ |
途中の計算を開く
$k=1$ の段を書く。予測は $\hat x_{1|0}=\hat x_{0|0}=0.5$、$P_{1|0}=P_{0|0}+q=\frac32$ である。$S_1=\frac32+1=\frac52$、$K_1=P_{1|0}/S_1=\frac35$ で、$e_1=2-0.5=1.5$ である。更新は $\hat x_{1|1}=0.5+\frac35\cdot1.5=1.4$、$P_{1|1}=\frac32-\frac35\cdot\frac52\cdot\frac35=\frac35$ である。
次の予測の分散は $P_{3|2}=\frac{21}{13}\approx1.6154$ で、$1,\frac32,\frac85,\frac{21}{13}$ は $p_\infty\approx1.6180$ に近づく。分散と利得は観測の値によらず、$e_k$ だけが観測で変わる。
位置と速度を状態にとる。刻み $1$ で $x=(s,\nu)^{\mathsf T}$、
$$
A=\begin{pmatrix}1&1\\0&1\end{pmatrix},\quad Q=\begin{pmatrix}0&0\\0&q\end{pmatrix},\quad C=\begin{pmatrix}1&0\end{pmatrix},\quad R=r
$$
とする。位置だけを観測し、速度は直接には測らない。$P_{0|-1}=\operatorname{diag}(a,b)$ のとき、$S_0=a+r$、$K_0=(a/(a+r),0)^{\mathsf T}$ で、第 1 回の更新は位置だけを直す。予測で $A$ を掛けると
$$
P_{1|0}=\begin{pmatrix}\dfrac{ar}{a+r}+b&b\\b&b+q\end{pmatrix}
$$
となり、位置と速度の誤差に相関が生じる。このため第 2 回の更新の利得は第 2 成分が $b/S_1$ となって $0$ でなくなり、位置の観測から速度が推定される。可観測性の働きが共分散の非対角成分として現れている。
答え:$a=b=q=r=1$ なら $P_{1|0}$ の成分は $\frac32,1,1,2$ で、$S_1=\frac52$、$K_1=(0.6,\,0.4)^{\mathsf T}$ である。
Riccati 方程式
更新と予測の共分散の式をまとめると、$P_k=P_{k|k-1}$ は
$$
P_{k+1}=A_kP_kA_k^{\mathsf T}+Q_k-A_kP_kC_k^{\mathsf T}\bigl(C_kP_kC_k^{\mathsf T}+R_k\bigr)^{-1}C_kP_kA_k^{\mathsf T}
$$
を満たす。これは離散時間の Riccati 方程式 である(AM79 式 (1.9)、p. 39。微分方程式の場合は Riccati方程式)。データを見る前に計算でき、推定の精度を事前に知ることができる。
以下、$A,C,Q,R$ は時刻によらないとし、右辺を $\mathcal{R}(P)$ と書く。
$P$ が半正定値のとき、$S=CPC^{\mathsf T}+R$、$L^\star=APC^{\mathsf T}S^{-1}$ とおくと、任意の行列 $L$ について
$$
\Phi(P,L):=(A-LC)P(A-LC)^{\mathsf T}+Q+LRL^{\mathsf T}=\mathcal{R}(P)+(L-L^\star)S(L-L^\star)^{\mathsf T}
$$
である。特に $\mathcal{R}(P)=\min_L\Phi(P,L)$(半正定値の順序)で、$\mathcal{R}$ は単調である:$P\le P'$ なら $\mathcal{R}(P)\le\mathcal{R}(P')$。
展開すると $(A-LC)P(A-LC)^{\mathsf T}+LRL^{\mathsf T}=APA^{\mathsf T}-LS{L^\star}^{\mathsf T}-L^\star SL^{\mathsf T}+LSL^{\mathsf T}$ である。$L^\star S{L^\star}^{\mathsf T}=APC^{\mathsf T}S^{-1}CPA^{\mathsf T}$ を足して引くと等式を得る。単調性は、$L'$ を $P'$ に対する最適な $L^\star$ として $\mathcal{R}(P)\le\Phi(P,L')\le\Phi(P',L')=\mathcal{R}(P')$ による。中央の不等号は $\Phi(P,L)$ が $P$ について単調であることによる。$\square$
この式の意味は、利得 $L$ の任意の観測器 $\hat x_{k+1}=A\hat x_k+Bu_k+L(y_k-C\hat x_k)$ の誤差共分散の漸化式が $\Phi$ で、Kalman 利得はそれを毎回最小にする、ということである。
行列 $F$ の固有値がすべて単位円の内部にあるとき $F$ を 安定 という。$(A,C)$ が 可検出 であるとは、$A-LC$ が安定となる $L$ が存在することをいう。$Q=GG^{\mathsf T}$ として、$(A^{\mathsf T},G^{\mathsf T})$ が可検出であることを、$(A,G)$ が 可安定 であるという。
$(A,C)$ が可検出で $Q$ は半正定値、$R$ は正定値とする。$P_0=0$、$P_{k+1}=\mathcal{R}(P_k)$ とおくと、$P_k$ は半正定値の順序で単調に増加し、半正定値行列 $\bar P$ に収束して、$\bar P=\mathcal{R}(\bar P)$ を満たす。
$P_1=\mathcal{R}(0)=Q\ge0=P_0$ である。lem-kf-min の単調性から帰納法で $P_{k+1}\ge P_k$ である。
有界性を示す。$F=A-LC$ が安定となる $L$ をとり、$W=Q+LRL^{\mathsf T}$ とおく。lem-kf-min から $\mathcal{R}(P)\le FPF^{\mathsf T}+W$ であり、右辺は $P$ について単調なので、帰納法で
$$
P_k\le\sum_{j=0}^{k-1}F^jW(F^{\mathsf T})^j\le\sum_{j=0}^\infty F^jW(F^{\mathsf T})^j=:P^+
$$
である。級数は $F$ の安定性により収束する。
任意のベクトル $z$ について $z^{\mathsf T}P_kz$ は単調増加で有界なので収束し、分極により $P_k$ の各成分も収束する。$S=CPC^{\mathsf T}+R$ は $P\ge0$ で正定値なので $\mathcal{R}$ は連続である。極限で $\bar P=\mathcal{R}(\bar P)$ を得る。$\square$
初期値によらない収束と安定性には、もう 1 つの条件が要る。次は証明しない。
$R$ が正定値で、$(A,C)$ が可検出、$(A,G)$ が可安定($Q=GG^{\mathsf T}$)とする。このとき、任意の半正定値の $P_0$ について $P_k$ は同じ極限 $\bar P$ に収束し、$\bar L=A\bar PC^{\mathsf T}(C\bar PC^{\mathsf T}+R)^{-1}$ に対し $A-\bar LC$ は安定である(AM79 §4.4、p. 77)。
したがって、十分に時間がたつと、利得を定数 $\bar L$ に固定した時不変のフィルタでよい。$\bar P$ は代数 Riccati 方程式 $P=\mathcal{R}(P)$ の解である。
連続時間と双対性
連続時間のモデル $dx=Ax\,dt+dw$、$dy=Cx\,dt+dv$ では、Kalman–Bucy フィルタが同様の役割を果たす。観測雑音の強度を $R$、状態雑音の強度を $Q$ とすると、利得は $L=PC^{\mathsf T}R^{-1}$、誤差共分散は
$$
\dot P=AP+PA^{\mathsf T}-PC^{\mathsf T}R^{-1}CP+Q
$$
を満たす(KB61、AMF20 Theorem 8.5、p. 8-20。この記事では証明せず、Kalman–Bucyフィルタ の定理「Kalman–Bucy フィルタ」で証明する)。
この方程式は、線形 2 次の最適制御の Riccati 方程式の $A,B$ を $A^{\mathsf T},C^{\mathsf T}$ に替え、時間の向きを逆にしたものである。推定と制御が互いに双対であることは Kalman の 1960 年の論文の結果の 1 つである(Kal60 Theorem 4、p. 42)。制御の側は 動的計画法と最適制御、制御理論 にある。状態方程式に雑音が入る LQ の問題でも同じ形の Riccati 方程式が現れる(確率最適制御 の定理「LQ 問題と Riccati 方程式」)。
使える条件と反例
更新の式が条件付き分布を与えるのは (G) のもとであり、$x_0$ と雑音の独立性と Gauss 性をともに使う。thm-kf-blue の形では無相関と 2 次のモーメントだけでよいが、最適性はアフィン関数の中に限られる。極限の thm-kf-steady は、さらに係数が定数で、$R$ の正定値性、可検出性、可安定性を要する。
次の表の各行は仮定を 1 つだけ外す。
| 外す仮定 | 例 | 起こること |
|---|---|---|
| Gauss 性 | $x_0=\pm1$(確率 $\frac12$ ずつ)、$y_0=x_0+v_0$、$v_0\sim N(0,1)$ | 更新式は $y_0/2$(2 乗誤差 $0.5$)。真の条件付き期待値は $\tanh y_0$(2 乗誤差 約 $0.450$)。thm-kf-opt は成り立たず、thm-kf-blue だけが残る |
| 状態方程式の線形性 | $x_1=x_0^2$、$y_0=x_0+v_0$、$x_0,v_0\sim N(0,1)$ 独立 | $\operatorname{Cov}(x_1,y_0)=0$ なのでアフィン推定は定数 $1$(2 乗誤差 $2$)。$E[x_1\mid y_0]=y_0^2/4+\frac12$ の 2 乗誤差は $\frac32$ |
| $w_k$ と $v_k$ の独立性 | $x_{k+1}=x_k+w_k$、$y_k=x_k+v_k$、$w_k=v_k\sim N(0,1)$ | $x_{k+1}=y_k$ で誤差は $0$。独立と誤認した漸化式の $P_{k+1\mid k}$ は $(1+\sqrt5)/2$ に収束する |
| $R_k$ の正定値性 | $C=0$、$R=0$($y_k\equiv0$) | $S_k=0$ で利得が定まらない(一般逆行列で書き直せば $K=0$) |
| 可検出性 | $A=2$、$C=0$、$Q=q>0$、$R=1$ | $P_{k+1}=4P_k+q\to\infty$。極限はない |
| 可安定性 | $A=2$、$C=1$、$Q=0$、$R=1$ | 不動点は $p=0,3$ の 2 つ。$P_0=0$ なら $P_k=0$、$P_0>0$ なら $P_k\to3$ で、極限が初期値による。$p=0$ では $A-\bar LC=2$ は安定でない |
非線形のモデルには、線形化して同じ式を使う方法など様々な近似があるが、thm-kf-opt の最適性は保証されない。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| $Q$ と $R$ を取り違える | $Q$ は状態の雑音、$R$ は観測の雑音の共分散である | 利得は 2 つの比で決まる。ex-kf-walk で $q=1,r=4$ なら $K\approx0.390$ だが、入れ替えると $K\approx0.828$ になる |
| 利得を 1 つ前の $P_{k-1\mid k-1}$ で作る(予測の段を飛ばす) | 利得は更新前の $P_{k\mid k-1}$ で作る | 観測を入れる前の不確かさと比べるからである。ex-kf-numeric の $k=1$ で $P_{0\mid0}=\frac12$ を使うと $\frac13$ になり、正しい値は $\frac35$ である |
| 最初の段で予測してから更新する | $P_0=P_{0\mid-1}$ なので、最初は $y_0$ の更新である | $x_0$ の分布に $y_0$ を入れる前の段がなく、余分な予測は $Q$ を 1 回多く足す |
| Gauss でないのに、観測の全ての関数の中で最適とする | 言えるのはアフィン関数の中での最適性である | thm-kf-blue の範囲を超える。節「使える条件と反例」の $x_0=\pm1$ の例で $\tanh y_0$ の方が小さい誤差を与える |
| 定常の利得が最初の時刻から最適だとする | 定常の利得は極限で最適であり、各時刻の最適な利得は $K_k$ である | ex-kf-numeric の $k=0$ で $K\approx0.618$ を使うと誤差分散は $0.528$ で、$K_0=\frac12$ の $0.5$ より大きい |
文献
離散時間の問題と解は Kal60(Theorem 3、p. 41)に始まり、教科書としての扱いは AM79 第 3 章(式 (1.6)–(1.12)、pp. 38–39)、AMF20 Theorem 8.4(p. 8-18)にある。条件付き期待値が 2 乗誤差を最小にすることは Kal60 Theorem 1-a、AM79 第 2 章 Theorem 3.1 にある。Kal60 は状態の時刻 $t+1$ の予測の形で述べている。
関連項目
- 前提: 多変量正規分布, 条件付き期待値, 正定値行列
- 比較: 最小二乗法, Bayesの定理, 直交射影
- 発展: Kalman–Bucyフィルタ, Riccati方程式, 制御理論, 動的計画法と最適制御, 確率最適制御, 指数型分布族
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

