平均・中央値・分散
概要
平均・中央値・分散(mean, median and variance)とは、データの中心と散らばりを表す基本の量である。平均値 $\bar x$ はずれの 2 乗の和 $\sum(x_i-a)^2$ を最小にするただ 1 つの $a$、中央値はずれの絶対値の和 $\sum|x_i-a|$ を最小にする $a$ であり(データが偶数個のとき最小にする $a$ は区間になり、高校の中央値はその中点)、分散は 2 乗の和の最小値を $n$ で割ったものである。データをベクトルとみると、分散は偏差ベクトルの長さの 2 乗、共分散は内積、相関係数は角の余弦になる。どの 2 つも無相関で分散 $\sigma^2$ の $n$ 個の確率変数の平均の分散は $\sigma^2/n$ である。
平均・中央値・分散とは
データの「中心」と「散らばり」を 1 つの数で表す量を、高校では代表値・散布度として習う。この記事は、その基本の 3 つ(平均値・中央値・分散)を定義し、「平均値はずれの 2 乗の和を最小にする」「中央値はずれの絶対値の和を最小にする」という 2 つの性質をこの記事の中で証明したうえで、それぞれを大学の数学の目で見直す 5 本の記事への案内をする。
$n$ 個の数値からなるデータ $x_1,\dots,x_n$ を考え、小さい順に並べ替えたものを $x_{(1)}\le x_{(2)}\le\cdots\le x_{(n)}$ と書く。
- 平均値:$\bar x:=\frac1n\sum_{i=1}^nx_i$。
- 中央値:$n=2m+1$(奇数)なら $x_{(m+1)}$、$n=2m$(偶数)なら $\frac12\bigl(x_{(m)}+x_{(m+1)}\bigr)$。
- 分散:偏差 $x_i-\bar x$ の 2 乗の平均 $s^2:=\frac1n\sum_{i=1}^n(x_i-\bar x)^2$。その正の平方根 $s$ を標準偏差という。
データ $1,2,3,4,10$ では
- 平均値:$\bar x=\frac{20}5=4$。
- 中央値:真ん中の $x_{(3)}=3$。
- 分散:偏差は $-3,-2,-1,0,6$ なので $s^2=\frac{9+4+1+0+36}5=10$。
最後の値を $100$ に変えると、平均値は $\frac{110}5=22$ に跳ね上がるが、中央値は $3$ のままである。
データ $1,2,4,7$ では
- 平均値:$\bar x=\frac{14}4=3.5$。
- 中央値:真ん中の 2 つ $2$ と $4$ の平均で $3$。
- 分散:偏差は $-2.5,-1.5,0.5,3.5$ なので $s^2=\frac{6.25+2.25+0.25+12.25}4=\frac{21}4=5.25$。
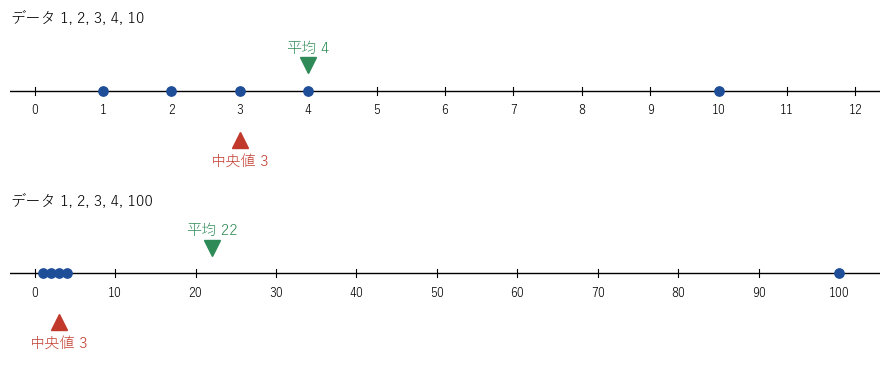 データ 1, 2, 3, 4, 10 と、最後の値を 100 に変えたデータ。平均値は 4 から 22 に動くが、中央値は 3 のまま。
平均値と中央値は、どちらも「中心」と呼ばれるのに値が違う。それぞれは何の意味で中心なのか。分散の公式 $s^2=\overline{x^2}-\bar x^2$ や、相関係数の $-1\le r\le1$ はなぜ成り立つのか。平均をとるとばらつきが減るのはなぜか。最初の問いには次の節で答え、残りは 5 本の記事で答える。
平均値と中央値は何を最小にするか
データの「中心」を 1 つの数 $a$ で代表させるとき、各データと $a$ のずれを全部合わせた量が小さいほど、$a$ はよい代表だと考えられる。ずれの測り方を 2 通り用意する。
$$
Q(a):=\sum_{i=1}^n(x_i-a)^2\quad(\text{ずれの 2 乗の和}),\qquad L(a):=\sum_{i=1}^n|x_i-a|\quad(\text{ずれの絶対値の和})
$$
平均値は $Q$ を、中央値は $L$ を最小にする。この節ではこの 2 つを証明する。
データ $x_1,\dots,x_n$ の平均値を $\bar x$ とする。すべての実数 $a$ について
$$
\sum_{i=1}^n(x_i-a)^2=\sum_{i=1}^n(x_i-\bar x)^2+n(a-\bar x)^2
$$
が成り立つ。したがって $Q(a)$ は $a=\bar x$ のときに限って最小になり、最小値は $ns^2$ である。特に $a=0$ とおくと、分散の公式
$$
s^2=\overline{x^2}-\bar x^2\qquad\Bigl(\overline{x^2}:=\frac1n\sum_{i=1}^nx_i^2\Bigr)
$$
が得られる。
段 1(偏差の和は $0$)。$\bar x$ の定義から $\sum_{i=1}^nx_i=n\bar x$ なので
$$
\sum_{i=1}^n(x_i-\bar x)=\sum_{i=1}^nx_i-n\bar x=0
$$
である。
段 2(2 つに分けて 2 乗する)。$x_i-a=(x_i-\bar x)+(\bar x-a)$ と分けて 2 乗すると
$$
(x_i-a)^2=(x_i-\bar x)^2+2(\bar x-a)(x_i-\bar x)+(\bar x-a)^2
$$
である。$i=1,\dots,n$ について足す。$\bar x-a$ は $i$ によらない数なので和の外に出せて、真ん中の項の和は $2(\bar x-a)\sum_{i=1}^n(x_i-\bar x)=0$(段 1)になる。最後の項は同じ数 $(\bar x-a)^2$ を $n$ 個足すので $n(a-\bar x)^2$ である。これで等式が示された。
段 3(最小値)。右辺の第 1 項 $\sum(x_i-\bar x)^2=ns^2$ は $a$ によらない。第 2 項 $n(a-\bar x)^2$ は $0$ 以上で、$0$ になるのは $a=\bar x$ のときだけである。よって $Q(a)\ge ns^2$ で、等号は $a=\bar x$ のときに限る。
段 4(分散の公式)。等式に $a=0$ を入れると $\sum x_i^2=ns^2+n\bar x^2$ である。両辺を $n$ で割って移項すると $s^2=\overline{x^2}-\bar x^2$ となる。$\square$
等式は、$Q(a)$ を $a$ の 2 次関数とみて平方完成したものでもある。グラフは頂点が $(\bar x,\ ns^2)$ の下に凸な放物線である(2次関数の最大・最小)。
次の定理のために、データを小さい順に並べた $x_{(1)}\le\cdots\le x_{(n)}$ を使う。$L(a)$ は足す順番によらないので、$L(a)=\sum_{i=1}^n|x_{(i)}-a|$ と書いてよい。
$p\le q$ とする。すべての実数 $a$ について $|p-a|+|q-a|\ge q-p$ であり、等号が成り立つのは $p\le a\le q$ のときに限る。
- $a< p$ のとき:$p-a>0$、$q-a>0$ なので $|p-a|+|q-a|=(p-a)+(q-a)=(q-p)+2(p-a)>q-p$。
- $p\le a\le q$ のとき:$|p-a|+|q-a|=(a-p)+(q-a)=q-p$。
- $a>q$ のとき:$|p-a|+|q-a|=(a-p)+(a-q)=(q-p)+2(a-q)>q-p$。
どの場合も $q-p$ 以上で、等号は真ん中の場合だけである。$\square$
数直線で見ると、$|p-a|+|q-a|$ は点 $a$ から 2 点 $p,q$ までの距離の和である。$a$ が 2 点の間にあれば和は 2 点の間の距離 $q-p$ で、外に出ると往復の分だけ長くなる。
データ $x_1,\dots,x_n$ を小さい順に並べたものを $x_{(1)}\le\cdots\le x_{(n)}$ とする。
- $n=2m+1$(奇数)のとき、$L(a)$ を最小にする $a$ は中央値 $x_{(m+1)}$ ただ 1 つである。
- $n=2m$(偶数)のとき、$L(a)$ を最小にする $a$ 全体は閉区間 $[x_{(m)},x_{(m+1)}]$ である。高校の中央値 $\frac12\bigl(x_{(m)}+x_{(m+1)}\bigr)$ はこの区間の中点なので、$L$ を最小にする。
段 1(組にする)。$i=1,\dots,m$ について、小さいほうから $i$ 番目と大きいほうから $i$ 番目を組にする。組 $x_{(i)}\le x_{(n+1-i)}$ に lem-mmv-two-points を使うと
$$
\lvert x_{(i)}-a\rvert+\lvert x_{(n+1-i)}-a\rvert\ge x_{(n+1-i)}-x_{(i)}
$$
で、等号は $a\in I_i:=[x_{(i)},x_{(n+1-i)}]$ のときに限る。区間は $I_1\supset I_2\supset\cdots\supset I_m$ と内側へ入れ子になっている($x_{(i)}\le x_{(i+1)}$、$x_{(n-i)}\le x_{(n+1-i)}$ だから)。
段 2(偶数個)。$n=2m$ なら、$m$ 組でデータ全部を使い切る。$m$ 個の不等式を足すと
$$
L(a)\ge\sum_{i=1}^m\bigl(x_{(n+1-i)}-x_{(i)}\bigr)=:c
$$
で、右辺の $c$ は $a$ によらない。等号は $m$ 個すべてで等号が成り立つとき、つまり $a$ がすべての $I_i$ に入るときに限る。入れ子なので、それは $a\in I_m=[x_{(m)},x_{(m+1)}]$ と同じである。この区間は空でないので、$L$ の最小値は $c$ で、最小にする $a$ 全体はちょうど $I_m$ である。
段 3(奇数個)。$n=2m+1$ なら、$m$ 組のほかに真ん中の $x_{(m+1)}$ が 1 つ残る。足すと
$$
L(a)\ge c+|x_{(m+1)}-a|\ge c
$$
である。等号は、$a$ がすべての $I_i$ に入り、かつ $a=x_{(m+1)}$ のときに限る。$x_{(m+1)}$ はどの $I_i$ にも入っている($x_{(i)}\le x_{(m+1)}\le x_{(n+1-i)}$)ので、等号は $a=x_{(m+1)}$ のときちょうど成り立つ。よって $L$ を最小にするのは $x_{(m+1)}$ ただ 1 つである($m=0$、つまり $n=1$ なら組はなく、$L(a)=|x_1-a|$ なので明らかである)。$\square$
2 つの定理と同じ主張は、各論の記事 平均値と二乗誤差 の定理「平均値は二乗誤差の和を最小にする」と、中央値と絶対誤差 の定理「中央値は絶対誤差の和を最小にする」でも証明されている。各論の記事では、確率変数の期待値への広がりや、平均値と中央値の使い分けまで扱う。
高校の計算と大学の概念
| 高校の計算 | 大学の言葉 | 詳しい記事 |
|---|---|---|
| 平均値 $\bar x$ | ずれの 2 乗の和 $\sum(x_i-a)^2$ を最小にするただ 1 つの $a$ | 平均値と二乗誤差 |
| 分散の公式 $s^2=\overline{x^2}-\bar x^2$ | 直交分解とピタゴラスの定理 | 平均値と二乗誤差、相関係数(高校数学) |
| 中央値 | ずれの絶対値の和 $\sum\vert x_i-a\vert$ を最小にする $a$(偶数個なら区間) | 中央値と絶対誤差 |
| 確率分布の中央値 | $E\vert X\vert<\infty$ なら $E\vert X-a\vert$ を最小にする $a$、確率を半分ずつに分ける点 | 確率分布の中央値 |
| 共分散・相関係数 | 偏差ベクトルの内積・なす角の余弦 | 相関係数(高校数学) |
| $-1\le r\le1$ | Cauchy–Schwarz の不等式 | 相関係数(高校数学) |
| 標本平均の標準偏差 $\frac{\sigma}{\sqrt n}$ | 直交するベクトルの和の長さ | 標本平均の分散 |
データ $1,2,3,4,10$ について、ずれの測り方ごとに「ずれの合計」を計算する。
- 2 乗の和 $Q(a)=\sum(x_i-a)^2$:$Q(3)=4+1+0+1+49=55$、$Q(4)=9+4+1+0+36=50$。平均値 $4$ のほうが小さい。
- 絶対値の和 $L(a)=\sum|x_i-a|$:$L(3)=2+1+0+1+7=11$、$L(4)=3+2+1+0+6=12$。中央値 $3$ のほうが小さい。
どちらの測り方でも、最小になるのはそれぞれ平均値と中央値である(thm-mmv-mean、thm-mmv-median)。$Q$ の最小値 $50$ は分散 $10$ の $5$ 倍であり、$Q(3)=50+5\cdot(3-4)^2=55$ も thm-mmv-mean の等式どおりである。
データ $1,2,3,4,10$ では、$x_i^2$ の平均は $\overline{x^2}=\frac{1+4+9+16+100}5=26$ なので
$$
\overline{x^2}-\bar x^2=26-16=10
$$
となり、偏差から計算した分散 $10$(ex-mmv-odd-data)と一致する。この一致がいつも起こることは thm-mmv-mean で証明した。相関係数(高校数学) では、同じ等式を直角三角形の三辺の関係として見直す。
2 つの変量 $\boldsymbol x=(1,2,3,4,5)$、$\boldsymbol y=(1,3,2,5,4)$ では、偏差は $(-2,-1,0,1,2)$ と $(-2,0,-1,2,1)$ である。$s_x^2=s_y^2=2$、共分散は $s_{xy}=\frac{4+0+0+2+2}5=\frac85$ なので、相関係数は $r=\frac{8/5}{2}=0.8$ である。$r=\cos\theta$ となる角は $\theta=36.86\ldots^\circ$ で、これは 2 つの偏差ベクトルのなす角である(相関係数(高校数学))。
表なら $1$、裏なら $0$ とする公正な硬貨 1 枚の分散は $\frac14$ である。2 枚を独立に投げた平均は $0,\frac12,1$ を確率 $\frac14,\frac12,\frac14$ でとり、分散は $\frac14\cdot\frac14+\frac12\cdot0+\frac14\cdot\frac14=\frac18$ である。1 枚の分散の半分になる。$n$ 枚なら $\frac1{4n}$ になることが 標本平均の分散 で示される。
条件を外すと崩れること
ここまでの主張には、それぞれ前提がある。前提を 1 つ外すと結論が崩れる反例を表にする。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| ずれを 2 乗で測る | データ $1,2,3,4,10$ で $L(4)=12>L(3)=11$ | 平均値がずれの合計を最小にする |
| データが奇数個 | データ $1,2,4,7$ で、$2\le a\le4$ のどの $a$ でも $L(a)=8$ | ずれの絶対値の和を最小にする $a$ がただ 1 つ |
| 分散は $n$ で割る | データ $1,2,3,4,10$ で、$n-1=4$ で割ると $12.5$ | $s^2=\overline{x^2}-\bar x^2$(右辺は $10$) |
| 2 回の結果が無相関 | 1 枚の硬貨の結果 $X$ を 2 回とも使う | 2 つの平均の分散が 1 つの分散の半分 |
- 2 乗を絶対値に替える。 ex-mmv-compare のとおり、データ $1,2,3,4,10$ では平均値 $4$ より中央値 $3$ のほうが $L$ が小さい。「平均値はずれの合計を最小にする」という主張は、ずれを 2 乗で測るという前提(thm-mmv-mean)を外すと成り立たない。
- 偶数個にする。 データ $1,2,4,7$ では、$2\le a\le4$ のとき $|1-a|+|7-a|=6$、$|2-a|+|4-a|=2$(lem-mmv-two-points)なので $L(a)=8$ で一定である。$a=2.5$ でも $a=4$ でも最小になり、最小にする値はただ 1 つに決まらない。高校の中央値 $3$ は、この区間 $[2,4]$ の中点を選ぶ約束である。この反例は「$L$ を最小にする $a$ は 1 つ」という含意を、奇数個という前提(thm-mmv-median の 1 つ目)を外して破る。
- $n-1$ で割る。 データ $1,2,3,4,10$ の偏差の 2 乗の和は $50$ である。$n-1=4$ で割った $12.5$(統計で不偏分散と呼ばれる量)は、$\overline{x^2}-\bar x^2=10$ と等しくない。分散の公式は「$n$ で割る」定義のもとでの等式である。
- 無相関でない場合。 公正な硬貨 1 枚の結果 $X$(表なら $1$、裏なら $0$)を、2 回目の結果としてもそのまま使う($Y=X$)。平均 $\frac{X+Y}2=X$ の分散は $\frac14$ のままで、ex-mmv-average の $\frac18$ にならない。「平均をとるとばらつきが減る」という含意は、2 回の結果が無相関であるという前提を外すと成り立たない。
疑問から記事を探す
| 疑問 | 答える記事 |
|---|---|
| 平均値はどういう意味で「中心」なのか | 平均値と二乗誤差 |
| 偶数個のとき、中央値を真ん中の 2 つの平均にするのはなぜか | 中央値と絶対誤差 |
| 外れ値があると平均値が動くのに、中央値が動かないのはなぜか | 中央値と絶対誤差 |
| 確率分布(さいころ、密度関数)の中央値はどう決めるか | 確率分布の中央値 |
| 期待値をもたない分布はあるか | 確率分布の中央値 |
| 相関係数が $-1$ と $1$ の間にあるのはなぜか | 相関係数(高校数学) |
| 相関係数が $0$ なら無関係か | 相関係数(高校数学) |
| 同じ測定をくり返して平均すると、なぜ精度が上がるのか | 標本平均の分散 |
| 何回くり返せば精度が 2 倍になるか | 標本平均の分散 |
読む順番
- 平均値と二乗誤差:平均値は、ずれの 2 乗の和を最小にするただ 1 つの値である。偏差の和が $0$ になることから等式 $\sum(x_i-a)^2=\sum(x_i-\bar x)^2+n(a-\bar x)^2$ を導き、分散の公式を系として得る。確率変数の期待値でも同じことが成り立つ。
- 中央値と絶対誤差:中央値は、ずれの絶対値の和を最小にする値である。偶数個のときは最小にする値が区間になり、高校の中央値はその中点であることがわかる。平均値との使い分けも扱う。
- 確率分布の中央値:確率変数の中央値を確率の釣り合いで定義し、$E|X-a|$ を最小にするのが中央値であることを示す。期待値をもたない Cauchy 分布でも中央値は使える。
- 相関係数(高校数学):データをベクトルとみると、分散は長さの 2 乗、共分散は内積、相関係数は角の余弦になる。$-1\le r\le1$ を 2 次関数の判別式で証明し、$r=\pm1$ となる条件を求める。1 のあとに読むとよい。
- 標本平均の分散:分散がどれも $\sigma^2$ で、どの 2 つも無相関な $n$ 個の確率変数の平均は、分散が $\frac{\sigma^2}n$ になる。共分散の性質から証明し、相関があると成り立たない例を見る。1 のあとに読むとよい。
1 → 2 → 3 の順に読むと、平均と中央値の違いがはっきりする。4 と 5 は 1 を読んでいれば、どちらからでも読める。
関連項目
- 前提: Σ記法の使い方, 絶対値, 期待値
- 次に読む: 平均値と二乗誤差, 中央値と絶対誤差, 確率分布の中央値, 相関係数(高校数学), 標本平均の分散, 四分位数と箱ひげ図
- 関連(高校数学): 2次関数の最大・最小, 絶対値と三角不等式, 大数の法則とさいころの平均, 確率変数の期待値と分散
- 発展: 分散, 大数の法則, 最小二乗法
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

