推定量のよさ
概要
推定量のよさ(properties of estimators)とは、母集団の未知の数 $\theta$ を標本から推し量る推定量 $T$ を偏り $E(T)-\theta$ と平均二乗誤差 $E((T-\theta)^2)$ で比べる見方である。平均二乗誤差は分散と偏りの 2 乗の和で、大きさ $n\ge2$ の無作為標本の偏差の 2 乗の和を $n-1$ で割ると母分散の不偏推定量になる。独立に $U(0,\theta)$ に従う $n$ 個の値では $2\bar X$ と $\frac{n+1}n\max X_i$ はどちらも不偏で、分散は $\frac{\theta^2}{3n}$ と $\frac{\theta^2}{n(n+2)}$ なので $n\ge2$ なら最大値を使う方がよい。平均二乗誤差では不偏でない $\frac{n+2}{n+1}\max X_i$ がさらによい。
前提知識: 標本平均の分散, 区間推定(高校数学), 一様分布と指数分布
高校での出発点:同じデータから 2 つの答
区間推定(高校数学) では、母平均を標本平均で推し量った。しかし、推し量りたい量によっては、標本から計算する方法がいくつも考えられる。どの方法がよいのかを、2 つの例で考える。
$1$ から $N$ までの通し番号の付いた券がある。$N$ は分からない。券をでたらめに $5$ 枚取り出すと、番号は $12$、$31$、$47$、$58$、$83$ だった。$N$ を推し量る。
番号は $1$ から $N$ までにまんべんなく散らばっているので、区間 $[0,\theta]$ の上の一様分布で近似して考える($\theta$ が $N$ にあたる)。$U(0,\theta)$ の平均は $\frac\theta2$ である(一様分布と指数分布)。
(1) 平均を使う方法。標本平均は $\dfrac{12+31+47+58+83}5=\dfrac{231}5=46.2$ である。平均が $\frac\theta2$ に近いはずなので、$\theta$ をその 2 倍の
$$
2\times46.2=92.4
$$
と推し量る。
(2) 最大値を使う方法。いちばん大きい番号は $83$ で、$N$ は $83$ 以上である。$5$ 個の値は $[0,\theta]$ を平均して $6$ つの区間に分けると考えると、最大値の後にも $\frac\theta6$ ほどの隙間が残るので、$\theta$ を
$$
\frac65\times83=99.6
$$
と推し量る。
同じデータから、$92.4$ と $99.6$ という違う答が出た。どちらがよいのだろうか。
表なら $1$、裏なら $0$ とする公平な硬貨の値を母集団とする。母平均は $\frac12$、母分散は $\sigma^2=\frac14$ である($1$ か $0$ の値の分散 $p(1-p)$ で $p=\frac12$)。硬貨を $2$ 回投げた値 $X_1$、$X_2$ から母分散を推し量る。
標本平均を $\bar X=\frac{X_1+X_2}2$ とし、偏差の 2 乗の和 $Q=(X_1-\bar X)^2+(X_2-\bar X)^2$ を 4 通りの結果で計算する。
| $(X_1,X_2)$ | $(0,0)$ | $(0,1)$ | $(1,0)$ | $(1,1)$ |
|---|---|---|---|---|
| $Q$ | $0$ | $\frac12$ | $\frac12$ | $0$ |
| $\frac Q2$($n$ で割る) | $0$ | $\frac14$ | $\frac14$ | $0$ |
| $\frac Q1$($n-1$ で割る) | $0$ | $\frac12$ | $\frac12$ | $0$ |
4 通りは同じ確率 $\frac14$ で起こるので、期待値は
$$
E\Bigl(\frac Q2\Bigr)=\frac14\Bigl(0+\frac14+\frac14+0\Bigr)=\frac18,\qquad E\Bigl(\frac Q1\Bigr)=\frac14\Bigl(0+\frac12+\frac12+0\Bigr)=\frac14
$$
である。$n=2$ で割ると平均的に $\sigma^2=\frac14$ の半分しか出ず、$n-1=1$ で割るとちょうど $\sigma^2$ になる。
この記事で答える問いは次の 3 つである。
- 「推し量る方法のよさ」は、何で測ればよいか。→ def-est-estimator、thm-est-mse
- ex-est-coin で、$n-1$ で割るとちょうど母分散になったのは偶然か。→ thm-est-unbiased-var
- ex-est-tickets の 2 つの方法のうち、どちらがよいか。→ thm-est-uniform
高校の言葉 この記事の言葉 大学の言葉 標本から計算した値で母数を推し量る 推定量 統計量による点推定 平均的に当たる 不偏 不偏推定量 ずれの 2 乗の平均 平均二乗誤差 2 乗損失のリスク 標本の数を増やすと当たる 一致性 一致推定量
推定量とそのよさの測り方
推定量・偏り・平均二乗誤差
母集団の分布が、値の分からない数 $\theta$ を含むとする(母平均 $\mu$、母分散 $\sigma^2$、ex-est-tickets の右端 $\theta$ など)。母集団から大きさ $n$ の無作為標本 $X_1,\ldots,X_n$ をとる。$X_1,\ldots,X_n$ は互いに独立で、どれも母集団と同じ分布に従う(区間推定(高校数学) の定義「母集団と無作為標本」)。
標本 $X_1,\ldots,X_n$ から計算して $\theta$ を推し量る確率変数 $T=t(X_1,\ldots,X_n)$ を、$\theta$ の 推定量 という。標本の実際の値を代入した数を 推定値 という。
(1) $E(T)-\theta$ を $T$ の 偏り(バイアス)という。$\theta$ がどんな値でも $E(T)=\theta$ となるとき、$T$ は $\theta$ の 不偏推定量 である、または $T$ は 不偏 であるという。
(2) $E\bigl((T-\theta)^2\bigr)$ を $T$ の 平均二乗誤差 という。
推定量 $T$ は、標本の値によって値が変わる確率変数である。ex-est-tickets の $92.4$ や $99.6$ は、たまたま得た標本での推定値である。推定量のよさは、1 回の推定値ではなく、標本をとり直したときの $T$ の分布で測る。偏りは「平均して当たっているか」、平均二乗誤差は「どれだけ近くに当たるか」を表す。
- 標本平均 $\bar X=\frac1n(X_1+\cdots+X_n)$ は母平均 $\mu$ の推定量で、$E(\bar X)=\mu$ なので不偏である。平均二乗誤差は、偏りが $0$ なので $E\bigl((\bar X-\mu)^2\bigr)=V(\bar X)=\frac{\sigma^2}n$ である(標本平均の分散 の主定理)。
- ex-est-coin の $\frac Q2$ は $\sigma^2$ の推定量で、$\sigma^2=\frac14$ のとき偏りは $\frac18-\frac14=-\frac18$ である。$\frac Q1$ の偏りは $0$ である。
- 標本の最初の 1 個 $X_1$ も $\mu$ の推定量で、$E(X_1)=\mu$ なので不偏である。しかし平均二乗誤差は $V(X_1)=\sigma^2$ で、$n\ge2$ なら $\bar X$ の $\frac{\sigma^2}n$ より大きい。不偏な推定量はいくつもあり、不偏というだけではよさは決まらない。
連続型の確率変数についても、和の期待値は期待値の和であり、独立な確率変数の和の分散は分散の和である(GS06 §6.3 の Theorem 6.10・Theorem 6.16。この記事では証明しない)。したがって、標本平均の分散 の主定理 $E(\bar X)=\mu$、$V(\bar X)=\frac{\sigma^2}n$ は、連続型の母集団の無作為標本でも成り立つ。以下ではこれを使う。
主定理 1:平均二乗誤差の分解
推定量 $T$ の分散 $V(T)$ が定まるとき
$$
E\bigl((T-\theta)^2\bigr)=\underbrace{V(T)}_{\text{散らばり}}+\underbrace{\bigl(E(T)-\theta\bigr)^2}_{\text{偏りの 2 乗}}
$$
が成り立つ。特に、不偏推定量の平均二乗誤差は分散に等しい。
方針:$T-\theta$ を「$T$ の平均からのずれ」と「偏り」に分けて 2 乗を展開する。
段 1(分ける)。$m=E(T)$ とおく。$T-\theta=(T-m)+(m-\theta)$ で、$m-\theta$ は定数である。2 乗すると
$$
(T-\theta)^2=(T-m)^2+2(m-\theta)(T-m)+(m-\theta)^2
$$
である。
段 2(期待値をとる)。期待値の線形性(和の期待値は期待値の和、定数倍は外に出せる、定数の期待値はその定数)により
$$
E\bigl((T-\theta)^2\bigr)=E\bigl((T-m)^2\bigr)+2(m-\theta)E(T-m)+(m-\theta)^2
$$
である。
段 3(真ん中の項)。$E(T-m)=E(T)-m=0$ なので、真ん中の項は $0$ である。第 1 項は分散の定義により $V(T)$ である。よって $E\bigl((T-\theta)^2\bigr)=V(T)+(m-\theta)^2$ である。$\square$
これは 平均値と二乗誤差 の命題「期待値はずれの 2 乗の期待値を最小にする」の等式 $E\bigl((X-a)^2\bigr)=V(X)+(\mu-a)^2$ で、$X$ を $T$ に、$a$ を真の値 $\theta$ にしたものと同じである。平均二乗誤差を小さくするには、散らばりと偏りの両方を小さくする必要がある。
ex-est-coin の $\frac Q2$($n$ で割る方)は、値 $0$ と $\frac14$ を確率 $\frac12$ ずつとる。$E\bigl(\frac Q2\bigr)=\frac18$ で、分散は $\frac12\bigl(0-\frac18\bigr)^2+\frac12\bigl(\frac14-\frac18\bigr)^2=\frac1{64}$、偏りの 2 乗は $\bigl(\frac18-\frac14\bigr)^2=\frac1{64}$ である。平均二乗誤差を直接計算すると
$$
\frac12\Bigl(0-\frac14\Bigr)^2+\frac12\Bigl(\frac14-\frac14\Bigr)^2=\frac1{32}=\frac1{64}+\frac1{64}
$$
で、分解のとおりになる。$\frac Q1$ は不偏で、分散は $\frac12\bigl(0-\frac14\bigr)^2+\frac12\bigl(\frac12-\frac14\bigr)^2=\frac1{16}$ なので、平均二乗誤差は $\frac1{16}$ である。この例では、偏りのある $\frac Q2$ の方が平均二乗誤差は小さい($\frac1{32}<\frac1{16}$)。
$n-1$ で割る標本分散は不偏
ex-est-coin で $n-1$ で割るとちょうど母分散になったのは偶然ではない。
母平均 $\mu$、母分散 $\sigma^2$ の母集団の無作為標本 $X_1,\ldots,X_n$($n\ge2$)について
$$
s^2=\frac1{n-1}\sum_{i=1}^n(X_i-\bar X)^2
$$
とおくと、$E(s^2)=\sigma^2$ である。つまり $s^2$ は $\sigma^2$ の不偏推定量である。
方針:$X_i-\bar X$ を $\mu$ からのずれ $X_i-\mu$ と $\bar X-\mu$ の差に書き、偏差の 2 乗の和を $\sum(X_i-\mu)^2-n(\bar X-\mu)^2$ に直す(GS06 §6.2 の Exercise 18 のヒントの計算)。
段 1(1 つの項の展開)。$X_i-\bar X=(X_i-\mu)-(\bar X-\mu)$ なので
$$
(X_i-\bar X)^2=(X_i-\mu)^2-2(\bar X-\mu)(X_i-\mu)+(\bar X-\mu)^2
$$
である。
段 2(和をとる)。$i=1,\ldots,n$ について足すと、$\bar X-\mu$ は $i$ によらないので
$$
\sum_{i=1}^n(X_i-\bar X)^2=\sum_{i=1}^n(X_i-\mu)^2-2(\bar X-\mu)\sum_{i=1}^n(X_i-\mu)+n(\bar X-\mu)^2
$$
である。
段 3(真ん中の和)。$\displaystyle\sum_{i=1}^n(X_i-\mu)=\sum_{i=1}^nX_i-n\mu=n\bar X-n\mu=n(\bar X-\mu)$ なので、真ん中の項は $-2n(\bar X-\mu)^2$ である。よって
$$
\sum_{i=1}^n(X_i-\bar X)^2=\sum_{i=1}^n(X_i-\mu)^2-n(\bar X-\mu)^2
$$
である。
段 4(期待値)。$E\bigl((X_i-\mu)^2\bigr)=V(X_i)=\sigma^2$ であり、$E(\bar X)=\mu$ なので $E\bigl((\bar X-\mu)^2\bigr)=V(\bar X)=\frac{\sigma^2}n$ である(標本平均の分散)。期待値の線形性により
$$
E\Bigl(\sum_{i=1}^n(X_i-\bar X)^2\Bigr)=n\sigma^2-n\cdot\frac{\sigma^2}n=(n-1)\sigma^2
$$
である。$n-1$ で割って $E(s^2)=\sigma^2$ を得る。$\square$
段 3 の式は、「平均値 $\bar X$ のまわりの 2 乗の和は、ほかのどの点(ここでは $\mu$)のまわりの 2 乗の和以下である」ことを表している(等号は $\bar X=\mu$ のとき)(平均値と二乗誤差 の主定理と同じ)。$\bar X$ は標本そのものに合わせて決めた点なので、偏差の 2 乗の和は $\mu$ のまわりの和より平均して $\sigma^2$ だけ小さくなる。これを補うのが $n-1$ で割ることである。
さいころの目の母分散は $\sigma^2=\frac{35}{12}$ である(確率変数の期待値と分散)。さいころを $2$ 個振ったときの $Q=(X_1-\bar X)^2+(X_2-\bar X)^2$ を、36 通りすべてについて平均すると $\frac{35}{12}$ になる。$n-1=1$ で割った $s^2=Q$ の期待値は $\sigma^2$ に等しい。$n=2$ では $Q=\frac{(X_1-X_2)^2}2$ である($\bar X=\frac{X_1+X_2}2$ から $X_1-\bar X=\frac{X_1-X_2}2$、$X_2-\bar X=-\frac{X_1-X_2}2$)。
36 通りの平均の計算を開く
差 $d=X_1-X_2$ の値ごとに組の数を数えると、$d=0$ が $6$ 通り、$\lvert d\rvert=1$ が $10$ 通り、$\lvert d\rvert=2$ が $8$ 通り、$\lvert d\rvert=3$ が $6$ 通り、$\lvert d\rvert=4$ が $4$ 通り、$\lvert d\rvert=5$ が $2$ 通りである。$d^2$ の合計は $10\cdot1+8\cdot4+6\cdot9+4\cdot16+2\cdot25=10+32+54+64+50=210$ で、$E(Q)=\dfrac1{36}\cdot\dfrac{210}2=\dfrac{105}{36}=\dfrac{35}{12}$ である。
主定理 2:一様分布の右端の推定
ex-est-tickets にもどる。母集団は一様分布 $U(0,\theta)$ で、$\theta$ が分からない。$X_1,\ldots,X_n$ は独立に $U(0,\theta)$ に従うとする。ここで「独立」とは、どんな区間 $I_1,\ldots,I_n$ についても
$$
P(X_1\in I_1\text{ かつ }\cdots\text{ かつ }X_n\in I_n)=P(X_1\in I_1)\cdots P(X_n\in I_n)
$$
が成り立つことである($n=2$ なら、点 $(X_1,X_2)$ が正方形の中の一様な点であること。幾何的確率)。2 つの推定量
$$
T_1=2\bar X,\qquad T_2=\frac{n+1}n\,M,\qquad M=\max(X_1,\ldots,X_n)
$$
を比べる。$M$ は $X_1,\ldots,X_n$ のうち最大のものである。
まず最大値 $M$ の分布を求める。
$X_1,\ldots,X_n$ が独立に $U(0,\theta)$ に従うとき、$M=\max(X_1,\ldots,X_n)$ は、$0\le x\le\theta$ で
$$
P(M\le x)=\Bigl(\frac x\theta\Bigr)^n
$$
を満たし、密度 $\dfrac{nx^{n-1}}{\theta^n}$($0\le x\le\theta$。それ以外で $0$)をもつ。さらに
$$
E(M)=\frac n{n+1}\theta,\qquad E(M^2)=\frac n{n+2}\theta^2,\qquad V(M)=\frac{n\theta^2}{(n+1)^2(n+2)}
$$
である。
段 1(分布関数)。「$M\le x$」は「$X_1\le x$ かつ $\cdots$ かつ $X_n\le x$」と同じである(最大のものが $x$ 以下であることと、全部が $x$ 以下であることは同じ)。独立性と $P(X_i\le x)=\frac x\theta$ により
$$
P(M\le x)=\frac x\theta\cdot\frac x\theta\cdots\frac x\theta=\Bigl(\frac x\theta\Bigr)^n\qquad(0\le x\le\theta)
$$
である。
段 2(密度)。分布関数 $F(x)$ は $x\le0$ で $0$、$0\le x\le\theta$ で $\bigl(\frac x\theta\bigr)^n$、$x\ge\theta$ で $1$ で、連続である。$[0,\theta]$ で微分可能で、導関数 $F'(x)=\dfrac{nx^{n-1}}{\theta^n}$ は連続である。確率密度関数と連続型確率変数 の主定理「分布関数と密度関数」の 2 により、$M$ は密度 $\dfrac{nx^{n-1}}{\theta^n}$($[0,\theta]$ の外で $0$)をもつ。
段 3(期待値)。
$$
E(M)=\int_0^\theta x\cdot\frac{nx^{n-1}}{\theta^n}\,dx=\frac n{\theta^n}\Bigl[\frac{x^{n+1}}{n+1}\Bigr]_0^\theta=\frac n{n+1}\theta,\qquad E(M^2)=\int_0^\theta x^2\cdot\frac{nx^{n-1}}{\theta^n}\,dx=\frac n{\theta^n}\Bigl[\frac{x^{n+2}}{n+2}\Bigr]_0^\theta=\frac n{n+2}\theta^2
$$
である。
段 4(分散)。分散の公式により
$$
V(M)=\frac n{n+2}\theta^2-\frac{n^2}{(n+1)^2}\theta^2=\frac{n\bigl((n+1)^2-n(n+2)\bigr)}{(n+1)^2(n+2)}\theta^2=\frac{n\theta^2}{(n+1)^2(n+2)}
$$
である。$(n+1)^2-n(n+2)=1$ を使った。$\square$
$E(M)=\frac n{n+1}\theta$ は $\theta$ より小さい。最大値は $\theta$ を超えないので、平均すると $\theta$ に届かない。$\frac{n+1}n$ 倍して偏りを直したのが $T_2$ である。ex-est-tickets の (2) で「最大値の後に $\frac\theta6$ ほどの隙間」と考えたのは、$n=5$ で $E(M)=\frac56\theta$ であることにあたる。
$X_1,\ldots,X_n$ が独立に $U(0,\theta)$ に従うとき、$T_1=2\bar X$ と $T_2=\dfrac{n+1}n\max(X_1,\ldots,X_n)$ はどちらも $\theta$ の不偏推定量で
$$
V(T_1)=\frac{\theta^2}{3n},\qquad V(T_2)=\frac{\theta^2}{n(n+2)}
$$
である。$n\ge2$ なら $V(T_2)< V(T_1)$ で、$n=1$ なら $T_1=T_2$ である。
段 1($T_1$)。$U(0,\theta)$ の平均は $\frac\theta2$、分散は $\frac{\theta^2}{12}$ である(一様分布と指数分布 の命題「一様分布の平均・分散・中央値」で $a=0$、$b=\theta$)。標本平均の分散 の主定理により $E(\bar X)=\frac\theta2$、$V(\bar X)=\frac{\theta^2}{12n}$ なので
$$
E(T_1)=2\cdot\frac\theta2=\theta,\qquad V(T_1)=4\cdot\frac{\theta^2}{12n}=\frac{\theta^2}{3n}
$$
である。
段 2($T_2$)。lem-est-max により
$$
E(T_2)=\frac{n+1}n\cdot\frac n{n+1}\theta=\theta,\qquad V(T_2)=\Bigl(\frac{n+1}n\Bigr)^2\cdot\frac{n\theta^2}{(n+1)^2(n+2)}=\frac{\theta^2}{n(n+2)}
$$
である。
段 3(比べる)。どちらも $\theta^2$ に正の数を掛けた形なので、分母を比べればよい。$n(n+2)-3n=n(n-1)$ で、$n\ge2$ なら正なので $n(n+2)>3n$、つまり $V(T_2)< V(T_1)$ である。$n=1$ なら $\bar X=M=X_1$ で、$T_1=2X_1=T_2$ である。$\square$
2 つとも不偏なので、thm-est-mse により平均二乗誤差は分散に等しい。$n\ge2$ なら、最大値を使う $T_2$ の方が真の値の近くに当たりやすい。
$\theta=10$、$n=5$ とすると
$$
V(T_1)=\frac{100}{15}=\frac{20}3=6.666\ldots,\qquad V(T_2)=\frac{100}{5\cdot7}=\frac{20}7=2.857\ldots
$$
で、$T_2$ の分散は $T_1$ の半分より小さい。計算機で $U(0,10)$ の乱数 $5$ 個の組を $200{,}000$ 組作ると、$T_1$ の平均 $9.995$・分散 $6.672$、$T_2$ の平均 $9.996$・分散 $2.865$ になった(図 1・図 2)。真の値から $2$ 以上ずれた割合は、$T_1$ で $0.450$、$T_2$ で $0.132$ だった。
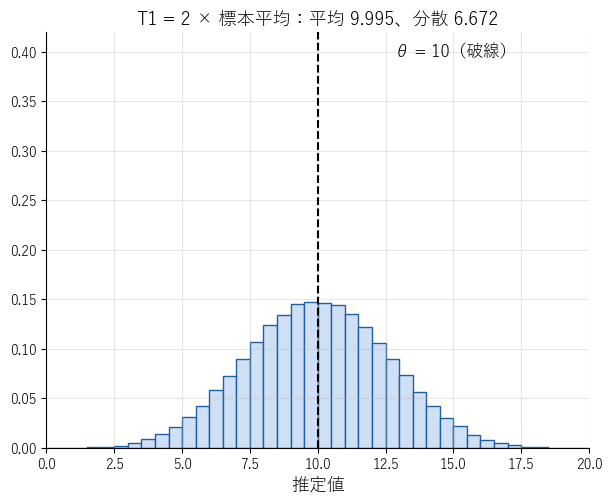 標本平均の 2 倍 T1 の値は、真の値 10 を中心に左右に広く散らばることを見る図
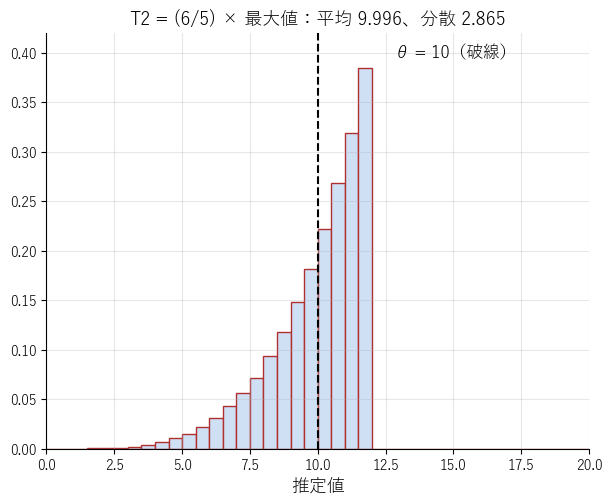 最大値の 6/5 倍 T2 の値は、12 を超えず、真の値 10 の近くに集まることを見る図
図 2 の $T_2$ の分布は左右対称でない。$T_2$ は $\frac65\theta=12$ を超えない一方、小さい側には長く伸びている。それでも平均は $\theta$ で、散らばりは $T_1$ より小さい。
ex-est-tickets で $\theta$ がおよそ $100$ だとすると、$n=5$ の標準偏差は
$$
\sqrt{V(T_1)}=\frac{100}{\sqrt{15}}=25.8\ldots,\qquad \sqrt{V(T_2)}=\frac{100}{\sqrt{35}}=16.9\ldots
$$
である。標準偏差で比べると、平均を使う方法のずれは、最大値を使う方法のずれの $1.5$ 倍ほどである。また $T_1=92.4$ は、実際に見えている番号 $83$ より大きいので矛盾はないが、$T_1$ は標本の最大値より小さくなることもある。たとえば番号が $5$、$7$、$9$、$11$、$60$ なら $T_1=2\times18.4=36.8$ で、見えている $60$ より小さい。$T_2$ はいつも最大値以上である。
不偏がいつも最良とは限らない
$T_2$ は、最大値 $M$ を $\frac{n+1}n$ 倍して偏りを $0$ にした。では、$M$ の定数倍 $cM$ のうち、平均二乗誤差がいちばん小さいのはどの $c$ か。
$X_1,\ldots,X_n$ が独立に $U(0,\theta)$ に従い、$M=\max(X_1,\ldots,X_n)$ とする。正の定数 $c$ について、$cM$ の平均二乗誤差を最小にするのは
$$
c=\frac{n+2}{n+1}
$$
で、最小値は $\dfrac{\theta^2}{(n+1)^2}$ である。これは不偏な $T_2$ の平均二乗誤差 $\dfrac{\theta^2}{n(n+2)}$ より小さい。
段 1($c$ の 2 次式)。$(cM-\theta)^2=c^2M^2-2c\theta M+\theta^2$ の期待値をとり、lem-est-max の $E(M)$、$E(M^2)$ を代入すると
$$
E\bigl((cM-\theta)^2\bigr)=\frac n{n+2}\theta^2\,c^2-\frac{2n}{n+1}\theta^2\,c+\theta^2
$$
である。
段 2(平方完成)。$A=\frac n{n+2}$、$B=\frac n{n+1}$ とおくと、右辺は $\theta^2(Ac^2-2Bc+1)=\theta^2\Bigl(A\bigl(c-\frac BA\bigr)^2+1-\frac{B^2}A\Bigr)$ である(2次関数の最大・最小)。$A>0$ なので、最小になるのは $c=\dfrac BA=\dfrac{n}{n+1}\cdot\dfrac{n+2}n=\dfrac{n+2}{n+1}$ のときである。
段 3(最小値)。最小値は
$$
\theta^2\Bigl(1-\frac{B^2}A\Bigr)=\theta^2\Bigl(1-\frac{n^2}{(n+1)^2}\cdot\frac{n+2}n\Bigr)=\theta^2\cdot\frac{(n+1)^2-n(n+2)}{(n+1)^2}=\frac{\theta^2}{(n+1)^2}
$$
である。$n(n+2)=(n+1)^2-1<(n+1)^2$ なので、$\dfrac{\theta^2}{(n+1)^2}<\dfrac{\theta^2}{n(n+2)}$ である。$\square$
$c=\frac{n+2}{n+1}$ は $\frac{n+1}n$ より小さい($(n+2)n<(n+1)^2$)。$\frac{n+2}{n+1}M$ は $\theta$ を平均して少し小さめに推し量るが、散らばりが減る分だけ、平均二乗誤差では $T_2$ に勝つ。thm-est-mse の分解で言えば、偏りの 2 乗を少し増やして、散らばりをそれ以上に減らしている。
$n=5$ なら最良の $c$ は $\frac76$ で、ex-est-tickets のデータでは $\frac76\times83=96.8\ldots$ である。$\theta=10$ での平均二乗誤差は次の表のとおりである(図 3)。
$\frac76M$ の偏りと分散を開く
$E\bigl(\frac76M\bigr)=\frac76\cdot\frac56\cdot10=\frac{175}{18}$ で、偏りは $\frac{175}{18}-10=-\frac5{18}$、偏りの 2 乗は $\frac{25}{324}$ である。分散は $\bigl(\frac76\bigr)^2V(M)=\frac{49}{36}\cdot\frac{5\cdot100}{36\cdot7}=\frac{875}{324}$ である。和は $\frac{900}{324}=\frac{25}9=2.777\ldots$ で、$\frac{100}{(5+1)^2}$ と一致する。
| 推定量 | 期待値 | 分散 | 平均二乗誤差 | $n=5$、$\theta=10$ |
|---|---|---|---|---|
| $T_1=2\bar X$ | $\theta$ | $\dfrac{\theta^2}{3n}$ | $\dfrac{\theta^2}{3n}$ | $6.666\ldots$ |
| $M=\max X_i$ | $\dfrac n{n+1}\theta$ | $\dfrac{n\theta^2}{(n+1)^2(n+2)}$ | $\dfrac{2\theta^2}{(n+1)(n+2)}$ | $4.761\ldots$ |
| $T_2=\dfrac{n+1}nM$ | $\theta$ | $\dfrac{\theta^2}{n(n+2)}$ | $\dfrac{\theta^2}{n(n+2)}$ | $2.857\ldots$ |
| $\dfrac{n+2}{n+1}M$ | $\dfrac{n(n+2)}{(n+1)^2}\theta$ | $\dfrac{n(n+2)\theta^2}{(n+1)^4}$ | $\dfrac{\theta^2}{(n+1)^2}$ | $2.777\ldots$ |
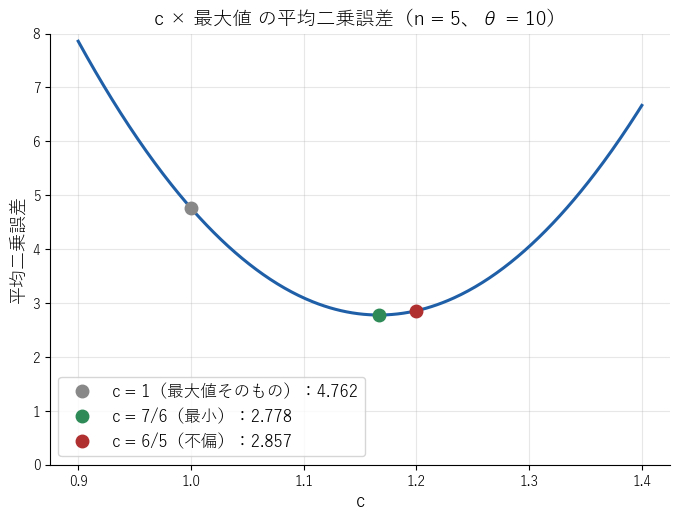 最大値の c 倍の平均二乗誤差は c の 2 次関数で、不偏になる c = 6/5 ではなく c = 7/6 で最小になることを見る図
表の $M$ の平均二乗誤差の計算を開く
thm-est-mse により、分散 $\frac{n\theta^2}{(n+1)^2(n+2)}$ と偏りの 2 乗 $\bigl(\frac\theta{n+1}\bigr)^2=\frac{\theta^2}{(n+1)^2}$ を足して、$\frac{n\theta^2+(n+2)\theta^2}{(n+1)^2(n+2)}=\frac{2\theta^2}{(n+1)(n+2)}$ となる。$n=5$、$\theta=10$ では $\frac{200}{42}=\frac{100}{21}=4.761\ldots$ である。
例と反例
ここまでの結果の仮定を外すと何が崩れるかを並べる。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| $n-1$ で割る | $n$ で割った標本分散 | 不偏(期待値は $\frac{n-1}n\sigma^2$) |
| 標本が独立 | 同じ値を $n$ 回写した標本 | $V(\bar X)=\frac{\sigma^2}n$ と $E(s^2)=\sigma^2$ |
| 母集団が一様分布 | 密度 $\frac{2x}{\theta^2}$($0\le x\le\theta$)の母集団 | $T_1=2\bar X$ が不偏 |
| $n\ge2$ | $n=1$ | $V(T_2)< V(T_1)$($T_1=T_2$ になる) |
$\sum(X_i-\bar X)^2$ を $n$ で割った値の期待値は、thm-est-unbiased-var の証明の段 4 から $\frac{(n-1)\sigma^2}n$ で、$\sigma^2$ より小さい。たとえば母標準偏差 $\sigma=3$、$n=4$ なら
$$
\frac{4-1}4\cdot3^2=\frac{27}4=6.75
$$
で、母分散 $9$ の $\frac34$ しかない。正規分布に従う乱数で $4$ 個の組を $200{,}000$ 組作ると、$n$ で割った値の平均は $6.759$、$n-1$ で割った値の平均は $9.011$ だった。偏りは $-\frac{\sigma^2}n$ で、$n$ が大きいと小さくなる。
1 回だけ測った値 $X_1$ を $n$ 回写して $X_1=X_2=\cdots=X_n$ としても、$n$ 個の値の組はできる。しかし独立ではない。このとき $\bar X=X_1$ なので $V(\bar X)=\sigma^2$ で、$\frac{\sigma^2}n$ にならない。また、偏差がすべて $0$ なので $s^2=0$ で、$E(s^2)=0\ne\sigma^2$ である。thm-est-unbiased-var の証明の段 4 は、$V(\bar X)=\frac{\sigma^2}n$ を使っている(標本平均の分散 の反例「同じ変数を $n$ 回使う」と同じ仕組み)。
母集団の密度が $\frac{2x}{\theta^2}$($0\le x\le\theta$)なら、平均は $\displaystyle\int_0^\theta x\cdot\frac{2x}{\theta^2}\,dx=\frac{2\theta}3$ である。このとき $E(T_1)=2\cdot\frac{2\theta}3=\frac43\theta$ で、$T_1$ は $\theta$ を平均して $\frac13\theta$ だけ大きく推し量る。$T_1$ が不偏なのは、一様分布の平均が $\frac\theta2$ だからである。推定量のよさは、母集団の分布についての仮定の上で決まる。
$n=1$ の行は thm-est-uniform の最後で確かめた。
大学数学で見る
推定量 $T_n$(標本の大きさ $n$ で作ったもの)が、どんな $\varepsilon>0$ についても $P(\lvert T_n-\theta\rvert\ge\varepsilon)\to0$($n\to\infty$)を満たすとき、$T_n$ は 一致性 をもつという(区間推定(高校数学) の注意「推定量の不偏性と一致性」)。不偏推定量なら、Chebyshev の不等式(区間推定(高校数学) の補題「Chebyshev の不等式」。連続型の確率変数でも、和を積分にかえた同じ証明で成り立つ)により $P(\lvert T_n-\theta\rvert\ge\varepsilon)\le\frac{V(T_n)}{\varepsilon^2}$ なので、$V(T_n)\to0$ なら一致性をもつ。$T_1$ も $T_2$ も一致性をもつが、分散の減り方が違う。$V(T_1)=\frac{\theta^2}{3n}$ は $\frac1n$ の速さ、$V(T_2)=\frac{\theta^2}{n(n+2)}$ はおよそ $\frac1{n^2}$ の速さで小さくなる(図 4)。
最尤推定量を開く
標本の値 $x_1,\ldots,x_n$ を得たとき、$\theta$ を動かして「この値の組の密度の積」$L(\theta)$ を最大にする $\theta$ を 最尤推定値 といい、それを標本 $X_1,\ldots,X_n$ の関数とみた推定量を 最尤推定量 という。$U(0,\theta)$ では、1 つの値の密度は $0\le x_i\le\theta$ なら $\frac1\theta$、それ以外で $0$ なので、$L(\theta)$ は $\theta\ge\max x_i$ なら $\frac1{\theta^n}$、$\theta<\max x_i$ なら $0$ である。$\frac1{\theta^n}$ は $\theta$ について減少するので、$L(\theta)$ を最大にするのは $\theta=\max x_i$、つまり最尤推定量は $M$ である。$M$ は不偏でなく($E(M)=\frac n{n+1}\theta$)、平均二乗誤差でも $\frac{n+2}{n+1}M$ に劣る(ex-est-four の表)。最尤推定量は多くの場面でよい性質をもつが、一様分布の右端のように、値の範囲が $\theta$ で決まる分布では注意がいる。
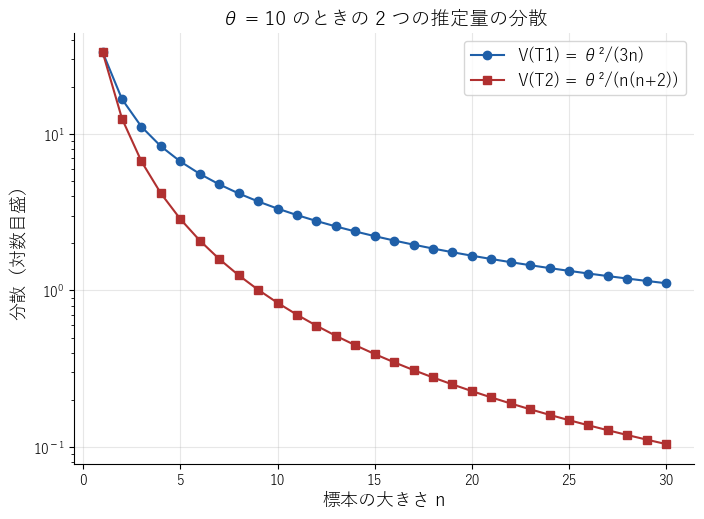 標本の大きさ n を増やすと、T1 の分散は 1/n の速さで、T2 の分散はおよそ 1/n² の速さで小さくなることを対数目盛で見る図
さらに先へ
- 推定量の散らばりが分かると、真の値を含む区間を作れる。母平均についての区間推定は 区間推定(高校数学) で、推定と表裏の関係にある検定は 仮説検定(高校数学) で扱う。
- 母集団から番号を取り出す話を、$1$ から $N$ までの整数の上の一様分布(離散の場合)で正確に扱うこともできる。この記事では連続の一様分布で近似した。
- 標本を取り出す方法(復元抽出と非復元抽出)の違いは 母集団と標本 で扱っている。
関連項目
- 前提: 標本平均の分散, 区間推定(高校数学), 一様分布と指数分布
- 前に読む: 標本平均の分散, 区間推定(高校数学), 一様分布と指数分布
- 次に読む: 仮説検定(高校数学)
- 関連(高校数学): 母集団と標本, 確率変数の期待値と分散, 平均値と二乗誤差, 2次関数の最大・最小
- 発展: 確率変数, 大数の法則
- 比較: 幾何的確率
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

