強化学習
概要
強化学習(reinforcement learning)とは、推移確率や報酬の仕組みが分からない Markov 決定過程で、環境と試行を繰り返して得た状態・行動・報酬の観測から、報酬の割引和を大きくする方策を学ぶ問題と、そのための方法の総称である。基本の方法である $Q$ 学習は、最適行動価値関数 $Q^*$ を、Bellman 最適作用素の 1 標本による推定で 1 成分ずつ更新して近づける。状態と行動が有限で、どの組も無限回試し、刻み幅の和が無限で 2 乗和が有界なら、推定値は確率 1 で $Q^*$ に収束し、そこから貪欲に選ぶ方策は最適になる。
前提知識: Markov決定過程, Banachの不動点定理, マルチンゲール, 条件付き期待値
ロボットの歩き方やゲームの打ち手を、正解の例を見せずに、試した結果の報酬だけから身につけさせたい。環境の仕組み(次の状態がどう決まり、報酬がいくら入るか)が分かっていれば、Markov決定過程 の Bellman 方程式を解けば最適な行動が決まる。しかし実際には仕組みが分からず、行動して観測した結果しか手に入らない。
強化学習 は、このように環境と試行を繰り返して得たデータから、報酬の割引和を大きくする方策を学ぶ問題と、そのための方法の総称である。この記事では状態と行動が有限の場合に限り、最も基本的な方法である $Q$ 学習 を扱う。主定理は、すべての状態と行動の組を無限回試し、刻み幅を適切に小さくしていけば、$Q$ 学習の推定値が確率 1 で最適な行動価値関数に収束すること(thm-rl-qconv)である。証明はこの記事の中で完結させる。あわせて、推定値から作る貪欲な方策の損失の評価、刻み幅の選び方、最大化の偏りなどの落とし穴を数値で示す。
定義と使える条件
記号は Markov決定過程 に合わせる。有限の状態の集合 $S$、状態ごとの行動の集合 $A(s)$、報酬 $r(s,a)$、推移確率 $p(\cdot\mid s,a)$、割引率 $\gamma\in[0,1)$ をもつ有限で割引のある Markov 決定過程を考え、最適価値関数を $v^*$ とする。状態と行動の組の集合を $\mathcal K:=\{(s,a):s\in S,\ a\in A(s)\}$ と置き、$Q\colon\mathcal K\to\mathbb R$ の全体を $\mathbb R^{\mathcal K}$、ノルムを $\|Q\|:=\max_{(s,a)\in\mathcal K}\lvert Q(s,a)\rvert$ とする。
$Q\in\mathbb R^{\mathcal K}$ について
$$
(HQ)(s,a):=r(s,a)+\gamma\sum_{y\in S}p(y\mid s,a)\max_{b\in A(y)}Q(y,b)
$$
と定める。$H$ を(行動価値の)Bellman 最適作用素 という。また
$$
Q^*(s,a):=r(s,a)+\gamma\sum_{y\in S}p(y\mid s,a)\,v^*(y)
$$
を 最適行動価値関数 という。$Q^*(s,a)$ は「$s$ で $a$ を選び、その後は最適に行動したときの価値」である。
- すべての $Q,Q'\in\mathbb R^{\mathcal K}$ で $\|HQ-HQ'\|\le\gamma\|Q-Q'\|$ である。
- $Q^*$ は $H$ のただ 1 つの不動点で、$v^*(s)=\max_{a\in A(s)}Q^*(s,a)$ である。
- 定常な方策 $\mu$ が $Q^*$ に関して貪欲(各 $s$ で $Q^*(s,\mu(s))=\max_aQ^*(s,a)$)なら、$\mu$ は最適方策である。
1:$\bigl\lvert\max_bQ(y,b)-\max_bQ'(y,b)\bigr\rvert\le\max_b\lvert Q(y,b)-Q'(y,b)\rvert\le\|Q-Q'\|$ と $\sum_yp(y\mid s,a)=1$ から従う。
2:$Q^*(s,a)$ は Markov決定過程 の記号で $Q_{v^*}(s,a)$ であり、同記事の定理「Bellman 方程式と最適方策」の (1)(3) から $v^*=Tv^*$、すなわち $\max_aQ^*(s,a)=v^*(s)$ である。これを $Q^*$ の定義に代入すると $HQ^*=Q^*$ を得る。$\mathbb R^{\mathcal K}$ はノルム $\|\cdot\|$ で完備で、1 から $H$ は縮小写像なので、Banachの不動点定理 により不動点はただ 1 つである。
3:$\mu$ が $Q^*$ に関して貪欲なら $T_\mu v^*=Tv^*$ で、$\mu$ は $v^*$ に関して貪欲である。同定理の (4) から $\mu$ は最適である。$\square$
したがって $Q^*$ が分かれば、各状態で $Q^*(s,\cdot)$ を最大にする行動を選ぶだけで最適に振る舞える。$v^*$ から最適な行動を選ぶには推移確率 $p$ が要るが、$Q^*$ からは要らない。これが、仕組みの分からない環境で $Q^*$ を推定する理由である。
学習者は時刻 $t=0,1,2,\dots$ に、それまでに観測したことに基づいて(乱数を使ってもよい)組 $(S_t,A_t)\in\mathcal K$ と刻み幅 $\alpha_t\in[0,1]$ を選び、環境から報酬 $R_t$ と次の状態 $S'_t$ を受け取る。$\mathcal F_t$ を、$(S_u,A_u,\alpha_u,R_u,S'_u)$($u< t$)と $(S_t,A_t,\alpha_t)$ が生成する $\sigma$ 加法族とし、環境は次を満たすとする。
$$
E[R_t\mid\mathcal F_t]=r(S_t,A_t),\qquad\lvert R_t\rvert\le\bar R,\qquad\Pr(S'_t=y\mid\mathcal F_t)=p(y\mid S_t,A_t)\quad(y\in S).
$$
報酬と推移を知らずに、この観測から最適方策を求める問題を 強化学習 の問題という。軌道に沿って学ぶときは $S_{t+1}=S'_t$ とする。
初期値 $Q_0\in\mathbb R^{\mathcal K}$ から
$$
Q_{t+1}(s,a)=\begin{cases}(1-\alpha_t)Q_t(s,a)+\alpha_t\Bigl(R_t+\gamma\max_{b\in A(S'_t)}Q_t(S'_t,b)\Bigr)&((s,a)=(S_t,A_t)),\\ Q_t(s,a)&(\text{それ以外})\end{cases}
$$
と更新する方法を $Q$ 学習(Q-learning)という。
括弧の中の $R_t+\gamma\max_bQ_t(S'_t,b)$ は $(HQ_t)(S_t,A_t)$ の 1 標本による推定で、$Q$ 学習は「1 成分ずつ、標本で近似した価値反復」である(SB18 §6.5、式 (6.8)、p. 131)。どの組を試すかを決める方策(行動方策)は何でもよく、学ぶ対象の最適方策と一致しなくてよい。
組 $(s,a)$ ごとの刻み幅を $\alpha_t(s,a):=\alpha_t\mathbf 1_{\{(S_t,A_t)=(s,a)\}}$ と置く。主定理の仮定は次のとおりである。
- (i) 割引率は $\gamma< 1$、報酬は有界($\lvert R_t\rvert\le\bar R$)である。
- (ii) どの組 $(s,a)\in\mathcal K$ も確率 1 で無限回選ばれ、$\sum_t\alpha_t(s,a)=\infty$ である。
- (iii) 定数 $K$ があり、確率 1 で、すべての $(s,a)$ について $\sum_t\alpha_t(s,a)^2\le K$ である。
たとえば組 $(s,a)$ を $n$ 回目に選んだときの刻みを $1/n$ や $1/n^{0.6}$ とすれば、(ii) の後半と (iii)($K=\sum_nn^{-2}$ や $\sum_nn^{-1.2}$)が成り立つ。(ii)(iii) は確率近似の Robbins–Monro の条件(SB18 式 (2.7)、p. 33)を、上界が乱数によらない形に少し強めたものである。
公式の表
| 場面 | 式 | 根拠 |
|---|---|---|
| 最適行動価値の方程式 | $Q^*=HQ^*$、$v^*(s)=\max_aQ^*(s,a)$ | lem-rl-qstar |
| $Q$ 学習の更新 | $Q(S_t,A_t)\leftarrow Q(S_t,A_t)+\alpha_t\bigl(R_t+\gamma\max_bQ(S'_t,b)-Q(S_t,A_t)\bigr)$ | def-rl-main |
| 刻み幅 | $n$ 回目に $1/n^\omega$($\frac12< \omega\le1$)なら (ii) の後半と (iii) を満たす。定数は (iii) を満たさない | thm-rl-qconv |
| 収束 | (i)〜(iii) のもとで $Q_t\to Q^*$(確率 1) | thm-rl-qconv |
| 貪欲な方策の損失 | $\|Q-Q^*\|\le\varepsilon$ なら $V^\mu\ge v^*-\frac{2\varepsilon}{1-\gamma}$ | prop-rl-greedy |
| 最適方策の取り出し | $\|Q-Q^*\|< \Delta/2$ なら貪欲な方策は最適($\Delta$ は最適でない行動の価値の差の最小) | prop-rl-greedy |
| 方策の価値の学習(TD(0)) | $V(S_t)\leftarrow V(S_t)+\alpha_t\bigl(R_t+\gamma V(S_{t+1})-V(S_t)\bigr)$ | SB18 §6.1、式 (6.2)、p. 120 |
主定理:$Q$ 学習の収束
def-rl-main の設定で (i)〜(iii) を仮定する。このとき、どの初期値 $Q_0$ についても、確率 1 で
$$
\lim_{t\to\infty}\|Q_t-Q^*\|=0
$$
である。さらに、すべての $t$ で $\|Q_t\|\le B:=\max\{\|Q_0\|,\ \bar R/(1-\gamma)\}$ が(確率 1 ではなく常に)成り立つ。
段 0(雑音の分離):組 $(s,a)$ について
$$
w_t(s,a):=\Bigl(R_t+\gamma\max_bQ_t(S'_t,b)-(HQ_t)(S_t,A_t)\Bigr)\mathbf 1_{\{(S_t,A_t)=(s,a)\}}
$$
と置くと、$Q$ 学習の更新はすべての組をまとめて
$$
Q_{t+1}(s,a)=\bigl(1-\alpha_t(s,a)\bigr)Q_t(s,a)+\alpha_t(s,a)\bigl((HQ_t)(s,a)+w_t(s,a)\bigr)\qquad(*)
$$
と書ける。$Q_t$ は時刻 $t-1$ までの観測で決まるので、$Q_t$ と $\alpha_t(s,a)$ は $\mathcal F_t$ 可測で、$w_t(s,a)$ は $\mathcal F_{t+1}$ 可測である。環境の仮定から $E[R_t\mid\mathcal F_t]=r(S_t,A_t)$、$E\bigl[\max_bQ_t(S'_t,b)\bigm|\mathcal F_t\bigr]=\sum_yp(y\mid S_t,A_t)\max_bQ_t(y,b)$ なので、$E[w_t(s,a)\mid\mathcal F_t]=0$ である。
段 1(有界性):$\|Q_t\|\le B$ を $t$ の帰納法で示す。更新される成分では、$\bar R+\gamma B\le B$ を使って
$$
\lvert Q_{t+1}(S_t,A_t)\rvert\le(1-\alpha_t)B+\alpha_t(\bar R+\gamma B)\le B
$$
である。また、(ii) からどの組 $(s,a)$ にも $(S_t,A_t)=(s,a)$ となる時刻があり、その事象の上で $r(s,a)=E[R_t\mid\mathcal F_t]$ なので $\lvert r(s,a)\rvert\le\bar R$ で、 $\|Q^*\|=\|HQ^*\|\le\bar R+\gamma\|Q^*\|$、すなわち $\|Q^*\|\le B$ である。よって $\|Q_t-Q^*\|\le2B$ で、$\lvert w_t(s,a)\rvert\le C:=2(\bar R+\gamma B)$ である。
段 2(雑音の寄与は消える):組 $(s,a)$ を固定し、$\alpha_t=\alpha_t(s,a)$、$w_t=w_t(s,a)$ と略す。値が非負の整数の時刻 $\tau$ について、$W^\tau_\tau=0$、$W^\tau_{t+1}=(1-\alpha_t)W^\tau_t+\alpha_tw_t$($t\ge\tau$)と定める。確率 1 の事象 $\Omega_0$ の上で、すべての $\tau$ について $W^\tau_t\to0$ となることを示す。
(a) $M_t:=\sum_{u< t}\alpha_uw_u$ と置く。段 0 から $E[\alpha_uw_u\mid\mathcal F_u]=\alpha_uE[w_u\mid\mathcal F_u]=0$ なので $(M_t)$ は マルチンゲール で、$u< v$ なら $E[\alpha_uw_u\alpha_vw_v]=E\bigl[\alpha_uw_u\,E[\alpha_vw_v\mid\mathcal F_v]\bigr]=0$ である。よって (iii) から
$$
E[M_t^2]=\sum_{u< t}E[\alpha_u^2w_u^2]\le C^2E\Bigl[\sum_u\alpha_u^2\Bigr]\le C^2K
$$
で、$E\lvert M_t\rvert\le C\sqrt K$ が $t$ によらず成り立つ。Doobのマルチンゲール収束定理 の定理「Doobのマルチンゲール収束定理」により、確率 1 で $M_t$ は有限の極限 $M_\infty$ に収束する。この事象と $\sum_t\alpha_t=\infty$ の事象((ii))の共通部分を $\Omega_0$ とする。以下 $\Omega_0$ の 1 点を固定し、決定的に議論する。
(b) $\tau=0$ の場合を $W_t:=W^0_t$ と書く。$U_t:=W_t-M_t+M_\infty$、$e_t:=M_\infty-M_t$ と置くと、代入して確かめられるとおり
$$
U_{t+1}=(1-\alpha_t)U_t+\alpha_te_t
$$
であり、$e_t\to0$ である。$\varepsilon>0$ について、$t\ge T$ で $\lvert e_t\rvert\le\varepsilon$ となる $T$ をとると、$t\ge T$ で $\lvert U_{t+1}\rvert-\varepsilon\le(1-\alpha_t)(\lvert U_t\rvert-\varepsilon)$ である。帰納法で
$$
\lvert U_t\rvert-\varepsilon\le\max\{\lvert U_T\rvert-\varepsilon,0\}\prod_{u=T}^{t-1}(1-\alpha_u)\le\max\{\lvert U_T\rvert-\varepsilon,0\}\exp\Bigl(-\sum_{u=T}^{t-1}\alpha_u\Bigr)\to0
$$
となり、$\limsup_t\lvert U_t\rvert\le\varepsilon$ である。$\varepsilon$ は任意なので $U_t\to0$、よって $W_t=U_t-e_t\to0$ である。
(c) 一般の $\tau$ では、$t\ge\tau$ について $W^\tau_t=W_t-\prod_{u=\tau}^{t-1}(1-\alpha_u)\,W_\tau$ である(両辺は $t=\tau$ で $0$、同じ漸化式を満たす)。積は (b) と同じく $0$ に収束するので $W^\tau_t\to0$ である。
段 3(誤差の包みを縮める):有限個の組について段 2 の事象の共通部分(確率 1)の 1 点を固定する。$\beta:=(1+\gamma)/2$ と置き、各 $k\ge0$ について「ある時刻 $T_k$ があり、$t\ge T_k$ なら $\|Q_t-Q^*\|\le D_k:=2B\beta^k$」を $k$ の帰納法で示す。$k=0$ は段 1 で $T_0=0$ とすればよい。
$k$ で成り立つとし、組 $(s,a)$ を固定する。$t\ge T_k$ について、$Y_{T_k}=D_k$、$Y_{t+1}=(1-\alpha_t(s,a))Y_t+\alpha_t(s,a)\gamma D_k$ と置き、段 2 の $W^{T_k}_t$ を $W_t$ と書く。このとき
$$
-Y_t+W_t\le Q_t(s,a)-Q^*(s,a)\le Y_t+W_t\qquad(t\ge T_k)
$$
である。実際 $t=T_k$ では $W_t=0$、$Y_t=D_k$ で成り立つ。$t$ で成り立てば、$Q^*=HQ^*$ と $(*)$ から
$$
Q_{t+1}(s,a)-Q^*(s,a)=(1-\alpha_t)\bigl(Q_t(s,a)-Q^*(s,a)\bigr)+\alpha_t\bigl((HQ_t-HQ^*)(s,a)+w_t\bigr)
$$
で、lem-rl-qstar の 1 から $\lvert(HQ_t-HQ^*)(s,a)\rvert\le\gamma\|Q_t-Q^*\|\le\gamma D_k$ である。$0\le\alpha_t\le1$ なので右辺は $(1-\alpha_t)(Y_t+W_t)+\alpha_t(\gamma D_k+w_t)=Y_{t+1}+W_{t+1}$ 以下、同様に $-Y_{t+1}+W_{t+1}$ 以上である。
$Y_t-\gamma D_k=\prod_{u=T_k}^{t-1}(1-\alpha_u(s,a))\,(1-\gamma)D_k\to0$((ii))、$W_t\to0$(段 2 の (c)。$T_k$ はいま固定した点で決まる整数)なので、$\limsup_t\lvert Q_t(s,a)-Q^*(s,a)\rvert\le\gamma D_k$ である。$B>0$ なら $\gamma D_k< \beta D_k=D_{k+1}$ で($B=0$ なら $Q_0=0$、$\bar R=0$ で、すべての $t$ で $Q_t=Q^*=0$ である)、組は有限個なので、ある $T_{k+1}$ から先で $\|Q_t-Q^*\|\le D_{k+1}$ となる。
$D_k\to0$ なので $\|Q_t-Q^*\|\to0$ である。$\square$
証明の骨格は、$(*)$ を「縮小写像 $H$ への 1 成分ずつの近づき」と「平均 0 の雑音」に分けることにある。雑音の寄与 $W$ は刻みの 2 乗和が有限なのでマルチンゲールの収束で消え、残りの決定的な部分 $Y$ は刻みの和が無限なので $\gamma D_k$ まで縮む。これを繰り返して包みの幅を $\beta^k$ 倍にしていく。
収束は、Watkins(1989)が $Q$ 学習を提案した後、Watkins と Dayan(1992)が限られた場合に、Tsitsiklis(1994)と Jaakkola・Jordan・Singh(1994)が一般の場合に示した(Sze10 §4.3.1 と脚注 15、pp. 56–57)。この記事の証明は Tsitsiklis の包み込みの方法を、(iii) の形の仮定に合わせて短くしたものである。
貪欲な方策の損失
$Q\in\mathbb R^{\mathcal K}$、$\varepsilon:=\|Q-Q^*\|$ とし、$\mu$ を $Q$ に関して貪欲な定常方策(各 $s$ で $Q(s,\mu(s))=\max_aQ(s,a)$)とする。このとき、$V^\mu$ を $\mu$ の価値関数として
$$
v^*(s)-\frac{2\varepsilon}{1-\gamma}\le V^\mu(s)\le v^*(s)\qquad(s\in S)
$$
である。また $\Delta:=\min\{v^*(s)-Q^*(s,a):(s,a)\in\mathcal K,\ Q^*(s,a)< v^*(s)\}$(最適でない行動がなければ $\Delta=\infty$)について $\varepsilon< \Delta/2$ なら、$\mu$ は最適方策である。
各 $s$ で、$a^*$ を $Q^*(s,\cdot)$ の最大点とすると
$$
Q^*(s,\mu(s))\ge Q(s,\mu(s))-\varepsilon\ge Q(s,a^*)-\varepsilon\ge Q^*(s,a^*)-2\varepsilon=v^*(s)-2\varepsilon
$$
である。$Q^*(s,\mu(s))=(T_\mu v^*)(s)$ なので $T_\mu v^*\ge v^*-2\varepsilon\mathbf 1$。$V^\mu=T_\mu V^\mu$ と、$T_\mu v-T_\mu w=\gamma P_\mu(v-w)$($P_\mu$ は推移行列)から
$$
v^*-V^\mu=(v^*-T_\mu v^*)+\gamma P_\mu(v^*-V^\mu)\le2\varepsilon\mathbf 1+\gamma\delta\mathbf 1,\qquad\delta:=\max_s\bigl(v^*(s)-V^\mu(s)\bigr)
$$
となり、最大をとって $\delta\le2\varepsilon+\gamma\delta$、すなわち $\delta\le2\varepsilon/(1-\gamma)$ である。$V^\mu\le v^*$ は Markov決定過程 の定理「Bellman 方程式と最適方策」の (2) による。後半:$\varepsilon< \Delta/2$ なら上の不等式から $Q^*(s,\mu(s))\ge v^*(s)-2\varepsilon> v^*(s)-\Delta$ で、$\Delta$ の定義から $Q^*(s,\mu(s))=v^*(s)$ である。$\mu$ は $Q^*$ に関して貪欲なので、lem-rl-qstar の 3 から最適である。$\square$
$\Delta$ は有限の問題では正なので、thm-rl-qconv と合わせると、確率 1 で、ある時刻から先は $Q_t$ に関する貪欲な方策が最適方策になる。前半の評価は Singh と Yee によるものとして知られている(Sze10 式 (16)、p. 17)。
計算の手順
- 問題を書く:状態・行動・報酬・割引率を決める。報酬が有界で $\gamma< 1$ であることを確かめる(条件 (i))。
- 行動方策を決める:どの組も無限回試されるようにする(条件 (ii))。確率 $\varepsilon$ で一様に、残りで $Q_t$ に関して貪欲に選ぶ $\varepsilon$ 貪欲法がよく使われる。完全に貪欲に選ぶと (ii) が満たされないことがある(反例の表の 3 行目)。
- 刻み幅を決める:組ごとの訪問回数 $n$ について $1/n^\omega$($\frac12< \omega\le1$)にする。$\omega=1$ は $\gamma$ が 1 に近いと極端に遅い(ex-rl-learning)。
- 更新する:観測 $(S_t,A_t,R_t,S'_t)$ ごとに def-rl-main の式で 1 成分だけ更新する。
- 方策を取り出す:$Q_t$ に関して貪欲な方策を使う。損失は prop-rl-greedy で見積もる。
- 確かめる:小さな問題では $Q^*$ を価値反復か方策の列挙で求め、$\|Q_t-Q^*\|$ を見る。
例題
状態は 1, 2、行動は「留まる」「移る」、$\gamma=0.9$ とする。状態 1 で留まると報酬 1 で状態 1 のまま、移ると報酬 0 で状態 2 へ行く。状態 2 で留まると報酬 2 で、確率 0.8 で状態 2 のまま、0.2 で状態 1 へ戻る。移ると報酬 0 で状態 1 へ行く。$Q^*$ と最適方策を求める。使う公式:lem-rl-qstar。
答え:最適方策は「1 では移る、2 では留まる」で、$v^*=(900/59,\ 1000/59)\approx(15.2542,\ 16.9492)$、
$$
Q^*(1,\text{留まる})=\tfrac{869}{59}\approx14.7288,\quad Q^*(1,\text{移る})=\tfrac{900}{59},\quad Q^*(2,\text{留まる})=\tfrac{1000}{59},\quad Q^*(2,\text{移る})=\tfrac{810}{59}\approx13.7288
$$
である。最適でない行動との差の最小は $\Delta=31/59\approx0.525$ である。
途中の計算を開く
方策「1 で移る、2 で留まる」の価値は $V(1)=0.9V(2)$、$V(2)=2+0.9(0.8V(2)+0.2V(1))$ を解いて $V(2)=2/0.118=1000/59$、$V(1)=900/59$。これを $v$ として $Q_v(s,a)=r(s,a)+0.9\sum_yp(y\mid s,a)v(y)$ を計算すると上の値になり、各状態で最大は採った行動なので $v=Tv$、すなわち $v=v^*$ である(Markov決定過程 の定理「Bellman 方程式と最適方策」)。ほかの 3 つの定常方策の価値は $(10,\ 95/7)$、$(10,\ 9)$、$(0,0)$ でどれも小さい。価値反復を 400 回行った値とも $10^{-14}$ 以内で一致する。
ex-rl-two の問題で、軌道に沿い、各時刻に行動を確率 $\frac12$ ずつ選んで $Q$ 学習を行う($Q_0=0$、状態 1 から出発)。使う公式:thm-rl-qconv、prop-rl-greedy。
答え:ある乱数の列での $\|Q_t-Q^*\|$ は次のとおりである。
| 刻み幅 | $t=10^3$ | $t=10^4$ | $t=10^5$ | $t=10^6$ |
|---|---|---|---|---|
| $1/n$ | 8.904 | 7.105 | 5.647 | 4.487 |
| $1/n^{0.6}$ | 2.082 | 0.0751 | 0.0186 | 0.00629 |
| 定数 $0.1$ | 1.217 | 0.249 | 0.432 | 0.291 |
$1/n^{0.6}$ では $t=10^4$ で誤差が $\Delta/2\approx0.263$ を下回り、prop-rl-greedy により貪欲な方策は最適である。$1/n$ も定理の仮定を満たすが、$10^6$ 歩でも誤差は 4 を超える。定数の刻みは誤差が $0.2$〜$0.5$ の間で揺れ続け、下がらない。
行動方策が (ii) を満たす理由を開く
どちらの状態からでも、次の状態が 1 になる確率は $0.5$ 以上(状態 1 から $\frac12$、状態 2 から $\frac12\cdot0.2+\frac12=0.6$)、2 になる確率は $0.4$ 以上($\frac12$ と $\frac12\cdot0.8$)である。行動はそのつど独立に確率 $\frac12$ で選ぶので、過去がどうであっても、次の時刻の組が指定した $(s,a)$ になる条件付き確率は $0.4\cdot\frac12=0.2$ 以上である。よって時刻 $m$ から $k$ 歩続けて $(s,a)$ を避ける確率は $0.8^k$ 以下で、$k\to\infty$ として、どの $m$ の後にも確率 1 で $(s,a)$ が現れる。すなわち各組は確率 1 で無限回選ばれる。$10^6$ 歩での各組の回数は 27 万、27 万、23 万、23 万回だった。
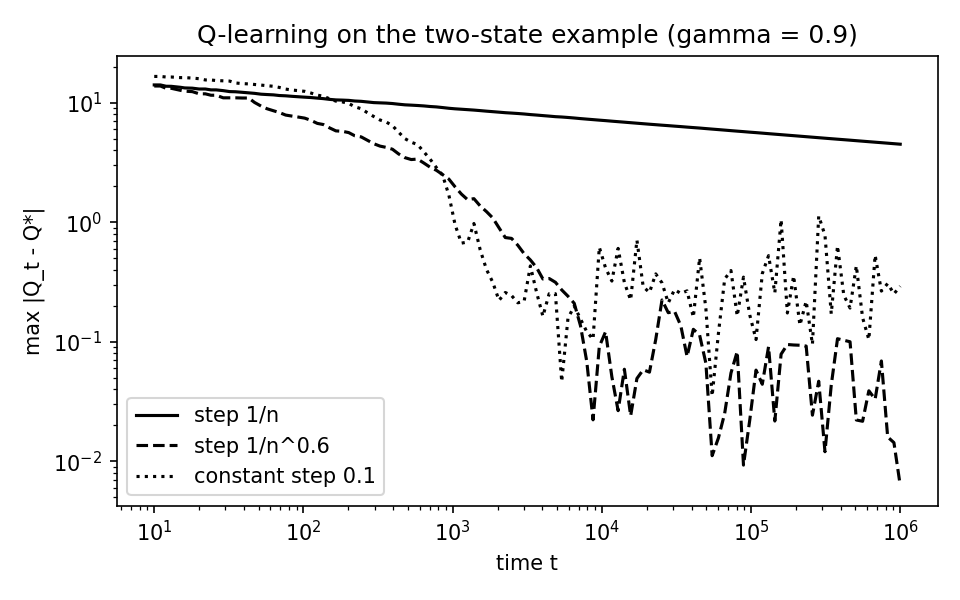 図: 例題 [ex-rl-learning] の誤差 max|Q_t − Q*| を時刻 t に対して両対数で描いたもの。実線は刻み 1/n、破線は 1/n^0.6、点線は定数 0.1。1/n はゆっくりとしか下がらず、定数 0.1 は 0.1〜1 の間で揺れ続け、1/n^0.6 は 10^6 歩で 0.01 を下回る。
1 つの状態に行動が 2 つあり、どちらの報酬も $+1$ と $-1$ を確率 $\frac12$ ずつとる(真の価値はともに $0$)。各行動を 1 回ずつ試した標本 $X_1,X_2$ の最大 $\max\{X_1,X_2\}$ で「最良の行動の価値」を推定するとき、その期待値を求める。使う公式:$Q$ 学習の更新の $\max_bQ_t(S'_t,b)$。
答え:$\max\{X_1,X_2\}=-1$ となるのは両方が $-1$ の確率 $\frac14$ のときだけなので、$E[\max\{X_1,X_2\}]=\frac34-\frac14=\frac12$ で、真の値 $0$ より大きい。行動が 10 個で報酬が平均 $-0.1$、分散 1 の正規分布なら、標本の最大の期待値は約 $1.439$ にもなる。別の独立な標本で、最大を与えた行動を評価し直すと(二重学習)、期待値は真の値(最初の例では $0$、正規分布の例では $-0.1$)になる(SB18 §6.7、pp. 134–136)。
使える条件と反例
各行は thm-rl-qconv の仮定を 1 つだけ外し、ほかの仮定は満たされている。ただし 3 行目では、選ばれない組について (ii) の後半も満たされない(前半を外すと避けられない)。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| (ii) の後半 $\sum_t\alpha_t=\infty$ | 状態 1 つ・行動 1 つ、報酬は常に 1、$\gamma=\frac12$、$n$ 回目の刻み $1/n^2$、$Q_0=0$ | $Q^*=2$ だが $Q_t\to2-\frac{2\sin(\pi/\sqrt2)}{\pi/\sqrt2}\approx1.2836$ |
| (iii) 刻みの 2 乗和の上界 | 状態 1 つ・行動 1 つ、報酬は $\pm1$ を半々、$\gamma=0$、刻みは定数 $0.1$ | $Q^*=0$ だが $Q_t$ は収束せず、$E[Q_t^2]\to\frac{0.1}{1.9}\approx0.0526$ |
| (ii) の前半(無限回選ぶ) | ex-rl-two で状態 1 から出発し、$Q_t$ に関して完全に貪欲に選ぶ(同点は「留まる」)、$Q_0=0$、刻み $1/n$ | 状態 1 で留まり続け、$Q_t(1,\text{留まる})\to10\ne Q^*(1,\text{留まる})\approx14.73$。貪欲な方策の価値は $10< v^*(1)$ |
| (i) の $\gamma< 1$ | 状態 1 つ・行動 1 つ、報酬は常に 1、$\gamma=1$、刻み $1/n$ | $Q=HQ$ すなわち $Q=1+Q$ に解がなく、$Q_n=1+\frac12+\dots+\frac1n\to\infty$ |
反例の確かめを開く
1 行目:$Q_1=1$ で、誤差 $e_n=2-Q_n$ は $e_n=(1-\frac1{2n^2})e_{n-1}$ を満たす。$\frac{\sin\pi x}{\pi x}=\prod_{k\ge1}(1-\frac{x^2}{k^2})$ に $x^2=\frac12$ を入れると $e_\infty=\prod_{k\ge2}(1-\frac1{2k^2})=2\frac{\sin(\pi/\sqrt2)}{\pi/\sqrt2}\approx0.7164$。2 行目:$Q_{t+1}=0.9Q_t+0.1R_t$ から $E[Q_{t+1}^2]=0.81E[Q_t^2]+0.01$ で、極限は $0.01/0.19$。$E[Q_t^2]$ が正の値に収束するので、$Q_t$ は $0$ に確率 1 で収束しない(有界なので、収束すれば有界収束定理で $E[Q_t^2]\to0$ となる)。さらに、ある道で $Q_t$ が収束すれば $R_t=Q_t+10(Q_{t+1}-Q_t)$ も収束するが、$R_t$ は確率 1 で $+1$ と $-1$ を無限回ずつとるので、確率 1 で $Q_t$ はどの値にも収束しない。刻み $1/n$ なら $Q_t$ は報酬の標本平均で、$0$ に収束する。3 行目:$Q(1,\text{留まる})> 0=Q(1,\text{移る})$ が初回から保たれ、状態 2 には行かない。$Q_n(1,\text{留まる})$ は $Q_n=Q_{n-1}+\frac1n(1-0.1Q_{n-1})$ で、$10-Q_n=(1-\frac{0.1}n)(10-Q_{n-1})\to0$。4 行目:$Q_n=Q_{n-1}+\frac1n$。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 刻み $1/n$ なら実用上も十分速い | $1/n^\omega$($\omega< 1$)や調整した刻みを使う | ex-rl-learning で $10^6$ 歩でも誤差 4.5。仮定を満たす刻みは遅いことが多い(SB18 §2.5、p. 33) |
| 定数の刻みでも最後は $Q^*$ に収束する | 平均 $Q^*$ の近くで揺れ続ける | 反例の表の 2 行目 |
| 貪欲に行動すれば効率よく学べる | 探索を混ぜる($\varepsilon$ 貪欲法など) | 反例の表の 3 行目 |
| $\max_bQ_t$ は最良の価値の偏りのない推定 | 上向きの偏りがある。二重学習で減らせる | ex-rl-maxbias |
| 関数近似(線形の特徴など)と組み合わせても収束する | 発散する例がある | 方策外の学習・関数近似・ブートストラップが重なると不安定になる(SB18 §11.2–11.3、pp. 260–264) |
補足
$Q$ 学習のように、学ぶ対象の方策(最適方策)と行動方策が違う方法を 方策外(off-policy)、同じものを 方策上(on-policy)という。方策上の代表は、$\max_bQ(S',b)$ の代わりに実際に次に選んだ行動 $A'$ の $Q(S',A')$ を使う Sarsa である(SB18 §6.4、p. 129)。
この記事は状態と行動が有限で、表で $Q$ を持てる場合に限った。状態が多い問題では $Q$ を関数で近似し、方策そのものを助変数で表して勾配で改善する方法(方策勾配法)も使われるが、収束の保証は表の場合よりずっと弱く、この記事では扱わない。試行の中で得る報酬の和を大きくすることを重視する問題、たとえば状態が 1 つの多腕バンディット問題では、探索と活用の釣り合いが主題になる。
関連項目
- 前提: Markov決定過程, Banachの不動点定理
- 理論: Doobのマルチンゲール収束定理, マルチンゲール
- 比較: 動的計画法
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

