誤差逆伝播法
概要
誤差逆伝播法(backpropagation)とは、ニューラルネットワークの損失のすべてのパラメータについての偏微分を、連鎖律を出力の側から入力の側へ順に当てて計算する方法である。順伝播で途中の値を保存したあと、各層の値についての損失の偏微分(誤差)を、重みの転置を掛けて活性化関数の微分を掛ける漸化式で出力から入力へ 1 層ずつ求め、各重みの偏微分を誤差とその層の入力の積として得る。演算は順伝播の 2 倍以下で、パラメータごとに差分をとる方法よりはるかに速く、一般の計算グラフの逆向きの自動微分の特別な場合にあたる。
前提知識: 合成関数の微分法, ニューラルネットワーク, Jacobi行列
誤差逆伝播法(backpropagation)は、ニューラルネットワーク の損失をすべてのパラメータについて偏微分した値(勾配)を、合成関数の微分法(連鎖律)を出力の側から入力の側へ順に当てて計算する方法である。ネットワークの値を入力から出力へ計算する 順伝播 で途中の値を保存し、そのあと各層の「損失の、その層の値についての偏微分」(誤差)を出力から入力へ向かって 1 層ずつ計算する(逆伝播)。各パラメータの偏微分は、その誤差と保存した値の積で得られる。
パラメータが $P$ 個あるとき、偏微分を 1 個ずつ差分で近似すると順伝播が約 $2P$ 回要る。誤差逆伝播法は順伝播 1 回と、その 2 倍以下の演算の逆伝播 1 回で、$P$ 個すべての偏微分を正確に(丸め誤差を除いて)計算する。これが、パラメータが数百万を超えるネットワークを 確率的勾配降下法 で学習できる理由である。
この記事では、層の形のネットワークについて逆伝播の公式とその正しさ(主定理)、演算回数の評価を証明し、一般の計算グラフの逆向きの微分(逆向きの自動微分)に一般化する。微分できない活性化関数や閉路のあるグラフで公式が壊れる例も示す。
定義と使える条件
記号は ニューラルネットワーク の定義「順伝播型ニューラルネットワーク」に合わせる:構造 $(n_0,\dots,n_L)$、活性化関数 $\sigma$、パラメータ $\theta=(W^{(1)},b^{(1)},\dots,W^{(L)},b^{(L)})$ について
$$
x^{(0)}=x,\qquad z^{(\ell)}=W^{(\ell)}x^{(\ell-1)}+b^{(\ell)},\qquad x^{(\ell)}=\sigma(z^{(\ell)})\ (\ell< L),\qquad\hat y=z^{(L)}
$$
である。ベクトルは縦ベクトル、$\sigma$ や $\sigma'$ は成分ごとに施し、$u\odot v$ は成分ごとの積、$A^{\mathsf T}$ は 転置行列 である。
データ $(x,y)$ と 損失関数 $\operatorname{loss}(\hat y,y)$($\hat y\in\mathbb{R}^{n_L}$ の関数)を固定し、$E(\theta):=\operatorname{loss}(f_\theta(x),y)$ とおく。$\ell=L,L-1,\dots,1$ について、$z^{(\ell)}$ を変数とみて、それより後の計算(パラメータは固定)で $E$ を表した関数を $E_\ell$ とする:
$$
E_L(z):=\operatorname{loss}(z,y),\qquad E_\ell(z):=E_{\ell+1}\bigl(W^{(\ell+1)}\sigma(z)+b^{(\ell+1)}\bigr)\quad(1\le\ell\le L-1).
$$
実際の値 $z^{(\ell)}$ での勾配 $\delta^{(\ell)}:=\nabla E_\ell(z^{(\ell)})\in\mathbb{R}^{n_\ell}$ を、第 $\ell$ 層の 誤差 という。$\delta^{(\ell)}_i$ は「$z^{(\ell)}_i$ だけを少し動かしたときの損失の変化率」である。
誤差逆伝播法を使う条件をまとめる。
- 微分可能性:$\sigma$ は実際に現れる値 $z^{(\ell)}_i$($\ell< L$)のすべてで微分可能、$\operatorname{loss}(\cdot,y)$ は $\hat y=z^{(L)}$ で微分可能である。
- 計算の順序:値は入力から出力へ一方向に流れる(計算グラフに閉路がない)。
- 出力:損失 $E$ は実数(1 次元)である。出力が多次元の写像の Jacobi 行列を求めるときは、出力の次元の回数だけ逆伝播を繰り返す。
公式の表
| 量 | 式 | 条件 | 根拠 |
|---|---|---|---|
| 出力層の誤差(2 乗誤差) | $\delta^{(L)}=\hat y-y$ | $\operatorname{loss}=\frac12\|\hat y-y\|^2$ | thm-bp-main の 1 |
| 出力層の誤差(softmax と交差エントロピー) | $\delta^{(L)}=p-e_y$、$p_k=\dfrac{e^{\hat y_k}}{\sum_je^{\hat y_j}}$ | $\operatorname{loss}=-\log p_y$、$y\in\{1,\dots,n_L\}$ | prop-bp-softmax |
| 出力層の誤差(ロジスティック関数と 2 値の交差エントロピー) | $\delta^{(L)}=\varsigma(\hat y)-y$ | $n_L=1$、$y\in\{0,1\}$、$\operatorname{loss}=-y\log\varsigma(\hat y)-(1-y)\log(1-\varsigma(\hat y))$ | prop-bp-softmax |
| 誤差の漸化式 | $\delta^{(\ell)}=\sigma'(z^{(\ell)})\odot\bigl(W^{(\ell+1)}\bigr)^{\mathsf T}\delta^{(\ell+1)}$ | $1\le\ell\le L-1$ | thm-bp-main の 2 |
| 重みの偏微分 | $\dfrac{\partial E}{\partial W^{(\ell)}_{ij}}=\delta^{(\ell)}_i\,x^{(\ell-1)}_j$、行列で $\delta^{(\ell)}\bigl(x^{(\ell-1)}\bigr)^{\mathsf T}$ | $1\le\ell\le L$ | thm-bp-main の 3 |
| 偏りの偏微分 | $\dfrac{\partial E}{\partial b^{(\ell)}}=\delta^{(\ell)}$ | $1\le\ell\le L$ | thm-bp-main の 3 |
| 入力についての偏微分 | $\nabla_xE=\bigl(W^{(1)}\bigr)^{\mathsf T}\delta^{(1)}$ | — | thm-bp-main の証明と同じ |
| 活性化関数の微分 | ReLU:$H(t)$($t\ne0$)、$\varsigma'=\varsigma(1-\varsigma)$、$\tanh'=1-\tanh^2$ | ReLU は $t=0$ で微分できない。$\tanh'$ と ReLU の微分は定義からの直接の計算(右の表にあるのは $\varsigma'$) | ニューラルネットワーク の公式の表 |
| 演算回数 | 逆伝播 $\le2\times$ 順伝播 | 掛け算と活性化関数・導関数の評価を 1 回と数える | thm-bp-cost |
| 誤差の大きさ(ロジスティック関数) | $\|\delta^{(\ell)}\|\le4^{-(L-\ell)}\prod_{k=\ell+1}^L\|W^{(k)}\|\,\|\delta^{(L)}\|$ | $\|W\|$ は作用素ノルム | prop-bp-vanishing |
| Jacobi 行列($\mathbb{R}^n\to\mathbb{R}^m$) | 前向きは $n$ 回、逆向きは $m$ 回の掃引 | 1 回の掃引は元の計算の定数倍 | 証明しない:BPRS18 §3.2(p. 13) |
主定理と証明
条件 1 の下で、$E_\ell$ は $z^{(\ell)}$ で微分可能であり、次が成り立つ。
- $\delta^{(L)}=\nabla_{\hat y}\operatorname{loss}(\hat y,y)\big|_{\hat y=z^{(L)}}$。
- $1\le\ell\le L-1$ について $\delta^{(\ell)}=\sigma'(z^{(\ell)})\odot\bigl(W^{(\ell+1)}\bigr)^{\mathsf T}\delta^{(\ell+1)}$。
- $1\le\ell\le L$ について $\dfrac{\partial E}{\partial W^{(\ell)}_{ij}}=\delta^{(\ell)}_i\,x^{(\ell-1)}_j$、$\dfrac{\partial E}{\partial b^{(\ell)}_i}=\delta^{(\ell)}_i$。
1 は定義そのものである。
2:$S(z):=\sigma(z)$(成分ごと)とおく。$S$ の第 $i$ 成分は $z_i$ だけの関数 $\sigma(z_i)$ で、条件 1 からそれぞれ $z^{(\ell)}_i$ で微分可能なので、$S$ は $z^{(\ell)}$ で微分可能で、その微分は対角行列 $\operatorname{diag}(\sigma'(z^{(\ell)}))$ である(合成関数の微分法 の命題「微分の行列成分と偏微分係数」)。$A(u):=W^{(\ell+1)}u+b^{(\ell+1)}$ はアフィンで微分は $W^{(\ell+1)}$ である。$E_\ell=E_{\ell+1}\circ A\circ S$ で、$A(S(z^{(\ell)}))=z^{(\ell+1)}$ である。$\ell$ についての下向きの帰納法で $E_{\ell+1}$ は $z^{(\ell+1)}$ で微分可能としてよい($\ell+1=L$ なら条件 1)。合成関数の微分法 の定理「多変数の連鎖律」から $E_\ell$ は $z^{(\ell)}$ で微分可能で、微分($1\times n_\ell$ 行列)は
$$
DE_\ell(z^{(\ell)})=DE_{\ell+1}(z^{(\ell+1)})\;W^{(\ell+1)}\;\operatorname{diag}\bigl(\sigma'(z^{(\ell)})\bigr)
$$
である。勾配は微分の転置なので $\delta^{(\ell)}=\operatorname{diag}(\sigma'(z^{(\ell)}))\,(W^{(\ell+1)})^{\mathsf T}\delta^{(\ell+1)}$ で、対角行列を掛けることは成分ごとの積なので主張を得る。
3:$W^{(\ell)}$ 以外のパラメータを固定すると、$x^{(\ell-1)}$ は $W^{(\ell)}$ によらず($\ell$ 層より前の計算だけで決まる)、$E=E_\ell(W^{(\ell)}x^{(\ell-1)}+b^{(\ell)})$ である。$W^{(\ell)}_{ij}$ を動かすと $z^{(\ell)}$ のうち第 $i$ 成分だけが変化率 $x^{(\ell-1)}_j$ で変わるので、連鎖律から $\partial E/\partial W^{(\ell)}_{ij}=\delta^{(\ell)}_i x^{(\ell-1)}_j$ である。$b^{(\ell)}_i$ についても変化率が $1$ なので $\delta^{(\ell)}_i$ である。$\square$
公式は、損失の勾配が「出力側の誤差を重みの転置で逆向きに送り、活性化関数の微分を掛ける」ことで得られることを示している。順伝播が $W$ を掛けて $\sigma$ を施すのと、ちょうど逆の順序で転置をとった操作である。
掛け算 1 回、活性化関数の値 1 回、その導関数の値 1 回をそれぞれ 1 回の演算と数え(足し算は数えない)、$M:=\sum_{\ell=1}^Ln_\ell n_{\ell-1}$、$U:=\sum_{\ell=1}^{L-1}n_\ell$ とおく。
- 順伝播の演算は $M+U$ 回である。
- 順伝播で $z^{(\ell)}$、$x^{(\ell)}$ を保存し $\delta^{(L)}$ が与えられれば、thm-bp-main の公式によるすべての誤差と偏微分の計算の演算は $2M-n_1n_0+2U$ 回であり、これは順伝播の 2 倍以下である。
1:$W^{(\ell)}x^{(\ell-1)}$ は掛け算 $n_\ell n_{\ell-1}$ 回で、$\ell=1,\dots,L$ で足して $M$ 回。活性化関数は $\ell< L$ の各層で $n_\ell$ 回、合わせて $U$ 回である。
2:$\ell=L-1,\dots,1$ について、$(W^{(\ell+1)})^{\mathsf T}\delta^{(\ell+1)}$ は掛け算 $n_{\ell+1}n_\ell$ 回、$\sigma'(z^{(\ell)})$ の評価が $n_\ell$ 回、成分ごとの積が $n_\ell$ 回である。足すと $\sum_{\ell=1}^{L-1}n_{\ell+1}n_\ell+2U=(M-n_1n_0)+2U$ 回である。重みの偏微分 $\delta^{(\ell)}_ix^{(\ell-1)}_j$ は全部で $M$ 回の掛け算で、偏りの偏微分は $\delta^{(\ell)}$ そのものなので演算は要らない。合計は $2M-n_1n_0+2U\le2(M+U)$ である。$\square$
偏微分を差分で 1 個ずつ求めると、中心差分ではパラメータ $P=\sum_\ell n_\ell(n_{\ell-1}+1)$ 個について順伝播が $2P$ 回要り、演算は $2P(M+U)$ 回の程度になる。$P$ は $M$ と同じ程度の大きさなので、差分の方法は逆伝播より $P$ 倍の程度遅い。
出力層の誤差と誤差の大きさ
- $p_k(z):=e^{z_k}/\sum_je^{z_j}$($z\in\mathbb{R}^m$)、$\operatorname{loss}(z,y):=-\log p_y(z)$ とすると $\nabla_z\operatorname{loss}=p(z)-e_y$($e_y$ は第 $y$ 成分だけが $1$ の単位ベクトル)。
- $z\in\mathbb{R}$、$y\in\{0,1\}$、$\operatorname{loss}(z,y):=-y\log\varsigma(z)-(1-y)\log(1-\varsigma(z))$ とすると $\frac{d}{dz}\operatorname{loss}=\varsigma(z)-y$。
計算を開く
1:$\operatorname{loss}=-z_y+\log\sum_je^{z_j}$ なので、$[k=y]$ を $k=y$ のとき $1$、それ以外で $0$ として $\partial\operatorname{loss}/\partial z_k=-[k=y]+e^{z_k}/\sum_je^{z_j}=p_k-[k=y]$。2:$\log\varsigma(z)=-\log(1+e^{-z})$ の微分は $1-\varsigma(z)$、$\log(1-\varsigma(z))=-z-\log(1+e^{-z})$ の微分は $-\varsigma(z)$ なので、微分は $-y(1-\varsigma)+(1-y)\varsigma=\varsigma-y$。$\square$
どちらの場合も、出力層の誤差は「予測した確率 $-$ 正解」になる。2 乗誤差の $\hat y-y$ と同じ形で、出力の活性化関数の微分が損失の微分と打ち消し合うためである。
活性化関数がロジスティック関数 $\varsigma$ のとき、$\|\cdot\|$ を Euclid ノルムと作用素ノルムとして
$$
\|\delta^{(\ell)}\|\le4^{-(L-\ell)}\prod_{k=\ell+1}^L\|W^{(k)}\|\;\|\delta^{(L)}\|\qquad(1\le\ell\le L)
$$
である。
$0<\varsigma'\le\frac14$(ニューラルネットワーク の公式の表)なので $\|\varsigma'(z)\odot v\|\le\frac14\|v\|$、また $\|(W^{(\ell+1)})^{\mathsf T}\delta\|\le\|W^{(\ell+1)}\|\,\|\delta\|$(転置の作用素ノルムは同じ)である。thm-bp-main の 2 から $\|\delta^{(\ell)}\|\le\frac14\|W^{(\ell+1)}\|\,\|\delta^{(\ell+1)}\|$ で、これを $\ell+1,\dots,L$ と繰り返せばよい。$\square$
重みの作用素ノルムが $4$ より小さい層が続くと、入力に近い層の誤差は層の数について指数的に小さくなり、そこのパラメータはほとんど更新されない。これを 勾配消失 という。ReLU では $\rho'\in\{0,1\}$ なので、この $\frac14$ の因子は現れない。
一般の計算グラフ
ネットワークに限らず、関数を「入力 $v_1,\dots,v_n$ から、前に計算した値の関数として $v_{n+1},v_{n+2},\dots,v_N$ を順に計算する」手順で書けば、同じ考え方で勾配が得られる。これを 逆向きの自動微分(リバースモード)といい、誤差逆伝播法はその特別な場合である。
$i=n+1,\dots,N$ について、添字の集合 $\operatorname{pa}(i)\subset\{1,\dots,i-1\}$ と関数 $\varphi_i$ により $v_i=\varphi_i\bigl((v_j)_{j\in\operatorname{pa}(i)}\bigr)$ と計算し、$f(v_1,\dots,v_n):=v_N$ とする。点 $a=(a_1,\dots,a_n)$ で計算した値を $a_{n+1},\dots,a_N$ とし、各 $\varphi_i$ は $(a_j)_{j\in\operatorname{pa}(i)}$ のまわりの開集合で定義され、そこで微分可能とする。次の手順で $\bar v_1,\dots,\bar v_N$ を計算する。
- $\bar v_N:=1$、ほかは $\bar v_k:=0$ とする。
- $i=N,N-1,\dots,n+1$ の順に、各 $j\in\operatorname{pa}(i)$ について $\bar v_j\leftarrow\bar v_j+\bar v_i\,\dfrac{\partial\varphi_i}{\partial v_j}$(偏微分は実際の値での値)とする。
このとき、終わった時点で $\bar v_j=\dfrac{\partial f}{\partial v_j}(a)$($1\le j\le n$)である。演算は、辺 $(j,i)$($j\in\operatorname{pa}(i)$)ごとに偏微分の評価 1 回と掛け算 1 回である。
証明を開く
$F_N(v_1,\dots,v_N):=v_N$、$F_{i-1}(v_1,\dots,v_{i-1}):=F_i\bigl(v_1,\dots,v_{i-1},\varphi_i((v_j)_{j\in\operatorname{pa}(i)})\bigr)$($i>n$)と定める。$F_{i-1}$ は「$v_1,\dots,v_{i-1}$ を与えて残りを計算したときの出力」で、$F_n=f$ である。$F_{i-1}=F_i\circ\Psi_i$、$\Psi_i(v_1,\dots,v_{i-1}):=(v_1,\dots,v_{i-1},\varphi_i(\dots))$ で、$\Psi_i(a_1,\dots,a_{i-1})=(a_1,\dots,a_i)$ である。$F_N$ は線形なので、$i$ についての下向きの帰納法と 合成関数の微分法 の定理「多変数の連鎖律」により、どの $F_i$ も $(a_1,\dots,a_i)$ で微分可能で、$k\le i-1$ について
$$\frac{\partial F_{i-1}}{\partial v_k}=\frac{\partial F_i}{\partial v_k}+\frac{\partial F_i}{\partial v_i}\cdot\frac{\partial\varphi_i}{\partial v_k}$$
($k\notin\operatorname{pa}(i)$ なら第 2 項は $0$)である。手順 2 で $i$ を処理する直前には $\bar v_k=\partial F_i/\partial v_k$($k\le i$)が成り立っている、と帰納法で示す。最初($i=N$)は $\partial F_N/\partial v_k=[k=N]$ で正しい。$i$ の処理では $\bar v_i=\partial F_i/\partial v_i$ を使って、$j\in\operatorname{pa}(i)$ に上の式の第 2 項を足すので、処理の後は $\bar v_k=\partial F_{i-1}/\partial v_k$($k\le i-1$)となる。$i=n+1$ を処理し終えると $\bar v_j=\partial F_n/\partial v_j=\partial f/\partial v_j$ である。演算の数は手順 2 の形から明らかである。$\square$
層の形のネットワークでは、$v$ を $z^{(\ell)}_i$、$x^{(\ell)}_i$ とパラメータの成分にとれば、手順 2 は thm-bp-main の漸化式そのものになる。$\bar v$ が「出力の、その値についての偏微分」であることが、各値が後でいくつの場所で使われても足し合わせればよい理由である(ex-bp-graph の $v_3$)。
計算の手順
1 個のデータ $(x,y)$ についての勾配の計算は次のとおりである。
- 順伝播:$x^{(0)}=x$ から $z^{(\ell)}=W^{(\ell)}x^{(\ell-1)}+b^{(\ell)}$、$x^{(\ell)}=\sigma(z^{(\ell)})$ を $\ell=1,\dots,L$ の順に計算し、すべての $z^{(\ell)}$、$x^{(\ell)}$ を保存する。$\hat y=z^{(L)}$ と損失を計算する。
- 出力層の誤差:$\delta^{(L)}=\nabla_{\hat y}\operatorname{loss}$ を公式の表から求める(2 乗誤差なら $\hat y-y$)。
- 逆伝播:$\ell=L-1,\dots,1$ の順に $\delta^{(\ell)}=\sigma'(z^{(\ell)})\odot(W^{(\ell+1)})^{\mathsf T}\delta^{(\ell+1)}$。
- 偏微分:$\partial E/\partial W^{(\ell)}=\delta^{(\ell)}(x^{(\ell-1)})^{\mathsf T}$、$\partial E/\partial b^{(\ell)}=\delta^{(\ell)}$。
- 確かめ:実装したら、いくつかの成分を中心差分 $\frac{E(\theta+he)-E(\theta-he)}{2h}$($h\approx10^{-6}$ 程度)と比べる。
$N$ 個のデータの平均の損失の勾配は、各データの勾配の平均である。確率的勾配降下法 では少数のデータ(ミニバッチ)の勾配の平均で更新する。
例題
$f(x_1,x_2)=x_1x_2+e^{x_1x_2}$ を $(1,2)$ で微分する。計算グラフは $v_1=x_1$、$v_2=x_2$、$v_3=v_1v_2$、$v_4=e^{v_3}$、$v_5=v_3+v_4$ で、値は $v_3=2$、$v_4=e^2=7.389056$、$v_5=9.389056$ である。逆向きに $\bar v_5=1$ から、$v_5=v_3+v_4$ で $\bar v_4=1$、$\bar v_3=1$。$v_4=e^{v_3}$ で $\bar v_3\leftarrow1+\bar v_4e^{v_3}=8.389056$。$v_3=v_1v_2$ で $\bar v_1=\bar v_3v_2=16.778112$、$\bar v_2=\bar v_3v_1=8.389056$。直接の計算 $\partial f/\partial x_1=x_2(1+e^{x_1x_2})$、$\partial f/\partial x_2=x_1(1+e^{x_1x_2})$ と一致する。$v_3$ は 2 か所で使われるので、その 2 つの寄与を足した。
ニューラルネットワーク の例題「順伝播の数値」のネットワーク(構造 $(2,2,1)$、ロジスティック関数、$W^{(1)}=\begin{pmatrix}1&-2\\3&1\end{pmatrix}$、$b^{(1)}=(0,-1)^{\mathsf T}$、$W^{(2)}=(2\ \ -1)$、$b^{(2)}=0.5$)に、$x=(1,2)$、$y=1$、2 乗誤差 $\frac12(\hat y-y)^2$ を与える。順伝播で $z^{(1)}=(-3,4)$、$x^{(1)}=(0.047426,0.982014)$、$\hat y=-0.387162$ である。
- $\delta^{(2)}=\hat y-y=-1.387162$、$\partial E/\partial W^{(2)}=\delta^{(2)}(x^{(1)})^{\mathsf T}=(-0.065787,\ -1.362212)$、$\partial E/\partial b^{(2)}=-1.387162$。
- $\varsigma'(z^{(1)})=(0.045177,\ 0.017663)$、$(W^{(2)})^{\mathsf T}\delta^{(2)}=(-2.774324,\ 1.387162)$ なので $\delta^{(1)}=(-0.125335,\ 0.024501)$。
- $\partial E/\partial W^{(1)}=\delta^{(1)}x^{\mathsf T}=\begin{pmatrix}-0.125335&-0.250669\\0.024501&0.049002\end{pmatrix}$、$\partial E/\partial b^{(1)}=\delta^{(1)}$。
9 個の偏微分は、中心差分($h=10^{-6}$)と小数第 6 位まで一致する。
出力 $\hat y=z=(2,1,0)$、正解 $y=1$ とすると、$p=(e^2,e,1)/(e^2+e+1)=(0.665241,\ 0.244728,\ 0.090031)$、損失 $-\log p_1=0.407606$、出力層の誤差は $p-e_1=(-0.334759,\ 0.244728,\ 0.090031)$ である。正解の成分だけが負で、正解の確率を上げる向きに勾配が働く。誤差の成分の和は $0$ である。
各層 1 ユニットで重み $1$、偏り $0$ のロジスティック関数を $L$ 段重ね、$u_0=x=0$、$u_k=\varsigma(u_{k-1})$、出力 $\hat y=u_L$ とする。$d\hat y/dx=\prod_{k=1}^L\varsigma'(u_{k-1})$ で、prop-bp-vanishing の上界は $4^{-L}$ である。$L=5,10,20$ で上界は $9.8\times10^{-4}$、$9.5\times10^{-7}$、$9.1\times10^{-13}$、実際の値は $6.8\times10^{-4}$、$3.9\times10^{-7}$、$1.3\times10^{-13}$ である($\varsigma'(0)=\frac14$ だが $u_k\ge\frac12$ では $\varsigma'(u_k)< \frac14$)。
構造 $(784,100,10)$、各隠れ層の活性化関数を 1 回の演算と数えると、$M=78400+1000=79400$、$U=100$ で、順伝播は $79500$ 回、逆伝播は $2M-n_1n_0+2U=158800-78400+200=80600$ 回である。パラメータは $P=79510$ 個で、中心差分ですべての偏微分を求めると $2P(M+U)\approx1.26\times10^{10}$ 回となり、逆伝播の約 16 万倍である。
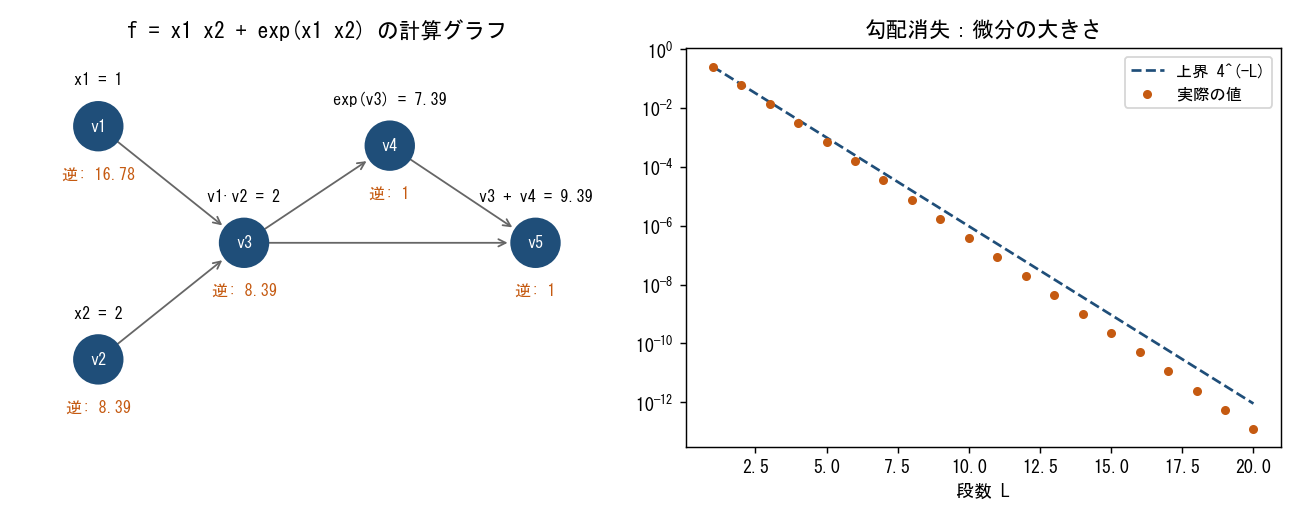 図: 左は例題の計算グラフで、v1 と v2 から積 v3、v3 から指数関数 v4、v3 と v4 の和 v5 への矢印があり、各頂点に順伝播の値と逆伝播の値(v1 は 16.78、v2 は 8.39、v3 は 8.39、v4 は 1、v5 は 1)が書かれている。右はロジスティック関数を L 段重ねたときの微分の大きさを、片対数で L が 1 から 20 まで描いたもので、上界 4 の −L 乗の直線の下に実際の値が並ぶ。
使える条件と反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 活性化関数が実際の値で微分可能(条件 1) | $f(x)=\rho(x)-\rho(-x)$ を $x=0$ で、$\rho'(0):=c$ と約束 | 逆伝播の値は $2c$ で、$f'(0)=1$ と($c=\frac12$ 以外)一致しない |
| 損失が微分可能(条件 1) | $\operatorname{loss}=\lvert\hat y-y\rvert$、$\hat y=y$ | $E$ は微分できず、勾配が存在しない |
| 計算グラフに閉路がない(条件 2) | 固定点 $v=av+u$($\lvert a\rvert<1$)の $u$ についての微分 | 右辺の $v$ を前の値とみて 1 回だけ逆伝播すると $1$ で、正しい値 $\frac1{1-a}$ と異なる |
| 出力が 1 次元(条件 3、thm-bp-cost) | $g(t)=(t,t^2,\dots,t^m)$ | Jacobi 行列に逆伝播が $m$ 回要り、前向きの微分(1 回)より費用が大きい |
確かめを開く
1 行目:$f$ は構造 $(1,2,1)$、$W^{(1)}=(1,-1)^{\mathsf T}$、$b^{(1)}=0$、$W^{(2)}=(1\ \ -1)$ のネットワークで、$f(x)=x$ である。$x=0$ で $z^{(1)}=(0,0)$、$E=f$ とみて $\delta^{(2)}=1$、$\delta^{(1)}=(c\cdot1,\ c\cdot(-1))$、$\partial f/\partial x=(W^{(1)})^{\mathsf T}\delta^{(1)}=c+c=2c$ である。$c=0$(多くの実装の約束)では $0$、$c=1$ では $2$ になる。2 行目:$\hat y\mapsto\lvert\hat y-y\rvert$ は $\hat y=y$ で微分できない。3 行目:$v=\frac u{1-a}$ なので $dv/du=\frac1{1-a}$($a=\frac12$ なら $2$)。$v_1=av_0+u$ を $k$ 回くり返した $v_k$($v_0=0$)の微分は $1+a+\dots+a^{k-1}$ で、$k\to\infty$ でだけ正しい値に近づく。固定点の微分は 陰関数定理 で $\frac{\partial v}{\partial u}=(1-a)^{-1}$ と求める。4 行目:逆伝播 1 回は出力の 1 次結合 1 つの勾配を与えるので、$m$ 行の Jacobi 行列には $m$ 回要る。入力が 1 次元なら、前向きの微分(二重数 で $t+\varepsilon$ を入力する)1 回で全成分の導関数が出る。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 誤差を $W^{(\ell+1)}\delta^{(\ell+1)}$ で送る | 転置 $(W^{(\ell+1)})^{\mathsf T}\delta^{(\ell+1)}$ | 行列の大きさが $n_{\ell+1}\times n_\ell$ なので転置しないと次元が合わない |
| $\sigma'$ を $x^{(\ell)}$ で評価する | $z^{(\ell)}$(活性化関数を施す前)で評価する | 連鎖律で微分するのは $\sigma$ の入力 |
| 2 か所で使われる値の逆伝播の値を上書きする | 足し合わせる | thm-bp-graph の手順 2 は加算 |
| 重みの偏微分に $x^{(\ell)}$ を掛ける | $x^{(\ell-1)}$(その層の入力)を掛ける | $z^{(\ell)}=W^{(\ell)}x^{(\ell-1)}+b^{(\ell)}$ |
| 勾配の確かめの差分の刻みを極端に小さくする | $10^{-6}$ 程度(倍精度の中心差分) | 小さすぎると桁落ちで誤差が増える |
補足
前向きの微分との比較:連鎖律を入力の側から順に当てる前向きの自動微分は、二重数 の計算として実現でき、1 回の掃引で 1 つの方向の微分を与える。$f\colon\mathbb{R}^n\to\mathbb{R}^m$ の Jacobi 行列には前向きは $n$ 回、逆向きは $m$ 回の掃引が要り、1 回の掃引の費用は元の計算の定数倍である(BPRS18 §3.2、p. 13 が Griewank と Walther の結果として述べる。この記事では証明しない)。学習の損失は $m=1$ でパラメータの数 $n$ が大きいので、逆向きが有利である。その代わり、逆向きは順伝播の途中の値をすべて保存する記憶領域が要る。
歴史:逆向きの微分の考え方は制御理論の随伴の方法(Pontryaginの最大原理 と関係する)などで知られており、ニューラルネットワークの学習の方法としては Rumelhart、Hinton、Williams(1986)によって広く知られるようになった(BPRS18 §3.3)。
ほかの文献での書き方:隠れ層 1 つのネットワークの誤差の漸化式は ESL17 §11.4 の式 (11.15)(「back-propagation equations」)、層の形の一般の場合は SSBD14 §20.6 にある。ESL17 の誤差は、損失を $\frac12$ を付けない 2 乗誤差の和にしたときの、この記事の $\delta$ と同じ量(活性化関数を施す前の値についての偏微分)である。SSBD14 は活性化関数を施した後の値についての偏微分を $\delta$ とおくので、この記事の $\delta^{(\ell)}$ とは因子 $\sigma'(z^{(\ell)})$ だけ異なる。
関連項目
- 前提: 合成関数の微分法, ニューラルネットワーク, Jacobi行列
- 使い道: 確率的勾配降下法, 勾配降下法, 普遍近似定理
- 比較: 二重数, 陰関数定理
- 発展: Pontryaginの最大原理, Hesse行列
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

