平均値と二乗誤差
概要
平均値と二乗誤差は、データの平均値を「ずれの 2 乗の和を最小にする値」として捉える見方である。データ $x_1,\dots,x_n$ の平均値を $\bar x$ とすると、すべての実数 $a$ について $\sum_{i=1}^n(x_i-a)^2=\sum_{i=1}^n(x_i-\bar x)^2+n(a-\bar x)^2$ が成り立つ。したがって左辺を最小にする $a$ は $\bar x$ ただ 1 つで、最小値は分散 $s^2$ の $n$ 倍である。$a=0$ とおけば分散の公式 $s^2=\overline{x^2}-\bar x^2$ が得られる。$E[X^2]$ が有限の確率変数 $X$ でも $E[(X-a)^2]=V(X)+(E[X]-a)^2$ が成り立ち、期待値がただ 1 つの最小点である。ずれを絶対値で測ると最小点は中央値になり、平均値とは一般に異なる。
高校での出発点:平均値と分散
$n$ 個の数値からなるデータ $x_1,x_2,\dots,x_n$ を考える。高校では、データの中心を表す代表値として平均値
$$
\bar x:=\frac1n(x_1+x_2+\cdots+x_n)=\frac1n\sum_{i=1}^nx_i
$$
を習う。各値と平均値の差 $x_i-\bar x$ を偏差という。偏差の 2 乗の平均
$$
s^2:=\frac1n\sum_{i=1}^n(x_i-\bar x)^2
$$
を分散といい、その正の平方根 $s$ を標準偏差という。分散の計算には、次の公式も習う。
$$
s^2=\overline{x^2}-\bar x^2,\qquad\text{ただし}\quad\overline{x^2}:=\frac1n\sum_{i=1}^nx_i^2 .
$$
まず 2 つのデータで計算してみる。
データは $1,2,3,4,10$ で、$n=5$ である。
- 平均値:$\bar x=\frac{1+2+3+4+10}5=\frac{20}5=4$。
- 偏差:$1-4=-3$、$2-4=-2$、$3-4=-1$、$4-4=0$、$10-4=6$。
- 分散:$s^2=\frac{(-3)^2+(-2)^2+(-1)^2+0^2+6^2}5=\frac{9+4+1+0+36}5=\frac{50}5=10$。
- 公式による計算:$\overline{x^2}=\frac{1+4+9+16+100}5=\frac{130}5=26$ なので、$s^2=26-4^2=10$。
2 通りの計算は一致する。標準偏差は $s=\sqrt{10}=3.16\ldots$ である。
データは $2,4,9$ で、$n=3$ である。
- 平均値:$\bar x=\frac{2+4+9}3=\frac{15}3=5$。
- 偏差:$-3$、$-1$、$4$。
- 分散:$s^2=\frac{9+1+16}3=\frac{26}3$。
- 公式による計算:$\overline{x^2}=\frac{4+16+81}3=\frac{101}3$ なので、$s^2=\frac{101}3-25=\frac{101-75}3=\frac{26}3$。
ここで次の問いが生じる。
- 平均値は、どういう意味でデータの「中心」なのか。→ thm-mse-main
- 分散の公式 $s^2=\overline{x^2}-\bar x^2$ は、なぜ成り立つのか。→ cor-mse-variance-formula
- 確率変数の期待値(確率分布の平均)でも、同じことが言えるか。→ prop-mse-random-variable
答えの要点は「平均値は、ずれの 2 乗の和を最小にするただ 1 つの値である」ことである。高校の計算と、この記事で取り出す考え方の対応を表にしておく。高校の計算 この記事の言葉 大学の言葉 平均値 $\bar x$ ずれの 2 乗の和 $Q(a)$ を最小にする $a$ 定数ベクトルの直線への正射影 偏差の和が $0$ $Q(a)$ を展開したときに交差項が消える 偏差ベクトルと定数ベクトルの直交 分散 $s^2$ $Q(a)$ の最小値を $n$ で割ったもの 偏差ベクトルの長さの 2 乗 分散の公式 $Q(a)$ の等式で $a=0$ とおいたもの ピタゴラスの定理 確率変数の期待値・分散 $E[(X-a)^2]$ の最小点と最小値 2 乗平均の距離で最も近い定数
ずれの測り方
「中心」を 1 つの数 $a$ で代表させると、各データはそこから $x_i-a$ だけずれる。ずれは正にも負にもなるので、2 乗して正の量にしてから足す。
データ $x_1,\dots,x_n$ と実数 $a$ について
$$
Q(a):=\sum_{i=1}^n(x_i-a)^2=(x_1-a)^2+(x_2-a)^2+\cdots+(x_n-a)^2
$$
とおき、$Q(a)$ を $a$ に対する二乗誤差の和という。$Q(a)$ は $0$ 以上の実数であり、$a$ を動かすと値が変わる。
データ $1,2,3$ について、いくつかの $a$ で $Q(a)$ を計算する。
- $Q(1)=0^2+1^2+2^2=5$。
- $Q(2)=1^2+0^2+1^2=2$。
- $Q(3)=2^2+1^2+0^2=5$。
- $Q(2.5)=1.5^2+0.5^2+0.5^2=2.25+0.25+0.25=2.75$。
データ $2,4,9$ では、$Q(4)=4+0+25=29$、$Q(5)=9+1+16=26$、$Q(6)=16+4+9=29$ である。計算した値の中では、どちらのデータでも、平均値($2$ と $5$)で $Q$ が最も小さい。これが偶然でないことを、この後で示す。
証明の鍵は、偏差の和が $0$ になることである。
どんなデータ $x_1,\dots,x_n$ についても
$$
\sum_{i=1}^n(x_i-\bar x)=0
$$
が成り立つ。
平均値の定義 $\bar x=\frac1n\sum_{i=1}^nx_i$ の両辺に $n$ を掛けると、$\sum_{i=1}^nx_i=n\bar x$ である。
次に、$\bar x$ は $i$ によらない数なので、$\bar x$ を $n$ 回足すと $n\bar x$ になる。したがって
$$
\sum_{i=1}^n(x_i-\bar x)=\sum_{i=1}^nx_i-\sum_{i=1}^n\bar x=n\bar x-n\bar x=0
$$
である。$\square$
データ $1,2,3,4,10$ の偏差は $-3,-2,-1,0,6$ で、和は $-3-2-1+0+6=0$ である。データ $2,4,9$ の偏差は $-3,-1,4$ で、和は $0$ である。
数直線の上では、平均値は「左側の偏差の合計と右側の偏差の合計が釣り合う点」である。データの点に同じ重さのおもりを置くと、平均値の位置で支えれば釣り合う。平均値がデータの重心と呼ばれるのはこのためである。
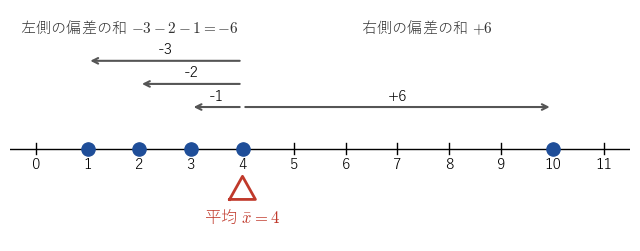 図1:データ 1, 2, 3, 4, 10 と平均値 4。左側の偏差の和 −6 と右側の偏差の和 +6 が釣り合う。
主定理:平均値は二乗誤差の和を最小にする
データ $x_1,\dots,x_n$ の平均値を $\bar x$ とする。すべての実数 $a$ について
$$
Q(a)=\sum_{i=1}^n(x_i-\bar x)^2+n(a-\bar x)^2
$$
が成り立つ。したがって、$Q(a)$ を最小にする $a$ は $a=\bar x$ ただ 1 つであり、最小値は $Q(\bar x)=ns^2$($s^2$ は分散)である。
方針:$x_i-a$ を「平均値からのずれ $x_i-\bar x$」と「平均値と $a$ の差 $\bar x-a$」の和に分けて 2 乗し、lem-mse-deviation-sum で真ん中の項を消す。
段 1(分ける)。各 $i$ について、$\bar x$ を引いて足すと
$$
x_i-a=(x_i-\bar x)+(\bar x-a)
$$
である。
段 2(2 乗する)。$(p+q)^2=p^2+2pq+q^2$ を $p=x_i-\bar x$、$q=\bar x-a$ に使うと
$$
(x_i-a)^2=(x_i-\bar x)^2+2(\bar x-a)(x_i-\bar x)+(\bar x-a)^2
$$
である。
段 3($i$ について足す)。$i=1,\dots,n$ についてこの式を足す。$\bar x-a$ は $i$ によらないので、2 番目の項では和の外にくくり出せる。3 番目の項は同じ数を $n$ 回足すので $n(\bar x-a)^2$ になる。よって
$$
Q(a)=\sum_{i=1}^n(x_i-\bar x)^2+2(\bar x-a)\sum_{i=1}^n(x_i-\bar x)+n(\bar x-a)^2
$$
である。
段 4(真ん中の項を消す)。lem-mse-deviation-sum により $\sum_{i=1}^n(x_i-\bar x)=0$ なので、真ん中の項は $0$ である。また $(\bar x-a)^2=(a-\bar x)^2$ である。これで主張の等式が得られた。
段 5(最小点)。右辺の第 1 項 $\sum_{i=1}^n(x_i-\bar x)^2$ は $a$ によらない。第 2 項 $n(a-\bar x)^2$ は $0$ 以上で、$0$ になるのは $a=\bar x$ のときだけである。したがって、すべての $a$ について $Q(a)\ge\sum_{i=1}^n(x_i-\bar x)^2=Q(\bar x)$ であり、等号は $a=\bar x$ のときだけ成り立つ。最小値は、分散の定義から $\sum_{i=1}^n(x_i-\bar x)^2=ns^2$ である。$\square$
データ $1,2,3,4,10$ では、ex-mse-first より $\bar x=4$、$\sum(x_i-\bar x)^2=50$ なので、定理は
$$
Q(a)=50+5(a-4)^2
$$
を主張する。
- $a=3$:右辺は $50+5\cdot1=55$。直接計算すると $Q(3)=2^2+1^2+0^2+1^2+7^2=4+1+0+1+49=55$。
- $a=10$:右辺は $50+5\cdot36=230$。直接計算すると $Q(10)=81+64+49+36+0=230$。
- $a=6$:右辺は $50+5\cdot4=70$。直接計算すると $Q(6)=25+16+9+4+16=70$。
- $a=4$:右辺は $50$ で、これが最小値 $5\cdot s^2=5\cdot10$ である。
$Q(a)$ は $a$ の 2 次関数で、グラフは下に凸な放物線になる。その頂点の $a$ 座標が平均値である。
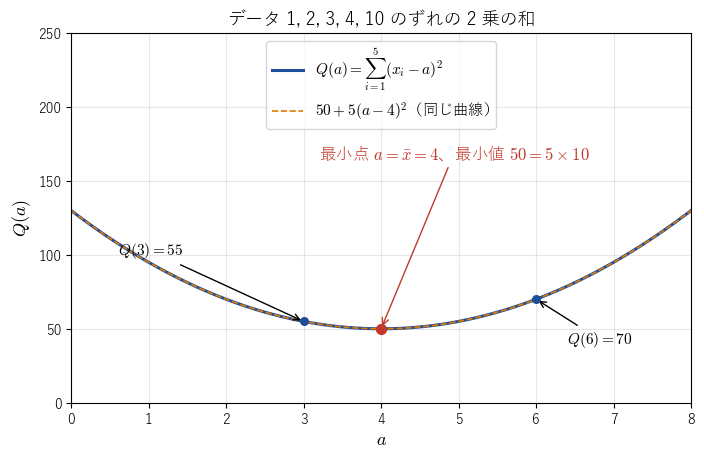 図2:データ 1, 2, 3, 4, 10 に対する Q(a) のグラフ。放物線の頂点は a = 4(平均値)で、高さ 50 は分散 10 の 5 倍である。
定理は、高校の 2 次関数の平方完成でも確かめられる。$Q(a)$ を $a$ について展開すると
$$
Q(a)=na^2-2\Bigl(\sum_{i=1}^nx_i\Bigr)a+\sum_{i=1}^nx_i^2=na^2-2n\bar x\,a+\sum_{i=1}^nx_i^2
$$
である。平方完成すると
$$
Q(a)=n(a-\bar x)^2+\Bigl(\sum_{i=1}^nx_i^2-n\bar x^2\Bigr)
$$
となり、頂点は $a=\bar x$ である。データ $1,2,3,4,10$ では $\sum x_i=20$、$\sum x_i^2=130$ なので
$$
Q(a)=5a^2-40a+130=5(a-4)^2+50
$$
である。この計算の定数項 $\sum x_i^2-n\bar x^2$ と定理の第 1 項 $\sum(x_i-\bar x)^2$ を見比べると、次の系が得られる。
$s^2=\overline{x^2}-\bar x^2$ である。
thm-mse-main の等式は、すべての実数 $a$ について成り立つ。$a=0$ とおくと、左辺は $Q(0)=\sum_{i=1}^nx_i^2$、右辺は $\sum_{i=1}^n(x_i-\bar x)^2+n\bar x^2=ns^2+n\bar x^2$ である。よって
$$
\sum_{i=1}^nx_i^2=ns^2+n\bar x^2
$$
である。両辺を $n$ で割ると $\overline{x^2}=s^2+\bar x^2$ となり、$\bar x^2$ を左辺に移せば $s^2=\overline{x^2}-\bar x^2$ である。$\square$
同じ最小化はデータのベクトルを定数ベクトルの向きへ正射影することに当たり、正射影と最小二乗法は 正射影と射影行列 で扱う。
ex-mse-first と ex-mse-second の「公式による計算」は、この系の使用例である。もう 1 つ、データ $3,5,7,9$ では $\bar x=6$、$\overline{x^2}=\frac{9+25+49+81}4=\frac{164}4=41$ なので $s^2=41-36=5$ である。偏差 $-3,-1,1,3$ から直接計算しても $\frac{9+1+1+9}4=5$ となる。
分散の公式は「$x_i^2$ の平均は、分散と平均値の 2 乗の和に分かれる」と読める。データをベクトルとみると、これは直角三角形の三辺の関係(ピタゴラスの定理)そのものである。その見方は 相関係数(高校数学) の記事で扱う。
2 次関数の最小値を平方完成で求める方法は 2次関数の最大・最小 で扱う。
確率変数の場合
同じことは、確率変数についても成り立つ。確率変数 $X$ の期待値を $E[X]$ と書く。値が有限個 $v_1,\dots,v_k$ でそれぞれの確率が $p_1,\dots,p_k$ なら $E[X]=\sum_jv_jp_j$ であり、確率密度関数 $w(t)$ をもつなら $E[X]=\int t\,w(t)\,dt$ である。$\mu:=E[X]$ とおき、$V(X):=E[(X-\mu)^2]$ を $X$ の分散という(GS06 Definition 6.1, 6.3–6.5)。以下では $E[X]$ と $E[X^2]$ が有限の値をもつとする。値が有限個の場合や、密度関数が有界な区間の外で $0$ の場合は、つねにそうである。
$\mu=E[X]$ とすると、すべての実数 $a$ について
$$
E[(X-a)^2]=V(X)+(\mu-a)^2
$$
が成り立つ。したがって $E[(X-a)^2]$ を最小にする $a$ は $a=\mu$ ただ 1 つであり、最小値は $V(X)$ である。
段 1。thm-mse-main の証明と同じく $X-a=(X-\mu)+(\mu-a)$ と分けて 2 乗すると
$$
(X-a)^2=(X-\mu)^2+2(\mu-a)(X-\mu)+(\mu-a)^2
$$
である。
段 2。両辺の期待値をとる。期待値の線形性(和の期待値は期待値の和、定数倍の期待値は期待値の定数倍、定数の期待値はその定数)により
$$
E[(X-a)^2]=E[(X-\mu)^2]+2(\mu-a)E[X-\mu]+(\mu-a)^2
$$
である。
段 3。$E[X-\mu]=E[X]-\mu=0$ なので真ん中の項は消え、第 1 項は定義により $V(X)$ である。最小点についての議論は thm-mse-main の証明の段 5 と同じである。$\square$
データ $x_1,\dots,x_n$ から 1 つを等しい確率 $\frac1n$ で選んだ値を $X$ とすると、$E[X]=\bar x$、$E[(X-a)^2]=\frac1nQ(a)$ である。この場合、命題は thm-mse-main に一致する。
公正なさいころの目 $X$ は $1,\dots,6$ を確率 $\frac16$ ずつとる。$E[X]=\frac{1+2+\cdots+6}6=\frac72$ であり、分散は $V(X)=\frac{35}{12}$ である。
- $a=3$:直接計算すると $E[(X-3)^2]=\frac{4+1+0+1+4+9}6=\frac{19}6$。命題の右辺は $\frac{35}{12}+\bigl(\frac72-3\bigr)^2=\frac{35}{12}+\frac3{12}=\frac{38}{12}=\frac{19}6$。
- $a=1$:直接計算すると $E[(X-1)^2]=\frac{0+1+4+9+16+25}6=\frac{55}6$。命題の右辺は $\frac{35}{12}+\bigl(\frac52\bigr)^2=\frac{35}{12}+\frac{75}{12}=\frac{110}{12}=\frac{55}6$。
最小値は $a=\frac72$ でとり、値は $\frac{35}{12}$ である。
区間 $[0,1]$ 上の確率密度関数 $w(t)=2t$ をもつ確率変数 $X$ を考える(区間の外では $w(t)=0$。$\int_0^12t\,dt=1$ である)。
- $E[X]=\int_0^1t\cdot2t\,dt=\Bigl[\frac23t^3\Bigr]_0^1=\frac23$。
- $E[X^2]=\int_0^1t^2\cdot2t\,dt=\Bigl[\frac12t^4\Bigr]_0^1=\frac12$。
- $V(X)=E[X^2]-(E[X])^2=\frac12-\frac49=\frac1{18}$(分散の公式は確率変数でも、命題で $a=0$ とおけば同じように得られる)。
- $E[(X-a)^2]=E[X^2]-2aE[X]+a^2=a^2-\frac43a+\frac12$。命題の右辺 $\frac1{18}+\bigl(\frac23-a\bigr)^2=\frac1{18}+\frac49-\frac43a+a^2$ も $a^2-\frac43a+\frac12$ に等しい。
最小点は $a=\frac23$ で、最小値は $\frac1{18}$ である。この分布の中央値は $\frac1{\sqrt2}=0.707\ldots$ で、平均と異なる(確率分布の中央値)。
例と反例
平均値は、ずれを「2 乗して足す」という測り方に結びついている。測り方を変えると、結論がどう変わるかを表にする。
| 外した仮定・変えた測り方 | 崩れる主張 | ボックス |
|---|---|---|
| ずれを 2 乗しない(符号つきのまま足す) | 最小にする $a$ が存在する | ex-mse-signed |
| ずれの最大値で測る | 最小にする $a$ が平均値である | ex-mse-max |
| データに極端な値を 1 つ入れる | 平均値が大多数のデータの近くにある | ex-mse-outlier |
符号つきのずれの和 $S(a):=\sum_{i=1}^n(x_i-a)$ は、lem-mse-deviation-sum と同じ計算で $S(a)=n\bar x-na=n(\bar x-a)$ となる。データ $1,2,3$ では $S(a)=6-3a$ で、$S(10)=-24$、$S(100)=-294$ のように、$a$ を大きくするといくらでも小さくなる。したがって $S$ を最小にする $a$ は存在しない。ずれを $0$ 以上の量(2 乗や絶対値)で測るという仮定を外すと、「ずれの合計が最小になる点を中心とする」という考え方そのものが成り立たない。
ずれを合計せず、いちばん大きなずれ $D(a):=\max_i|x_i-a|$ で測る。データの最小値を $m$、最大値を $M$ とする。$a$ から最も遠いデータは $m$ か $M$ なので、$D(a)=\max(a-m,\ M-a)$ である($a$ が区間 $[m,M]$ の外にあるときも同じ式で表せる)。2 つの数 $a-m$ と $M-a$ の和は $M-m$ なので、大きい方は $\frac{M-m}2$ 以上であり、等号は 2 つが等しいとき、すなわち $a=\frac{m+M}2$ のときだけである。
データ $1,2,3,4,10$ では、$D$ の最小点は範囲の中点 $\frac{1+10}2=5.5$ で、$D(5.5)=4.5$ である。平均値 $4$ では $D(4)=6$ で、最小ではない。「平均値はずれを最も小さくする」という主張は、ずれの測り方を 2 乗の和に決めて初めて正しい。
データ $1,2,3,4,10$ の最後の値を $100$ に変えると、平均値は $\frac{1+2+3+4+100}5=22$ になる。5 個のうち 4 個は $4$ 以下なのに、平均値はどのデータからも遠い。分散は $\overline{x^2}=\frac{1+4+9+16+10000}5=2006$ から $2006-22^2=1522$ に増える。2 乗は大きなずれを非常に重く数えるので、$Q(a)$ を小さくするために $a$ は外れ値の方へ引き寄せられる。一方、中央値は $3$ のままである(中央値と絶対誤差)。
ずれの 2 乗は計算と相性がよい。2 つの変量の和 $z_i=x_i+y_i$ の平均値は $\bar z=\bar x+\bar y$ を満たし、thm-mse-main のように展開と平方完成だけで最小点と最小値がわかる。確率変数についても prop-mse-random-variable が同じ形で成り立ち、独立な測定を平均するとばらつきが減るという計算(標本平均の分散)にもつながる。外れ値に弱いことと引き換えに、計算の道具が豊富なのが平均値の特徴である。
さらに先へ
- データを $\mathbb{R}^n$ のベクトルとみると、thm-mse-main は「定数ベクトルの直線への正射影」の性質であり、分散の公式はピタゴラスの定理になる。この見方は 相関係数(高校数学) の記事で扱う。
- 定数の代わりに 1 次式 $\alpha+\beta x_i$ でデータ $y_i$ を近似し、ずれの 2 乗の和を最小にするのが最小二乗法である。
- ずれの絶対値の和で測ると、最小にするのは中央値になる(中央値と絶対誤差)。
関連項目
- 案内: 平均・中央値・分散
- 前提: 総和記号, 2次関数, 期待値
- 次に読む: 相関係数(高校数学), 標本平均の分散
- 関連(高校数学): 2次関数の最大・最小, 正射影と射影行列, Jensenの不等式(高校数学)
- 発展: 最小二乗法, 内積空間
- 比較: 中央値と絶対誤差, 確率分布の中央値
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

