傾向スコア
概要
傾向スコア(propensity score)とは、2 値の処置 $X$ と共変量 $Z$ について、共変量の値のもとで処置を受ける条件付き確率 $e(Z)=P(X=1\mid Z)$ のことである。$e(Z)$ の値を固定すると処置群と対照群で $Z$ の分布が等しくなり、$Z$ のもとで潜在結果と処置が条件付き独立で $0< e(Z)< 1$ なら、$e(Z)$ のもとでも条件付き独立になるので、多次元の共変量の代わりに 1 次元の傾向スコアで調整できる。逆数 $1/e(Z)$ で重みを付けた推定量は平均処置効果の不偏推定量だが、$e(Z)$ が $0$ に近い値をとると分散が無限大になりうる。結果の回帰と組み合わせた推定量は、傾向スコアと回帰のどちらか一方が正しければ偏らない。
観察研究で薬の効果を調べるとき、因果推論 の調整の公式は、年齢・重症度・持病などの共変量 $Z$ の値ごとに服薬した人としなかった人を比べる。共変量が 10 個もあると、値の組ごとの層はほとんど空になる。そこで、共変量の情報を「その人が服薬する確率」$e(Z)=P(X=1\mid Z)$ という 1 つの数にまとめる。これが 傾向スコア(propensity score)である。Rosenbaum と Rubin が導入した方法として知られる(Pea09 §3.3.3、p. 117)。
この記事の主定理は、傾向スコアの値が同じ人どうしでは、処置を受けた群と受けなかった群で共変量の分布が等しく、共変量で調整してよい状況なら傾向スコアだけで調整してもよい、という定理である。続いて、傾向スコアの逆数で重みを付けた推定量の不偏性と分散を求め、傾向スコアが $0$ に近い点があると分散が無限大になりうることを示す。最後に、結果のモデルと組み合わせた推定量が、2 つのモデルのどちらか一方が正しければ偏らない性質(二重頑健性)を証明する。
定義と使える条件
以下、処置 $X$ は $\{0,1\}$ に値をとり、共変量 $Z$ は可測空間に値をとる確率変数(何次元のベクトルでもよい)、結果 $Y$ は実数値で、潜在結果 $Y(0),Y(1)$ は 因果推論 の定義「潜在結果と平均処置効果」の一致性を満たす。$\tau:=\mathrm E[Y(1)]-\mathrm E[Y(0)]$ を平均処置効果とする。確率変数 $U,V,W$ について、$U\perp V\mid W$ は、すべての可測集合 $A,B$ で $P(U\in A,V\in B\mid W)=P(U\in A\mid W)P(V\in B\mid W)$ がほとんど確実に成り立つことをいう(条件付き確率は 条件付き期待値 の意味)。$Z$ が有限個の値をとるときは 因果推論 の条件付き独立と一致する。
- 可測関数 $e$ で $e(Z)=P(X=1\mid Z)$(ほとんど確実に)となるものを 傾向スコア という。
- $Z$ の可測関数 $b(Z)$ で $X\perp Z\mid b(Z)$ となるものを 釣り合いのスコア(balancing score)という。
$Z$ そのものは釣り合いのスコアである。釣り合いのスコアの値を固定すると、処置群と対照群で $Z$ の条件付き分布が同じになる。ランダム化した実験で群の間の共変量の偏りが確率的にしか起こらないのと同じ状態を、層の中で作れるということである。
使える条件は次のとおりである。(i)〜(iii) は 因果推論 と同じ番号にそろえた。
- (i) 一致性:$X=x$ なら $Y=Y(x)$。
- (ii) 条件付きの無視可能性:$x=0,1$ について $Y(x)\perp X\mid Z$。
- (iii) 正値性:$0< e(Z)< 1$ がほとんど確実に成り立つ。
- (iv) 強い正値性:ある $\varepsilon>0$ で $\varepsilon\le e(Z)\le1-\varepsilon$ がほとんど確実に成り立つ。推定量の分散を有限にするのに使う。
- (v) 傾向スコアが正しい:推定に使う関数が真の $e$ に等しい(または一致推定量である)。
公式の表
以下 $Q(x,z)$ を $Q(x,Z)=\mathrm E[Y(x)\mid Z]$ となる関数とする。(i)〜(iii) のもとで $Q(x,Z)=\mathrm E[Y\mid X=x,Z]$ でもある。
| 量 | 公式 | 使える条件 | 根拠 |
|---|---|---|---|
| 釣り合い | $X\perp Z\mid e(Z)$ | なし | thm-ps-balance の 2 |
| 傾向スコアによる無視可能性 | $Y(x)\perp X\mid e(Z)$ | (ii)(iii) | thm-ps-balance の 3 |
| 層別 | $P(Y(x)=y)=\sum_sP(Y=y\mid X=x,e(Z)=s)P(e(Z)=s)$ | (i)–(iii)、$Z$ が有限個の値 | cor-ps-strata |
| 逆確率重み付け | $\mathrm E[Y(1)]=\mathrm E\bigl[XY/e(Z)\bigr]$、$\mathrm E[Y(0)]=\mathrm E\bigl[(1-X)Y/(1-e(Z))\bigr]$ | (i)–(iii) | prop-ps-ipw |
| IPW 推定量の分散 | $\dfrac1N\Bigl(\mathrm E\Bigl[\dfrac{m_1(Z)}{e(Z)}+\dfrac{m_0(Z)}{1-e(Z)}\Bigr]-\tau^2\Bigr)$、$m_x(Z)=\mathrm E[Y(x)^2\mid Z]$ | (i)–(iii)、独立同分布 | prop-ps-ipw |
| 二重頑健な推定量の偏り | $\mathrm E\Bigl[\dfrac{(e-\tilde g)(Q(1,\cdot)-\tilde Q(1,\cdot))}{\tilde g}+\dfrac{(e-\tilde g)(Q(0,\cdot)-\tilde Q(0,\cdot))}{1-\tilde g}\Bigr]$($Z$ で評価) | (i)–(iii) | thm-ps-dr |
主定理と証明
処置が 2 値なので、条件付き独立は条件付き確率 1 つで判定できる。
$X$ は $\{0,1\}$ に値をとり、$V,W$ は確率変数とする。$X\perp V\mid W$ であることと、$P(X=1\mid V,W)=P(X=1\mid W)$ がほとんど確実に成り立つことは同値である。
要点:$P(X=1\mid W)$ が $P(X=1\mid V,W)$ の定義の等式を満たすかどうかを、$\{V\in A,W\in C\}$ の形の集合で確かめる。
詳しい証明を開く
$h(W):=P(X=1\mid W)$ とおく。同値の後ろから前。 有界可測な $f$ について、$\sigma(W)\subset\sigma(V,W)$ なので塔の性質から $\mathrm E[\mathbf 1_{\{X=1\}}f(V)\mid W]=\mathrm E[P(X=1\mid V,W)f(V)\mid W]=h(W)\,\mathrm E[f(V)\mid W]$ である。$X$ は 2 値なので、$\{X=1\}$ と $\{X=0\}$ の両方でこの分解が成り立ち、条件付き独立になる。
前から後ろ。 可測集合 $A,C$ について、条件付き独立から $\mathrm E[\mathbf 1_{\{X=1\}}\mathbf 1_A(V)\mid W]=h(W)P(V\in A\mid W)$ なので、両辺に $\mathbf 1_C(W)$ を掛けて期待値をとると $\mathrm E[\mathbf 1_{\{X=1\}}\mathbf 1_A(V)\mathbf 1_C(W)]=\mathrm E[h(W)\mathbf 1_A(V)\mathbf 1_C(W)]$ を得る。$\{V\in A,W\in C\}$ の形の集合は積について閉じていて $\sigma(V,W)$ を生成するので、Dynkin の $\pi$-$\lambda$ 定理によりこの等式は $\sigma(V,W)$ のすべての集合で成り立つ。$h(W)$ は $\sigma(V,W)$ 可測なので、$h(W)=P(X=1\mid V,W)$ である。$\square$
$b$ を可測関数とする。
- $b(Z)$ が釣り合いのスコアであることと、$e(Z)=\mathrm E[X\mid b(Z)]$ がほとんど確実に成り立つことは同値である。とくに、ある可測関数 $f$ で $e(Z)=f(b(Z))$ となるなら $b(Z)$ は釣り合いのスコアである。
- $e(Z)$ は釣り合いのスコアである。すなわち $X\perp Z\mid e(Z)$ である。
- (ii)(iii) が成り立つなら、$x=0,1$ について $Y(x)\perp X\mid e(Z)$ であり、$0< P(X=1\mid e(Z))< 1$ がほとんど確実に成り立つ。
1。 $W:=b(Z)$ は $Z$ の関数なので $\sigma(Z,W)=\sigma(Z)$ であり、$P(X=1\mid Z,W)=e(Z)$ である。lem-ps-binary を $V=Z$ で使うと、$X\perp Z\mid W$ は $e(Z)=P(X=1\mid W)=\mathrm E[X\mid W]$ と同値である。$e(Z)=f(W)$ なら、$f(W)$ は $\sigma(W)$ 可測なので、塔の性質から $\mathrm E[X\mid W]=\mathrm E[\mathrm E[X\mid Z]\mid W]=\mathrm E[f(W)\mid W]=f(W)=e(Z)$ となり、同値の条件が成り立つ。
2。 1 で $b=e$、$f$ を恒等写像とすればよい。
3。 $S:=e(Z)$ とおく。(ii) と lem-ps-binary から $P(X=1\mid Y(x),Z)=P(X=1\mid Z)=S$ である。$\sigma(Y(x),S)\subset\sigma(Y(x),Z)$ なので、塔の性質により
$$
P(X=1\mid Y(x),S)=\mathrm E\bigl[P(X=1\mid Y(x),Z)\bigm\vert Y(x),S\bigr]=\mathrm E[S\mid Y(x),S]=S
$$
である。2 の証明から $P(X=1\mid S)=S$ でもあるので、$P(X=1\mid Y(x),S)=P(X=1\mid S)$ となり、lem-ps-binary を $V=Y(x)$、$W=S$ で使って $Y(x)\perp X\mid S$ を得る。最後に $P(X=1\mid S)=S$ と (iii) から、$0< P(X=1\mid S)< 1$ である。$\square$
$\mathrm E[X\mid b(Z)]$ は $b(Z)$ の関数なので、1 は「$b(Z)$ が釣り合いのスコアであることと、$e(Z)$ がほとんど確実に $b(Z)$ の関数であることは同値」と言い換えられる。この意味で、傾向スコアは釣り合いのスコアの中でもっとも粗い。3 は、$Z$ による調整が正しい状況では、多次元の $Z$ の代わりに 1 次元の $e(Z)$ で調整してよいことを意味する。$Z$ が有限個の値をとるときは、因果推論 の定理「無視可能性と調整の公式」を $Z$ の代わりに $e(Z)$ で使うと、次の系を得る。
$Z$ が有限個の値をとり、(i)〜(iii) が成り立つとする。このとき
$$
P(Y(x)=y)=\sum_{s}P(Y=y\mid X=x,e(Z)=s)\,P(e(Z)=s)
$$
である。和は $P(e(Z)=s)>0$ となる $s$ にわたる。
傾向スコアの値が同じ 2 人の共変量が同じとは限らない。釣り合うのは群全体の共変量の 分布 である(ex-ps-strata)。また、この定理は (ii) を前提にしており、(ii) そのものを作り出すわけではない。観測しない交絡があれば、傾向スコアを使っても偏りは消えない(Pea09 §3.3.3、p. 117、反例の表の 1 行目)。
逆確率重み付け
(i)〜(iii) を仮定し、$\mathrm E\lvert Y(0)\rvert,\mathrm E\lvert Y(1)\rvert< \infty$ とする。
- $\mathrm E\bigl[XY/e(Z)\bigr]=\mathrm E[Y(1)]$、$\mathrm E\bigl[(1-X)Y/(1-e(Z))\bigr]=\mathrm E[Y(0)]$ である。
- $(X_i,Z_i,Y_i)$($i=1,\dots,N$)を $(X,Z,Y)$ と同じ分布の独立な組とし、
$$ \psi:=\frac{XY}{e(Z)}-\frac{(1-X)Y}{1-e(Z)},\qquad\hat\tau_{\mathrm{IPW}}:=\frac1N\sum_{i=1}^N\psi_i $$
とおく。$\mathrm E\hat\tau_{\mathrm{IPW}}=\tau$ であり、$m_x(Z):=\mathrm E[Y(x)^2\mid Z]$ について
$$ \mathrm E\psi^2=\mathrm E\Bigl[\frac{m_1(Z)}{e(Z)}+\frac{m_0(Z)}{1-e(Z)}\Bigr]\ (\le\infty) $$
である。これが有限なら $\operatorname{Var}\hat\tau_{\mathrm{IPW}}=(\mathrm E\psi^2-\tau^2)/N$ で、$\sqrt N(\hat\tau_{\mathrm{IPW}}-\tau)$ は $N(0,\mathrm E\psi^2-\tau^2)$ に分布収束する。 - (iv) と $\mathrm E[Y(x)^2]< \infty$ が成り立てば、$\mathrm E\psi^2\le\bigl(\mathrm E[Y(1)^2]+\mathrm E[Y(0)^2]\bigr)/\varepsilon< \infty$ である。
1。 (ii) から、非負の可測関数 $h$ について $\mathrm E[Xh(Y(1))\mid Z]=e(Z)\,\mathrm E[h(Y(1))\mid Z]$ である(有界な $h$ で条件付き独立の定義から従い、単調収束定理で非負へ広げる)。$h=\lvert\cdot\rvert$ とすると $\mathrm E[X\lvert Y(1)\rvert/e(Z)]=\mathrm E\lvert Y(1)\rvert< \infty$ なので、正と負の部分に分けて $\mathrm E[XY(1)\mid Z]=e(Z)Q(1,Z)$ を得る。一致性から $XY=XY(1)$ なので、$\mathrm E[XY/e(Z)]=\mathrm E[Q(1,Z)]=\mathrm E[Y(1)]$ である。$\mathrm E[Y(0)]$ も同様である。
2。 平均は 1 から出る。$X(1-X)=0$ なので $\psi^2=XY(1)^2/e(Z)^2+(1-X)Y(0)^2/(1-e(Z))^2$ で、1 と同じく $Z$ で条件を付けると $\mathrm E[\psi^2\mid Z]=m_1(Z)/e(Z)+m_0(Z)/(1-e(Z))$ を得る。分散の式は独立な和の分散であり、分布収束は 中心極限定理 による。
3。 $1/e(Z)\le1/\varepsilon$、$1/(1-e(Z))\le1/\varepsilon$ と $\mathrm E[m_x(Z)]=\mathrm E[Y(x)^2]$ による。$\square$
1 は (i)〜(iii) のもとで 因果推論 の逆確率重み付けの式を一般の $Z$ に広げたものである。処置群の各個体を $1/e(Z)$ 倍に数えると、処置を受けにくい共変量をもつ個体が重くなり、処置群が全体の共変量の分布を代表するように重みが付く。
2 の分散は $e(Z)$ が $0$ に近い所で $1/e(Z)$ の大きさで増える。(iii) が成り立っていても $\mathrm E[1/e(Z)]=\infty$ となることがあり、$m_1(Z)$ が正の定数以上ならそのとき $\mathrm E\psi^2=\infty$ である。このとき $\hat\tau_{\mathrm{IPW}}$ は不偏で大数の強法則により $\tau$ に収束するが、分散は無限大で、$\sqrt N$ の速さの正規近似は使えない(ex-ps-overlap)。
重みを合計で割った Hájek 型の推定量
$$
\hat\tau_{\mathrm H}:=\frac{\sum_iX_iY_i/e(Z_i)}{\sum_iX_i/e(Z_i)}-\frac{\sum_i(1-X_i)Y_i/(1-e(Z_i))}{\sum_i(1-X_i)/(1-e(Z_i))}
$$
も使われる(Mur25 式 (36.29)、p. 1200)。1 で $Y\equiv1$ とすると $\mathrm E[X/e(Z)]=1$ なので、分母はどちらも $N$ で割ると $1$ に確率収束し、$\hat\tau_{\mathrm H}$ も $\tau$ に収束する。$Y$ に定数 $c$ を足しても $\hat\tau_{\mathrm H}$ は変わらないが、$\hat\tau_{\mathrm{IPW}}$ は $c\bigl(\frac1N\sum_iX_i/e(Z_i)-\frac1N\sum_i(1-X_i)/(1-e(Z_i))\bigr)$ だけ動く。この違いのため、結果の平均が $0$ から遠いと $\hat\tau_{\mathrm H}$ の方が安定しやすい。
二重頑健性
傾向スコアは実際には推定しなければならず、そのモデルが誤っていれば重み付けの推定量は偏る(反例の表の 4 行目)。結果の回帰 $Q$ のモデルと組み合わせると、どちらか一方が正しければ偏らない推定量が作れる。$\tilde g$ と $\tilde Q$ を、それぞれ $e$ と $Q$ の代わりに使う関数(推定したモデル)とし、
$$
\tilde\psi:=\tilde Q(1,Z)-\tilde Q(0,Z)+\frac{X\bigl(Y-\tilde Q(1,Z)\bigr)}{\tilde g(Z)}-\frac{(1-X)\bigl(Y-\tilde Q(0,Z)\bigr)}{1-\tilde g(Z)}
$$
とおく。その標本平均が 拡張した逆確率重み付けの推定量(AIPW、Mur25 式 (36.30)、p. 1200)である。
(i)〜(iii) を仮定し、$\mathrm E[Y(x)^2]< \infty$ とする。可測関数 $\tilde g$ はある $\varepsilon>0$ で $\varepsilon\le\tilde g\le1-\varepsilon$ を満たし、$\mathrm E[\tilde Q(x,Z)^2]< \infty$($x=0,1$)とする。このとき
$$
\mathrm E\tilde\psi-\tau=\mathrm E\Bigl[\frac{\bigl(e(Z)-\tilde g(Z)\bigr)\bigl(Q(1,Z)-\tilde Q(1,Z)\bigr)}{\tilde g(Z)}\Bigr]+\mathrm E\Bigl[\frac{\bigl(e(Z)-\tilde g(Z)\bigr)\bigl(Q(0,Z)-\tilde Q(0,Z)\bigr)}{1-\tilde g(Z)}\Bigr]
$$
である。とくに次が成り立つ。
- $\tilde g(Z)=e(Z)$ か、$x=0,1$ について $\tilde Q(x,Z)=Q(x,Z)$ のどちらかがほとんど確実に成り立てば、$\mathrm E\tilde\psi=\tau$ である。
- $d_e:=\bigl(\mathrm E[(e(Z)-\tilde g(Z))^2]\bigr)^{1/2}$、$d_x:=\bigl(\mathrm E[(Q(x,Z)-\tilde Q(x,Z))^2]\bigr)^{1/2}$ とおくと、$\lvert\mathrm E\tilde\psi-\tau\rvert\le\varepsilon^{-1}d_e(d_1+d_0)$ である。
仮定から $\tilde\psi$ の各項は 2 乗可積分であり、以下の期待値はすべて有限である。$\Delta_1:=Q(1,Z)-\tilde Q(1,Z)$、$\Delta_0:=Q(0,Z)-\tilde Q(0,Z)$ とおく。
処置群の項。 一致性から $X(Y-\tilde Q(1,Z))=X(Y(1)-\tilde Q(1,Z))$ である。$\tilde Q(1,Z)$ と $\tilde g(Z)$ は $Z$ の関数なので、prop-ps-ipw の証明の 1 と同じく (ii) から
$$
\mathrm E\Bigl[\frac{X(Y-\tilde Q(1,Z))}{\tilde g(Z)}\Bigm\vert Z\Bigr]=\frac{e(Z)\bigl(Q(1,Z)-\tilde Q(1,Z)\bigr)}{\tilde g(Z)}=\frac{e(Z)\Delta_1}{\tilde g(Z)}
$$
である。よって
$$
\mathrm E\Bigl[\tilde Q(1,Z)+\frac{X(Y-\tilde Q(1,Z))}{\tilde g(Z)}\Bigr]=\mathrm E\Bigl[Q(1,Z)-\Delta_1+\frac{e(Z)\Delta_1}{\tilde g(Z)}\Bigr]=\mathrm E[Y(1)]+\mathrm E\Bigl[\frac{(e(Z)-\tilde g(Z))\Delta_1}{\tilde g(Z)}\Bigr]
$$
である。
対照群の項。 同様に $\mathrm E[(1-X)(Y-\tilde Q(0,Z))\mid Z]=(1-e(Z))\Delta_0$ なので
$$
\mathrm E\Bigl[\tilde Q(0,Z)+\frac{(1-X)(Y-\tilde Q(0,Z))}{1-\tilde g(Z)}\Bigr]=\mathrm E[Y(0)]+\mathrm E\Bigl[\Delta_0\Bigl(\frac{1-e(Z)}{1-\tilde g(Z)}-1\Bigr)\Bigr]=\mathrm E[Y(0)]-\mathrm E\Bigl[\frac{(e(Z)-\tilde g(Z))\Delta_0}{1-\tilde g(Z)}\Bigr]
$$
である。$\tilde\psi$ は処置群の項から対照群の項を引いたものなので、2 つの式の差が主張の式である。
1。 $\tilde g(Z)=e(Z)$ なら両方の項で $e-\tilde g=0$、$\tilde Q=Q$ なら $\Delta_1=\Delta_0=0$ である。
2。 $1/\tilde g\le1/\varepsilon$、$1/(1-\tilde g)\le1/\varepsilon$ と Cauchy–Schwarz の不等式による。$\square$
偏りは「傾向スコアの誤差」と「結果の回帰の誤差」の 積 の形をしている。2 つのモデルを推定するとき、どちらの誤差も $N^{-1/4}$ より速く小さくなれば積は $N^{-1/2}$ より速く小さくなり、推定量の誤差を支配しない。この考えから、AIPW 推定量が条件のもとで $\sqrt N$ の速さで正規分布に近づくこと、推定と評価に別の部分標本を使う交差当てはめ(cross fitting)が有効なことが知られているが、この記事では証明しない(Mur25 §36.4.2.3–§36.4.2.4、pp. 1200–1202)。
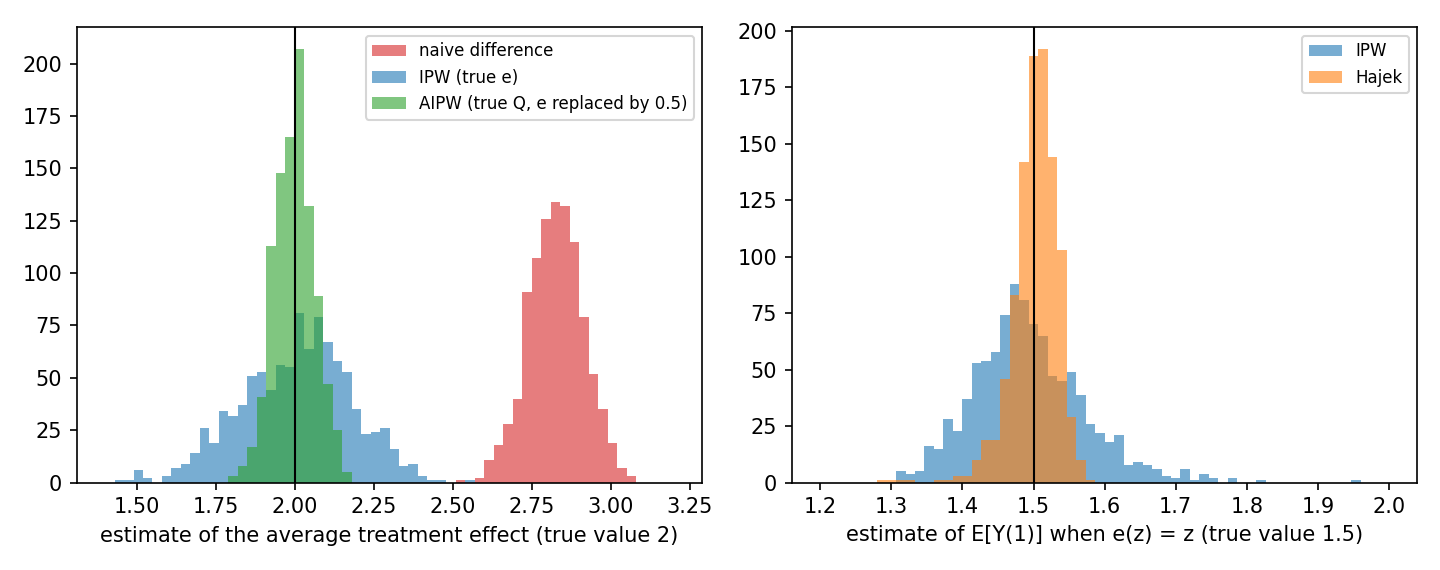 図:左は例題 ex-ps-sim の推定値の分布(1000 回)。単純な差(赤)は真の値 2 から大きくずれ、e が既知の IPW(青)は 2 のまわりに広く、結果の回帰が正しく傾向スコアを 0.5 に替えた AIPW(緑)は 2 のまわりに狭く分布する。右は例題 ex-ps-overlap の E[Y(1)] の推定値の分布で、IPW(青)は右に長い裾をもち、Hájek 型(橙)は狭い。
計算の手順
- 共変量を選ぶ。 (ii) を満たすように、処置と結果の共通の原因を $Z$ に入れる。処置の後に決まる変数や合流点は入れない(因果推論 の反例の表)。
- 傾向スコアを推定する。 $Z$ から $X$ を予測する回帰(ロジスティック回帰など)で $\hat e$ を求める(Mur25 §36.4.2.2、p. 1200)。
- 重なりを確かめる。 2 つの群で $\hat e$ の分布を比べ、$0$ や $1$ に近い値がないかを見る。極端な値の個体を除くと、推定の対象が「重なりのある部分集団の効果」に変わる(Mur25 §36.4.5.2、p. 1206)。
- 釣り合いを確かめる。 $\hat e$ の層の中、または重みを付けたあとで、2 つの群の共変量の平均や分布を比べる。
- 推定する。 層別・照合(matching)・Hájek 型・AIPW などで推定し、複数の方法の結果が大きく食い違わないかを見る(Mur25 §36.4.6、p. 1208)。
例題
$Z$ は $\{1,2,3,4\}$ の上の一様分布、$e(1)=e(2)=0.2$、$e(3)=e(4)=0.6$、$P(Y=1\mid X=x,Z=z)=0.2+0.1z+0.2x$ とし、(i)〜(iii) を仮定する。単純な比較と、$e(Z)$ の 2 つの層による層別を比べる。
使う公式:thm-ps-balance、cor-ps-strata。
答え:$P(X=1)=\frac25$ で、単純な比較は $P(Y=1\mid X=1)-P(Y=1\mid X=0)=\frac7{10}-\frac5{12}=\frac{17}{60}\approx0.28333$。層 $e=0.2$ では処置群・対照群とも $Z$ は $\{1,2\}$ の上の一様分布で、回復の確率は $\frac{11}{20}$ と $\frac7{20}$。層 $e=0.6$ では $\frac34$ と $\frac{11}{20}$。層の確率はどちらも $\frac12$ なので $P(Y(1)=1)=\frac{13}{20}$、$P(Y(0)=1)=\frac9{20}$ で、効果は $\frac15$。$Z$ の 4 つの層で調整した値も $\frac15$ である。
途中の計算を開く
群全体では $P(Z=z\mid X=1)$ が $z=1,2,3,4$ で $\frac18,\frac18,\frac38,\frac38$、$P(Z=z\mid X=0)$ が $\frac13,\frac13,\frac16,\frac16$ で、処置群に $Z$ の大きい個体が多い。$Z$ が大きいほど回復しやすいので、単純な比較は効果を $\frac{17}{60}-\frac15=\frac1{12}$ だけ大きく見せる。層 $e=0.2$ の中では $P(Z=1\mid X=x,e(Z)=0.2)=\frac{0.25\cdot0.2}{0.5\cdot0.2}=\frac12$($x=1$)、$\frac{0.25\cdot0.8}{0.5\cdot0.8}=\frac12$($x=0$)で、thm-ps-balance の 2 のとおり釣り合っている。$Z=1$ と $Z=2$ は傾向スコアが同じだが共変量は違う。
$Z\sim N(0,1)$、$e(z)=1/(1+e^{-z})$、$Y(x)=1+2x+Z+\eta$($\eta\sim N(0,1)$ は $(X,Z)$ と独立)とする。$\tau=2$ である。$N=1000$ の標本を乱数の種 $723$ で $2000$ 回生成して、推定量の平均と標準偏差を比べる。
使う公式:prop-ps-ipw、thm-ps-dr。
答え:
| 推定量 | 平均 | 標準偏差 |
|---|---|---|
| 単純な差 | $2.82942$ | $0.08599$ |
| IPW($e$ は既知) | $1.99973$ | $0.16969$ |
| Hájek 型 | $2.00608$ | $0.11602$ |
| AIPW($Q$ は正しく、$\tilde g=0.5$) | $2.00141$ | $0.06380$ |
| AIPW($e$ は正しく、$\tilde Q(x,z)=1+2x$) | $2.00297$ | $0.11619$ |
| AIPW($\tilde g=0.5$、$\tilde Q(x,z)=1+2x$) | $2.82946$ | $0.08595$ |
単純な差の母集団での値は $2+\mathrm E[Z\mid X=1]-\mathrm E[Z\mid X=0]\approx2.82648$ である。IPW の標準偏差の理論値は prop-ps-ipw の 2 から $\sqrt{29.78466/1000}\approx0.17258$。最後の行の偏りは thm-ps-dr の式で $Q-\tilde Q=Z$ とした $4\,\mathrm E[(e(Z)-0.5)Z]\approx0.82648$ と一致する。
$Z$ は $(0,1)$ の上の一様分布、$e(z)=z$、$Y(1)=1+Z$ とし、$\mathrm E[Y(1)]=1.5$ を $\frac1N\sum_iX_iY_i/e(Z_i)$ で推定する。
使う公式:prop-ps-ipw の 2。
答え:(iii) は成り立つので不偏だが、$\mathrm E[(XY/e(Z))^2]=\mathrm E[(1+Z)^2/Z]=\infty$ で分散は無限大である。乱数の種 $7231$、$N=1000$ で $2000$ 回の模擬では、IPW の推定値の $5\%$ 点と $95\%$ 点は $1.38253$ と $1.63332$(最大 $2.16103$)、Hájek 型は $1.44914$ と $1.54663$ であった。
確かめを開く
$\int_\varepsilon^1(1+z)^2/z\,dz=-\log\varepsilon+2(1-\varepsilon)+(1-\varepsilon^2)/2$ は $\varepsilon\to0$ で発散する($\varepsilon=10^{-2},10^{-4},10^{-6}$ で $7.08512,11.71014,16.31551$)。分散が有限なら $5\%$ 点と $95\%$ 点の幅の $\sqrt N$ 倍は一定の値に近づくが、模擬(各 $1000$ 回)では $N=100,1000,10000$ で $7.25,7.91,9.66$ と増え続ける。Hájek 型は $Y$ を $Y-1$ に替えると推定値がちょうど $1$ 減るので、その誤差は $Y-1=Z$ を推定するときの誤差と同じである。重みの大きい点は $Z$ が小さく、$Z$ も小さいので、影響が抑えられる。
使える条件と反例
各行は 1 つの条件だけを外し、ほかの条件は満たす。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| (ii) 無視可能性 | 観測しない $U$ が確率 $\frac12$ で $1$、$P(X=1\mid U)=0.2,0.8$($U=0,1$)、$Y=X+U$、$Z$ は定数 | $e\equiv0.5$ で重み付けは単純な差と同じになり、極限は $1.6$。効果は $1$ |
| (iii) 正値性 | $Z$ は確率 $\frac12$ で $0$ か $1$、$e(0)=0$、$e(1)=0.5$、$Y(1)=1+Z$ | $\mathrm E[XY/e(Z)]$($X=1$ の項だけ)は $1$ で、$\mathrm E[Y(1)]=1.5$ と違う。$Z=0$ の $Y(1)$ は観察から決まらない |
| (iv) 強い正値性 | ex-ps-overlap | 不偏だが分散は無限大で、$\sqrt N$ の速さの正規近似が使えない |
| (v) 傾向スコアが正しい | ex-ps-sim で $e$ の代わりに $0.5$ を使う IPW | 平均は $2.82790$ で、効果 $2$ からずれる(母集団で $2.82648$)。AIPW は $Q$ が正しければ偏らない |
1 行目の確かめ:$\mathrm E[XY]=\frac12(0.2\cdot1+0.8\cdot2)=0.9$、$\mathrm E[(1-X)Y]=\frac12\cdot0.2\cdot1=0.1$ なので、$\mathrm E[XY/0.5-(1-X)Y/0.5]=2(0.9-0.1)=1.6$ である。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 傾向スコアを使えば観測しない交絡も除ける | 除けるのは $Z$ による交絡だけ | thm-ps-balance の 3 は (ii) を仮定する。反例の表の 1 行目 |
| 傾向スコアが同じ 2 人は共変量も似ている | 釣り合うのは群全体の共変量の分布 | ex-ps-strata の $Z=1$ と $Z=2$ |
| 重みの大きい個体を除いても同じ効果を推定している | 推定の対象が重なりのある部分集団の効果に変わる | Mur25 §36.4.5.2、p. 1206 |
| $e(Z)>0$ なら重み付けの推定は安定している | $1/e(Z)$ の期待値が大きいと分散が大きい | ex-ps-overlap |
| 観測した変数は全部 $Z$ に入れる | 処置の後の変数や合流点は除く。変数を増やすと重なりも弱くなる | 因果推論 の反例の表、Mur25 §36.4、Definition 1 のあと、p. 1197 |
補足
重なりが弱く処置を受けにくい個体が多いときは、処置を受けた群での平均効果 $\mathrm E[Y(1)-Y(0)\mid X=1]$ を推定の対象にすることがある。これには $e(Z)< 1$ だけが要り、$e(Z)>0$ は要らない(Mur25 §36.4.5.3、p. 1206)。実際、$\mathrm E[Y(0)\mid X=1]$ は $\mathrm E\bigl[(1-X)Y\,e(Z)/(1-e(Z))\bigr]/P(X=1)$ と書け、prop-ps-ipw の 1 と同じ議論で確かめられる。
関連項目
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

