区間推定(高校数学)
概要
区間推定(高校数学)は、母平均や母比率の範囲を標本から推し量る方法である。母平均 $\mu$、母標準偏差 $\sigma$ の母集団からの大きさ $n$ の無作為標本の平均 $\bar X$ について、$\bar X$ が正規分布に従うなら、区間 $\bar X\pm1.96\frac{\sigma}{\sqrt n}$ が $\mu$ を含む確率は $0.95$ で、一般の母集団でも $n$ が大きければ中心極限定理により近似的にそうなる。この確率は区間を作る前のもので、観測後の区間に $\mu$ が入る確率ではない。$\sigma$ が分かっていれば分布の形を仮定しなくても、Chebyshev の不等式から $\bar X\pm\sqrt{20}\frac{\sigma}{\sqrt n}$ は確率 $0.95$ 以上で $\mu$ を含む。
前提知識: 確率変数の期待値と分散, 標本平均の分散, 正規分布
高校での出発点:支持率の調査
数学 B の「統計的な推測」では、母集団(調べたい集団全体)から一部を選んで調べ、その結果から母集団の平均や割合を推し量る。1 つの値で言い当てるのではなく、「この範囲にあるだろう」と幅をもたせて答えるのが 区間推定 である。高校では次の公式を使う。
- 母平均 $\mu$ の信頼度 $95\%$ の信頼区間:$\displaystyle \bar x-1.96\frac{\sigma}{\sqrt n}\le\mu\le\bar x+1.96\frac{\sigma}{\sqrt n}$($\bar x$ は標本平均、$\sigma$ は母標準偏差、$n$ は標本の大きさ)。
- 母比率 $p$ の信頼度 $95\%$ の信頼区間:$\displaystyle \hat p-1.96\sqrt{\frac{\hat p(1-\hat p)}n}\le p\le\hat p+1.96\sqrt{\frac{\hat p(1-\hat p)}n}$($\hat p$ は標本での割合)。
まず 2 つの例で計算してみる。
ある政策について無作為に選んだ $400$ 人に聞いたところ、$160$ 人が支持した。標本での支持率は $\hat p=\frac{160}{400}=0.4$ である。
$$
\sqrt{\frac{\hat p(1-\hat p)}n}=\sqrt{\frac{0.4\cdot0.6}{400}}=\sqrt{0.0006}=0.02449\ldots
$$
なので、$1.96\times0.02449\ldots=0.0480\ldots$ である。信頼度 $95\%$ の信頼区間は
$$
0.4-0.048\le p\le0.4+0.048,\qquad\text{すなわち}\qquad 0.352\le p\le0.448
$$
である。ニュースで「支持率 $40\%$(誤差 $\pm4.8$ ポイント)」と言うときの誤差は、この幅の半分にあたる。
ある工場で作る製品の重さは、母標準偏差が $\sigma=2$ g であることが分かっているとする。無作為に $100$ 個を選んで量ったら、平均は $\bar x=50.3$ g であった。$\frac{\sigma}{\sqrt n}=\frac2{\sqrt{100}}=0.2$ なので $1.96\times0.2=0.392$ で、母平均 $\mu$ の信頼度 $95\%$ の信頼区間は
$$
50.3-0.392\le\mu\le50.3+0.392,\qquad\text{すなわち}\qquad 49.908\le\mu\le50.692
$$
である。
公式に数を入れれば答えは出る。しかし次の問いが残る。
- $1.96$ はどこから来たのか。なぜこの式で「$95\%$」と言えるのか。→ thm-iest-normal-facts、thm-iest-main
- 「$95\%$」とは何の確率か。「$\mu$ が $49.908$ と $50.692$ の間にある確率が $95\%$」と読んでよいか。→ rem-iest-meaning、ex-iest-simulation、ex-iest-misread
- 誤差を半分にするには、何人に聞けばよいか。→ ex-iest-sample-size
- 正規分布の近似に頼らずに、確かに $95\%$ 以上と保証できる区間は作れるか。→ thm-iest-guaranteed
- 公式がうまく働かないのはどんなときか。→ 反例の一覧この記事の主定理は 2 つである。標本平均が正規分布に従うときに、標本をとる前の確率的な区間 $\bar X\pm1.96\frac{\sigma}{\sqrt n}$ が確率 $0.95$ で母平均を含むこと(thm-iest-main)と、分布の形について何も仮定しなくても($\sigma$ は既知とする)、幅を広げた確率的な区間 $\bar X\pm\sqrt{20}\frac{\sigma}{\sqrt n}$ が確率 $0.95$ 以上で母平均を含むこと(thm-iest-guaranteed)である。
高校の計算 この記事での見方 大学の言葉 ボックス 標本平均の期待値 $\mu$、標準偏差 $\frac{\sigma}{\sqrt n}$ 期待値と分散の計算規則から出る 標本分布 prop-iest-sample-mean 正規分布表の $1.96$ $P(-1.96\le Z\le1.96)=0.95$ 標準正規分布の分位点 thm-iest-normal-facts $\bar x\pm1.96\frac{\sigma}{\sqrt n}$ 不等式の変形で「$\mu$ をはさむ」形に直す 信頼区間 thm-iest-main 母比率の信頼区間 1 か 0 をとる確率変数の平均 中心極限定理による近似 cor-iest-approx (高校では扱わない)幅の広い安全な区間 Chebyshev の不等式 分布によらない信頼区間 thm-iest-guaranteed
準備:標本平均の期待値と分散
調べたい集団を 母集団 という。母集団から 1 つを無作為に選んだときの値を確率変数とみて、その期待値 $\mu$ を 母平均、分散 $\sigma^2$ を 母分散、標準偏差 $\sigma$ を 母標準偏差 という。
母集団から $n$ 回、毎回もとに戻して無作為に選ぶ(復元抽出)とき、$k$ 回目に選んだものの値を $X_k$ とする。$X_1,X_2,\dots,X_n$ は互いに独立で、どれも母集団と同じ分布をもつ。これを大きさ $n$ の 無作為標本 といい、
$$
\bar X:=\frac{X_1+X_2+\dots+X_n}n
$$
を 標本平均 という。「支持する」を $1$、「支持しない」を $0$ で表すと、母平均は支持する人の割合 $p$(母比率)になり、標本平均 $\bar X$ は標本の中の割合 $\hat p$(標本比率)になる。教科書によっては標本比率を $R$ と書く。
もとに戻さずに選ぶ(非復元抽出)ときは $X_1,\dots,X_n$ が独立でなくなるが、母集団が標本に比べて十分大きければ、ほとんど同じ結果になる。この違いは 母集団と標本 で扱う。
支持する人の割合が $p$ の母集団から 1 人選び、支持なら $X=1$、不支持なら $X=0$ とする。確率変数の期待値と分散 の定義どおりに計算すると
$$
E(X)=1\cdot p+0\cdot(1-p)=p,\qquad V(X)=E(X^2)-E(X)^2=p-p^2=p(1-p)
$$
である($X^2=X$ なので $E(X^2)=p$)。たとえば $p=0.4$ なら母平均 $0.4$、母分散 $0.24$ である。
母平均 $\mu$、母分散 $\sigma^2$ の母集団からの大きさ $n$ の無作為標本について
$$
E(\bar X)=\mu,\qquad V(\bar X)=\frac{\sigma^2}n,\qquad \sigma(\bar X)=\frac{\sigma}{\sqrt n}
$$
が成り立つ。
方針:期待値は線形性で求める。分散は和 $X_1+\dots+X_n$ のずれの 2 乗を展開し、独立性で交差項を消す。使う計算規則はすべて 確率変数の期待値と分散 で証明したものである。
段 1(期待値)。期待値の線形性(和の期待値は期待値の和、定数倍は外に出せる)により
$$
E(\bar X)=\frac1n\bigl(E(X_1)+\dots+E(X_n)\bigr)=\frac1n\cdot n\mu=\mu
$$
である。
段 2(和のずれ)。$T:=X_1+\dots+X_n$ とおくと、段 1 と同じく $E(T)=n\mu$ で、ずれは $T-n\mu=\sum_{k=1}^n(X_k-\mu)$ である。この 2 乗を展開すると
$$
(T-n\mu)^2=\sum_{k=1}^n(X_k-\mu)^2+2\sum_{1\le j< k\le n}(X_j-\mu)(X_k-\mu)
$$
となる($n$ 個の数の和の 2 乗は、各数の 2 乗の和と、異なる 2 つの積の 2 倍の和である)。
段 3(交差項の期待値は 0)。$j\ne k$ のとき $X_j$ と $X_k$ は独立なので、独立な確率変数の積の期待値の公式 $E(X_jX_k)=E(X_j)E(X_k)=\mu^2$ が使える。線形性により
$$
E\bigl((X_j-\mu)(X_k-\mu)\bigr)=E(X_jX_k)-\mu E(X_k)-\mu E(X_j)+\mu^2=\mu^2-\mu^2-\mu^2+\mu^2=0
$$
である。
段 4(分散)。段 2 の式の期待値をとると、段 3 から交差項は消え、$E\bigl((X_k-\mu)^2\bigr)=\sigma^2$ が $n$ 個残る。よって $V(T)=n\sigma^2$ である。$\bar X=\frac1nT$ なので、定数倍の公式 $V(aT)=a^2V(T)$ により $V(\bar X)=\frac1{n^2}\cdot n\sigma^2=\frac{\sigma^2}n$ で、その正の平方根が $\sigma(\bar X)=\frac\sigma{\sqrt n}$ である。$\square$
この命題は 標本平均の分散 の主定理と同じ内容で、そこでは独立の代わりに「どの 2 つも無相関」という弱い仮定で示している。
- 母比率 $p=0.4$ の母集団から $n=400$ 人を選ぶ。ex-iest-bernoulli より $\sigma^2=0.24$ なので、標本比率 $\hat p$ は期待値 $0.4$、分散 $\frac{0.24}{400}=0.0006$、標準偏差 $\sqrt{0.0006}=0.0244\ldots$ である。ex-iest-poll で使った $0.02449\ldots$ と同じ数が出てくる。
- ex-iest-mean の製品では $\sigma=2$、$n=100$ なので、標本平均の標準偏差は $\frac{2}{10}=0.2$ である。$n=400$ にすると $\frac{2}{20}=0.1$ で、標本を $4$ 倍にして標準偏差が半分になる。
準備:正規分布の 3 つの事実
$1.96$ という数は、正規分布から来る。標準正規分布 とは、$a\le b$ に対して
$$
P(a\le Z\le b)=\int_a^b\varphi(z)\,dz,\qquad \varphi(z):=\frac1{\sqrt{2\pi}}e^{-z^2/2}
$$
で確率が決まる確率変数 $Z$ の分布である。$\varphi$ を 密度関数 という(値が連続的な確率変数と密度関数は 確率密度関数と連続型確率変数 で扱う)。$\mu+\sigma Z$($\sigma>0$)の分布を 正規分布 $N(\mu,\sigma^2)$ といい、その期待値は $\mu$、分散は $\sigma^2$ である($Z$ の期待値が $0$、分散が $1$ であることは 二項分布から正規分布へ で積分により示す。あとは 1 次式の期待値・分散の公式を使う)。
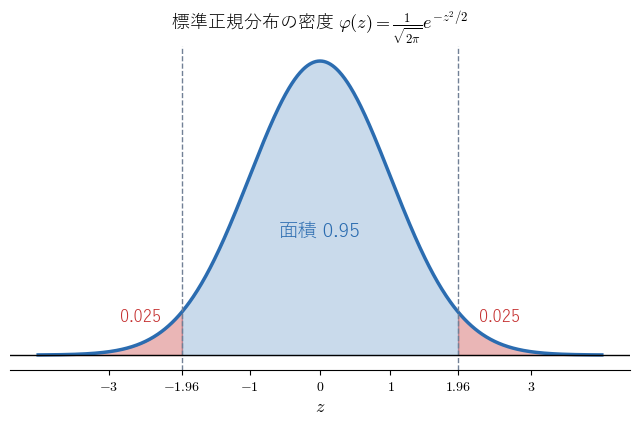 図1:標準正規分布の密度関数。$-1.96\le z\le1.96$ の部分の面積が 0.95 で、左右の端に 0.025 ずつが残ることを見る図。
この記事では、正規分布について次の 3 つの事実を証明せずに使う。
- $Z$ が標準正規分布に従うとき、$P(-1.96\le Z\le1.96)=0.9500\ldots$ である(図1)。
- 母集団の分布が正規分布 $N(\mu,\sigma^2)$ なら、大きさ $n$ の無作為標本の標本平均 $\bar X$ は正規分布 $N\bigl(\mu,\frac{\sigma^2}n\bigr)$ に従う。したがって $Z_n:=\dfrac{\bar X-\mu}{\sigma/\sqrt n}$ は標準正規分布に従う。
- (中心極限定理)母集団の分布が何であっても(分散が有限であれば)、$n$ を大きくすると、すべての $a\le b$ について $P(a\le Z_n\le b)$ は $P(a\le Z\le b)$ に近づく。
1 は数値計算である。積分 $\int_{-1.96}^{1.96}\varphi(z)\,dz$ を計算すると $0.950004\ldots$ になる。正規分布表は、このような積分の値を並べた表である。同じく $P(|Z|\le1)=0.6826\ldots$、$P(|Z|\le2)=0.9544\ldots$、$P(|Z|\le2.58)=0.9901\ldots$ である。
2 は「独立な正規分布の和はまた正規分布である」ことから出る。本記事では証明しない(GS06 Example 7.5)。$Z_n$ が標準正規分布に従うことは、$\bar X$ の期待値が $\mu$、標準偏差が $\frac\sigma{\sqrt n}$ であること(prop-iest-sample-mean)から、$Z_n$ が $\bar X$ の標準化であることによる。
3 は 中心極限定理 で、本記事では証明しない(GS06 Theorem 9.2、9.4(値が離散的な場合)、Theorem 9.6(連続的な場合))。1 か 0 をとる母集団の場合(標本比率)は de Moivre–Laplace の定理と呼ばれ、二項分布から正規分布へ で証明する。どのくらい大きい $n$ なら近似が良いかは、この定理だけからは分からない(ex-iest-small-n、ex-iest-small-p)。
- $P(Z\le1.96)$ は、左右対称性から $\frac12+\frac12P(|Z|\le1.96)=\frac12+\frac{0.95}2=0.975$ である。正規分布表で $1.96$ の行を引くと $0.4750$($0$ から $1.96$ までの面積)とあり、$0.5+0.475=0.975$ と一致する。
- 信頼度を $99\%$ にしたければ、$P(|Z|\le c)=0.99$ となる $c$ を探す。rem-iest-normal-facts の値から $c=2.58$ とすればよい。ex-iest-poll の支持率では $2.58\times0.02449\ldots=0.0632\ldots$ で、区間は $0.337\le p\le0.463$ と広がる。確かさを上げると区間は広くなる。
主定理 1:母平均の信頼区間
母平均 $\mu$、母標準偏差 $\sigma$ の母集団からの大きさ $n$ の無作為標本の標本平均を $\bar X$ とし、$Z_n=\dfrac{\bar X-\mu}{\sigma/\sqrt n}$ が標準正規分布に従うとする(母集団が正規分布なら、thm-iest-normal-facts の 2 によりこれが成り立つ)。このとき
$$
P\Bigl(\bar X-1.96\frac{\sigma}{\sqrt n}\le\mu\le\bar X+1.96\frac{\sigma}{\sqrt n}\Bigr)=P(-1.96\le Z\le1.96)=0.9500\ldots
$$
である。$1.96$ を正の数 $c$ に替えても、同じ式が $P(-c\le Z\le c)$ で成り立つ。
方針:「$Z_n$ が $-1.96$ と $1.96$ の間にある」という事象と、「区間が $\mu$ をはさむ」という事象が、同じ事象であることを示す。同じ事象の確率は等しい。以下 $d:=\frac{\sigma}{\sqrt n}>0$ とおく。
段 1(分母を払う)。$d>0$ なので、不等式の各辺に $d$ を掛けても向きは変わらない。
$$
-1.96\le\frac{\bar X-\mu}d\le1.96\iff-1.96d\le\bar X-\mu\le1.96d.
$$
段 2($\mu$ を移す)。右側の不等式 $\bar X-\mu\le1.96d$ は、両辺に $\mu-1.96d$ を足して $\bar X-1.96d\le\mu$ と同値である。左側の不等式 $-1.96d\le\bar X-\mu$ は、両辺に $\mu+1.96d$ を足して $\mu\le\bar X+1.96d$ と同値である。したがって
$$
-1.96d\le\bar X-\mu\le1.96d\iff\bar X-1.96d\le\mu\le\bar X+1.96d.
$$
段 3(確率が等しい)。段 1 と段 2 は、どの根元事象(どの標本の結果)についても成り立つ同値である。よって、「$-1.96\le Z_n\le1.96$」となる結果の集まりと、「$\bar X-1.96d\le\mu\le\bar X+1.96d$」となる結果の集まりは同じ事象であり、確率も等しい。仮定より $Z_n$ は標準正規分布に従うので、その確率は $P(-1.96\le Z\le1.96)=0.9500\ldots$(thm-iest-normal-facts の 1)である。$c$ に替えても、段 1〜段 3 は $1.96$ を $c$ に置き換えるだけで同じである。$\square$
定理の中の区間 $\bigl[\bar X-1.96\frac\sigma{\sqrt n},\ \bar X+1.96\frac\sigma{\sqrt n}\bigr]$ は、両端に確率変数 $\bar X$ を含む。標本をとるたびに位置が変わる 確率的な区間 である。定理は「この動く区間が、動かない $\mu$ を捕まえる確率が $0.95$」と言っている。
標本を実際にとって標本平均の値 $\bar x$ が得られたとき、数の区間
$$
\Bigl[\bar x-1.96\frac{\sigma}{\sqrt n},\ \bar x+1.96\frac{\sigma}{\sqrt n}\Bigr]
$$
を、母平均 $\mu$ の 信頼度 $95\%$ の信頼区間 という。$1.96$ を $2.58$ に替えたものを信頼度 $99\%$ の信頼区間という。
thm-iest-main の確率 $0.95$ は、標本をとる 前 の、「これからとる標本で作る区間が $\mu$ を含む」確率である。標本をとった 後 では、区間は $[49.908,\ 50.692]$ のような数の区間になり、$\mu$ も(知らないが)決まった数なので、「$\mu$ がこの区間に入る」は正しいか正しくないかのどちらかで、確率を考える余地がない。
「信頼度 $95\%$」は、この作り方をくり返すと、長い目で見て約 $95\%$ の区間が $\mu$ を含む、という 作り方の性能 を表す。大数の法則とさいころの平均 により、区間を作る試行を何度も独立にくり返すと、$\mu$ を含む区間の割合は $0.95$ に近づく。
母平均 $\mu=50$、母標準偏差 $\sigma=2$ の正規分布の母集団から、大きさ $100$ の標本をとって信頼度 $95\%$ の信頼区間 $\bar x\pm0.392$ を作ることを、計算機の乱数で $100$ 回くり返した(図2)。図2 は、含む本数が期待値の $95$ 本と同じになった回を選んで示したものである。最初に試した乱数では $100$ 本すべてが $\mu$ を含んだので、乱数の種(乱数の列を決める番号)を選び直した。
- $\mu=50$ を含んだ区間は $95$ 本、含まなかった区間は $5$ 本($26$、$46$、$58$、$62$、$77$ 回目)であった。
- 含まない区間も、見た目は他の区間と変わらない。1 本の区間だけを見て、それが $\mu$ を含む $95$ 本のほうか、含まない $5$ 本のほうかを知ることはできない。
- 含む本数そのものも偶然で変わる。各回が確率 $0.95$ で独立に「含む」ので、含む本数は二項分布($n=100$、$p=0.95$)に従い、期待値 $95$、標準偏差 $\sqrt{100\cdot0.95\cdot0.05}=2.17\ldots$ である。乱数の種を $40$ 通り変えて試したところ、含む本数は $90$ 本から $100$ 本の間でばらついた($95$ 本と $96$ 本がそれぞれ $8$ 回で最も多く、$90$ 本が $2$ 回、$100$ 本が $1$ 回)。1 回の結果だけで「ちょうど $95$ 本になる」と考えてはいけない。
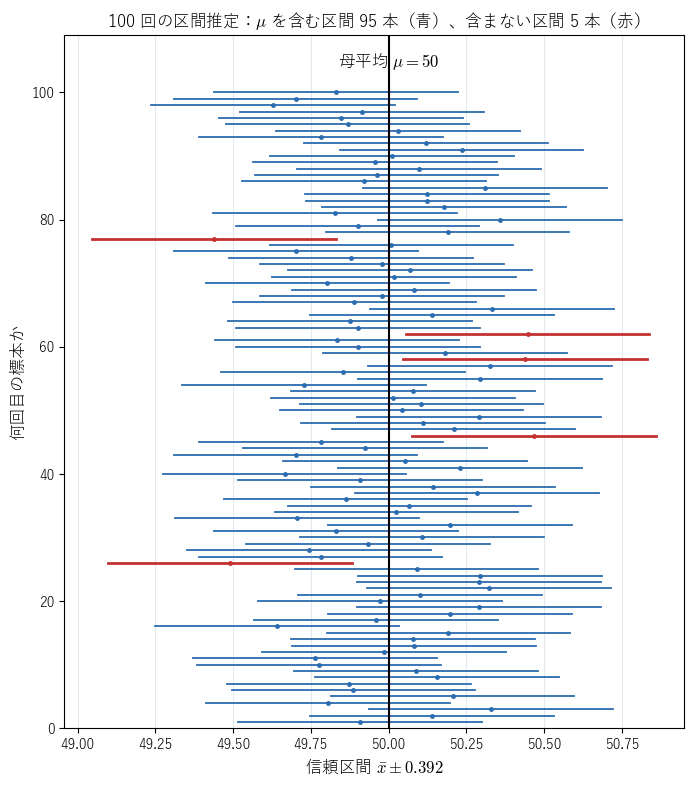 図2:母平均 50 の正規母集団から大きさ 100 の標本を 100 回とって作った信頼度 95% の信頼区間。青は母平均を含む区間(95 本)、赤は含まない区間(5 本)。含む本数が 95 本になった回を選んで示す。区間のほうが動き、母平均は動かないことを見る図。
母集団が正規分布でないとき:近似としての信頼区間
thm-iest-main は、$Z_n$ が ちょうど 標準正規分布に従うことを仮定した。母集団が正規分布でないときは、中心極限定理(thm-iest-normal-facts の 3)により近似として同じことが言える。
母集団の分布が何であっても(分散が有限であれば)、$n$ が大きいとき
$$
P\Bigl(\bar X-1.96\frac{\sigma}{\sqrt n}\le\mu\le\bar X+1.96\frac{\sigma}{\sqrt n}\Bigr)\approx0.95
$$
である。より正確には、左辺は $n\to\infty$ のとき $P(-1.96\le Z\le1.96)=0.9500\ldots$ に近づく。
thm-iest-main の証明の段 1〜段 3 は、$Z_n$ の分布を使っていない。そこで示したとおり、左辺の事象は「$-1.96\le Z_n\le1.96$」と同じ事象なので、左辺は $P(-1.96\le Z_n\le1.96)$ に等しい。thm-iest-normal-facts の 3 を $a=-1.96$、$b=1.96$ として使うと、これは $n\to\infty$ のとき $P(-1.96\le Z\le1.96)$ に近づく。$\square$
1 か 0 をとる母集団では $\mu=p$、$\sigma=\sqrt{p(1-p)}$ である(ex-iest-bernoulli)。cor-iest-approx の区間 $\hat p\pm1.96\sqrt{p(1-p)/n}$ は、知りたい $p$ そのものを含んでいるので、このままでは計算できない。そこで $\sigma$ の中の $p$ を標本比率 $\hat p$ で置き換えた $\hat p\pm1.96\sqrt{\hat p(1-\hat p)/n}$ を使う。これが高校で習う母比率の信頼区間である。この置き換えはもう 1 段の近似であり、$n$ が大きければ $\hat p$ は $p$ に近い(大数の法則とさいころの平均)ので影響は小さい、と考える。本記事ではこの近似の精度を証明しない(考え方は GS06 Example 9.4)。近似が悪くなる例は ex-iest-small-n、ex-iest-small-p で見る。
誤差の大きさ $1.96\sqrt{p(1-p)/n}$ は $p$ によって変わる。次の不等式で、$p$ が分からなくても誤差の上限が分かる。
$0\le p\le1$ のとき $p(1-p)\le\frac14$ であり、等号は $p=\frac12$ のときだけ成り立つ。したがって 1 か 0 をとる母集団の母標準偏差は $\sigma=\sqrt{p(1-p)}\le\frac12$ である。
$\frac14-p(1-p)=\frac14-p+p^2=\bigl(p-\frac12\bigr)^2\ge0$ である。等号は $p-\frac12=0$ のときだけである。両辺が $0$ 以上なので、平方根をとっても大小は変わらない。$\square$
同じ平方完成で最大値を求める考え方は 2次関数の最大・最小 で扱う。
母比率の信頼度 $95\%$ の信頼区間の幅の半分(誤差)を $0.03$ 以下にしたい。prop-iest-pq より、誤差 $1.96\sqrt{p(1-p)/n}$ は $p$ が何であっても $1.96\cdot\frac12\cdot\frac1{\sqrt n}$ 以下である。これが $0.03$ 以下になる条件は
$$
\frac{0.98}{\sqrt n}\le0.03\iff\sqrt n\ge\frac{0.98}{0.03}=32.66\ldots\iff n\ge1067.1\ldots
$$
なので、$n\ge1068$ にすれば十分である。
誤差は $\frac1{\sqrt n}$ に比例するので、誤差を半分にするには $n$ を $4$ 倍にしなければならない。たとえば $n=400$ での誤差の上限は $\frac{0.98}{20}=0.049$、$n=1600$ では $\frac{0.98}{40}=0.0245$ である。ex-iest-poll の $\pm0.048$ は、$p$ の見積もり $0.4$ が $\frac12$ に近いので、上限 $0.049$ とほぼ同じになっている。
主定理 2:分布を仮定しない区間
正規分布による区間は、近似がどのくらい良いかを定理からは言えない。幅を広げてもよければ、分布の形について何も仮定せずに($\sigma$ は既知とする)「確率 $0.95$ 以上」を保証できる。道具は Chebyshev の不等式である。
値が有限個の確率変数 $Y$ の期待値を $m$、分散を $v$ とする。正の数 $c$ について
$$
P\bigl(|Y-m|\ge c\bigr)\le\frac{v}{c^2}
$$
が成り立つ。
方針:分散の和から、ずれが $c$ 以上の項だけを残して小さく見積もる。$Y$ の分布を $(y_i,q_i)$ とする。
段 1(項を捨てる)。分散の定義 $v=\sum_i(y_i-m)^2q_i$ の各項は $0$ 以上なので、$|y_i-m|\ge c$ を満たす $i$ の項だけを残すと、和は小さくなるか変わらない。
$$
v\ge\sum_{i:\ |y_i-m|\ge c}(y_i-m)^2q_i.
$$
段 2(各項を $c^2$ で下から抑える)。残した項では $|y_i-m|\ge c>0$ なので $(y_i-m)^2\ge c^2$ である。$q_i\ge0$ を掛けて足すと
$$
\sum_{i:\ |y_i-m|\ge c}(y_i-m)^2q_i\ge c^2\sum_{i:\ |y_i-m|\ge c}q_i=c^2P\bigl(|Y-m|\ge c\bigr)
$$
である。最後の等号は、$|Y-m|\ge c$ となる値の確率を足したものがその事象の確率だからである。
段 3。段 1 と段 2 から $v\ge c^2P(|Y-m|\ge c)$ で、両辺を $c^2>0$ で割ると主張が得られる。$\square$
この不等式は値が有限個でない確率変数でも成り立つ(GS06 Theorem 8.1、8.3)。大数の法則とさいころの平均 では、同じ不等式から大数の法則を導く。
母集団のとる値が有限個で、母平均が $\mu$、母標準偏差が $\sigma>0$ であるとする。大きさ $n$ の無作為標本の標本平均 $\bar X$ と正の数 $k$ について
$$
P\Bigl(\bar X-k\frac{\sigma}{\sqrt n}<\mu<\bar X+k\frac{\sigma}{\sqrt n}\Bigr)\ge1-\frac1{k^2}
$$
が成り立つ。とくに $k=\sqrt{20}=4.472\ldots$ とすると、右辺は $0.95$ である。
方針:$\bar X$ に lem-iest-chebyshev を使って「大きくずれる確率」を上から抑え、余事象に移る。最後に thm-iest-main と同じ書き換えで「$\mu$ をはさむ」形にする。$d:=\frac{\sigma}{\sqrt n}$ とおく。
段 1(Chebyshev の不等式を使う)。$X_1,\dots,X_n$ はどれも有限個の値しかとらないので、$\bar X$ も有限個の値しかとらない。prop-iest-sample-mean より $E(\bar X)=\mu$、$V(\bar X)=\frac{\sigma^2}n=d^2$ である。lem-iest-chebyshev を $Y=\bar X$、$c=kd$ として使うと
$$
P\bigl(|\bar X-\mu|\ge kd\bigr)\le\frac{d^2}{k^2d^2}=\frac1{k^2}
$$
である。
段 2(余事象)。「$|\bar X-\mu|\ge kd$」の余事象は「$|\bar X-\mu|< kd$」なので
$$
P\bigl(|\bar X-\mu|< kd\bigr)=1-P\bigl(|\bar X-\mu|\ge kd\bigr)\ge1-\frac1{k^2}
$$
である。
段 3($\mu$ をはさむ形にする)。$|\bar X-\mu|< kd$ は $-kd<\bar X-\mu< kd$ と同じで、thm-iest-main の証明の段 2 と同じ移項により $\bar X-kd<\mu<\bar X+kd$ と同値である。同じ事象なので確率も等しく、主張が得られる。$k=\sqrt{20}$ なら $1-\frac1{20}=0.95$ である。$\square$
- ex-iest-mean の製品($\sigma=2$、$n=100$、$\bar x=50.3$)では、$k=\sqrt{20}$ として $4.472\ldots\times0.2=0.894\ldots$ なので、保証つきの区間は $49.405\ldots<\mu<51.194\ldots$ である。正規近似の区間の半分の幅 $0.392$ の約 $2.28$ 倍($4.472\div1.96$)になる。
- ex-iest-poll の支持率では $\sigma=\sqrt{p(1-p)}$ が分からない。しかし prop-iest-pq より $\sigma\le\frac12$ なので、$\frac12$ で置き換えると区間は広くなるだけで、$p$ を含む確率は下がらない。$\sqrt{20}\cdot\frac12\cdot\frac1{\sqrt{400}}=0.1118\ldots$ なので、$0.288\ldots< p<0.511\ldots$ は、正規近似を使わずに確率 $0.95$ 以上で $p$ を含む区間の作り方から得られる。
正規近似の区間 thm-iest-main は幅が狭いかわりに「正規分布に近い」ことに頼り、thm-iest-guaranteed は分布の形に頼らない($\sigma$ が分かっていることは要る)かわりに幅が約 $2.3$ 倍になる。実際の調査で正規近似が使われるのは、$n$ が大きいときには近似がよく合うことが経験的にも数値的にも確かめられているからである(次の節の図3 の $n=400$)。
例と反例
信頼区間の公式は、読み方を誤ったり、仮定を外したりすると、「$95\%$」が成り立たなくなる。
| 外した仮定・誤り | 崩れる主張 | ボックス |
|---|---|---|
| (読み方の誤り)観測した後の区間について確率を言う | 「$\mu$ がこの区間に入る確率は $95\%$」 | ex-iest-misread |
| 標本が大きい(正規近似) | 区間が $p$ を含む確率が $0.95$ に近いこと | ex-iest-small-n |
| 母比率が $0$ や $1$ に近すぎない | 同上 | ex-iest-small-p |
| 母標準偏差 $\sigma$ が分かっている | 同上($\sigma$ を標本から見積もると区間が狭すぎる) | ex-iest-unknown-sigma |
| 標本が独立 | $V(\bar X)=\frac{\sigma^2}n$、したがって区間の信頼度 | ex-iest-dependent |
ex-iest-simulation の図2 では、$26$ 回目の区間は $\mu=50$ を含んでいない。この区間について「$\mu$ がこの区間に入る確率は $95\%$」と言うのは誤りで、実際には $\mu$ はこの区間に入っていない。$27$ 回目の区間は $\mu$ を含んでいる。観測した後の区間について言えるのは、$\mu$ を含むか含まないかのどちらかであること(あえて確率で言えば $1$ か $0$)で、どちらなのかは $\mu$ を知らない限り分からない。
実際の調査では $\mu$ を知らないので、手元の 1 本がどちらなのかは分からない。分からないことと、確率が $0.95$ であることは別のことである。thm-iest-main が保証するのは、「区間を作る前に見た、作り方が成功する確率」が $0.95$ であることだけである(rem-iest-meaning)。
満たさない条件:確率を言う対象が、まだ標本をとっていない確率的な区間であること。破る主張:「観測した区間が $\mu$ を含む確率が $0.95$」。
母比率 $p=\frac12$ の母集団から $n=10$ 人を選ぶ。支持する人数を $K$ とすると、$K$ は二項分布に従い $P(K=k)=\binom{10}k\big/1024$ である。$\hat p=\frac K{10}$ の区間 $\hat p\pm1.96\sqrt{\hat p(1-\hat p)/10}$ が $\frac12$ を含むかどうかを、$k$ ごとに調べる。
- $k=2$:$\hat p=0.2$、$1.96\sqrt{0.2\cdot0.8/10}=1.96\sqrt{0.016}=0.247\ldots$ で、上端は $0.447\ldots<0.5$。含まない。
- $k=3$:$\hat p=0.3$、$1.96\sqrt{0.3\cdot0.7/10}=1.96\sqrt{0.021}=0.284\ldots$ で、上端は $0.584\ldots\ge0.5$。含む。
- $k=0,1$ では上端はさらに小さい($k=0$ では区間は $[0,0]$、$k=1$ では上端 $0.1+0.185\ldots=0.285\ldots$)ので含まない。$k=4,5,6$ は $\hat p$ が $\frac12$ に近く、含む。$k$ と $10-k$ は $\frac12$ について対称なので、$k=7$ は含み、$k=8,9,10$ は含まない。
したがって区間が $\frac12$ を含む確率は
$$ P(3\le K\le7)=\frac{120+210+252+210+120}{1024}=\frac{912}{1024}=0.890625 $$
で、$0.95$ より小さい。満たさない条件:$n$ が大きいこと。破る主張:信頼度が $0.95$ に近いこと。
母比率 $p=0.02$ の母集団から $n=50$ 人を選ぶ。$1$ 人も当てはまらない確率は $0.98^{50}=0.364\ldots$ である。このとき $\hat p=0$ で、区間は $0\pm1.96\sqrt{0\cdot1/50}$、つまり $[0,0]$ の 1 点になり、$p=0.02$ を含まない。したがって、区間が $p$ を含む確率は $1-0.364\ldots=0.6358\ldots$ 以下である。すべての $k$ について計算すると $0.6353\ldots$ になり、この上限よりわずかに小さい。$k\ge6$($\hat p\ge0.12$)でも区間の下端が $0.02$ を超えて $p$ を含まないので、その確率 $P(K\ge6)=0.00047\ldots$ の分だけ減るからである。
図3 は、区間が本当の $p$ を含む確率を、すべての $k$ について二項分布の確率を足して厳密に計算したものである。$n=400$ では $p$ が極端でなければ $0.95$ に近いが、$n=10$ や、$n=50$ でも $p$ が $0$ や $1$ に近いところでは、大きく下回る。満たさない条件:$np$ が十分大きいこと。破る主張:信頼度が $0.95$ に近いこと。
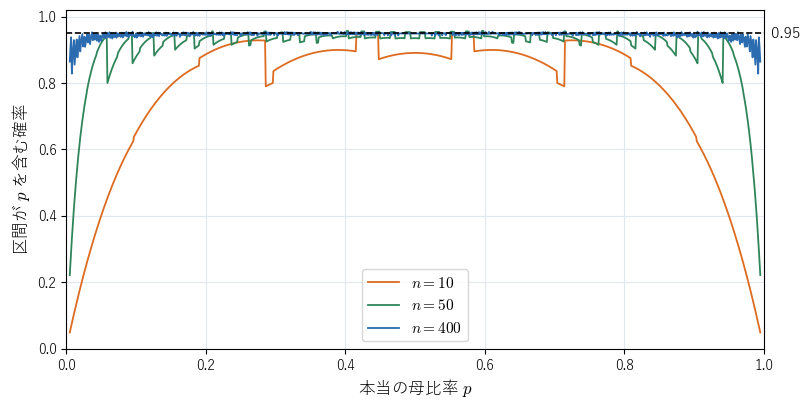 図3:母比率の信頼区間 $\hat p\pm1.96\sqrt{\hat p(1-\hat p)/n}$ が本当の $p$ を含む確率(二項分布による厳密な計算)。破線が 0.95。標本が小さいときや、$p$ が 0 や 1 に近いときに、0.95 を大きく下回ることを見る図。
thm-iest-main は $\sigma$ が分かっていることを仮定した。$\sigma$ が分からないとき、標本から
$$
s:=\sqrt{\frac1{n-1}\sum_{k=1}^n(X_k-\bar X)^2}
$$
を計算して $\sigma$ の代わりに使うことがある。母集団が正規分布でも、$n$ が小さいとこれは危ない。$n=5$ のとき、区間 $\bar X\pm1.96\frac{s}{\sqrt5}$ が $\mu$ を含む確率を数値計算すると $0.878\ldots$ で、$0.95$ に届かない。$s$ 自体が偶然で小さくなることがあり、そのとき区間が狭くなりすぎるからである。$n=10$ では $0.918\ldots$、$n=30$ では $0.940\ldots$ で、$n$ が大きくなると $0.95$ に近づく。
大学では、$\frac{\bar X-\mu}{s/\sqrt n}$ の分布(自由度 $n-1$ の t分布)を使って $1.96$ の代わりの数を決める。$n=5$ ではその数は $2.776\ldots$ である(数値計算。本記事では t 分布を扱わない)。満たさない条件:$\sigma$ が分かっていること。破る主張:信頼度が $0.95$ であること。
1 人を選んで同じ質問を $400$ 回すると、答えは毎回同じなので $X_1=X_2=\dots=X_{400}$ である。$X_k$ は独立でない。標本比率 $\hat p$ は $X_1$ に等しく、$0$ か $1$ である。どちらの場合も $\hat p(1-\hat p)=0$ なので、区間は $[0,0]$ か $[1,1]$ の 1 点になる。$0< p<1$ なら、区間が $p$ を含む確率は $0$ である。
母平均の場合も同じである。$X_1=\dots=X_{100}$ なら $\bar X=X_1$ で、$V(\bar X)=\sigma^2$ であって $\frac{\sigma^2}{100}$ ではない(prop-iest-sample-mean の段 3 が使えない)。母集団が正規分布なら、区間 $\bar X\pm1.96\frac{\sigma}{10}$ が $\mu$ を含む確率は $P(|Z|\le0.196)=0.155\ldots$ しかない。
満たさない条件:標本の独立性。破る主張:$V(\bar X)=\frac{\sigma^2}n$ と、区間の信頼度。独立でない確率変数の和の分散が変わることは 確率変数の期待値と分散 の反例でも見た。
大学数学で見る:推定量と 2 つの考え方
標本から計算して母集団の量を推し量る確率変数を 推定量 という。標本平均 $\bar X$ は母平均 $\mu$ の推定量で、次の 2 つの良い性質をもつ。
- 不偏性:$E(\bar X)=\mu$(prop-iest-sample-mean)。平均的には真の値に当たる。
- 一致性:どんな $\varepsilon>0$ についても $P(|\bar X-\mu|\ge\varepsilon)\to0$($n\to\infty$)。これは大数の法則で、lem-iest-chebyshev から出る(大数の法則とさいころの平均)。
ex-iest-unknown-sigma の $s^2$ で $n$ ではなく $n-1$ で割るのは、$E(s^2)=\sigma^2$(不偏性)となるようにするためである。本記事ではこの等式を証明しない。計算は 推定量のよさ で扱う。
ex-iest-misread で見たように、ここまでの考え方(頻度論)では $\mu$ は決まった数で、確率をもつのは標本と区間のほうである。これに対し、$\mu$ そのものを確率変数とみて、調べる前の見込み(事前分布)を決め、観測したデータで Bayesの定理 により更新する考え方(ベイズ統計)もある。そこでは「データを見た後で $\mu$ がこの区間に入る確率」を考えることができ、その確率が $0.95$ になる区間を 信用区間 という。答えは事前分布の選び方によって変わる。Bayes の定理そのものは 確率の定義と条件付き確率 で扱う。
さらに先へ
thm-iest-main の証明で、「$Z_n$ が $\pm1.96$ の間にある」ことと「区間が $\mu$ を含む」ことを同じ事象として書き換えた。この書き換えを逆向きに読むと、「母平均が $\mu_0$ だと仮定すると、観測した標本平均はありそうにない」かどうかを判断する方法になる。これが 仮説検定(高校数学) で、信頼区間と検定は同じ不等式の 2 つの読み方である。大学では、信頼区間 は母平均・母比率に限らず一般の母数について作られ、小さい標本では t分布 や二項分布の厳密な計算が使われる。正規分布そのものの性質は 正規分布(高校数学)、正規近似の根拠は 中心極限定理 で扱う。
関連項目
- 前提: 確率変数の期待値と分散, 標本平均の分散, 正規分布
- 前に読む: 確率変数の期待値と分散, 正規分布(高校数学), 標本平均の分散
- 次に読む: 仮説検定(高校数学)
- 関連(高校数学): 大数の法則とさいころの平均, 二項分布から正規分布へ, 母集団と標本, 2次関数の最大・最小
- 発展: 信頼区間, 中心極限定理, t分布, 推定量
- 比較: Chebyshevの不等式, Bayesの定理
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する