度数分布とヒストグラム
概要
度数分布とヒストグラム(frequency distribution and histogram)とは、データの値の範囲を重ならない階級に区切って各階級に入る個数(度数)を数えた表と、それを隣りあう長方形の柱で描いた図である。階級の真ん中の値を階級値、度数をデータの個数で割った値を相対度数という。幅がすべて $h$ の階級で各データを階級値に置き換えて計算した平均は、もとの平均とのずれが $\frac h2$ 以下である。柱の高さを「相対度数 $\mathbin{÷}$ 階級の幅」にすると、柱の面積が相対度数になり面積の合計は $1$ になるので、幅の違う階級があっても分布を正しく読める。各階級の中に一様に散らばると仮定した分布の分散は、階級値で計算した分散に $\frac{h^2}{12}$ を足したものである。階級が粗すぎると 2 つの山が 1 つに見え、細かすぎると形が読めない。
高校での出発点:20 個の値を表にまとめる
データの値が 20 個くらいなら、そのまま並べても全体の様子はなんとか読める。値が 200 個、2000 個になると、並べただけでは何も見えない。そこで、値の範囲をいくつかの区間に区切り、各区間に入る値の個数を数えて表にする。これが度数分布表で、その表を棒の図にしたものがヒストグラムである。
まず小さなデータで、表を作るところから始める。
20 人の通学時間(分)を小さい順に並べると、次のとおりだったとする。
$$
12,15,18,22,23,25,27,28,31,33,\quad 34,36,38,41,44,47,52,58,63,71
$$
$10$ 分から $80$ 分までを、幅 $10$ 分の区間 $10$ 以上 $20$ 未満、$20$ 以上 $30$ 未満、……、$70$ 以上 $80$ 未満に区切り、各区間に入る人数を数える。
- $10$ 以上 $20$ 未満:$12,15,18$ の $3$ 人。
- $20$ 以上 $30$ 未満:$22,23,25,27,28$ の $5$ 人。
- $30$ 以上 $40$ 未満:$31,33,34,36,38$ の $5$ 人。
- $40$ 以上 $50$ 未満:$41,44,47$ の $3$ 人。
- $50$ 以上 $60$ 未満:$52,58$ の $2$ 人。
- $60$ 以上 $70$ 未満:$63$ の $1$ 人。$70$ 以上 $80$ 未満:$71$ の $1$ 人。
人数の合計は $3+5+5+3+2+1+1=20$ で、全員をちょうど 1 回ずつ数えている。
ex-fdh-commute のデータの平均は、20 個の値の合計 $718$ を $20$ で割って
$$
\bar x=\frac{718}{20}=35.9\ \text{(分)}
$$
である。一方、各区間の人を全員その区間の真ん中の値($15,25,\dots,75$)にいるとみなして平均をとると
$$
\frac{15\cdot3+25\cdot5+35\cdot5+45\cdot3+55\cdot2+65\cdot1+75\cdot1}{20}=\frac{730}{20}=36.5\ \text{(分)}
$$
になる。差は $36.5-35.9=0.6$ 分である。
ex-fdh-two-means の 2 つ目の計算は、もとの 20 個の値を知らなくても、区間ごとの人数さえ分かればできる。そのかわり、答えは本当の平均から少しずれた。この記事では次の問いに答える。
- 表から計算した平均は、本当の平均からどれだけずれうるか。→ thm-fdh-mean-error
- ヒストグラムの棒の高さは、何にすれば分布を正しく読めるか。→ thm-fdh-area
- 区間の幅や区切り方を変えると、図の見え方はどう変わるか。→ ex-fdh-bimodal、ex-fdh-unequal
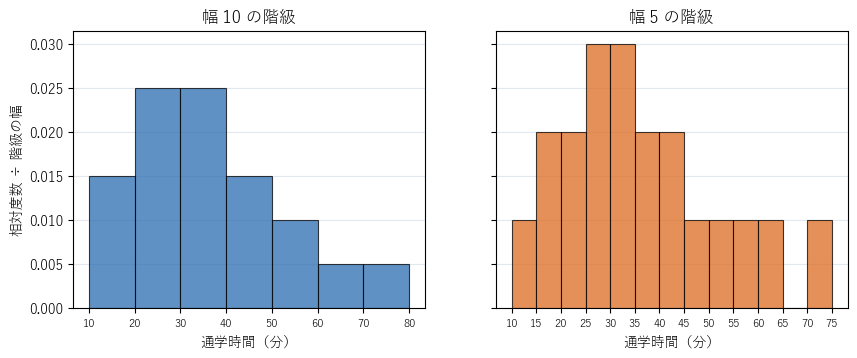 同じ 20 人の通学時間を、幅 10 の階級(左)と幅 5 の階級(右)で描いたヒストグラム。高さは相対度数を階級の幅で割った値にしてある
図 1 は同じデータを 2 通りの幅で描いたものである。左の幅 $10$ では $20$ 分台と $30$ 分台が同じ高さの山になり、右の幅 $5$ では $25$ 分から $35$ 分に山があって、右に長い裾が続く。どちらも同じ 20 個の値から描いた図であり、どちらが正しいというものではない。区切り方で見え方が変わることは、ex-fdh-bimodal でもう一度扱う。高校の言葉 この記事で示すこと 大学の言葉 階級値で計算した平均 ずれは階級の幅の半分以下(thm-fdh-mean-error) 丸めの誤差の評価 ヒストグラムの柱の高さ 相対度数 $\mathbin{÷}$ 幅にすると面積が相対度数(thm-fdh-area) 密度の推定 階級値で計算した分散 一様に散らばると仮定した分布の分散は、これより $\frac{h^2}{12}$ 大きい(prop-fdh-sheppard) 丸めによる分散の補正
度数分布表の言葉
$N$ 個の数値データ $x_1,x_2,\dots,x_N$ を考える。
- データの値の範囲を、互いに重ならない区間 $a_0\le x< a_1$、$a_1\le x< a_2$、……、$a_{m-1}\le x< a_m$($a_0< a_1<\dots< a_m$)に分け、どのデータもどれか 1 つの区間に入るようにする。各区間を 階級、$a_k-a_{k-1}$ を 階級の幅 という。
- 階級 $a_{k-1}\le x< a_k$ の真ん中の値 $c_k=\dfrac{a_{k-1}+a_k}2$ を 階級値 という。
- 階級に入るデータの個数 $f_k$ を 度数 という。$f_1+f_2+\dots+f_m=N$ である。
- $\dfrac{f_k}N$ を 相対度数 という。相対度数の合計は $1$ である。
- 最初の階級から $k$ 番目の階級までの度数の和 $F_k=f_1+\dots+f_k$ を 累積度数、$\dfrac{F_k}N$ を 累積相対度数 という。
階級・階級値・度数などを並べた表を 度数分布表 という。度数分布表から、横軸に階級、縦軸に高さをとった長方形(柱)を隣どうし隙間なく並べた図を ヒストグラム という(柱の高さの決め方は thm-fdh-area で述べる)。
この記事では、階級を「左端を含み右端を含まない」区間にとる。どちらの端を含めるかは教科書や資料によって違うが、どの値もちょうど 1 つの階級に入るように決めることが大事である(決めないと何が起こるかは ex-fdh-boundary)。
ex-fdh-commute を度数分布表にすると、次のようになる($N=20$)。
| 階級(分) | 階級値 | 度数 | 相対度数 | 累積相対度数 |
|---|---|---|---|---|
| $10$ 以上 $20$ 未満 | $15$ | $3$ | $0.15$ | $0.15$ |
| $20$ 以上 $30$ 未満 | $25$ | $5$ | $0.25$ | $0.40$ |
| $30$ 以上 $40$ 未満 | $35$ | $5$ | $0.25$ | $0.65$ |
| $40$ 以上 $50$ 未満 | $45$ | $3$ | $0.15$ | $0.80$ |
| $50$ 以上 $60$ 未満 | $55$ | $2$ | $0.10$ | $0.90$ |
| $60$ 以上 $70$ 未満 | $65$ | $1$ | $0.05$ | $0.95$ |
| $70$ 以上 $80$ 未満 | $75$ | $1$ | $0.05$ | $1.00$ |
累積相対度数を見ると、$30$ 分未満の人が全体の $40\%$、$40$ 分未満の人が $65\%$ である。累積相対度数が $0.5$ をまたぐのは $30$ 以上 $40$ 未満の階級なので、中央値はこの階級にある。実際、中央値は 10 番目と 11 番目の値の平均 $\dfrac{33+34}2=33.5$ で、確かにこの階級に入っている。
同じデータを幅 $5$ の階級で数えると、$10$ 以上 $15$ 未満から $70$ 以上 $75$ 未満までの 13 個の階級の度数は、順に
$$
1,\ 2,\ 2,\ 3,\ 3,\ 2,\ 2,\ 1,\ 1,\ 1,\ 1,\ 0,\ 1
$$
となる(合計 $20$)。階級値は $12.5,17.5,\dots,72.5$ である。階級値で計算した平均は
$$
\frac{12.5\cdot1+17.5\cdot2+22.5\cdot2+27.5\cdot3+32.5\cdot3+37.5\cdot2+42.5\cdot2+47.5+52.5+57.5+62.5+72.5}{20}=\frac{725}{20}=36.25
$$
で、本当の平均 $35.9$ との差は $0.35$ である。幅 $10$ のときの差 $0.6$ より小さい。
主定理 1:階級値で計算した平均のずれ
ex-fdh-two-means と ex-fdh-table5 では、幅 $10$ のときずれが $0.6$、幅 $5$ のとき $0.35$ だった。どちらも階級の幅の半分($5$ と $2.5$)よりずっと小さい。これは偶然ではない。
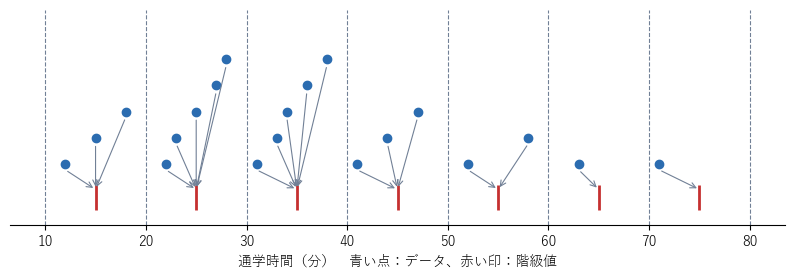 幅 10 の階級で、各データ(青い点)を階級値(赤い印)へ動かしたところ。どの点も動く距離は 5 以下である
図 2 のように、階級値で計算することは、各データを自分の階級の真ん中へ動かすことである。1 つの値が動く距離は、階級の幅の半分を超えない。平均は値の和を $N$ で割ったものなので、平均が動く距離も幅の半分を超えないはずである。これを式で確かめる。
$N$ 個のデータ $x_1,\dots,x_N$ を、幅がすべて $h$ の階級に分ける。各データ $x_i$ を、それが入る階級の階級値 $c(x_i)$ に置き換えて計算した平均を
$$
\bar x_G=\frac1N\sum_{i=1}^Nc(x_i)
$$
とし、もとのデータの平均を $\bar x=\dfrac1N\displaystyle\sum_{i=1}^Nx_i$ とする。このとき
$$
\lvert\bar x_G-\bar x\rvert\le\frac h2
$$
が成り立つ。等号が成り立つのは、すべてのデータがそれぞれの階級の左端にあるときに限る。
$\bar x_G$ は、度数分布表から計算する平均 $\dfrac1N\displaystyle\sum_{k=1}^mc_kf_k$ と同じものである。階級 $k$ に入る $f_k$ 個のデータがどれも $c_k$ に置き換わるので、$\displaystyle\sum_{i=1}^Nc(x_i)$ の中には $c_k$ がちょうど $f_k$ 回現れるからである。
方針:平均の差を「1 つずつのずれ」の平均に書き直し、1 つずつのずれを幅の半分で押さえる。
段 1(1 つの値のずれ).$x_i$ が階級 $a\le x< a+h$ に入るとする。階級値は $c(x_i)=a+\dfrac h2$ である。$a\le x_i< a+h$ の各辺から $a+\dfrac h2$ を引くと
$$
-\frac h2\le x_i-c(x_i)<\frac h2
$$
となる。したがって $\lvert c(x_i)-x_i\rvert\le\dfrac h2$ である。
段 2(平均の差を和で書く).$\bar x_G$ と $\bar x$ の定義から
$$
\bar x_G-\bar x=\frac1N\sum_{i=1}^Nc(x_i)-\frac1N\sum_{i=1}^Nx_i=\frac1N\sum_{i=1}^N\bigl(c(x_i)-x_i\bigr)
$$
である。
段 3(三角不等式).和の絶対値は絶対値の和以下である(三角不等式 $\lvert a+b\rvert\le\lvert a\rvert+\lvert b\rvert$ を $N-1$ 回くり返して使う。絶対値と三角不等式)。段 2 と段 1 から
$$
\lvert\bar x_G-\bar x\rvert=\frac1N\left\lvert\sum_{i=1}^N\bigl(c(x_i)-x_i\bigr)\right\rvert\le\frac1N\sum_{i=1}^N\bigl\lvert c(x_i)-x_i\bigr\rvert\le\frac1N\cdot\underbrace{\frac h2+\dots+\frac h2}_{N\text{ 個}}=\frac h2
$$
が成り立つ。
段 4(等号).すべての $x_i$ が階級の左端にあると、段 1 で $c(x_i)-x_i=\dfrac h2$ がすべての $i$ で成り立つ。このとき段 2 の和は $\dfrac h2\cdot N$ になり、$\bar x_G-\bar x=\dfrac h2$ である。逆に等号が成り立つなら、段 3 の最後の $\le$ が等号なので、すべての $i$ で $\lvert c(x_i)-x_i\rvert=\dfrac h2$ である。段 1 の範囲 $-\dfrac h2\le x_i-c(x_i)<\dfrac h2$ の中でこれが起こるのは $x_i-c(x_i)=-\dfrac h2$、つまり $x_i$ が階級の左端にあるときだけである。
3 個のデータ $10,20,30$ を、幅 $10$ の階級 $10$ 以上 $20$ 未満、$20$ 以上 $30$ 未満、$30$ 以上 $40$ 未満に分ける。どの値も階級の左端にある。本当の平均は $\dfrac{10+20+30}3=20$、階級値で計算した平均は $\dfrac{15+25+35}3=25$ で、差は $5=\dfrac{10}2$ である。thm-fdh-mean-error の不等式は、これ以上よくできない。
ex-fdh-two-means のずれ $0.6$ が幅の半分 $5$ よりずっと小さかったのは、階級値より大きいデータと小さいデータの両方があり、段 2 の和の中でずれが打ち消しあったからである。定理が保証するのは「どんなデータでも $\frac h2$ を超えない」ことだけで、実際のずれはたいていもっと小さい。階級の幅 $h$ を小さくすれば、保証されるずれも小さくなる。
主定理 2:ヒストグラムは面積で読む
ヒストグラムの柱の高さを度数そのものにする描き方は、階級の幅がすべて等しいときには問題がない。どの柱も幅が同じなので、高さの比と面積の比が一致するからである。ところが、データの少ない端の方の階級をまとめて幅を広げると、事情が変わる。
ex-fdh-commute のデータで、人数の少ない $40$ 分以上をまとめ、階級を $10$ 以上 $20$ 未満、$20$ 以上 $30$ 未満、$30$ 以上 $40$ 未満、$40$ 以上 $80$ 未満の 4 つにする。度数は順に $3,5,5,7$ である。
度数をそのまま柱の高さにすると、$40$ 以上 $80$ 未満の柱が一番高く、しかも幅が 4 倍あるので、面積はほかの柱よりはるかに大きい(図 3 の左)。図だけを見ると「40 分以上の人がいちばん多く集まっている」ように見える。しかし実際には、この階級の $7$ 人は $40$ 分の幅に散らばっていて、$10$ 分あたりにすると $\dfrac74=1.75$ 人しかいない。$20$ 以上 $30$ 未満の階級の $10$ 分あたり $5$ 人よりずっと少ない。
柱の高さを「相対度数 $\mathbin{÷}$ 階級の幅」にすると、高さは順に
$$
\frac{3/20}{10}=0.015,\quad \frac{5/20}{10}=0.025,\quad \frac{5/20}{10}=0.025,\quad \frac{7/20}{40}=0.00875
$$
となり、$40$ 以上 $80$ 未満の柱はいちばん低くなる(図 3 の右)。
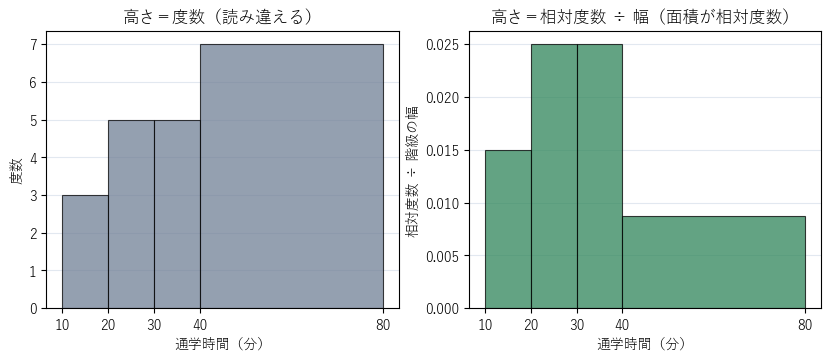 幅の違う階級で、高さを度数にした図(左)と、高さを相対度数÷幅にした図(右)。左では広い階級が大きく見えるが、右では面積が相対度数になる
図 3 の右の描き方では、柱の面積がその階級の相対度数に等しい。これが一般に成り立つことを述べる。
def-fdh-table の度数分布表で、階級 $k$ の幅を $h_k=a_k-a_{k-1}$、相対度数を $\dfrac{f_k}N$ とする。階級 $k$ の柱の高さを
$$
d_k=\frac{f_k/N}{h_k}\qquad\Bigl(\text{相対度数}\mathbin{÷}\text{階級の幅}\Bigr)
$$
にすると、次が成り立つ。
(R1) 階級 $k$ の柱の面積は、その階級の相対度数 $\dfrac{f_k}N$ に等しい。
(R2) すべての柱の面積の合計は $1$ である。
(R3) いくつかの隣りあう階級を 1 つにまとめても、まとめた部分の柱の面積の合計は変わらない。
条件 (i):柱は幅 $h_k$、高さ $d_k$ の長方形なので、面積は $h_k\cdot d_k=h_k\cdot\dfrac{f_k/N}{h_k}=\dfrac{f_k}N$ である。
条件 (ii):(i) から、面積の合計は $\dfrac{f_1}N+\dots+\dfrac{f_m}N=\dfrac{f_1+\dots+f_m}N$ である。度数の合計は $N$(def-fdh-table)なので、合計は $\dfrac NN=1$ である。
条件 (iii):階級 $k$ から $l$ までをまとめると、まとめた階級の度数は $f_k+\dots+f_l$ になる。(i) をまとめた階級に使うと、その柱の面積は $\dfrac{f_k+\dots+f_l}N$ で、まとめる前の柱の面積の和 $\dfrac{f_k}N+\dots+\dfrac{f_l}N$ に等しい。
ex-fdh-unequal の高さで面積を計算すると
$$
10\cdot0.015+10\cdot0.025+10\cdot0.025+40\cdot0.00875=0.15+0.25+0.25+0.35=1
$$
である。$40$ 以上 $80$ 未満の柱の面積 $0.35$ は、幅 $10$ の表(ex-fdh-table10)の $40$ 分以上の 4 つの階級の相対度数の和 $0.15+0.10+0.05+0.05=0.35$ に等しい。まとめても面積は変わらない(thm-fdh-area の条件 (iii))。
面積で読むヒストグラムでは、「$a$ 分以上 $b$ 分未満の人の割合」が、$a$ から $b$ までの柱の面積として読める($a$、$b$ が階級の境目のとき)。高さの意味は「幅 $1$ あたりの相対度数」で、データが密に集まっている所ほど高い。度数そのものを高さにした図は、階級の幅がすべて等しいときには、面積で読む図を縦に $N\cdot h$ 倍しただけのものになる。そのため形は同じで、どちらで描いてもよい。
同じ「高さ = 割合 $\mathbin{÷}$ 幅」の考え方を、データではなく確率に当てはめ、幅を細かくしていった極限が確率密度関数である。その話は 確率密度関数と連続型確率変数 の例「度数分布の高さを『確率 ÷ 幅』にする」で扱っている。
階級値で計算した分散
分散も、階級値を使って度数分布表から計算できる。
thm-fdh-mean-error と同じ記号で、各データを階級値に置き換えて計算した分散
$$
s_G^2=\frac1N\sum_{k=1}^mc_k^2f_k-\bar x_G^2
$$
を、階級値で計算した分散 という。
分散は「2 乗の平均 − 平均の 2 乗」で計算できる(平均・中央値・分散 の例「分散の公式」)ので、$s_G^2$ は階級値のデータ($c_k$ が $f_k$ 個ずつ)の分散そのものである。
ex-fdh-commute のデータの本当の分散は、2 乗の平均から平均の 2 乗を引いて $s^2=245.89$ である。
- 幅 $10$:$\dfrac1{20}(15^2\cdot3+25^2\cdot5+35^2\cdot5+45^2\cdot3+55^2\cdot2+65^2+75^2)-36.5^2=\dfrac{31900}{20}-1332.25=1595-1332.25=262.75$。
- 幅 $5$:同じように計算して $s_G^2=242.1875$。
幅 $10$ では本当の値より大きく、幅 $5$ では少し小さい。
各階級の中でデータがどう散らばっているかは、度数分布表からは分からない。そこで「各階級の中でデータが一様に散らばっている」と仮定してみる。すると分散について、次のことが言える。
幅がすべて $h$ の度数分布表で、階級 $k$ の相対度数 $\dfrac{f_k}N$ を、その階級の区間に一様に広げた分布(thm-fdh-area の高さ $d_k$ を密度とする分布)を考える。この分布の平均は $\bar x_G$、分散は
$$
s_G^2+\frac{h^2}{12}
$$
である。
要点:階級の中の一様な散らばりは、階級値からのずれ $u$ が $-\frac h2$ から $\frac h2$ まで一様に広がることで、$u$ の平均は $0$、$u^2$ の平均は $\frac{h^2}{12}$ である。分散は「2 乗の平均 − 平均の 2 乗」なので、2 乗の平均だけが $\frac{h^2}{12}$ 増える。
積分による計算を開く
段 1.階級 $k$ の中の点を $x=c_k+u$($-\frac h2\le u\le\frac h2$)と書く。この区間で密度は一定の値 $d_k=\frac{f_k}{Nh}$ である。$\int_{-h/2}^{h/2}du=h$、$\int_{-h/2}^{h/2}u\,du=0$、$\int_{-h/2}^{h/2}u^2\,du=\Bigl[\frac{u^3}3\Bigr]_{-h/2}^{h/2}=\frac{h^3}{12}$ である。
段 2(平均).階級 $k$ の部分の寄与は $\int_{-h/2}^{h/2}(c_k+u)\,d_k\,du=d_k(c_kh+0)=\frac{f_k}Nc_k$ である。$k$ について足すと $\frac1N\sum_kc_kf_k=\bar x_G$ になる。
段 3(2 乗の平均).階級 $k$ の部分の寄与は $\int_{-h/2}^{h/2}(c_k+u)^2\,d_k\,du=d_k\Bigl(c_k^2h+2c_k\cdot0+\frac{h^3}{12}\Bigr)=\frac{f_k}N\Bigl(c_k^2+\frac{h^2}{12}\Bigr)$ である。$k$ について足し、$\sum_k\frac{f_k}N=1$ を使うと、2 乗の平均は $\frac1N\sum_kc_k^2f_k+\frac{h^2}{12}$ である。
段 4.分散は 2 乗の平均から平均の 2 乗を引いたものなので、$\frac1N\sum_kc_k^2f_k+\frac{h^2}{12}-\bar x_G^2=s_G^2+\frac{h^2}{12}$ である。
$\dfrac{h^2}{12}$ は、幅 $h$ の区間に一様に散らばった値の分散である。連続型の確率変数の分散の定義と計算は 確率密度関数と連続型確率変数 にある。
prop-fdh-sheppard が述べるのは、仮定した「一様に広げた分布」の分散であって、もとのデータの分散ではない。ex-fdh-var で確かめると、幅 $5$ では $242.1875+\dfrac{25}{12}=244.27\ldots$ となって本当の分散 $245.89$ に近づくが、幅 $10$ では $262.75+\dfrac{100}{12}=271.08\ldots$ となって、かえって遠ざかる。データが少なく、階級の中の散らばりが一様から遠いと、補正は当てにならない。どんな条件のもとで $s_G^2+\frac{h^2}{12}$ が本当の分散のよい近似になるかは、この記事では扱わない。
例と反例
度数分布表とヒストグラムを作るときの約束を 1 つ外すと、何が崩れるかを表にする。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 高さを度数にするなら、階級の幅がすべて等しい | ex-fdh-unequal($40$ 以上 $80$ 未満をまとめる) | 柱の大きさで人の集まり方が読める |
| どの値もちょうど 1 つの階級に入る | ex-fdh-boundary(両端を含む階級) | 度数の合計が $N$ になる |
| 階級の幅が山の形に比べて十分に細かい | ex-fdh-bimodal(幅 $8$ の階級) | 山の数が図から読める |
| 階級の数がデータの数に比べて多すぎない | ex-fdh-too-fine(幅 $1$ の階級) | 柱の高さの並びから分布の形が読める |
5 個のデータ $10,20,20,25,30$ を、「$10$ 以上 $20$ 以下」「$20$ 以上 $30$ 以下」の 2 つの階級に分ける。両方の階級が境目の $20$ を含んでいるので、$20$ の 2 個はどちらの階級にも数えられる。度数は $10,20,20$ の $3$ と $20,20,25,30$ の $4$ で、合計は $7$ になり、データの個数 $5$ を超える。相対度数の合計も $\dfrac35+\dfrac45=\dfrac75\ne1$ になり、thm-fdh-area の条件 (ii) が崩れる。「左端を含み右端を含まない」のように、端の扱いを 1 つに決めれば起こらない。
ある部の 1 年生と 3 年生、合わせて 18 人の記録が次のとおりだったとする。
$$
29,31,32,33,34,34,35,35,38,\quad 41,44,44,45,46,46,47,49,51
$$
幅 $4$ の階級($28$ 以上 $32$ 未満から $48$ 以上 $52$ 未満まで)で数えると、度数は $2,6,1,1,6,2$ で、$32$〜$36$ と $44$〜$48$ に 2 つの山があり、真ん中がへこむ(図 4 の左)。
同じデータを幅 $8$ の階級($24$ 以上 $32$ 未満から $48$ 以上 $56$ 未満まで)で数えると、度数は $2,7,7,2$ になる。$32$ 以上 $40$ 未満の階級には左の山の 6 個とへこみの $38$ が、$40$ 以上 $48$ 未満の階級にはへこみの $41$ と右の山の 6 個が入り、へこみが両側の山に吸収される。柱は $2,7,7,2$ と真ん中が高い 1 つの山に見える(図 4 の右)。2 つの集団が混ざっていることは、この図からは読めない。
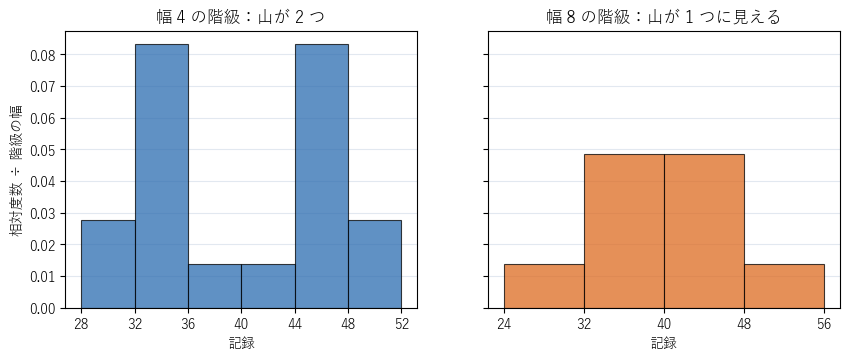 同じ 18 個のデータを、幅 4 の階級(左)と幅 8 の階級(右)で描いたヒストグラム。左では山が 2 つ見えるが、右では 1 つの山に見える
ex-fdh-commute の 20 個の値はすべて異なる整数なので、幅 $1$ の階級($12$ 以上 $13$ 未満、$13$ 以上 $14$ 未満、……)で数えると、どの階級の度数も $0$ か $1$ になる。$12$ から $71$ までの 60 個の階級のうち、20 個の柱が同じ高さで立ち、残りの 40 個は高さ $0$ である。柱の高さの並びは値がどこにあるかを示すだけで、「$20$ 分台から $30$ 分台に多い」という形は読めない。thm-fdh-mean-error のずれの上限 $\frac h2=0.5$ は小さくなったが、図としての役目は果たしていない。
2 つの ex-fdh-bimodal と ex-fdh-too-fine は、階級の幅を「粗すぎず細かすぎず」に選ぶ必要があることを示している。どちらの図も数え間違いはしていない。区切り方を変えて何通りか描いてみて、どの図でも共通に見える特徴を読むのが安全である。
大学数学で見る:ヒストグラムは密度の推定
大学の統計学では、データを「ある確率分布から取り出された標本」とみなし、ヒストグラムをその分布の密度関数(確率密度関数と連続型確率変数)を推定する道具と考える。thm-fdh-area の高さ $d_k$ は、面積の合計が $1$ になるように正規化したヒストグラムで、NIS12 の 1.3.3.14 節も、度数を「データの個数 × 階級の幅」で割ると柱の下の面積が $1$ になると述べている。
階級の幅とデータの数の釣り合いを開く
密度の推定として見ると、階級の幅 $h$ には 2 つの向きの誤差がある。
- $h$ が大きいと、階級の中の細かい形がならされる(ex-fdh-bimodal)。thm-fdh-mean-error の上限 $\frac h2$ や prop-fdh-sheppard の $\frac{h^2}{12}$ も、幅を大きくすると大きくなる。
- $h$ が小さいと、各階級に入るデータの個数が少なくなり、柱の高さが偶然で大きく揺れる(ex-fdh-too-fine)。
データの個数 $N$ が大きいほど、細かい階級でも各階級に十分な個数が入るので、$h$ を小さくできる。どう釣り合いをとるかについては、理論から導いた規則がいくつも提案されている(NIS12 1.3.3.14 節)。この記事では、規則の内容と根拠には立ち入らない。
さらに先へ
- 階級の幅を細かくし、データの個数を増やしていったときのヒストグラムの極限が密度関数である。確率の側からの同じ話は 確率密度関数と連続型確率変数 で扱う。
- 度数分布表は平均や分散のほかに、中央値がどの階級にあるかも教えてくれる(ex-fdh-table10)。中央値・四分位数を並べた図は 四分位数と箱ひげ図 で、中央値の性質は 中央値と絶対誤差 で扱う。
- 度数分布表は、いくつかのグループのデータをまとめるときにも使う。まとめ方によっては、グループごとの傾向と全体の傾向が逆になることがある。これが次に読む Simpsonのパラドックス である。
- 乱数で作った和のヒストグラムが、足す個数を増やすと正規分布の釣り鐘の形に近づく現象は 中心極限定理(高校数学) で扱う。
関連項目
- 前提: 平均・中央値・分散, 四分位数と箱ひげ図
- 前に読む: 平均・中央値・分散, 四分位数と箱ひげ図
- 次に読む: Simpsonのパラドックス
- 関連(高校数学): 確率密度関数と連続型確率変数, 中央値と絶対誤差, 中心極限定理(高校数学), 絶対値と三角不等式
- 発展: 確率変数
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

