確率密度関数と連続型確率変数
概要
確率密度関数と連続型確率変数(probability density functions and continuous random variables)とは、値が連続的に変わる確率変数 $X$ の確率を、$f(x)\ge0$、$\int_{-\infty}^{\infty}f(x)\,dx=1$ を満たす関数 $f$(確率密度関数)のグラフの下の面積 $P(a\le X\le b)=\int_a^bf(x)\,dx$ で与える考え方である。1 点の確率はいつも $0$ で、分布関数 $F(x)=P(X\le x)$ は $f$ が連続な点で微分できて $F'(x)=f(x)$ となる。期待値と分散は $E(X)=\int xf(x)\,dx$、$V(X)=E(X^2)-\mu^2$ で定める(積分が収束するときに限る)。1 点に正の確率が集まる確率変数は密度関数をもたない。
前提知識: 確率変数の期待値と分散, 定積分と面積, 区分求積と積分の定義, 微分積分学の基本定理
高校での出発点:長さや面積で決まる確率
確率変数の期待値と分散 で扱った確率変数は、さいころの目のように、とる値がとびとびで、1 つ 1 つの値に確率が付いていた。ところが、待ち時間・身長・でたらめに選んだ実数のように、値が連続的に変わる量では、確率を「1 つの値ごと」に考えるとうまくいかない。まず 3 つの例で、何が起こるかを見る。
$0$ 以上 $1$ 以下の実数を 1 つ、どこも同じ「出やすさ」で選び、それを $X$ とする。計算機の乱数(0 から 1 の数を返す関数)がこれにあたる。「どこも同じ出やすさ」とは、区間に入る確率がその区間の長さに等しいことだと考える。
- $P(0.2\le X\le0.5)=0.5-0.2=0.3$、$P(0\le X\le0.25)=0.25$ である。
- では、ちょうど $X=\frac12$ になる確率はいくらか。$h$ を $0< h\le\frac12$ の数とすると、$X=\frac12$ ならば $\frac12-h\le X\le\frac12+h$ なので
$$ P\Bigl(X=\frac12\Bigr)\le P\Bigl(\frac12-h\le X\le\frac12+h\Bigr)=2h $$
である。$h=0.01$ なら $0.02$ 以下、$h=0.0001$ なら $0.0002$ 以下になる。$0$ 以上の数で、どんな正の数 $2h$ よりも小さいのは $0$ だけなので、$P\bigl(X=\frac12\bigr)=0$ である。
1 つ 1 つの値の確率はすべて $0$ なのに、区間の確率は正である。したがって、この $X$ の確率分布は「値と確率の表」では書けない。
0 から 1 の乱数を 2 つ、互いに影響しないように引き、$U$、$V$ とする。点 $(U,V)$ は一辺 $1$ の正方形の中のでたらめな点であり、正方形の中の図形に入る確率はその面積に等しいと考える。2 つのうち大きいほうを $M=\max(U,V)$ とする。
$0\le x\le1$ とする。「$M\le x$」は「$U\le x$ かつ $V\le x$」と同じであり、これは点 $(U,V)$ が一辺 $x$ の正方形 $0\le U\le x$、$0\le V\le x$ に入ることである(図1)。よって
$$
P(M\le x)=x^2
$$
である。たとえば $P(M\le0.5)=0.25$、$P(0.5\le M\le1)=1-0.25=0.75$ で、$M$ は大きいほうに偏っている。$0\le a< b\le1$ なら、事象「$M\le b$」は、重ならない 2 つの事象「$M\le a$」「$a< M\le b$」に分かれるので、$P(a< M\le b)=b^2-a^2$ である。さらに $P(M=a)=0$ である。実際、$0< h\le a$ なら $M=a$ のとき $a-h< M\le a$ なので、$P(M=a)\le a^2-(a-h)^2=2ah-h^2\le2h$ であり、ex-pdn-uniform-intro と同じ理由で $0$ になる($a=0$ なら $P(M=0)\le P(M\le h)=h^2$ を使う)。よって $P(a\le M\le b)=b^2-a^2$ でもある。
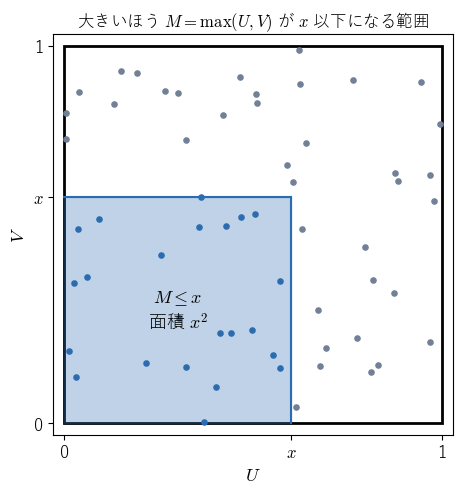 一辺 1 の正方形の中のでたらめな点 $(U,V)$。大きいほう $M$ が $x$ 以下になるのは、点が左下の一辺 $x$ の正方形に入るときで、その確率は面積 $x^2$ であることを見る図。
ex-pdn-max-intro の $M$ の値の範囲 $[0,1]$ を、幅 $\frac1m$ の $m$ 個の階級に分ける。$k$ 番目($k=0,1,\dots,m-1$)の階級 $\frac km\le M\le\frac{k+1}m$ に入る確率は
$$
\Bigl(\frac{k+1}m\Bigr)^2-\Bigl(\frac km\Bigr)^2=\frac{(k+1)^2-k^2}{m^2}=\frac{2k+1}{m^2}
$$
である。この確率を階級の幅 $\frac1m$ で割った値を長方形の高さにすると、高さは $\frac{2k+1}m$ になる。階級の中点は $\frac{2k+1}{2m}$ なので、高さはちょうど「中点の $2$ 倍」である。
- $m=2$:高さは $\frac12$、$\frac32$。
- $m=4$:高さは $\frac14$、$\frac34$、$\frac54$、$\frac74$。
長方形の面積(高さ × 幅)が確率になり、面積の合計は $1$ である。幅を細かくしていくと、長方形の上の辺は直線 $y=2x$ に近づいていく(図2)。実際に乱数を 10000 組引いて同じ高さのヒストグラムを作っても、同じ直線に沿う。
に近づくことを見る図。](https://firebasestorage.googleapis.com/v0/b/mathlog-361213.appspot.com/o/uploads%2Fmathdown%2FSqgelL2M0ehgWaPni4MA.png?alt=media) $M$ のヒストグラムを、高さ=確率÷幅で描いたもの。左と中央は厳密な確率で幅 1/4 と 1/16、右は乱数 10000 組から作ったもの。幅を細かくすると、長方形の上の辺が直線 $y=2x$(赤)に近づくことを見る図。
3 つの例から、次の問いが出てくる。
- 確率が長さや面積で決まる確率変数を、一般にはどう表せばよいか。→ def-pdn-density
- 1 点の確率が $0$ になるのはなぜか。$\le$ と $<$ の違いは効くか。→ prop-pdn-point
- 図2 の直線 $y=2x$ はどうやって見つければよいか。→ thm-pdn-cdf
- 期待値と分散はどう定めればよいか。→ def-pdn-mean-var、prop-pdn-variance-formula
- どんな確率変数も、値と確率の表で書けるか、密度関数で書けるかのどちらかか。→ ex-pdn-counter-mixed、ex-pdn-cantor
値がとびとびの確率変数(確率変数の期待値と分散)と、この記事の確率変数の対応を表にしておく。和が積分に、確率が「密度 × 幅」に置き換わる。とびとびの値の確率変数 連続的な値の確率変数(この記事) ボックス 値 $x_k$ の確率 $p_k$ 密度 $f(x)$(幅 $\Delta x$ の区間の確率 $\approx f(x)\Delta x$) def-pdn-density $p_k\ge0$、$\sum_kp_k=1$ $f(x)\ge0$、$\int_{-\infty}^{\infty}f(x)\,dx=1$ def-pdn-density $P(a\le X\le b)=\sum_{a\le x_k\le b}p_k$ $P(a\le X\le b)=\int_a^bf(x)\,dx$ def-pdn-density 1 点の確率は正でありうる 1 点の確率はいつも $0$ prop-pdn-point $E(X)=\sum_kx_kp_k$ $E(X)=\int_{-\infty}^{\infty}xf(x)\,dx$ def-pdn-mean-var $V(X)=\sum_k(x_k-\mu)^2p_k$ $V(X)=\int_{-\infty}^{\infty}(x-\mu)^2f(x)\,dx$ def-pdn-mean-var
確率密度関数
実数全体で定義された関数 $f$ が次の 2 つの条件を満たすとき、$f$ を 確率密度関数(または単に 密度関数)という。
- すべての実数 $x$ で $f(x)\ge0$ である。
- $\displaystyle\int_{-\infty}^{\infty}f(x)\,dx=1$ である。
確率変数 $X$ が、$a\le b$ を満たすすべての実数 $a$、$b$ について
$$ P(a\le X\le b)=\int_a^bf(x)\,dx $$
を満たすとき、$X$ を密度関数 $f$ をもつ 連続型確率変数 といい、$X$ は密度 $f$ の分布に 従う という。
この記事で扱う $f$ は、有限個の点を除いて連続な関数とする。多くの例では、ある閉区間 $[\alpha,\beta]$ の外で $f(x)=0$ であり、そのときは条件 2 の積分は普通の定積分 $\int_\alpha^\beta f(x)\,dx$ のことである。そうでないときは、関数 $g$ について $\int_{-\infty}^{\infty}g(x)\,dx$ を、2 つの 広義積分 $\displaystyle\int_0^{\infty}g(x)\,dx=\lim_{R\to\infty}\int_0^Rg(x)\,dx$ と $\displaystyle\int_{-\infty}^0g(x)\,dx=\lim_{R'\to\infty}\int_{-R'}^0g(x)\,dx$ がそれぞれ収束するときの和と定める($R$ と $R'$ は別々に $\infty$ に近づける)。区切りの点を $0$ から別の点 $s$ に変えても、収束するかどうかも値も変わらない($0$ と $s$ の間の積分は、定積分か、収束する広義積分で、有限の値だからである)。有限個の除いた点の近くで $f$ が有界でなければ、その点の近くの積分も広義積分として考える。
条件 1 は「確率は $0$ 以上」、条件 2 は「どこかの値をとる確率は $1$」に対応する。確率が面積で表されるので、密度関数のグラフの下の面積が、そのまま確率になる。
- 一様分布。$0\le x\le1$ で $f(x)=1$、それ以外で $f(x)=0$ とする。$\int_0^11\,dx=1$ なので密度関数である。$P(a\le X\le b)=\int_a^b1\,dx=b-a$($0\le a\le b\le1$)となり、ex-pdn-uniform-intro の「確率=長さ」と一致する。一般に、$\alpha<\beta$ に対して $[\alpha,\beta]$ で $f(x)=\frac1{\beta-\alpha}$、それ以外で $0$ とした密度の分布を、区間 $[\alpha,\beta]$ 上の 一様分布 という。
- $f(x)=2x$ の場合。$0\le x\le1$ で $f(x)=2x$、それ以外で $0$ とする。$f\ge0$ で、$\int_0^12x\,dx=\bigl[x^2\bigr]_0^1=1$ である。$0\le a\le b\le1$ なら $\int_a^b2x\,dx=b^2-a^2$ で、これは ex-pdn-max-intro の $P(a\le M\le b)$ と一致する。つまり $M$ は密度 $2x$ をもつ。図2 の直線 $y=2x$ はこの密度関数のグラフである。
- $f(x)=\frac34(1-x^2)$ の場合($-1\le x\le1$、それ以外で $0$)。この範囲で $1-x^2\ge0$ であり、
$$ \int_{-1}^1\frac34(1-x^2)\,dx=\frac34\Bigl[x-\frac{x^3}3\Bigr]_{-1}^1=\frac34\Bigl(\frac23+\frac23\Bigr)=1 $$
である。$P\bigl(0\le X\le\frac12\bigr)=\frac34\bigl(\frac12-\frac1{24}\bigr)=\frac34\cdot\frac{11}{24}=\frac{11}{32}=0.34375$ である。 - 定数を決める。$0\le x\le2$ で $f(x)=cx$、それ以外で $0$ が密度関数になる $c$ を求める。$\int_0^2cx\,dx=c\bigl[\frac{x^2}2\bigr]_0^2=2c$ なので、$2c=1$ から $c=\frac12$ である。
密度関数の値は確率ではない。確率になるのは、値に幅を掛けた面積である。
- 区間 $\bigl[0,\frac12\bigr]$ 上の一様分布の密度は $f(x)=2$ で、$1$ より大きい。それでも $P(0.1\le X\le0.2)=2\times0.1=0.2$ で、確率は $1$ 以下である。
- ex-pdn-max-intro の $M$(密度 $2x$)で、幅 $0.01$ の区間の確率を計算すると
$$ P(0.9\le M\le0.91)=0.91^2-0.9^2=0.8281-0.81=0.0181 $$
である。密度の値 $f(0.9)=1.8$ に幅 $0.01$ を掛けると $0.018$ で、ほぼ一致する。幅 $\Delta x$ が小さいとき、$P(x\le X\le x+\Delta x)\approx f(x)\,\Delta x$ である。密度という名前は、この「単位の幅あたりの確率」という意味から来ている。
1 点の確率は 0
ex-pdn-uniform-intro で見たことは、密度関数をもつどの確率変数でも成り立つ。
$X$ が密度関数 $f$ をもつ連続型確率変数ならば、すべての実数 $c$ について $P(X=c)=0$ である。したがって、$a< b$ のとき
$$
P(a\le X\le b)=P(a< X\le b)=P(a\le X< b)=P(a< X< b)=\int_a^bf(x)\,dx
$$
が成り立ち、不等号に等号を含めるかどうかは確率に影響しない。
方針:def-pdn-density は $a=b$ の場合も含むので、$a=b=c$ とおけば $P(X=c)=\int_c^cf(x)\,dx=0$ がすぐに出る。ここでは、$a< b$ の区間の確率だけからも同じ結論が出ることを示す(段 2・段 3 は ex-pdn-cantor でも使う)。ex-pdn-uniform-intro と同じく、$c$ を含む幅 $2h$ の区間の確率で $P(X=c)$ を上からおさえ、$h$ を $0$ に近づける。
段 1(上からおさえる)。$h>0$ とする。$X=c$ ならば $c-h\le X\le c+h$ なので、確率を比べて
$$
0\le P(X=c)\le P(c-h\le X\le c+h)=\int_{c-h}^{c+h}f(x)\,dx
$$
である。右辺を $I(h)$ と書く。
段 2($f$ が $c$ の近くで有界な場合)。ある $h_0>0$ と $K>0$ があって、$c-h_0\le x\le c+h_0$ で $f(x)\le K$ とする。$0< h\le h_0$ なら、積分の大小関係($f\le K$ なら $\int f\le\int K$)により $I(h)\le\int_{c-h}^{c+h}K\,dx=2Kh$ である。よって、すべての $0< h\le h_0$ で $0\le P(X=c)\le2Kh$ となる。$p:=P(X=c)$ が正だとすると、$h:=\min\bigl\{h_0,\frac p{4K}\bigr\}$ のとき $p\le2Kh\le\frac p2$ となって矛盾する。したがって $p=0$ である。
段 3($f$ が $c$ の近くで有界でない場合)。def-pdn-density の約束により、このとき $c$ は除いた有限個の点の 1 つで、$c$ の近くの積分は広義積分である。$h_0>0$ を、$c-h_0\le x\le c+h_0$ に $c$ 以外の除いた点がないようにとる。$0< h< h_0$ のとき
$$
I(h)=\int_{c-h_0}^{c+h_0}f(x)\,dx-\int_{c-h_0}^{c-h}f(x)\,dx-\int_{c+h}^{c+h_0}f(x)\,dx
$$
である。広義積分が収束するとは、$h\to0$ のとき $\int_{c-h_0}^{c-h}f(x)\,dx$ が $\int_{c-h_0}^{c}f(x)\,dx$ に、$\int_{c+h}^{c+h_0}f(x)\,dx$ が $\int_{c}^{c+h_0}f(x)\,dx$ に近づくという意味である。したがって $I(h)$ は $\int_{c-h_0}^{c+h_0}f-\int_{c-h_0}^cf-\int_c^{c+h_0}f=0$ に近づく。段 1 の不等式 $0\le P(X=c)\le I(h)$ で $h\to0$ とすると、$P(X=c)=0$ である。
段 4(等号の有無)。$a< b$ とする。事象「$a\le X\le b$」は、互いに重ならない 3 つの事象「$X=a$」「$a< X< b$」「$X=b$」に分かれるので
$$
P(a\le X\le b)=P(X=a)+P(a< X< b)+P(X=b)=P(a< X< b)
$$
である。$P(a< X\le b)$、$P(a\le X< b)$ も同じように、$P(a< X< b)$ に $0$ を足したものである。$\square$
prop-pdn-point により、$X$ がどの値をとる確率も $0$ である。それでも $X$ は何かの値をとる。確率 $0$ の事象は「起こりえない事象」とは限らない。これは、とびとびの値の確率変数にはなかった現象である。たとえば ex-pdn-uniform-intro で $X=\frac12$ になることは起こりうるが、その確率は $0$ である。
主定理:分布関数を微分すると密度関数
ex-pdn-max-intro では、まず $P(M\le x)=x^2$ を面積で求め、そこから密度 $2x$ にたどり着いた。この「$x$ 以下になる確率」に名前を付ける。
確率変数 $X$ について、実数 $x$ の関数
$$
F(x):=P(X\le x)
$$
を $X$ の 分布関数(または 累積分布関数)という。$X$ が密度関数 $f$ をもつときは、$F(x)=\displaystyle\int_{-\infty}^xf(t)\,dt$ である。これは $P(X\le x)=\lim_{a\to-\infty}P(a\le X\le x)$ という確率の性質(確率の連続性)による。本記事ではこの性質を証明せずに使う。密度が区間 $[\alpha,\beta]$ の外で $0$ のときに $P(X<\alpha)=0$ となることも、同じ性質から出る。
分布関数は、$x$ が増えると減らない関数である。実際、$x< y$ なら「$X\le x$」は「$X\le y$」に含まれるので、$F(x)\le F(y)$ である。また $x< y$ のとき、事象「$X\le y$」は重ならない 2 つの事象「$X\le x$」「$x< X\le y$」に分かれるので
$$
P(x< X\le y)=F(y)-F(x)
$$
である。
- $[0,1]$ 上の一様分布では、$x<0$ で $F(x)=0$、$0\le x\le1$ で $F(x)=\int_0^x1\,dt=x$、$x>1$ で $F(x)=1$ である。
- 密度 $2x$ の $M$ では、$0\le x\le1$ で $F(x)=\int_0^x2t\,dt=x^2$ である。$P(0.5\le M\le0.8)=F(0.8)-F(0.5)=0.64-0.25=0.39$ で、これは密度のグラフの下の $0.5\le x\le0.8$ の部分の面積である(図3)。
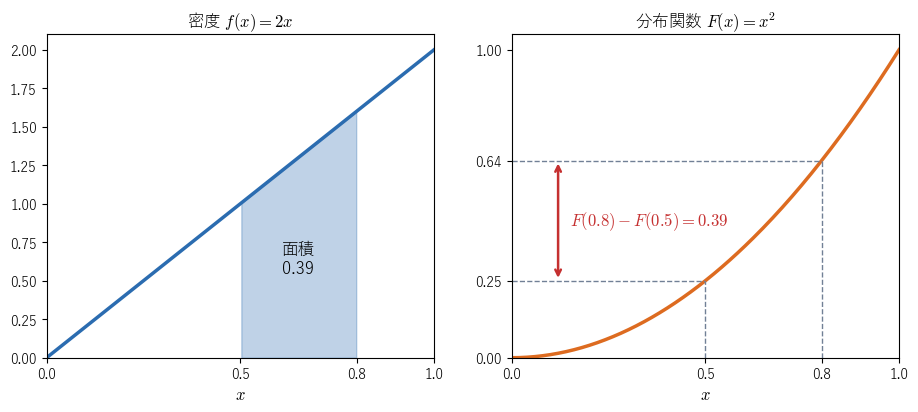 左は密度 $f(x)=2x$ と、$0.5\le x\le0.8$ の部分の面積 0.39。右は分布関数 $F(x)=x^2$ で、同じ確率が高さの差 $F(0.8)-F(0.5)$ として現れることを見る図。
密度関数を積分すると分布関数になる。逆に、分布関数を微分すると密度関数に戻る。これがこの記事の主定理である。
- $X$ が密度関数 $f$ をもち、$f$ が $x_0$ を含むある開区間で連続ならば、分布関数 $F$ は $x_0$ で微分可能で、$F'(x_0)=f(x_0)$ である。
- 逆に、確率変数 $X$ の分布関数 $F$ がすべての実数で連続で、ある $\alpha<\beta$ について、$x\le\alpha$ で $F(x)=0$、$x\ge\beta$ で $F(x)=1$ であり、閉区間 $[\alpha,\beta]$ で $F$ が微分可能で導関数 $F'$ が連続(端点では片側の微分係数を考える)とする。$[\alpha,\beta]$ で $f(x):=F'(x)$、それ以外で $f(x):=0$ と定めると、$f$ は密度関数で、$X$ は密度 $f$ をもつ。
方針:1 では、$\frac{F(x_0+h)-F(x_0)}h$ が「幅 $h$ の区間の確率 ÷ 幅」であることを使い、区間での $f$ の最小値と最大値ではさむ。2 では、定積分の計算 $\int_a^bF'(t)\,dt=F(b)-F(a)$ を使う。
段 1(1 の準備)。$\delta>0$ を、$f$ が閉区間 $[x_0-\delta,x_0+\delta]$ で連続になるようにとる($x_0$ を含む開区間の中に、このような閉区間がとれる)。$0< h<\delta$ とすると、$F$ の定義から
$$
F(x_0+h)-F(x_0)=P(x_0< X\le x_0+h)=\int_{x_0}^{x_0+h}f(t)\,dt
$$
である(最後の等号は prop-pdn-point による)。
段 2(最小値と最大値ではさむ)。閉区間 $[x_0,x_0+h]$ で連続な $f$ は最小値 $m(h)$ と最大値 $M(h)$ をもつ(最大値・最小値の定理)。$m(h)\le f(t)\le M(h)$ を $x_0$ から $x_0+h$ まで積分すると、$m(h)\,h\le\int_{x_0}^{x_0+h}f(t)\,dt\le M(h)\,h$ である。$h>0$ で割って
$$
m(h)\le\frac{F(x_0+h)-F(x_0)}h\le M(h)
$$
を得る。
段 3($h\to+0$)。$m(h)$、$M(h)$ は区間 $[x_0,x_0+h]$ のどこかの点での $f$ の値であり、その点と $x_0$ の距離は $h$ 以下である。$f$ は $x_0$ で連続なので、$h\to+0$ のとき $m(h)$ も $M(h)$ も $f(x_0)$ に近づく。はさみうちの原理 により、右側からの微分係数は $f(x_0)$ である。
段 4($h<0$ の場合)。$-\delta< h<0$ なら、$F(x_0+h)-F(x_0)=-\int_{x_0+h}^{x_0}f(t)\,dt$ で、$h$ で割ると $\frac1{|h|}\int_{x_0+h}^{x_0}f(t)\,dt$ になる。区間 $[x_0+h,x_0]$ での最小値と最大値で段 2・段 3 と同じようにはさむと、左側からの微分係数も $f(x_0)$ である。両側が一致するので $F'(x_0)=f(x_0)$ である。これは 微分積分学の基本定理 の証明と同じ議論である。
段 5(2:$f$ は密度関数)。$F$ は減らない関数なので、$[\alpha,\beta]$ の点での微分係数は $0$ 以上である(増加量 $F(x+h)-F(x)$ と $h$ が同じ符号か $0$ なので、差分商は $0$ 以上)。よって $f\ge0$ である。$F'$ は $[\alpha,\beta]$ で連続なので、定積分の基本的な計算により
$$
\int_{-\infty}^{\infty}f(x)\,dx=\int_\alpha^\beta F'(x)\,dx=F(\beta)-F(\alpha)=1-0=1
$$
である。
段 6(2:区間の確率)。$a< b$ とする。$a$ と $b$ を区間 $[\alpha,\beta]$ に押し込んだ点を $a'$、$b'$ とする($a<\alpha$ なら $a'=\alpha$、$a>\beta$ なら $a'=\beta$、それ以外なら $a'=a$。$b'$ も同じ)。$F$ は $\alpha$ 以下で $0$、$\beta$ 以上で $1$ なので $F(a)=F(a')$、$F(b)=F(b')$ であり、$f$ は $[\alpha,\beta]$ の外で $0$ なので $\int_a^bf=\int_{a'}^{b'}F'$ である。よって
$$
P(a< X\le b)=F(b)-F(a)=F(b')-F(a')=\int_{a'}^{b'}F'(x)\,dx=\int_a^bf(x)\,dx
$$
である。最後に $P(X=a)=0$ を示す。$h>0$ なら $X=a$ のとき $a-h< X\le a$ なので $P(X=a)\le F(a)-F(a-h)$ であり、$F$ は $a$ で連続なので右辺は $h\to+0$ で $0$ に近づく。よって $P(a\le X\le b)=P(X=a)+P(a< X\le b)=\int_a^bf(x)\,dx$ である。$\square$
主定理の 2 を使うと、分布関数を面積などで求めてから微分して、密度関数を見つけることができる。
- 大きいほう。ex-pdn-max-intro の $M$ は、$0\le x\le1$ で $F(x)=x^2$、$x<0$ で $0$、$x>1$ で $1$ である。$F$ は連続で、$[0,1]$ で $F'(x)=2x$ は連続なので、主定理の 2 から密度は $2x$ である。
- 小さいほう。同じ $U$、$V$ で小さいほう $N=\min(U,V)$ を考える。「$N>x$」は「$U>x$ かつ $V>x$」で、点 $(U,V)$ が一辺 $1-x$ の正方形 $x< U\le1$、$x< V\le1$ に入ることなので、$P(N>x)=(1-x)^2$ である。よって $0\le x\le1$ で $F(x)=1-(1-x)^2$ であり、微分して密度は $f(x)=2(1-x)$ である。$\int_0^12(1-x)\,dx=\bigl[2x-x^2\bigr]_0^1=1$ となることも確かめられる。
- 乱数の 2 乗。$[0,1]$ 上の一様分布に従う $U$ について、$Y=U^2$ とする。$0\le y\le1$ なら「$Y\le y$」は「$U\le\sqrt y$」なので $F(y)=\sqrt y$ である。$0< y\le1$ で微分すると $F'(y)=\frac1{2\sqrt y}$ で、これは $y\to+0$ でいくらでも大きくなるので、主定理の 2 の仮定($[0,1]$ で $F'$ が連続)は満たされない。そこで直接確かめる。$0< a< b\le1$ なら $P(a< Y\le b)=\sqrt b-\sqrt a=\int_a^b\frac{dy}{2\sqrt y}$ であり、$a\to+0$ とすると広義積分 $\int_0^b\frac{dy}{2\sqrt y}=\sqrt b$ が得られる。1 点の確率は $P(Y=a)=P(U=\sqrt a)=0$ である。よって $Y$ は、$0< y\le1$ で $f(y)=\frac1{2\sqrt y}$、それ以外で $0$ という密度をもつ。この例のように、密度関数は有界とは限らない。
期待値と分散
和から積分へ
値がとびとびの確率変数の期待値は $\sum_kx_kp_k$ だった。連続型の確率変数では、ex-pdn-histogram のように値の範囲を細かい区間に分け、各区間の値をその中点で代表させる。区間の確率は「密度 × 幅」でほぼ表されるので、期待値は $\sum(\text{中点})\times f(\text{中点})\times(\text{幅})$ でほぼ表される。幅を $0$ に近づけると、この和は 区分求積と積分の定義 で扱った Riemann和 として積分 $\int xf(x)\,dx$ に近づく。まず数値で見る。
密度 $2x$ の $M$ を考える。$[0,1]$ を幅 $\frac1m$ の $m$ 個の階級に分け、$k$ 番目の階級に入ったら値を中点 $\frac{2k+1}{2m}$ に丸める。ex-pdn-histogram より、その確率は $\frac{2k+1}{m^2}$ である。丸めた値は、とびとびの値の確率変数なので、期待値は
$$
E_m=\sum_{k=0}^{m-1}\frac{2k+1}{2m}\cdot\frac{2k+1}{m^2}=\frac1{2m^3}\sum_{k=0}^{m-1}(2k+1)^2
$$
である。
- $m=4$ のとき、$(2k+1)^2$ は $1,9,25,49$ で和は $84$ なので、$E_4=\frac{84}{128}=\frac{21}{32}=0.65625$ である。
- 奇数の 2 乗の和の公式 $\sum_{k=0}^{m-1}(2k+1)^2=\frac{m(4m^2-1)}3$(数学的帰納法と整列性 の方法で示せる)を使うと、$E_m=\frac{4m^2-1}{6m^2}=\frac23-\frac1{6m^2}$ である。$m=4$ なら $\frac23-\frac1{96}=\frac{21}{32}$ で 1 と一致する。$m=16$ なら $E_{16}=\frac{341}{512}=0.666015625$ である。
$m$ を大きくすると $E_m$ は $\frac23$ に近づく。一方、積分で計算すると $\int_0^1x\cdot2x\,dx=\bigl[\frac{2x^3}3\bigr]_0^1=\frac23$ で、同じ値である。
期待値と分散の定義
$X$ を密度関数 $f$ をもつ連続型確率変数とする。
$$
E(X):=\int_{-\infty}^{\infty}xf(x)\,dx
$$
を $X$ の 期待値(または 平均)という。$\mu=E(X)$ とおき、
$$
V(X):=\int_{-\infty}^{\infty}(x-\mu)^2f(x)\,dx,\qquad \sigma(X):=\sqrt{V(X)}
$$
をそれぞれ $X$ の 分散、標準偏差 という。密度が区間の外で $0$ でないときは、これらの積分は def-pdn-density で定めた意味の広義積分($0$ 以上の側と $0$ 以下の側で別々に収束すること)であり、収束するときだけ定義する(収束しない例は ex-pdn-counter-no-mean)。$xf(x)$ は $x>0$ で $0$ 以上、$x<0$ で $0$ 以下なので、$E(X)$ が定まることは $\int_{-\infty}^{\infty}|x|f(x)\,dx$ が収束することと同じである(GS06 Definition 6.4 の定義と一致する)。また、$0$ 以上の値をとる関数 $g$ について、$\int_{-\infty}^{\infty}g(x)f(x)\,dx$ が収束するとき、その値を $E(g(X))$ と書く。たとえば $E(X^2)=\int_{-\infty}^{\infty}x^2f(x)\,dx$ である。
$Y=g(X)$ はそれ自身が確率変数なので、$Y$ の密度を求めてから def-pdn-mean-var で $E(Y)$ を計算することもできる。その値が $\int g(x)f(x)\,dx$ と一致することは、$g$ が連続で、積分が収束するなら一般に成り立つ(GS06 Theorem 6.11。本記事では一般には証明しない)。たとえば ex-pdn-derivative の 3 の $Y=U^2$ では、$Y$ の密度 $\frac1{2\sqrt y}$ から $E(Y)=\int_0^1y\cdot\frac1{2\sqrt y}\,dy=\int_0^1\frac{\sqrt y}2\,dy=\bigl[\frac{y^{3/2}}3\bigr]_0^1=\frac13$ であり、$U$ の密度から $\int_0^1u^2\cdot1\,du=\frac13$ としても同じ値になる。
分散を定義どおり計算するのは手間がかかる。とびとびの値のときと同じ公式が使える。
$X$ が密度関数 $f$ をもち、$E(X)=\mu$ と $E(X^2)$ が定まるとき
$$
V(X)=E(X^2)-\mu^2
$$
である。
方針:$(x-\mu)^2$ を展開し、積分の線形性(和の積分は積分の和、定数倍は外に出せる)で 3 つの積分に分ける。
段 1(展開)。$(x-\mu)^2f(x)=x^2f(x)-2\mu\,xf(x)+\mu^2f(x)$ である。
段 2(積分を分ける)。積分の線形性により
$$
V(X)=\int_{-\infty}^{\infty}x^2f(x)\,dx-2\mu\int_{-\infty}^{\infty}xf(x)\,dx+\mu^2\int_{-\infty}^{\infty}f(x)\,dx
$$
である(広義積分のときは、$[0,R]$ と $[-R',0]$ のそれぞれで積分を 3 つに分けてから $R\to\infty$、$R'\to\infty$ とすれば同じである。仮定から、右辺の 3 つの積分はどれも $0$ 以上の側と $0$ 以下の側で別々に収束しているので、左辺の積分も収束する)。
段 3(それぞれの値)。第 1 項は $E(X^2)$、第 2 項の積分は定義から $\mu$、第 3 項の積分は密度関数の条件 2 から $1$ である。よって $V(X)=E(X^2)-2\mu\cdot\mu+\mu^2\cdot1=E(X^2)-\mu^2$ である。$\square$
- $[0,1]$ 上の一様分布:$E(X)=\int_0^1x\,dx=\frac12$、$E(X^2)=\int_0^1x^2\,dx=\frac13$ なので、$V(X)=\frac13-\frac14=\frac1{12}$、$\sigma(X)=\frac1{2\sqrt3}=0.2886\ldots$ である。
- 密度 $2x$ の $M$:$E(M)=\frac23$(ex-pdn-riemann-mean)、$E(M^2)=\int_0^1x^2\cdot2x\,dx=\bigl[\frac{x^4}2\bigr]_0^1=\frac12$ なので、$V(M)=\frac12-\frac49=\frac1{18}$ である。定義どおり $\int_0^1\bigl(x-\frac23\bigr)^2\cdot2x\,dx$ を計算しても $\frac1{18}$ になる。
- 密度 $2(1-x)$ の小さいほう $N$(ex-pdn-derivative の 2):$E(N)=\int_0^12x(1-x)\,dx=1-\frac23=\frac13$、$E(N^2)=\int_0^12x^2(1-x)\,dx=\frac23-\frac12=\frac16$ なので $V(N)=\frac16-\frac19=\frac1{18}$ である。$M+N=U+V$(大きいほうと小さいほうの和は 2 つの和)なので、$E(M)+E(N)=\frac23+\frac13=1=E(U)+E(V)$ となっていることも確かめられる。
- 密度 $\frac34(1-x^2)$($-1\le x\le1$):$xf(x)$ は 奇関数 なので $E(X)=0$ であり、$V(X)=E(X^2)=\frac34\int_{-1}^1(x^2-x^4)\,dx=\frac34\bigl(\frac23-\frac25\bigr)=\frac34\cdot\frac4{15}=\frac15$ である。
1 次式で変換した確率変数
一様分布は、$[0,1]$ 上のものを伸ばして平行移動すれば、どの区間の上のものも得られる。一般に、密度をもつ $X$ を 1 次式で変換した $aX+b$ も密度をもつ。
$X$ が密度関数 $f$ をもち、$a\ne0$、$b$ を定数とする。$Y=aX+b$ は密度関数
$$
g(y)=\frac1{|a|}f\Bigl(\frac{y-b}a\Bigr)
$$
をもつ。さらに $E(X)$、$V(X)$ が定まるなら、$E(Y)=aE(X)+b$、$V(Y)=a^2V(X)$ である。
方針:「$c\le Y\le d$」を $X$ の不等式に直し、$x=\frac{y-b}a$ と 置換積分 する。$a<0$ のときは不等式の向きが変わることに注意する。密度が区間の外で $0$ でないときの広義積分は、$0$ 以上の側と $0$ 以下の側に分けて、それぞれ置換してから極限をとる(段 2〜段 4)。
段 1($a>0$ の場合の密度)。$c\le d$ とする。$c\le aX+b\le d$ は $\frac{c-b}a\le X\le\frac{d-b}a$ と同じなので
$$
P(c\le Y\le d)=\int_{(c-b)/a}^{(d-b)/a}f(x)\,dx
$$
である。$x=\frac{y-b}a$ と置換すると、$dx=\frac1a\,dy$ で、$x=\frac{c-b}a$ のとき $y=c$、$x=\frac{d-b}a$ のとき $y=d$ なので、右辺は $\int_c^d\frac1af\bigl(\frac{y-b}a\bigr)\,dy=\int_c^dg(y)\,dy$ になる($a>0$ なので $\frac1a=\frac1{|a|}$)。
段 2($a<0$ の場合の密度)。$a<0$ で割ると不等号の向きが変わるので、$c\le aX+b\le d$ は $\frac{d-b}a\le X\le\frac{c-b}a$ と同じである。段 1 と同じ置換で
$$
P(c\le Y\le d)=\int_{(d-b)/a}^{(c-b)/a}f(x)\,dx=\int_d^c\frac1af\Bigl(\frac{y-b}a\Bigr)dy=\int_c^d\Bigl(-\frac1a\Bigr)f\Bigl(\frac{y-b}a\Bigr)dy
$$
である。$a<0$ なので $-\frac1a=\frac1{|a|}$ であり、右辺は $\int_c^dg(y)\,dy$ である。$g\ge0$ である。また段 1・段 2 の置換は確率を使わない積分の等式なので、$\int_0^dg(y)\,dy$ と $\int_c^0g(y)\,dy$ は $x=-\frac ba$ で区切った 2 つの側での $f$ の積分に等しく、$d\to\infty$、$c\to-\infty$ とすると、それぞれの $x$ の区間の端も $\infty$ または $-\infty$ に向かう。よって $\int_{-\infty}^{\infty}g(y)\,dy=\int_{-\infty}^{\infty}f(x)\,dx=1$ であり(区切りの点は def-pdn-density のとおり取り替えてよい)、$g$ は $Y$ の密度関数である。
段 3(期待値)。$\mu=E(X)$ とし、まず $a>0$ とする。$R>0$ について、段 1 と逆向きに $y=ax+b$ と置換すると、$g(y)\,dy$ は $f(x)\,dx$ に変わり、$y=0$ は $x=-\frac ba$ に、$y=R$ は $x=\frac{R-b}a$ に対応するので
$$
\int_0^Ryg(y)\,dy=a\int_{-b/a}^{(R-b)/a}xf(x)\,dx+b\int_{-b/a}^{(R-b)/a}f(x)\,dx
$$
である。$E(X)$ が定まるので、区切りの点を $-\frac ba$ にとった広義積分 $\int_{-b/a}^{\infty}xf(x)\,dx$ と $\int_{-b/a}^{\infty}f(x)\,dx$ は収束し、$R\to\infty$ で左辺も収束する。$\int_{-R'}^0yg(y)\,dy$ も同じように $x$ の区間 $\bigl[\frac{-R'-b}a,-\frac ba\bigr]$ での積分に移り、$R'\to\infty$ で収束する。よって $E(Y)$ は定まり、2 つを足して
$$
E(Y)=\int_{-\infty}^{\infty}(ax+b)f(x)\,dx=a\int_{-\infty}^{\infty}xf(x)\,dx+b\int_{-\infty}^{\infty}f(x)\,dx=a\mu+b
$$
である。$a<0$ のときは、$y$ の区間 $[0,R]$ が $x$ の区間 $\bigl[\frac{R-b}a,-\frac ba\bigr]$($-\frac ba$ より左の側)に移り、積分の向きの入れ替えと $\frac1{|a|}=-\frac1a$ の符号が打ち消し合うので、左右の役割を入れ替えて同じ議論が通る。
段 4(分散)。被積分関数は $0$ 以上で、段 3 と同じく $y=0$ の左右で別々に置換してから極限をとる。$y-(a\mu+b)=a(x-\mu)$ なので
$$
V(Y)=\int_{-\infty}^{\infty}\bigl(a(x-\mu)\bigr)^2f(x)\,dx=a^2\int_{-\infty}^{\infty}(x-\mu)^2f(x)\,dx=a^2V(X)
$$
である。$\square$
- $U$ が $[0,1]$ 上の一様分布に従うとき、$\alpha<\beta$ に対して $Y=(\beta-\alpha)U+\alpha$ の密度は、prop-pdn-linear から $\frac1{\beta-\alpha}\cdot1$($\alpha\le y\le\beta$)で、$[\alpha,\beta]$ 上の一様分布である。$E(Y)=(\beta-\alpha)\cdot\frac12+\alpha=\frac{\alpha+\beta}2$、$V(Y)=(\beta-\alpha)^2\cdot\frac1{12}=\frac{(\beta-\alpha)^2}{12}$ である。たとえば $[2,8]$ 上の一様分布では $E=5$、$V=\frac{36}{12}=3$ であり、直接計算しても $\int_2^8\frac x6\,dx=\frac{64-4}{12}=5$、$\int_2^8\frac{x^2}6\,dx=\frac{512-8}{18}=28$、$28-25=3$ である。
- 密度 $2x$ の $M$ について $Y=-2M+1$ とする($a=-2$、$b=1$)。密度は $g(y)=\frac12\cdot2\cdot\frac{y-1}{-2}=\frac{1-y}2$($-1\le y\le1$)で、$\int_{-1}^1\frac{1-y}2\,dy=1$ である。期待値は $-2\cdot\frac23+1=-\frac13$、分散は $4\cdot\frac1{18}=\frac29$ であり、$g$ から直接計算しても同じ値になる。
正規分布の標準化 $Z=\frac{X-\mu}\sigma$ は、prop-pdn-linear の $a=\frac1\sigma$、$b=-\frac\mu\sigma$ の場合である。正規分布での計算は 正規分布(高校数学) で扱う。
例と反例
def-pdn-density の 2 つの条件と、期待値が定まるための条件を 1 つずつ外すと、何が崩れるかを確かめる。最後の 2 行は、「どの確率変数も、とびとびの値をとるか密度をもつかのどちらかである」という思い込みへの反例である。
| 外した条件 | 崩れること | ボックス |
|---|---|---|
| $f(x)\ge0$ | 区間の確率が負や $1$ より大きくなる | ex-pdn-counter-negative |
| 全体の積分が $1$ | 「どこかの値をとる確率」が $1$ にならない | ex-pdn-counter-area |
| $\int xf(x)\,dx$ が収束する | 期待値が定まらない(分散だけが定まらない場合もある) | ex-pdn-counter-no-mean |
| 1 点の確率が $0$ | 密度関数をもたない | ex-pdn-counter-mixed |
| (1 点の確率はすべて $0$ でも) | 密度関数をもたない分布がある | ex-pdn-cantor |
$0\le x\le1$ で $f(x)=4x-1$、それ以外で $0$ とする。全体の積分は $\int_0^1(4x-1)\,dx=\bigl[2x^2-x\bigr]_0^1=1$ で、条件 2 は満たす。しかし $0\le x<\frac14$ で $f(x)<0$ である。もし $P(a\le X\le b)=\int_a^bf(x)\,dx$ となる $X$ があれば
$$
P\Bigl(0\le X\le\frac14\Bigr)=\Bigl[2x^2-x\Bigr]_0^{1/4}=\frac18-\frac14=-\frac18,\qquad P\Bigl(\frac14\le X\le1\Bigr)=1-\Bigl(-\frac18\Bigr)=\frac98
$$
となり、確率が負になったり $1$ を超えたりする。そのような確率変数はない。
満たす性質:全体の積分は $1$。満たさない性質:条件 1($f\ge0$)。崩れること:確率が $0$ 以上 $1$ 以下であること。
$0\le x\le1$ で $f(x)=x$、それ以外で $0$ とする。$f\ge0$ だが、$\int_0^1x\,dx=\frac12$ である。$f$ を密度とみなすと、$X$ が $0$ から $1$ のどこかの値をとる確率が $\frac12$ になり、$f$ が $0$ の範囲にも値をとらないので、「$X$ がどこかの値をとる確率は $1$」と合わない。
満たす性質:条件 1。満たさない性質:条件 2。崩れること:全体の確率が $1$ であること。ex-pdn-check の 4 と同じように定数倍して $2x$ にすれば密度関数になり、これは ex-pdn-max-intro の $M$ の密度である。
- $U$ を $(0,1]$ の値をとる一様な乱数とし、$X=\frac1U$ とする。$x\ge1$ なら「$X\le x$」は「$U\ge\frac1x$」なので $F(x)=1-\frac1x$ であり、微分すると密度は $f(x)=\frac1{x^2}$($x\ge1$、それ以外で $0$)である。$\int_1^R\frac{dx}{x^2}=1-\frac1R\to1$ なので、確かに密度関数の条件を満たす。しかし
$$ \int_1^Rx\cdot\frac1{x^2}\,dx=\int_1^R\frac{dx}x=\log R $$
は $R\to\infty$ でいくらでも大きくなり、広義積分 $\int_1^\infty xf(x)\,dx$ は収束しない。$X$ の期待値は定まらない。 - $X=\frac1{\sqrt U}$ とすると、$x\ge1$ で $F(x)=P\bigl(U\ge\frac1{x^2}\bigr)=1-\frac1{x^2}$ で、密度は $f(x)=\frac2{x^3}$ である。$\int_1^R\frac{2}{x^2}\,dx=2-\frac2R\to2$ なので期待値は $2$ と定まる。しかし $\int_1^Rx^2\cdot\frac2{x^3}\,dx=2\log R$ は収束しないので、$E(X^2)$ は定まらず、分散も定まらない(prop-pdn-variance-formula の仮定が満たされない)。
- 密度 $f(x)=\frac1{\pi(1+x^2)}$(すべての実数 $x$)の分布を Cauchy 分布 という(全体の積分が $1$ になることは $x=\tan\theta$ と置換すると確かめられる)。$\int_0^Rx\cdot\frac1{\pi(1+x^2)}\,dx=\frac1{2\pi}\log(1+R^2)$ は $R\to\infty$ でいくらでも大きくなるので、$X$ の期待値は定まらない。$xf(x)$ は 奇関数 なので $\int_{-R}^Rxf(x)\,dx=0$ がすべての $R$ で成り立つが、def-pdn-mean-var は $0$ 以上の側と $0$ 以下の側で別々に収束することを求めるので、これで期待値が $0$ になるわけではない。Cauchy 分布が平均をもたないことは 大数の法則とさいころの平均 でも扱っている。
満たす性質:密度関数の条件 1、2。満たさない性質:広義積分 $\int xf(x)\,dx$(2 では $\int x^2f(x)\,dx$)の収束。崩れること:期待値(分散)が定まること。値がとびとびの場合の同じ現象は 確率変数の期待値と分散 の反例(値が無限個ある場合)にある。
硬貨を投げ、表なら $X=0$、裏なら $X$ を $[0,1]$ 上の一様な乱数の値とする。雨の日と晴れの日がある 1 日の降水量のように、「ちょうど $0$」がある確率で起こり、それ以外は連続的に分布する量の模型である。分布関数は、$x<0$ で $F(x)=0$、$0\le x\le1$ で
$$
F(x)=P(\text{表})+P(\text{裏})\cdot x=\frac12+\frac x2
$$
であり、$x>1$ で $1$ である(図4)。$F$ は $x=0$ で高さ $\frac12$ の段をもつ。
- $X$ は密度関数をもたない。もしもてば、prop-pdn-point により $P(X=0)=0$ となるが、実際には $P(X=0)\ge P(\text{表})=\frac12$ だからである。
- $X$ は、とびとびの値だけをとる確率変数でもない。$0< c\le1$ なら $P(X=c)=\frac12P(\text{乱数}=c)=0$ なので、値 $0$ 以外の各点の確率はすべて $0$ である。とびとびの値(有限個または数え上げられる個数の値)の確率を足して $1$ にするには、各点の確率の和が $1$ でなければならないが、ここでは $0$ 以外の点の確率の和は $0$ で、$P(X=0)=\frac12$ と合わせても $\frac12$ にしかならない。
満たす性質:分布関数は減らない関数で、$0$ から $1$ まで増える。満たさない性質:1 点の確率がすべて $0$ であること。崩れること:密度関数をもつこと。期待値は $\frac12\cdot0+\frac12\cdot\frac12=\frac14$ と、場合に分けて計算できる。
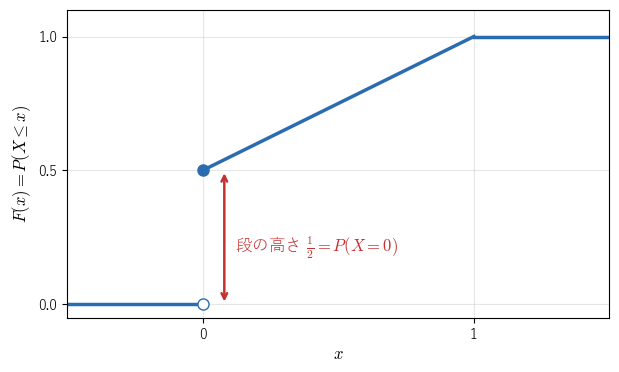 本文の反例の確率変数の分布関数。$x=0$ で高さ 1/2 の段があり、その後は直線で 1 まで増えることを見る図。段があることが、1 点に確率 1/2 が集まっていることを表す。
1 点の確率がすべて $0$ なら、分布関数に段はない。それでも密度関数をもつとは限らない。次の例は大学の確率論で有名なものである。まず有界な密度関数をもたないことを示し、次にこの記事で扱う密度関数(有限個の点を除いて連続)ももたないことを示す。
硬貨を無限に投げ続け、$k$ 回目が表なら $\varepsilon_k=1$、裏なら $\varepsilon_k=0$ として
$$
X=\sum_{k=1}^{\infty}\frac{2\varepsilon_k}{3^k}
$$
とする。$X$ は 3 進法で書いたとき各位の数字が $0$ か $2$ だけの数で、$[0,1]$ の値をとる。
- 1 点の確率は $0$。各位が $0$ か $2$ だけの 3 進法の表し方は 1 通りなので、$X=c$ となるには $\varepsilon_1,\dots,\varepsilon_k$ が $c$ の最初の $k$ 桁で決まる値にそろう必要がある($c$ にそのような表し方がなければ、$X=c$ となることはない)。その確率は $\frac1{2^k}$ 以下で、$k$ はいくらでも大きくとれるので $P(X=c)=0$ である。
- 有界な密度関数をもたない。最初の $k$ 回の結果を決めると、$X$ は長さ $\frac1{3^k}$ の閉区間に入る(残りの和は $0$ 以上 $\sum_{j>k}\frac2{3^j}=\frac1{3^k}$ 以下なので)。そのような区間は $2^k$ 個で、長さの合計は $\bigl(\frac23\bigr)^k$ である。これらの区間の合併を $C_k$ とすると、$X$ はいつも $C_k$ に入る。もし $X$ が $f(x)\le K$ となる密度関数 $f$ をもてば
$$ 1=P(X\in C_k)=\sum(\text{各区間での }f\text{ の積分})\le K\Bigl(\frac23\Bigr)^k $$
となるが、$k=10$ で右辺は $0.0173\ldots\times K$、$k$ を大きくすれば $0$ に近づくので矛盾する。 - 密度関数をもたない。$X$ が、def-pdn-density の意味の密度関数 $f$(有限個の点 $p_1,\dots,p_r$ を除いて連続)をもつとして矛盾を導く。prf-pdn-point の段 2・段 3 で見たとおり、各 $p_i$ について $\int_{p_i-h}^{p_i+h}f(x)\,dx$ は $h\to+0$ で $0$ に近づく。そこで $\delta>0$ を、$r$ 個の区間 $[p_i-\delta,p_i+\delta]$ での $f$ の積分の和が $\frac12$ 未満になるようにとる。$[0,1]$ から $r$ 個の開区間 $(p_i-\delta,p_i+\delta)$ を取り除いた残りは有限個の閉区間の和で、そこには除いた点がないので $f$ は連続であり、各閉区間で最大値をもつ(最大値・最小値の定理)。それらの最大値のうち最も大きいものを $K$ とする。$C_k$ の各区間での $f$ の積分を、区間 $[p_i-\delta,p_i+\delta]$ に入る部分と残りの部分に分けると、$f\ge0$ なので前の部分の合計は $\frac12$ 未満、残りの部分の合計は $K$ と長さの合計 $\bigl(\frac23\bigr)^k$ の積以下である。よって
$$ 1=P(X\in C_k)\le\frac12+K\Bigl(\frac23\Bigr)^k $$
である。$k$ を大きくすると右辺は $\frac12$ に近づくので矛盾する。
$C_1,C_2,\dots$ の共通部分が Cantor集合 で、$X$ はその上に分布する。満たす性質:1 点の確率はすべて $0$。満たさない性質:密度をもつこと(2・3)。崩れること:「段のない分布関数なら密度で書ける」という予想。大学の意味の密度(Lebesgue積分 で積分する密度)ももたないが、これは本記事では証明せず、理由を rem-pdn-density-ratio で述べる。
大学数学で見る
高校では、確率を「事象の起こりやすさ」として 1 つ 1 つの事象に与える。連続型の確率変数では、区間 $[a,b]$ ごとに $P(a\le X\le b)$ が決まり、重ならない区間の確率は足し算できる。大学では、区間だけでなく、区間から和・共通部分・補集合を(数え上げられる回数)くり返しとってできる集合(Borel 集合)の全体に確率を与える関数を 確率測度 とよび、確率変数の分布を $\mathbb{R}$ 上の確率測度として扱う(確率空間)。この見方では、とびとびの値の分布も、密度をもつ分布も、ex-pdn-counter-mixed や ex-pdn-cantor のような分布も、同じ「確率測度」の例になる。
期待値も 1 つの式で書ける。分布関数 $F$ を使った Stieltjes 積分 $E(X)=\int x\,dF(x)$ は、$F$ が段で増えるところでは $\sum x_kp_k$、$F$ が微分可能なところでは $\int xF'(x)\,dx=\int xf(x)\,dx$ になる。和と積分を同じ枠で扱う Stieltjes 積分は Stieltjes積分(高校数学) で扱っている。一般の確率測度による積分は Lebesgue積分 で定義される。
ex-pdn-density-value で見た $P(x\le X\le x+\Delta x)\approx f(x)\Delta x$ は、「確率 ÷ 長さ」の極限が密度であることを表している。thm-pdn-cdf の 1 は、$f$ が連続な点でこの極限が $f(x)$ に等しいことを示した。大学では、確率測度と長さの測度(Lebesgue 測度)の「比」として密度を定める(Radon–Nikodymの定理)。ex-pdn-cantor では、長さの合計が $0$ に近づく集合 $C_k$ の確率が $1$ のままであり、確率が長さに比例して小さくならないことが、密度で書けない理由になっている。
さらに先へ
2 つの確率変数の組 $(U,V)$ には、平面上の密度(同時密度)が考えられる。ex-pdn-max-intro の正方形の面積の計算はその最も簡単な場合で、独立な確率変数の和の密度は積分(畳み込み)で求められる(GS06 第 7 章)。高校数学で使う連続型の分布のうち、正規分布は 正規分布(高校数学) で、一様分布と待ち時間を表す指数分布は 一様分布と指数分布 で扱う。密度をもつ分布の中央値は 確率分布の中央値 にあり、そこでも密度 $2t$ の分布を例に使っている。身長のように値が連続的な量の母集団から標本を選んで平均を調べる話は、母集団と標本 と 区間推定(高校数学) で扱う。
関連項目
- 前提: 確率変数の期待値と分散, 定積分と面積, 区分求積と積分の定義, 微分積分学の基本定理
- 前に読む: 確率変数の期待値と分散, 区分求積と積分の定義
- 次に読む: 正規分布(高校数学), 二項分布から正規分布へ
- 関連(高校数学): 確率分布の中央値, Gauss積分(高校数学), 一様分布と指数分布, Stieltjes積分(高校数学)
- 発展: 確率密度関数, 確率変数, 確率空間, Lebesgue積分, 分布関数
- 比較: 二項分布, 広義積分
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

