動的計画法と最適制御
概要
動的計画法と最適制御(dynamic programming and optimal control)とは、決定を何段にも重ねる問題を、ある状態から先の最適費用を表す価値関数の漸化式(Bellman 方程式)に直し、終わりの段から後ろ向きに解く計算の型である。最適な列の後半はそれ自身最適であるという Bellman の最適性原理が根拠で、状態と行動が有限なら表の計算になる。線形の系と 2 次の費用では Riccati 漸化式で最適なフィードバックの係数が求まり、割引のある無限期間の問題は価値反復で解ける。在庫管理、機械の保守、制御器の設計に使う。
前提知識: 重み付きグラフの最短経路, 正定値行列, Banachの不動点定理, Markov連鎖
動的計画法と最適制御(dynamic programming and optimal control)は、決定を何段にも重ねる問題を、「この状態から先に最低いくらかかるか」を表す関数の漸化式に直して解く計算の型である。
たとえば、4 期にわたる在庫の問題を考える。毎期の発注量を決めると、発注費と保管費がかかる。発注量の組合せは期の数について指数的に増えるが、「$t$ 期のはじめの在庫が $x$ のとき、残りの期に最低いくらかかるか」を $V_t(x)$ と書けば、$V_t$ は $V_{t+1}$ から 1 段の最小化で求まる。終わりの期から順に表を埋めれば、全部の組合せを調べずに答えが出る。
$$
V_t(x)=\min_{u}\bigl\{(\text{今の段の費用})+V_{t+1}(\text{次の状態})\bigr\}
$$
この式を Bellman 方程式 という。根拠は、最適な決定の列の後半は、途中の状態から始まる問題の最適な列になっている、という性質である(Bellman の最適性原理)。動的計画法の枠組みは Bellman が 1950 年代半ばに定式化し、広めた(Eri19 第 3 章、p. 101)。
この記事では、アルゴリズム設計の方法としての一般論は 動的計画法 に任せ、状態・行動・費用で書いた決定の問題 を扱う。次を証明する。
- 有限段の問題で、後ろ向きの漸化式の解が最適な費用であり、最適な列の特徴づけと最適性原理が成り立つこと(thm-dpoc-bellman)。
- 線形の系と 2 次の費用では、最適な行動が状態の線形関数で、係数が Riccati 漸化式で決まること(thm-dpoc-lq)。
- 割引のある無限期間の問題で、価値反復が等比的に収束し、止める判定の誤差が評価できること(thm-dpoc-vi)。
- 連続時間の問題で、Hamilton–Jacobi–Bellman 方程式の滑らかな解が最適な費用を与えること(prop-dpoc-hjb)。
定義と使える条件
$T\ge1$ を段の数とする。有限段の決定問題 は、次のものからなる。各 $t=0,\dots,T$ について状態の集合 $S_t$。各 $t< T$ と $x\in S_t$ について、選べる 行動 の空でない集合 $U_t(x)$、次の状態を決める写像 $f_t(x,u)\in S_{t+1}$、段の費用 $g_t(x,u)\in\mathbb{R}$。終端の費用 $g_T\colon S_T\to\mathbb{R}$。
時刻 $t$ の状態 $x$ から始めて行動の列 $(u_t,\dots,u_{T-1})$($u_s\in U_s(x_s)$)を選ぶと、状態は $x_t=x$、$x_{s+1}=f_s(x_s,u_s)$ と動き、費用は
$$
J_t(x;u_t,\dots,u_{T-1}):=\sum_{s=t}^{T-1}g_s(x_s,u_s)+g_T(x_T)
$$
である。$J_t$ の下限 $V_t(x)$ を 価値関数(最適費用)という。$J_t$ の最小を与える行動の列を 最適な列 という。各段で状態から行動を決める写像の組 $\mu=(\mu_0,\dots,\mu_{T-1})$($\mu_t(x)\in U_t(x)$)を 政策 という。
動的計画法が使えるのは、次の 3 つの条件が成り立つときである。
(i) 状態で足りる:次の状態と段の費用が、今の状態と行動だけで決まる。過去の履歴に依存するなら、その情報を状態に入れて問題を書き直す。
(ii) 費用が足し算で分かれる:全体の費用が、段の費用の和である。
(iii) 最小が存在する:各段の最小化で最小値がとれる。$U_t(x)$ が有限集合なら自動的に成り立つ。
3 つの条件が要ることは、ex-dpoc-counterexamples で確かめる。
公式の表
どの行も「後ろ向きに 1 段ずつ最小化する」という同じ形をしている。
| 問題 | 再帰式 | 使える条件 | 根拠 |
|---|---|---|---|
| 有限段・決定的 | $V_T=g_T$、$V_t(x)=\min_u\{g_t(x,u)+V_{t+1}(f_t(x,u))\}$ | 上の (i)(ii)(iii) | thm-dpoc-bellman |
| 有限段・確率的 | $V_t(x)=\min_u\bigl\{g_t(x,u)+\sum_yp_t(y\mid x,u)V_{t+1}(y)\bigr\}$ | 状態と行動が有限、政策の中で比較 | 下の導出 |
| 最短の道 | $d_k(v)=\min\bigl\{d_{k-1}(v),\min_{w\to v}(d_{k-1}(w)+\ell(w,v))\bigr\}$ | 辺が $k$ 本以下の道の最短の長さ | thm-dpoc-bellman(頂点 $v$ から辺を逆向きにたどって始点へ戻る問題に直し、「動かない」行動を費用 $0$ で足す。状態は残りの段で始点へ戻れる頂点に限る) |
| 離散時間の LQ | $P_t=Q+A^{\mathsf T}P_{t+1}A-A^{\mathsf T}P_{t+1}B(R+B^{\mathsf T}P_{t+1}B)^{-1}B^{\mathsf T}P_{t+1}A$ | $Q,Q_T$ が半正定値、$R$ が正定値 | thm-dpoc-lq |
| 同じ漸化式の別の形 | $P_t=Q+K_t^{\mathsf T}RK_t+(A-BK_t)^{\mathsf T}P_{t+1}(A-BK_t)$ | 同上、$K_t$ は thm-dpoc-lq の係数 | 下の導出 |
| 割引のある無限期間 | $V(x)=\min_a\bigl\{c(x,a)+\beta\sum_yp(y\mid x,a)V(y)\bigr\}$ | 状態と行動が有限、$0\le\beta< 1$ | thm-dpoc-vi |
| 連続時間(HJB) | $-\partial_tV=\min_u\{\ell(t,x,u)+\nabla_xV\cdot f(t,x,u)\}$、$V(T,x)=g(x)$ | $V$ が $C^1$ 級で最小が存在 | prop-dpoc-hjb |
| 連続時間の LQ | $-\dot S=A^{\mathsf T}S+SA-SBR^{-1}B^{\mathsf T}S+Q$、$S(T)=Q_T$ | $R$ が正定値、解 $S$ が $[0,T]$ で存在 | prop-dpoc-hjb と下の導出。式は AMF20 §7.5 の (7.31) と同じ |
確率的な有限段の式の導出を開く
状態と行動を有限とし、$p_t(y\mid x,u)$ を遷移の確率、$J^\mu_t(x)$ を政策 $\mu$ に従うときの、時刻 $t$ の状態 $x$ から先の費用の期待値とする。Markov 性から $J^\mu_T=g_T$、$J^\mu_t(x)=g_t(x,\mu_t(x))+\sum_yp_t(y\mid x,\mu_t(x))J^\mu_{t+1}(y)$ である。表の式で定めた関数を $W_t$ とする。$J^\mu_{t+1}\ge W_{t+1}$ なら、確率の重みは $0$ 以上なので $J^\mu_t(x)\ge g_t(x,\mu_t(x))+\sum_yp_t(y\mid x,\mu_t(x))W_{t+1}(y)\ge W_t(x)$ となる。各段で最小を与える行動を選ぶ政策では、すべての不等号が等号になる。よって $W_t=\min_\mu J^\mu_t$ である。
Riccati 漸化式の別の形の導出を開く
$P:=P_{t+1}$、$S:=R+B^{\mathsf T}PB$、$K:=K_t=S^{-1}B^{\mathsf T}PA$ とおくと $B^{\mathsf T}PA=SK$ である。展開すると $K^{\mathsf T}RK+(A-BK)^{\mathsf T}P(A-BK)=A^{\mathsf T}PA-A^{\mathsf T}PBK-K^{\mathsf T}B^{\mathsf T}PA+K^{\mathsf T}SK=A^{\mathsf T}PA-K^{\mathsf T}SK$ となる。$K^{\mathsf T}SK=A^{\mathsf T}PBS^{-1}B^{\mathsf T}PA$ だから、もとの式と一致する。半正定値の行列の和の形なので、数値計算で対称性と半正定値性が崩れにくい。
連続時間の LQ の Riccati 方程式の導出を開く
$\dot x=Ax+Bu$、$\ell=x^{\mathsf T}Qx+u^{\mathsf T}Ru$、$V(t,x)=x^{\mathsf T}S(t)x$($S$ は対称行列)とおく。$\nabla_xV=2Sx$ より、HJB の右辺の中身は $x^{\mathsf T}Qx+u^{\mathsf T}Ru+2x^{\mathsf T}S(Ax+Bu)$ である。$u$ について平方を完成すると、最小は $u=-R^{-1}B^{\mathsf T}Sx$ でとられ、最小値は $x^{\mathsf T}(Q+A^{\mathsf T}S+SA-SBR^{-1}B^{\mathsf T}S)x$ である。左辺は $-x^{\mathsf T}\dot Sx$ なので、すべての $x$ で等しいことは表の方程式と同値である。
主定理と証明
有限段の問題
def-dpoc-finite の問題で、$W_T:=g_T$ とし、$t=T-1,\dots,0$ の順に
$$
W_t(x):=\min_{u\in U_t(x)}\bigl\{g_t(x,u)+W_{t+1}(f_t(x,u))\bigr\}
$$
が定まる(すべての $t$ と $x$ で最小値が存在する)と仮定する。このとき次が成り立つ。
(1) すべての $t$ と $x$ で $V_t(x)=W_t(x)$ である。
(2) 時刻 $t$ の状態 $x$ から始める列 $(u_t,\dots,u_{T-1})$ が最適であることは、すべての $s\ge t$ で $u_s$ が $W_s(x_s)$ の最小を与えることと同値である。
(3)(最適性原理)$(u_0,\dots,u_{T-1})$ が状態 $x_0$ から始める最適な列なら、各 $t$ で $(u_t,\dots,u_{T-1})$ は時刻 $t$ の状態 $x_t$ から始める最適な列である。
(4) 各 $t,x$ で最小を与える行動の 1 つを $\mu^*_t(x)$ とする政策 $\mu^*$ は、どの時刻のどの状態から始めても最適な列を与える。
時刻 $t$ の状態 $x$ から始める列 $(u_t,\dots,u_{T-1})$ を任意にとり、$x_s$ を対応する状態の列とする。各 $s\ge t$ について
$$
D_s:=g_s(x_s,u_s)+W_{s+1}(x_{s+1})-W_s(x_s)
$$
とおく。$x_{s+1}=f_s(x_s,u_s)$ であり、$W_s(x_s)$ は最小値なので $D_s\ge0$ である。$D_s=0$ となるのは、$u_s$ が $W_s(x_s)$ の最小を与えるときに限る。$D_s$ を足すと $W$ の項は打ち消し合い、$W_T=g_T$ より
$$
\sum_{s=t}^{T-1}D_s=\sum_{s=t}^{T-1}g_s(x_s,u_s)+g_T(x_T)-W_t(x)=J_t(x;u_t,\dots,u_{T-1})-W_t(x)
$$
となる。よって、すべての列で $J_t\ge W_t(x)$ であり、等号はすべての $D_s$ が $0$ のときに限る。
各段で最小を与える行動を順に選べば、$D_s=0$ となる列が実際に作れる。したがって $W_t(x)$ は下限で、しかも最小値である。これで (1) と (2) と (4) が示せた。
(3) を示す。$t=0$ に (2) を使うと、すべての $s$ で $u_s$ は $W_s(x_s)$ の最小を与える。その条件のうち $s\ge t$ の部分は、(2) により $(u_t,\dots,u_{T-1})$ が時刻 $t$ の状態 $x_t$ から最適であることを意味する。$\square$
この証明は、最適な列に限らず どの列についても、最適費用との差が各段の「損失」$D_s$ の和に分かれることを示している。最適でない選択をした段で、$D_s$ の分だけ費用が増える。
線形の系と 2 次の費用
状態 $x_t\in\mathbb{R}^n$、行動 $u_t\in\mathbb{R}^m$、$A,B$ を定まった行列として $x_{t+1}=Ax_t+Bu_t$ で動く系に、費用
$$
\sum_{t=0}^{T-1}\bigl(x_t^{\mathsf T}Qx_t+u_t^{\mathsf T}Ru_t\bigr)+x_T^{\mathsf T}Q_Tx_T
$$
を考える。$Q,Q_T$ は対称な半正定値行列、$R$ は正定値行列である。この問題を LQ 制御(linear quadratic control)という。
$P_T:=Q_T$ とし、$t=T-1,\dots,0$ の順に
$$
K_t:=(R+B^{\mathsf T}P_{t+1}B)^{-1}B^{\mathsf T}P_{t+1}A,\qquad
P_t:=Q+A^{\mathsf T}P_{t+1}A-A^{\mathsf T}P_{t+1}B(R+B^{\mathsf T}P_{t+1}B)^{-1}B^{\mathsf T}P_{t+1}A
$$
と定める。このとき、すべての $P_t$ は対称な半正定値行列で、途中の逆行列は存在する。時刻 $t$ の状態 $x$ から先の最適費用は $V_t(x)=x^{\mathsf T}P_tx$ である。最適な列はただ 1 つで、$u_t=-K_tx_t$ で与えられる。
$P$ を対称な半正定値行列とする。$S:=R+B^{\mathsf T}PB$ は、$R$ が正定値で $B^{\mathsf T}PB$ が半正定値なので、正定値で対称であり、逆行列をもつ。$K:=S^{-1}B^{\mathsf T}PA$ とおくと $B^{\mathsf T}PA=SK$ だから、すべての $x,u$ について
\begin{align*}
&x^{\mathsf T}Qx+u^{\mathsf T}Ru+(Ax+Bu)^{\mathsf T}P(Ax+Bu)\\
&=x^{\mathsf T}(Q+A^{\mathsf T}PA)x+2u^{\mathsf T}SKx+u^{\mathsf T}Su\\
&=(u+Kx)^{\mathsf T}S(u+Kx)+x^{\mathsf T}(Q+A^{\mathsf T}PA-K^{\mathsf T}SK)x
\end{align*}
が成り立つ。$K^{\mathsf T}SK=A^{\mathsf T}PBS^{-1}B^{\mathsf T}PA$ である。$S$ は正定値なので、この式を $u$ について最小にする $u$ は $u=-Kx$ ただ 1 つで、最小値は $x^{\mathsf T}P^+x$ である。ここで $P^+$ は、$P=P_{t+1}$ のときの $P_t$ の式の右辺で、対称である。左辺は $u$ によらず $0$ 以上なので、$x^{\mathsf T}P^+x\ge0$ であり、$P^+$ は半正定値である。
$W_T(x)=x^{\mathsf T}P_Tx$ から始めて、$W_{t+1}(x)=x^{\mathsf T}P_{t+1}x$ なら上の計算により $W_t(x)=x^{\mathsf T}P_tx$ で、最小は $u=-K_tx$ だけでとられる。thm-dpoc-bellman の仮定が成り立つので、$V_t=W_t$ である。同じ定理の (2) により、最適な列は各段で最小を与える行動の列であり、それはただ 1 つに決まる。$\square$
割引のある無限期間の問題
割引のある決定過程 は、有限集合 $S$(状態)、各 $x\in S$ で選べる行動の空でない有限集合 $A(x)$、費用 $c(x,a)\in\mathbb{R}$、遷移の確率 $p(y\mid x,a)$、割引率 $0\le\beta< 1$ からなる。
定常な政策 $\mu$ は各状態に行動 $\mu(x)\in A(x)$ を与える写像である。$P_\mu$ を成分 $p(y\mid x,\mu(x))$ の遷移行列、$c_\mu$ を成分 $c(x,\mu(x))$ のベクトルとし、$\mu$ の費用を
$$
V^\mu:=\sum_{t=0}^{\infty}\beta^tP_\mu^tc_\mu
$$
と定める。第 $t$ 項の $x$ 成分は、Markov連鎖 として動かしたときの $t$ 期目の費用の期待値に $\beta^t$ を掛けたものである。ベクトル $v\in\mathbb{R}^S$ に対し
$$
(T_\mu v)(x):=c(x,\mu(x))+\beta\sum_yp(y\mid x,\mu(x))v(y),\qquad(Tv)(x):=\min_{a\in A(x)}\Bigl\{c(x,a)+\beta\sum_yp(y\mid x,a)v(y)\Bigr\}
$$
とおき、$\|v\|:=\max_x\lvert v(x)\rvert$ とする。$T_\mu v=Tv$ となる $\mu$ を、$v$ に関する 貪欲な政策 という。
def-dpoc-mdp の問題で、次が成り立つ。
(1) すべての $v,w$ について $\|Tv-Tw\|\le\beta\|v-w\|$ である。
(2) $Tv=v$ を満たす $v$ はただ 1 つである。これを $V^*$ とすると、どの $V_0$ から始めても $V_{k+1}:=TV_k$ は $\|V_k-V^*\|\le\beta^k\|V_0-V^*\|$ を満たす。
(3) すべての定常な政策 $\mu$ で $V^\mu\ge V^*$(成分ごと)であり、$V^*$ に関する貪欲な政策 $\mu^*$ では $V^{\mu^*}=V^*$ である。
(4) $\|V_{k+1}-V_k\|\le\varepsilon$ なら $\|V_{k+1}-V^*\|\le\dfrac{\beta}{1-\beta}\varepsilon$ である。
(5) $V_k$ に関する貪欲な政策 $\mu_k$ は $\|V^{\mu_k}-V^*\|\le\dfrac{2\beta}{1-\beta}\|V_k-V^*\|$ を満たす。
- $x$ を固定し、$Tw(x)$ の最小を与える行動を $a$ とする。$Tv(x)$ は最小値なので
$$ Tv(x)-Tw(x)\le\beta\sum_yp(y\mid x,a)\bigl(v(y)-w(y)\bigr)\le\beta\|v-w\| $$
である。$v$ と $w$ を入れかえれば、絶対値の評価が得られる。 -
- より $T$ は完備な距離空間 $(\mathbb{R}^S,\|\cdot\|)$ の縮小写像なので、Banachの不動点定理 により不動点がただ 1 つある。$\|V_{k+1}-V^*\|=\|TV_k-TV^*\|\le\beta\|V_k-V^*\|$ を $k$ 回使うと評価が得られる。
- 同じ計算で $T_\mu$ も比 $\beta$ の縮小であり、$T_\mu^kv=\sum_{t< k}\beta^tP_\mu^tc_\mu+\beta^kP_\mu^kv$ より $T_\mu^kv\to V^\mu$ である。とくに $V^\mu$ は $T_\mu$ のただ 1 つの不動点である。また、$v\le w$(成分ごと)なら $T_\mu v\le T_\mu w$ である。$T$ の定義から $T_\mu V^*\ge TV^*=V^*$ なので、繰り返すと $T_\mu^kV^*\ge V^*$ となり、$k\to\infty$ として $V^\mu\ge V^*$ を得る。$\mu^*$ が貪欲なら $T_{\mu^*}V^*=TV^*=V^*$ だから、$V^*$ は $T_{\mu^*}$ の不動点であり、不動点の一意性から $V^{\mu^*}=V^*$ である。
- $\|V_{k+1}-V^*\|=\|TV_k-TV^*\|\le\beta\|V_k-V^*\|\le\beta\bigl(\|V_k-V_{k+1}\|+\|V_{k+1}-V^*\|\bigr)$ を $\|V_{k+1}-V^*\|$ について解く。
- $\mu:=\mu_k$ とする。$T_\mu V_k=TV_k$ と $V^\mu=T_\mu V^\mu$、$V^*=TV^*$ より
$$ \|V^\mu-V^*\|\le\|T_\mu V^\mu-T_\mu V_k\|+\|TV_k-TV^*\|\le\beta\|V^\mu-V_k\|+\beta\|V_k-V^*\|\le\beta\|V^\mu-V^*\|+2\beta\|V_k-V^*\| $$
である。これを $\|V^\mu-V^*\|$ について解く。$\square$
- の比較は定常な政策の中で行っている。時刻によって変わる政策や履歴による政策と比べても改善しないことは、Markov決定過程 の定理「Bellman 方程式と最適方策」の (2) にある(同記事は報酬を最大にする形で書かれ、$c=-r$ で移り合う)。有限の問題の $V^*$ の一意性と貪欲な政策の最適性は SB18 §3.6(pp. 63–64)にも述べられている。
連続時間の問題
$\dot x=f(t,x,u)$、$x(0)=x_0$、$u(t)\in U$ の系と、費用 $J=\int_0^T\ell(t,x(t),u(t))\,dt+g(x(T))$ を考える。$u$ は区分的に連続、$f,\ell$ は連続で、解 $x$ は $[0,T]$ の上に存在するものだけを比べる。$V\colon[0,T]\times\mathbb{R}^n\to\mathbb{R}$ が $C^1$ 級で、$V(T,x)=g(x)$ と
$$
\partial_tV(t,x)+\min_{u\in U}\bigl\{\ell(t,x,u)+\nabla_xV(t,x)\cdot f(t,x,u)\bigr\}=0
$$
を満たす(最小は存在する)とする。このとき、すべての $(x,u)$ で $J\ge V(0,x_0)$ である。$u(t)$ が $u$ の連続点の各時刻で上の最小を与えるなら、等号が成り立つ。
$(x,u)$ をとる。$u$ の連続点で
$$
\frac{d}{dt}V(t,x(t))=\partial_tV+\nabla_xV\cdot f(t,x(t),u(t))\ge-\ell(t,x(t),u(t))
$$
である。不等号は、$V$ の方程式から $\partial_tV+\ell+\nabla_xV\cdot f\ge0$ が任意の $u\in U$ で成り立つことによる。$t\mapsto V(t,x(t))$ は連続で区分的に $C^1$ 級なので、$0$ から $T$ まで積分でき、$g(x(T))-V(0,x_0)\ge-\int_0^T\ell\,dt$ となる。これは $J\ge V(0,x_0)$ である。各時刻で $u(t)$ が最小を与えるなら不等号は等号になり、$J=V(0,x_0)$ である。$\square$
この命題は十分条件である。$C^1$ 級の解は存在するとは限らず(ex-dpoc-counterexamples)、最小を与える $u$ で閉じた系に解があることも別に確かめる。
計算の手順
有限段の問題は次の順に解く。
- 定式化:段、状態、行動、次の状態、段の費用を決める。条件 (i)(ii) を確かめる。ここで迷うのは、ほとんどの場合、状態に何を入れるかである。「残りの問題を解くのに、過去のうち何を覚えていれば足りるか」と問う。
- 終端:$V_T=g_T$ を書く。
- 後ろ向きの計算:$t=T-1,\dots,0$ の順に、すべての状態 $x$ について thm-dpoc-bellman の最小化を行い、$V_t(x)$ と最小を与える行動 $\mu_t(x)$ を表に記録する。
- 前向きの復元:与えられた $x_0$ から $u_t=\mu_t(x_t)$、$x_{t+1}=f_t(x_t,u_t)$ と進める。最小を与える行動が複数あるときは、thm-dpoc-bellman の (2) により、どれを選んでも最適である。
手順の分岐は問題の型で決まる。割引のある無限期間の問題では、価値反復 を次のように行う。問題の型 手順 3 の中身 結果の形 計算量の目安 状態と行動が有限 表を埋める 価値の表と行動の表 乗算と比較が $T\lvert S\rvert\lvert U\rvert$ 回程度 LQ $P_t,K_t$ の漸化式(thm-dpoc-lq) $u_t=-K_tx_t$ $n\times n$ の行列の演算が $T$ 回 割引のある無限期間 下の価値反復 定常な政策 1 反復が状態数 $\times$ 行動数 $\times$ 遷移先の数 連続時間の LQ Riccati方程式を $t=T$ から逆向きに解く $u=-R^{-1}B^{\mathsf T}S(t)x$ 常微分方程式の数値解 - $V_0$(たとえば $0$)と許容誤差 $\delta>0$ を決める。
- $V_{k+1}:=TV_k$ を計算する。
- $\|V_{k+1}-V_k\|\le\delta(1-\beta)/\beta$ なら止める。thm-dpoc-vi の (4) により $\|V_{k+1}-V^*\|\le\delta$ である($\beta=0$ のときは 1 反復で $V_1=V^*$ なので判定は要らない)。
- $V_{k+1}$ に関する貪欲な政策を出力する。費用の差は thm-dpoc-vi の (5) で評価できる。
反復の回数は、$\|V_k-V^*\|\le\beta^k\|V_0-V^*\|$ から $\log(\|V_0-V^*\|/\delta)/\log(1/\beta)$ 回程度である。$\beta$ が $1$ に近いと回数が増える。
例題
地点 $A$ から $D$ へ、$B_1,B_2$ のどちらかと $C_1,C_2$ のどちらかを通って進む。辺の長さは $A\to B_1:2$、$A\to B_2:4$、$B_1\to C_1:7$、$B_1\to C_2:3$、$B_2\to C_1:2$、$B_2\to C_2:4$、$C_1\to D:3$、$C_2\to D:5$ である。
使う公式:thm-dpoc-bellman。
答え:最短の長さは $V(A)=9$ で、道は $A\to B_2\to C_1\to D$ である。最初の辺だけを見て短い $B_1$ へ進むと、その先をどう選んでも合計は $10$ 以上になる。
途中の計算を開く
終点から順に $V(D)=0$、$V(C_1)=3$、$V(C_2)=5$ である。$V(B_1)=\min\{7+3,\ 3+5\}=8$($C_2$ へ)、$V(B_2)=\min\{2+3,\ 4+5\}=5$($C_1$ へ)である。$V(A)=\min\{2+8,\ 4+5\}=9$($B_2$ へ)である。
需要が $d=(2,3,2,4)$ で、品切れは許さない。期のはじめの在庫を $x$、発注量を $q\ge0$ とすると、期の終わりの在庫は $y=x+q-d_t\ge0$ である。費用は、発注すれば固定費 $6$(発注量によらない)と、期の終わりの在庫 $1$ 個あたり $1$ である。はじめの在庫は $0$、残った在庫の処分の費用は $0$ とする。
使う公式:thm-dpoc-bellman(状態は期のはじめの在庫)。
答え:最小の費用は $V_0(0)=19$ である。最適な発注量の列は $(5,0,6,0)$ と $(7,0,0,4)$ の 2 通りである。
価値の表を開く
$V_4=0$ から後ろ向きに計算する。在庫 $x$ に対する $V_t(x)$ は次のとおりである。
| $x$ | 0 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|---|
| $V_3$ | 6 | 6 | 6 | 6 | 0 | 1 | 2 |
| $V_2$ | 10 | 10 | 6 | 7 | 8 | 9 | 4 |
| $V_1$ | 14 | 14 | 14 | 10 | 11 | 8 | 10 |
たとえば $V_2(0)$ は、需要 $2$ を満たすために発注が要り、$y$ を選ぶ問題になる。$y=4$ のとき $6+4+V_3(4)=10$、$y=0$ のとき $6+0+V_3(0)=12$ で、最小は $10$ である。最後に $V_0(0)=\min_{y\ge0}\{6+y+V_1(y)\}$ は、$y=3$ で $6+3+10=19$、$y=5$ で $6+5+8=19$ と 2 か所でとられる。これが 2 通りの最適な計画に対応する。
$x_{t+1}=x_t+u_t$、$T=3$、$Q=R=Q_T=1$、$x_0=1$ とする。
使う公式:thm-dpoc-lq。
答え:$P_3=1$、$P_2=\tfrac32$、$P_1=\tfrac85$、$P_0=\tfrac{21}{13}$ で、最適費用は $\tfrac{21}{13}\approx1.61538$ である。最適な行動は $u=(-\tfrac8{13},-\tfrac3{13},-\tfrac1{13})$、状態は $x=(1,\tfrac5{13},\tfrac2{13},\tfrac1{13})$ である。
途中の計算と Fibonacci 数との関係を開く
$A=B=Q=R=1$ なので、漸化式は $P_t=1+P_{t+1}-\dfrac{P_{t+1}^2}{1+P_{t+1}}=1+\dfrac{P_{t+1}}{1+P_{t+1}}$、係数は $K_t=\dfrac{P_{t+1}}{1+P_{t+1}}$ である。よって $K_2=\tfrac12$、$K_1=\tfrac35$、$K_0=\tfrac8{13}$ である。$F_n$ を Fibonacci数 とすると $P_{T-n}=F_{2n+2}/F_{2n+1}$ である。実際、$a=F_{2n+2}$、$b=F_{2n+1}$ とすると $1+\dfrac{a/b}{1+a/b}=\dfrac{2a+b}{a+b}=\dfrac{F_{2n+4}}{F_{2n+3}}$ である。したがって段の数を増やすと、$P$ は黄金比 $\tfrac{1+\sqrt5}2\approx1.61803$ に近づく。これは不動点の方程式 $P^2=P+1$ の正の解である。
位置と速度を成分とする状態 $x_t\in\mathbb{R}^2$ が
$$
A=\begin{pmatrix}1&1\\0&1\end{pmatrix},\quad B=\begin{pmatrix}0\\1\end{pmatrix}
$$
で動くとする(行動は速度の変化)。$Q=Q_T=\operatorname{diag}(1,0)$(位置の 2 乗だけに費用をかける)、$R=1$、$T=3$、$x_0=(1,0)^{\mathsf T}$ とする。
使う公式:thm-dpoc-lq。
答え:最適費用は $x_0^{\mathsf T}P_0x_0=\tfrac52=2.5$ である。最適な行動は $u=(-\tfrac12,0,0)$ で、位置は $1,1,\tfrac12,0$ と動く。
途中の計算を開く
$P_3=Q_T$ から $P_2=\begin{pmatrix}2&1\\1&1\end{pmatrix}$、$P_1=\begin{pmatrix}5/2&2\\2&3\end{pmatrix}$、$P_0=\begin{pmatrix}5/2&2\\2&13/4\end{pmatrix}$ である。係数は $K_2=(0,\ 0)$、$K_1=(\tfrac12,\ 1)$、$K_0=(\tfrac12,\ \tfrac54)$ である。$K_2=0$ なのは、最後の行動は終端の位置を変えない(費用がかからない速度しか変えない)からである。費用の内訳は、位置の 2 乗の和 $1+1+\tfrac14+0=\tfrac94$ と、行動の 2 乗の和 $\tfrac14$ である。
機械の状態は 良・劣化・故障 の 3 つで、毎期「運転」か「修理」を選ぶ。割引率は $\beta=0.9$ である。
| 状態 | 運転の費用 | 運転したときの次の状態 | 修理の費用 |
|---|---|---|---|
| 良 | $0$ | 良 $0.7$、劣化 $0.3$ | $5$ |
| 劣化 | $2$ | 劣化 $0.6$、故障 $0.4$ | $5$ |
| 故障 | $10$ | 故障 $1$ | $8$ |
修理すると、次の期は必ず 良 になる。
使う公式:thm-dpoc-vi。
答え:最適な政策は「良なら運転、劣化・故障なら修理」で、最適費用は $V^*(\text{良})\approx10.6299$、$V^*(\text{劣化})\approx14.5669$、$V^*(\text{故障})\approx17.5669$ である。
途中の計算を開く
この政策の費用は線形方程式で求まる。$v_{\text{劣化}}=5+0.9v_{\text{良}}$、$v_{\text{故障}}=8+0.9v_{\text{良}}$、$v_{\text{良}}=0.9(0.7v_{\text{良}}+0.3v_{\text{劣化}})$ より、$v_{\text{良}}(1-0.63-0.243)=1.35$ で、$v_{\text{良}}=1.35/0.127\approx10.6299$ である。この $v$ は $Tv=v$ を満たす。たとえば劣化の状態で運転すると $2+0.9(0.6\cdot14.5669+0.4\cdot17.5669)\approx16.19$ で、修理の $14.5669$ より大きい。$V_0=0$ から価値反復を行うと、誤差 $\|V_k-V^*\|$ は次のように減る。$V_1$ に関する貪欲な政策がすでに最適な政策に一致し、以後は変わらない。
| $k$ | 1 | 10 | 20 | 50 | 100 |
|---|---|---|---|---|---|
| 誤差 | 12.5669 | 4.2914 | 1.4963 | 0.06343 | 0.000327 |
終盤の誤差の比は $0.9$ で、thm-dpoc-vi の (2) の比どおりである。$\|V_{k+1}-V_k\|\le10^{-3}$ となる最初の反復では、$\|V_{k+1}-V^*\|\approx0.00857$ で、(4) の上界 $9\times10^{-3}$ より小さい。差の小ささをそのまま誤差と読むと、$9$ 倍近く見誤る。
$\dot x=u$、$x(0)=1$、費用 $\int_0^1(x^2+u^2)\,dt$ とする($T=1$、終端の費用は $0$)。
使う公式:prop-dpoc-hjb、公式の表の連続時間の LQ の行。
答え:Riccati 方程式の解は $S(t)=\tanh(1-t)$ で、最適なフィードバックは $u=-\tanh(1-t)\,x$、最適費用は $\tanh1\approx0.76159$ である。
途中の計算を開く
$A=0$、$B=Q=R=1$、$Q_T=0$ なので、方程式は $-\dot S=1-S^2$、$S(1)=0$ である。$S(t)=\tanh(1-t)$ は $\dot S=-(1-\tanh^2(1-t))=-(1-S^2)$ と $S(1)=0$ を満たす。$V(t,x)=S(t)x^2$ は $C^1$ 級で HJB 方程式を満たす。閉じた系 $\dot x=-S(t)x$ は線形なので解が $[0,1]$ で存在し、prop-dpoc-hjb の等号の条件が成り立つ。よって最適費用は $V(0,1)=\tanh1$ である。
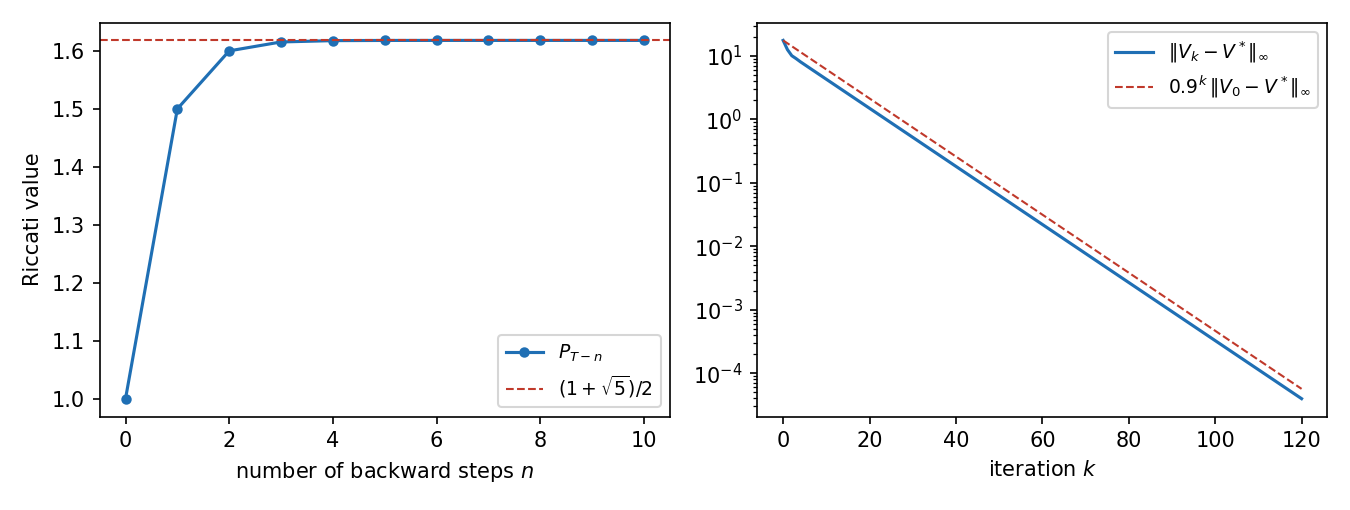 左:スカラーの LQ 制御で、後ろ向きの段の数 n に対する Riccati 漸化式の値。黄金比に近づく。右:機械の保守の例の価値反復の誤差。片対数の目盛りで、比 0.9 の直線の下にある。
使える条件と反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 最小の存在 | $T=1$、$U_0=(0,1]$、$g_0(x,u)=u$、$g_1=0$ | 下限 $0$ はとられず、最適な列がない |
| 費用が足し算で分かれる | 全体の費用が $(g_0+g_1)^2$ の形 | 最適な列の後半が、後半だけの問題の最適な列にならない |
| 状態で足りる | 行動を変えると切替の費用がかかるのに、状態に前の行動を入れない | 再帰式の値が本当の費用と合わず、誤った列を選ぶ |
| $R$ が正定値 | $T=1$、$A=B=1$、$Q=0$、$Q_T=\tfrac12$、$R=-1$ | Riccati の式の値は有限だが、費用は下に有界でない |
| $0\le\beta< 1$ | 状態 1 つ、行動 1 つ、$c=1$、$\beta=1$ | $Tv=v+1$ に不動点がなく、$V_k$ は発散する |
| $V$ が $C^1$ 級 | $\dot x=u$、$\lvert u\rvert\le1$、$\ell=0$、$g(x)=\lvert x\rvert$ | 最適費用が微分できず、prop-dpoc-hjb が使えない |
どの反例も、外した条件のほかの条件は満たしている。
最小の存在:$\inf_{0< u\le1}u=0$ だが、$u=0$ は選べない。どの $u$ についても $u/2$ の方が費用が小さい。状態と費用の和の形は保たれている。
足し算で分かれる費用:$g_0=1$(行動なし)、第 1 段で $g_1\in\{0,-1\}$ を選ぶとする。全体の費用 $(g_0+g_1)^2$ は $g_1=-1$ で最小値 $0$ をとる。後半だけの費用 $g_1^2$ の最小は $g_1=0$ で、最適な列の後半と食い違う。累積の和を状態に入れれば、条件 (ii) を満たす問題に書き直せる。
状態で足りること:2 段で行動 $\mathrm{A},\mathrm{B}$ を選ぶ。第 0 段の費用は $\mathrm{A}:0$、$\mathrm{B}:1$、第 1 段の費用は $\mathrm{A}:3$、$\mathrm{B}:0$、2 段の行動が違うと切替の費用 $5$ がかかる。列 $\mathrm{AA},\mathrm{AB},\mathrm{BA},\mathrm{BB}$ の本当の費用は $3,5,9,1$ で、最小は $\mathrm{BB}$ の $1$ である。前の行動を状態に入れずに段ごとに最小化すると、第 0 段で $\mathrm{A}$、第 1 段で $\mathrm{B}$ を選び、本当の費用は $5$ になる。前の行動を状態に入れれば正しく解ける。
$R$ の符号:$J(u)=-u^2+\tfrac12(x_0+u)^2$ である。$R+B^{\mathsf T}Q_TB=-\tfrac12$ で、$u=x_0$ は $J$ の停留点だが最大点である。$x_0=1$ のとき $J(1)=1$ で、$J(100)=-4899.5$ である。$Q,Q_T$ は半正定値のままで、$R$ だけが条件を破っている。
割引率:$Tv=v+1$ なので $V_k=V_0+k$ である。$c=0$ に変えると、今度はすべての $v$ が不動点になり、一意性が崩れる。
$C^1$ 級:$[t,T]$ で $\lvert x\rvert$ を減らせる量は $T-t$ までなので、最適費用は $V(t,x)=\max\{\lvert x\rvert-(T-t),0\}$ である。これは $\lvert x\rvert=T-t$ で微分できない。微分できる点では方程式 $\partial_tV+\min_{\lvert u\rvert\le1}u\,\partial_xV=0$ を満たす。微分できない点をもつ最適費用を扱うには、粘性解(粘性解の理論)のような弱い解の概念を使う。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 前の段から順に、その段の費用が最小の行動を選ぶ | 後ろから価値を計算し、行動は $g_t+V_{t+1}$ の最小で選ぶ | ex-dpoc-stage |
| 最適な列 1 本だけを記録する | 全状態の行動の表(政策)を記録する。外乱で状態がずれても、表から行動が分かる | thm-dpoc-bellman の (4) |
| 状態に過去の情報を入れ忘れる | 残りの問題に要る情報をすべて状態に入れる | ex-dpoc-counterexamples |
| Riccati 漸化式で $P_t$ と $P_{t+1}$ を混ぜる | 右辺はすべて $P_{t+1}$ で、$K_t$ も $P_{t+1}$ から作る。$t$ は減る向きに計算する | thm-dpoc-lq |
| $\Vert V_{k+1}-V_k\Vert \le\varepsilon$ を誤差 $\varepsilon$ と読む | 誤差の上界は $\beta\varepsilon/(1-\beta)$ | thm-dpoc-vi の (4)、ex-dpoc-machine |
| HJB 方程式の解が最適費用の定義だと思う | 滑らかな解があれば最適費用だが、滑らかな解はないことがある | ex-dpoc-counterexamples |
補足
- 状態の数の爆発:表で解く方法の手間は状態の数に比例する。状態が $d$ 個の成分をもち、各成分を $N$ 段階に刻むと、状態は $N^d$ 個になる。これが動的計画法の主な限界で、「次元の呪い」とよばれる。LQ 制御は価値関数が 2 次形式の行列 1 つで済む例外である。
- 政策反復:貪欲な政策の計算と、その政策の費用の線形方程式 $(I-\beta P_\mu)v=c_\mu$ の解を交互に行う方法である(SB18 §4.3)。価値反復の更新式は同じ本の §4.4 の式 (4.10)(p. 83)にある。費用の最小化ではなく報酬の最大化で書かれているので、符号を読みかえる。
- 無限期間の LQ:すべての行列が定数で、系が可到達(reachable)で $Q$ が正定値のとき、$T\to\infty$ とすると、連続時間では代数 Riccati 方程式 $A^{\mathsf T}S+SA-SBR^{-1}B^{\mathsf T}S+Q=0$ の解で定数のフィードバックが得られる(AMF20 §7.5、式 (7.33)。この記事では証明しない)。ex-dpoc-lq-scalar の黄金比は、その離散時間の場合の小さな例である。離散代数 Riccati 方程式の解は、状態と入力に制約がある モデル予測制御 の終端の費用にも使われる。状態方程式に雑音が入る場合は 確率最適制御 で扱う。
- 最小二乗による解法:制約つきの最小二乗の問題として、状態と行動を全部並べて一度に解くこともできる(VMLS18 §17.2、pp. 366–367)。Riccati 漸化式は、段の数に比例する手間で解ける点と、フィードバックの形で答えが出る点が違う。
- 別の道筋:価値関数を使わず、最適な軌道が満たす必要条件を調べる方法が Pontryaginの最大原理 である。変分法 の連続時間の問題とも関係する。
- 最短の道との関係:thm-dpoc-bellman の証明の $D_s$ は、最短の道でいえば、辺の長さと距離の差である。重み付きグラフの最短経路 の補題「最短の道の途中までも最短」は、道を逆向きにたどれば (3) の最短の道の場合である。
関連項目
- 前提: 重み付きグラフの最短経路, 正定値行列, Banachの不動点定理, Markov連鎖
- 比較: 動的計画法, Dijkstra法, 線形計画法, Hamilton–Jacobi方程式
- 理論: 最適化, 変分法
- 発展: Markov決定過程, Pontryaginの最大原理, 伝達関数, 確率最適制御, モデル予測制御
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

