ニューラルネットワーク
概要
ニューラルネットワーク(neural network)とは、アフィン写像と、ReLU やロジスティック関数のような 1 変数の非線形関数を成分ごとに施す写像とを交互に合成して作る関数の族で、アフィン写像の係数をパラメータとして動かし、データに合うように選んで(学習して)分類や予測に使う。1 個の閾値素子では排他的論理和を表せないが、隠れ層を 1 つ加えるとすべての論理関数を表せる。ReLU を使うネットワークの関数は連続な区分線形関数で、入力が 1 次元なら逆も成り立つ。層を深くすると、同じユニット数で線形な部分の数を指数的に増やせる。
ニューラルネットワーク(neural network)は、アフィン写像と、1 変数の決まった非線形関数を成分ごとに施す写像とを、交互に何回も合成して作る関数の族である。合成の各段を 層、非線形関数を 活性化関数 といい、アフィン写像の係数(重みと偏り)が パラメータ である。パラメータを動かすと関数が動くので、データに合うようにパラメータを選ぶ(学習する)ことで、画像の分類や数値の予測に使う関数を作る。
たとえば入力 $x=(x_1,x_2)\in\{0,1\}^2$ に排他的論理和 $x_1\oplus x_2$ を返す関数は、1 個の「重み付き和を閾値で切る素子」では作れないが、素子を 2 段に並べると作れる。ReLU と呼ばれる活性化関数 $\operatorname{ReLU}(t)=\max\{t,0\}$ を使うと、
$$
x_1\oplus x_2=\operatorname{ReLU}(x_1+x_2)-2\operatorname{ReLU}(x_1+x_2-1)
$$
と書ける。ネットワークの理論は、このような「何段・何個の素子で何が表せるか」と、「パラメータをどう選ぶか」の 2 つに分かれる。
この記事では順伝播型(層の間を一方向にだけ値が流れる)ネットワークを定義し、1 個の閾値素子が排他的論理和を表せないこと、深さ 2 の閾値ネットワークがすべての論理関数を表すこと、ReLU ネットワークがちょうど連続な区分線形関数を与えること(入力が 1 次元の場合の逆も)、深くすると折れ目の数が指数的に増えることを証明する。任意の連続関数を近似できることは 普遍近似定理、パラメータについての微分の計算は 誤差逆伝播法 で扱う。
定義と使える条件
$\mathbb{R}^n$ の元は縦ベクトルとし、1 変数の関数 $\phi\colon\mathbb{R}\to\mathbb{R}$ をベクトル $z=(z_1,\dots,z_m)$ に施すときは成分ごとに $\phi(z):=(\phi(z_1),\dots,\phi(z_m))$ と読む。
次の 1 変数の関数を 活性化関数 として使う。
- ReLU(正規化線形関数):$\operatorname{ReLU}(t)=\max\{t,0\}$。
- ロジスティック関数(シグモイド関数):$\varsigma(t)=\dfrac1{1+e^{-t}}$。
- 双曲線正接:$\tanh t=\dfrac{e^t-e^{-t}}{e^t+e^{-t}}$。
- 閾値関数(Heaviside関数):$H(t)=1$($t>0$)、$H(t)=0$($t\le0$)。
一般には、任意の関数 $\sigma\colon\mathbb{R}\to\mathbb{R}$ を活性化関数としてよい。
$L\ge1$ と正の整数の列 $(n_0,n_1,\dots,n_L)$(構造)、活性化関数 $\sigma$ を固定する。パラメータ $\theta=(W^{(1)},b^{(1)},\dots,W^{(L)},b^{(L)})$ は、$n_\ell\times n_{\ell-1}$ 行列 $W^{(\ell)}$(重み)と $b^{(\ell)}\in\mathbb{R}^{n_\ell}$(偏り)の組である。入力 $x\in\mathbb{R}^{n_0}$ に対し
$$
x^{(0)}=x,\qquad z^{(\ell)}=W^{(\ell)}x^{(\ell-1)}+b^{(\ell)}\ (1\le\ell\le L),\qquad x^{(\ell)}=\sigma\bigl(z^{(\ell)}\bigr)\ (1\le\ell\le L-1)
$$
と順に定め、$f_\theta(x):=z^{(L)}\in\mathbb{R}^{n_L}$ とおく。写像 $f_\theta\colon\mathbb{R}^{n_0}\to\mathbb{R}^{n_L}$ を、この構造と活性化関数の (順伝播型)ニューラルネットワーク が計算する関数という。
- $L$ を 深さ、$x^{(1)},\dots,x^{(L-1)}$ を 隠れ層、その成分を ユニット(素子、ニューロン)という。隠れ層の数は $L-1$ である。
- $\max_{1\le\ell\le L-1}n_\ell$ を 幅、$\sum_{\ell=1}^{L-1}n_\ell$ を ユニット数 という。
- パラメータの個数は $P=\sum_{\ell=1}^Ln_\ell(n_{\ell-1}+1)$ である。
深さ $L=1$ のネットワークは隠れ層をもたず、アフィン写像 $x\mapsto W^{(1)}x+b^{(1)}$ にすぎない。出力の層には活性化関数を施さない(恒等写像)と定めた。分類に使うときは、出力に閾値関数や def-nn-activation 以外の関数(確率に直す softmax 関数など)を後から施す。
$w\in\mathbb{R}^n$、$c\in\mathbb{R}$ について、関数 $x\mapsto H(w\cdot x+c)$ を 閾値素子(パーセプトロン)という。活性化関数を $H$ とするネットワーク $f_\theta$($n_L=1$)の出力にさらに $H$ を施した関数 $x\mapsto H(f_\theta(x))$ を 閾値ネットワーク という。深さ $1$ の閾値ネットワークは閾値素子である。
$\{0,1\}^n$ から $\{0,1\}$ への写像を 論理関数(Boole 関数)という。閾値ネットワークの深さ・ユニット数は、出力の $H$ の前のネットワーク $f_\theta$ のものとする。
$\mathbb{R}^n$ の部分集合で、有限個の 1 次不等式 $a_i\cdot x\le d_i$ の解の全体として書けるもの(空集合と $\mathbb{R}^n$ も含む)を 多面集合 という。連続写像 $f\colon\mathbb{R}^n\to\mathbb{R}^m$ が 連続区分線形 であるとは、有限個の多面集合 $P_1,\dots,P_k$ で $\bigcup_jP_j=\mathbb{R}^n$ となり、各 $P_j$ の上で $f$ がアフィン写像に一致するものがあることをいう。
この記事の結果を使う条件をまとめる。
- 層の構造:値は入力から出力へ一方向に流れ、各層は直前の層の値だけを受け取る(def-nn-network)。
- 活性化関数:どの関数を使うかで表せる関数が変わる。区分線形性の結果(thm-nn-cpwl)は ReLU、論理関数の結果(thm-nn-boolean)は閾値関数を仮定する。
- 定義域:論理関数の結果は入力が $\{0,1\}^n$、区分線形の逆(prop-nn-1d)と深さの結果(thm-nn-depth)は入力が 1 次元の場合である。
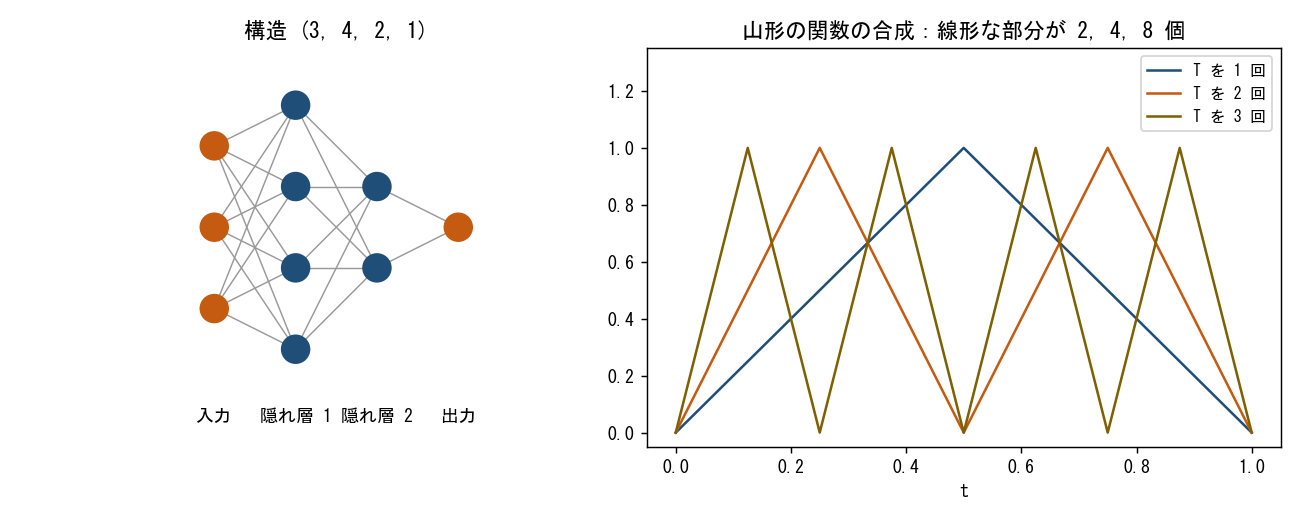 図: 左は構造 (3, 4, 2, 1) のネットワークの図で、入力 3 個、隠れ層のユニット 4 個と 2 個、出力 1 個を丸で描き、隣り合う層のすべての丸を線で結んでいる。右は区間 0 から 1 で山形の関数 T と、その 2 回・3 回の合成のグラフで、合成するたびに山の数が 2 倍になる。
公式の表
ReLU を $\rho$ と略すことがある。
| 量・恒等式 | 式 | 条件 | 根拠 |
|---|---|---|---|
| パラメータの個数 | $P=\sum_{\ell=1}^Ln_\ell(n_{\ell-1}+1)$ | 構造 $(n_0,\dots,n_L)$ | def-nn-network |
| 順伝播の掛け算の回数 | $\sum_{\ell=1}^Ln_\ell n_{\ell-1}$ | 行列とベクトルの積を定義どおりに計算 | def-nn-network |
| ロジスティック関数の微分 | $\varsigma'=\varsigma(1-\varsigma)$、$0<\varsigma'\le\frac14$ | $t\in\mathbb{R}$ | 下の確かめ |
| $\tanh$ とロジスティック関数 | $\tanh t=2\varsigma(2t)-1$ | $t\in\mathbb{R}$ | 下の確かめ |
| 恒等写像と絶対値 | $t=\rho(t)-\rho(-t)$、$\lvert t\rvert=\rho(t)+\rho(-t)$ | $t\in\mathbb{R}$ | 下の確かめ |
| 最大値 | $\max\{a,b\}=a+\rho(b-a)$ | $a,b\in\mathbb{R}$ | 下の確かめ |
| 1 隠れ層の閾値ネットワーク | すべての論理関数を $2^n$ 個以下のユニットで表す | 入力 $\{0,1\}^n$ | thm-nn-boolean |
| ReLU ネットワーク | 連続区分線形 | 任意の構造 | thm-nn-cpwl |
| 1 変数の連続区分線形関数 | 折れ目 $N$ 個なら隠れ層 1 つ・$N+1$ ユニットの ReLU ネットワーク | 入力 1 次元 | prop-nn-1d |
| 1 隠れ層・$N$ ユニットの ReLU ネットワーク | 区間上の線形な部分は $N+1$ 個以下 | 入力 1 次元 | thm-nn-depth |
| 山形の関数の $L$ 回合成 | $[0,1]$ 上で線形な部分がちょうど $2^L$ 個、ユニット $2L$ 個 | 入力 1 次元 | thm-nn-depth |
| VC 次元 | 閾値ネットワークの族の VC 次元は $O(\lvert E\rvert\log\lvert E\rvert)$($\lvert E\rvert$ は辺の数) | 構造を固定した族 | 証明しない:SSBD14 Theorem 20.6(p. 274) |
計算を開く
$\varsigma'(t)=\frac{e^{-t}}{(1+e^{-t})^2}=\varsigma(t)\bigl(1-\varsigma(t)\bigr)$ で、$u(1-u)\le\frac14$($0< u< 1$)から $0<\varsigma'\le\frac14$。$2\varsigma(2t)-1=\frac{2-(1+e^{-2t})}{1+e^{-2t}}=\frac{1-e^{-2t}}{1+e^{-2t}}=\tanh t$。$t\ge0$ なら $\rho(t)=t$、$\rho(-t)=0$、$t< 0$ なら $\rho(t)=0$、$\rho(-t)=-t$ で、どちらでも $\rho(t)-\rho(-t)=t$、$\rho(t)+\rho(-t)=\lvert t\rvert$。$b\ge a$ なら $a+\rho(b-a)=b$、$b< a$ なら $a$ なので最大値である。$\square$
主定理と証明
1 個の閾値素子の限界と論理関数
$x_1\oplus x_2$($x\in\{0,1\}^2$ で $x_1\ne x_2$ のとき $1$、$x_1=x_2$ のとき $0$)に等しい閾値素子 $H(w_1x_1+w_2x_2+c)$ は存在しない。
そのような $w_1,w_2,c$ があったとする。$H(t)=1\iff t>0$ だから、4 点の値から
$$
c\le0,\qquad w_1+c>0,\qquad w_2+c>0,\qquad w_1+w_2+c\le0
$$
である。2 番目と 3 番目を足すと $w_1+w_2+2c>0$、すなわち $w_1+w_2+c>-c\ge0$ となり、4 番目に反する。$\square$
幾何的には、閾値素子は $\mathbb{R}^2$ を 超平面(直線)$w\cdot x+c=0$ で 2 つに分け、片側に $1$ を与える。値 $1$ の点 $(1,0),(0,1)$ と値 $0$ の点 $(0,0),(1,1)$ は、それぞれの点を結ぶ線分が中点 $(\frac12,\frac12)$ で交わるので、1 本の直線では分けられない。隠れ層を 1 つ加えると、この制約はなくなる。
任意の論理関数 $f\colon\{0,1\}^n\to\{0,1\}$ は、深さ $2$、隠れ層のユニット数 $\max\{\lvert f^{-1}(1)\rvert,1\}$($2^n$ 以下)の閾値ネットワークで表せる。
$u\in\{0,1\}^n$ について $\lvert u\rvert:=\sum_iu_i$ とおき、
$$
g_u(x):=H\Bigl(\sum_{i=1}^n(2u_i-1)x_i-\lvert u\rvert+\tfrac12\Bigr)\qquad(x\in\{0,1\}^n)
$$
と定める。$\sum_i(2u_i-1)x_i=\sum_{u_i=1}x_i-\sum_{u_i=0}x_i$ は、$x_i\in\{0,1\}$ なので $\lvert u\rvert$ 以下であり、等号は「$u_i=1$ のところで $x_i=1$、$u_i=0$ のところで $x_i=0$」、すなわち $x=u$ のときに限る。値は整数なので、$x\ne u$ なら括弧の中は $-\frac12$ 以下、$x=u$ なら $\frac12$ である。よって $g_u(x)=1\iff x=u$ である。
$S:=f^{-1}(1)$ が空でなければ、隠れ層に $g_u$($u\in S$)を並べ、出力を
$$
H\Bigl(\sum_{u\in S}g_u(x)-\tfrac12\Bigr)
$$
とする。$\sum_{u\in S}g_u(x)$ は $x\in S$ なら $1$($g_x$ だけが $1$)、$x\notin S$ なら $0$ なので、出力は $f(x)$ に等しい。これは深さ $2$ の閾値ネットワーク(隠れ層の重みは $2u_i-1$、偏りは $-\lvert u\rvert+\frac12$、出力の重みは $1$、偏りは $-\frac12$)である。$S$ が空なら、隠れ層に任意のユニットを 1 個置いて出力の重みを $0$、偏りを $-\frac12$ とすれば、出力は恒等的に $0=f$ である。$\square$
この構成のユニット数は最悪 $2^n$ である。ユニット数が指数的になることは避けられない:深さ 2 に限らず、すべての論理関数を表せる閾値ネットワークの構造は、ユニット数が $n$ について指数的に大きくなければならない(SSBD14 Theorem 20.2、p. 272。証明は VC 次元の評価による。この記事では証明しない)。
ReLU ネットワークと区分線形関数
活性化関数を ReLU とするネットワークが計算する関数 $f_\theta\colon\mathbb{R}^{n_0}\to\mathbb{R}^{n_L}$ は、構造とパラメータによらず、連続区分線形である。
連続区分線形な写像の全体が次の 2 つの操作で閉じていることを示す。
(a) $g\colon\mathbb{R}^n\to\mathbb{R}^m$ が連続区分線形で、$A$ が $k\times m$ 行列、$d\in\mathbb{R}^k$ なら、$Ag+d$ も連続区分線形である。実際、$g$ がアフィンになる多面集合 $P_j$ の上で $Ag+d$ もアフィンであり、連続性も保たれる。
(b) $g=(g_1,\dots,g_m)$ が連続区分線形なら、$\operatorname{ReLU}(g)=(\operatorname{ReLU}(g_1),\dots,\operatorname{ReLU}(g_m))$ も連続区分線形である。実際、$P_j$ の上で $g_i(x)=a_{ij}\cdot x+c_{ij}$ と書く。各 $j$ と符号の選び方 $\epsilon\in\{+1,-1\}^m$ について
$$
P_{j,\epsilon}:=P_j\cap\bigcap_{i=1}^m\{x:\ \epsilon_i(a_{ij}\cdot x+c_{ij})\ge0\}
$$
とおくと、これは 1 次不等式を $m$ 個加えた多面集合で、$\epsilon$ を動かした和集合は $P_j$ である(各 $i$ で $a_{ij}\cdot x+c_{ij}$ は $0$ 以上か $0$ 以下のどちらか)。$P_{j,\epsilon}$ の上では $\operatorname{ReLU}(g_i)$ は $\epsilon_i=+1$ なら $g_i$、$\epsilon_i=-1$ なら $0$ なので、どの成分もアフィンである。ReLU は連続なので合成も連続である。
$x^{(0)}=x$ は恒等写像なので連続区分線形である(多面集合は $\mathbb{R}^{n_0}$ 1 個)。$x^{(\ell-1)}$ が $x$ の関数として連続区分線形なら、(a) により $z^{(\ell)}=W^{(\ell)}x^{(\ell-1)}+b^{(\ell)}$ が、(b) により $x^{(\ell)}=\operatorname{ReLU}(z^{(\ell)})$ が連続区分線形である。帰納法により $f_\theta=z^{(L)}$ も連続区分線形である。$\square$
逆向きの主張(連続区分線形関数が ReLU ネットワークで表せること)は、この記事では入力が 1 次元の場合だけを示す。
$g\colon\mathbb{R}\to\mathbb{R}$ は連続で、点 $t_1< t_2< \dots< t_N$($N\ge1$)について区間 $(-\infty,t_1]$、$[t_k,t_{k+1}]$($1\le k\le N-1$)、$[t_N,\infty)$ の上でアフィンとする。それぞれの区間での傾きを $s_0,s_1,\dots,s_N$ とすると
$$
g(t)=g(t_1)+s_0\bigl(\rho(t-t_1)-\rho(t_1-t)\bigr)+\sum_{k=1}^N(s_k-s_{k-1})\,\rho(t-t_k)
$$
である($\rho=\operatorname{ReLU}$)。とくに $g$ は隠れ層 1 つ、ユニット $N+1$ 個($\rho(t-t_k)$ と $\rho(t_1-t)$)の ReLU ネットワークが計算する関数である。
右辺を $h(t)$ とおく。$h$ は連続で、各項は $t_1,\dots,t_N$ 以外では微分可能なので、各区間の内部で $h'$ を比べればよい。$t< t_1$ では $\rho(t-t_k)=0$($k\ge1$)、$\rho(t-t_1)-\rho(t_1-t)=t-t_1$ なので $h'=s_0$。$t_j< t< t_{j+1}$($t_{N+1}:=\infty$)では $\rho(t-t_k)$ は $k\le j$ のとき傾き $1$、$k>j$ のとき $0$ なので
$$
h'(t)=s_0+\sum_{k=1}^j(s_k-s_{k-1})=s_j
$$
である。よって $g-h$ は各区間の上で傾き $0$、すなわち定数であり、連続なので $\mathbb{R}$ 全体で定数である。$t=t_1$ では $\rho(t_1-t_k)=0$($t_1\le t_k$)なので $h(t_1)=g(t_1)$、したがって $g=h$ である。$\rho(t-t_1)$ は和の $k=1$ の項と共通なので、使うユニットは $\rho(t-t_1),\dots,\rho(t-t_N),\rho(t_1-t)$ の $N+1$ 個で、定数 $g(t_1)$ は出力の偏りに入れる。$\square$
深さと折れ目の数
区間 $I$ の上の連続区分線形関数 $g$ について、$I$ を有限個の閉区間に分けて各区間で $g$ がアフィンとなるような分け方のうち、区間の個数が最小のものの個数を 線形な部分の数 という。最小の分け方では隣り合う区間の傾きが異なる。
- 隠れ層 1 つ・ユニット $N$ 個の ReLU ネットワーク $f(t)=\sum_{j=1}^Nc_j\rho(a_jt+\beta_j)+b$ は、任意の閉区間の上で線形な部分の数が $N+1$ 以下である。
- $T(t):=2\rho(t)-4\rho(t-\frac12)$ とおき、$T^{L}$ を $T$ の $L$ 回の合成とする。$T^L$ は隠れ層 $L$ 個・各層ユニット $2$ 個の ReLU ネットワークが計算する関数で、$[0,1]$ の上では区間 $J_m:=[\frac m{2^L},\frac{m+1}{2^L}]$($0\le m\le2^L-1$)の上で傾き $(-1)^m2^L$ のアフィン関数である。とくに $[0,1]$ の上の線形な部分の数はちょうど $2^L$ である。
- したがって、隠れ層 1 つの ReLU ネットワークで $[0,1]$ の上で $T^L$ に一致するものは、ユニットを $2^L-1$ 個以上もつ。
1:$a_j\ne0$ の項 $\rho(a_jt+\beta_j)$ は点 $-\beta_j/a_j$ 以外では局所的にアフィンであり、$a_j=0$ の項は定数である。よって高々 $N$ 個の点の集合 $S$ を除いて $f$ は局所的にアフィンで、閉区間 $I$ を $S$ の点で切った高々 $N+1$ 個の閉区間のそれぞれの上で $f$ はアフィンである(区間の内部で導関数が局所定数なので定数)。最小の分け方の個数はこれ以下である。
2:$t\in[0,\frac12]$ なら $T(t)=2t$、$t\in[\frac12,1]$ なら $T(t)=2t-4(t-\frac12)=2-2t$ である。とくに $T$ は $[0,1]$ を $[0,1]$ に写す。主張を $L$ についての帰納法で示す。$L=1$ はこの計算そのものである。$L$ で正しいとし、$T^{L+1}=T^L\circ T$ を区間 $J'_m:=[\frac m{2^{L+1}},\frac{m+1}{2^{L+1}}]$ の上で調べる。
- $m\le2^L-1$ のとき:$J'_m\subset[0,\frac12]$ で $T(t)=2t$ は $J'_m$ を $J_m$ に写す。帰納法の仮定から $T^{L+1}$ は $J'_m$ の上でアフィンで、傾きは $2\cdot(-1)^m2^L=(-1)^m2^{L+1}$ である。
- $m\ge2^L$ のとき:$J'_m\subset[\frac12,1]$ で $T(t)=2-2t$ は $J'_m$ を $J_k$($k:=2^{L+1}-m-1$)に写す。傾きは $-2\cdot(-1)^k2^L=(-1)^{k+1}2^{L+1}$ で、$k+1=2^{L+1}-m$ は $m$ と偶奇が等しいので $(-1)^m2^{L+1}$ である。
よって $L+1$ でも正しい。隣り合う区間の傾きは符号が異なるので、どの 2 つもまとめられず、線形な部分の数はちょうど $2^L$ である。ネットワークとしては、各隠れ層が直前の値 $u$ から $\rho(u)$ と $\rho(u-\frac12)$ を作り、次の層の重みと偏りに $T(u)=2\rho(u)-4\rho(u-\frac12)$ の 1 次結合を組み込めばよい(最初の層は $u=t$、出力は最後の層の 2 個の 1 次結合)。
3:1 の上界と 2 から $N+1\ge2^L$ である。$\square$
ユニット数 $2L$ の深いネットワークが、隠れ層 1 つなら $2^L-1$ 個以上のユニットを要する関数を計算する。Telgarsky は、この考え方を「近似」に進め、層の少ないネットワークでは指数的に多いユニットがないと近似できない関数があることを示した(Tel16 Theorem 1.1。この記事では証明しない)。
計算の手順
順伝播(関数の値の計算)は def-nn-network の式をそのまま上から計算する。
- $x^{(0)}=x$ とおく。
- $\ell=1,\dots,L$ の順に $z^{(\ell)}=W^{(\ell)}x^{(\ell-1)}+b^{(\ell)}$ を計算し、$\ell< L$ なら $x^{(\ell)}=\sigma(z^{(\ell)})$ とする。
- $f_\theta(x)=z^{(L)}$ を返す。学習で微分を計算するときは、$z^{(\ell)}$ と $x^{(\ell)}$ をすべて保存しておく。
学習は、データ $(x_1,y_1),\dots,(x_N,y_N)$ と損失関数 $\operatorname{loss}(\hat y,y)$(2 乗誤差 $\frac12\|\hat y-y\|^2$ など)について、平均の損失 $R(\theta)=\frac1N\sum_i\operatorname{loss}(f_\theta(x_i),y_i)$ を小さくする $\theta$ を探すことである。
- パラメータを $0$ に近い乱数で初期化する(全部を同じ値にしない。節「よくある誤り」)。
- データを 1 個(または少数)選び、順伝播で損失を計算する。
- 誤差逆伝播法 で損失の $\theta$ についての勾配を計算する。
- 確率的勾配降下法 で $\theta\leftarrow\theta-\eta\nabla_\theta\operatorname{loss}$ と更新し、2 に戻る。
$R$ は $\theta$ について凸でないので、この手順が最小点を見つける保証はない。
例題
構造 $(2,2,1)$、$W^{(1)}=\begin{pmatrix}1&1\\1&1\end{pmatrix}$、$b^{(1)}=\begin{pmatrix}0\\-1\end{pmatrix}$、$W^{(2)}=(1\ \ -2)$、$b^{(2)}=0$ とすると $f(x)=\rho(x_1+x_2)-2\rho(x_1+x_2-1)$ である。値は $f(0,0)=0$、$f(1,0)=f(0,1)=1-0=1$、$f(1,1)=2-2=0$ で、$x_1\oplus x_2$ に等しい。thm-nn-xor とは違い、隠れ層があるので表せる。
構造 $(2,2,1)$、活性化関数はロジスティック関数 $\varsigma$、$W^{(1)}=\begin{pmatrix}1&-2\\3&1\end{pmatrix}$、$b^{(1)}=\begin{pmatrix}0\\-1\end{pmatrix}$、$W^{(2)}=(2\ \ -1)$、$b^{(2)}=0.5$、入力 $x=(1,2)$ とする。$z^{(1)}=(1-4,\ 3+2-1)=(-3,4)$、$x^{(1)}=(\varsigma(-3),\varsigma(4))=(0.047426,\ 0.982014)$ で、出力は
$$
f_\theta(x)=2\times0.047426-0.982014+0.5=-0.387162
$$
である(小数第 7 位を四捨五入)。
構造 $(784,100,10)$($28\times28$ 画素の画像を 10 種類に分ける典型的な大きさ)のパラメータは $100\times785+10\times101=78500+1010=79510$ 個、順伝播の掛け算は $784\times100+100\times10=79400$ 回である。図の構造 $(3,4,2,1)$ では $4\times4+2\times5+1\times3=29$ 個である。
$\max\{0,x_1,x_2\}=\rho(x_1)+\rho\bigl(x_2-\rho(x_1)\bigr)$ である(公式の表の最大値の式で $a=\rho(x_1)=\max\{0,x_1\}$、$b=x_2$)。右辺は、第 1 隠れ層で $\rho(x_1)$、$\rho(x_2)$、$\rho(-x_2)$ を作り、第 2 隠れ層で $\rho(\rho(x_1))=\rho(x_1)$ と $\rho\bigl(\rho(x_2)-\rho(-x_2)-\rho(x_1)\bigr)$ を作って足す、隠れ層 2 つのネットワークである。隠れ層 1 つでは表せない(prop-nn-max3)。
thm-nn-depth の $T$ について、$T^3$ は $[0,1]$ を 8 等分した各区間の上で傾き $\pm8$ のアフィン関数で、$T^3(\frac k8)$ は $k$ が偶数なら $0$、奇数なら $1$ である。$T^3$ は隠れ層 3 つ・ユニット 6 個で計算できるが、隠れ層 1 つでは 7 個以上のユニットが要る。
使える条件と反例
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 隠れ層がある(thm-nn-boolean の深さ 2) | 隠れ層のない閾値素子 | 排他的論理和を表せない(thm-nn-xor) |
| 活性化関数が非線形 | $\sigma(t)=t$、任意の深さ | $f_\theta$ はアフィンで、出力に $H$ を施しても排他的論理和を表せない |
| 活性化関数が ReLU(thm-nn-cpwl) | ロジスティック関数、$f(x)=\varsigma(x)$ | 連続区分線形でない |
| 入力が 1 次元(prop-nn-1d) | $\max\{0,x_1,x_2\}$ | 連続区分線形だが、隠れ層 1 つの ReLU ネットワークで表せない |
| 隠れ層が 1 つ(thm-nn-depth の 1) | 隠れ層 3 つ・ユニット 6 個の $T^3$ | 線形な部分の数 $8$ がユニット数 $+1=7$ を超える |
2 行目:アフィン写像の合成はアフィンなので $f_\theta(x)=Ax+d$ の形である。$H(Ax+d)$ は閾値素子なので thm-nn-xor により排他的論理和ではない。3 行目:$\varsigma''=\varsigma(1-\varsigma)(1-2\varsigma)$ は $t=0$ でだけ $0$ になるので、$\varsigma$ はどの区間の上でもアフィンでない。4 行目は次の命題による。
$F(x)=\max\{0,x_1,x_2\}$($x\in\mathbb{R}^2$)に等しい、隠れ層 1 つの ReLU ネットワークは存在しない。
証明を開く
$F$ が微分できない点の集合 $D_F$ は、半直線 $\{x_1=x_2\ge0\}$、$\{x_1=0\ge x_2\}$、$\{x_2=0\ge x_1\}$ の和集合である(それ以外の点の近くでは $0,x_1,x_2$ のうち 1 つだけが最大で、$F$ はその 1 次式に等しい。半直線の上では 2 つの 1 次式が最大で、勾配の異なる 2 つの 1 次式の最大値なので微分できない)。とくに $D_F$ は空でなく、どの直線 $\ell$ についても $\ell\setminus D_F$ は無限集合である($\ell$ が半直線を含む直線なら、その延長の反対側の半直線の点は原点以外 $D_F$ に入らず、そうでない直線は $D_F$ と高々 3 点で交わる)。
一方、$f(x)=\sum_jc_j\rho(a_j\cdot x+\beta_j)+b$($a_j\ne0$ の項だけを考えてよい。$a_j=0$ の項は定数)とする。項を、零点の直線 $\{a_j\cdot x+\beta_j=0\}$ が同じものごとにまとめる。同じ直線をもつ 2 つの項は $(a_j,\beta_j)=\lambda(a,\beta)$($\lambda\ne0$)の形で、$\lambda>0$ なら $\rho(\lambda u)=\lambda\rho(u)$、$\lambda< 0$ なら $\rho(\lambda u)=\lvert\lambda\rvert(\rho(u)-u)$($u=a\cdot x+\beta$)なので、まとめた和は $C\rho(a\cdot x+\beta)+(\text{1 次式})$ の形になる。$C\ne0$ となる直線を $\ell_1,\dots,\ell_r$ とすると、$f$ は $\ell_1\cup\dots\cup\ell_r$ の外で局所的にアフィンで、$\ell_i$ の点のうち他の $\ell_k$ に載らない点 $p$ では、$p$ の近くで $f=C\rho(a\cdot x+\beta)+(\text{アフィン})$ なので微分できない。よって $D_f$ は空であるか、ある直線 $\ell_i$ から有限個の点を除いたものを含む。$D_F$ はそのどちらでもないので $f\ne F$ である。$\square$
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 活性化関数が何でも、層を増やせば表せる関数が増える | 活性化関数が 1 次式なら何層でもアフィン写像 | アフィン写像の合成はアフィン |
| パラメータをすべて同じ値で初期化する | 乱数で初期化する | 同じ層のユニットが同じ値と同じ勾配をもち、更新しても区別がつかない |
| ReLU ネットワークは滑らかな関数を表せる | 連続区分線形な関数しか表せない(近似はできる) | thm-nn-cpwl |
| 表せることと学習で見つかることを同じに考える | 表せても勾配法がそのパラメータに着くとは限らない | 損失はパラメータについて凸でない |
補足
任意の連続関数を、隠れ層 1 つのネットワークでコンパクト集合の上で一様に近似できること(ReLU やロジスティック関数を含む)は 普遍近似定理 で証明する。ネットワークの勾配の計算は 誤差逆伝播法、学習の手順は 確率的勾配降下法 にある。閾値ネットワークの学習の標本数は VC 次元で測られ、VC次元 の理論がそのまま当てはまる(SSBD14 §20.4)。
活性化関数を出力に施す流儀($f_\theta$ の最後にも $\sigma$ を施す)や、層の数を隠れ層の数で数える流儀もある。この記事では出力の層をアフィンのままにし、深さはアフィン写像の数 $L$ で数えた。
関連項目
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

