変分推論
概要
変分推論(variational inference)とは、Bayes 統計で計算の難しい事後分布を、扱いやすい分布の族の中で Kullback–Leibler ダイバージェンスの意味で最も近い分布で近似する方法である。周辺尤度の対数は ELBO(evidence lower bound)とこの KL ダイバージェンスの和に等しいので、周辺尤度を計算せずに ELBO を最大にすればよい。分布を座標ごとの積に限る平均場近似では、因子を 1 つずつ最適にする座標上昇法で ELBO は減らず、最適な因子は他の因子による対数同時密度の期待値の指数で与えられる。正規分布の事後分布では平均は正しく求まるが、分散は小さく見積もられる。
前提知識: Bayes統計, Kullback–Leiblerダイバージェンス, 多変量正規分布, 指数型分布族
Bayes 統計では、観測 $x$ のもとでの潜在変数・母数 $z$ の事後分布 $p(z\mid x)=p(x,z)/p(x)$ を求めたい。分子の同時密度は模型から書けるが、分母の 周辺尤度(エビデンス)$p(x)=\int p(x,z)\,dz$ は高次元の積分で、閉じた形で計算できないことが多い。
変分推論 は、積分の代わりに最適化を解く。扱いやすい分布の族 $\mathcal Q$ を決め、その中で事後分布に Kullback–Leibler ダイバージェンスの意味で最も近い $q$ を探す。このとき $p(x)$ を知らなくても計算できる量 ELBO(evidence lower bound)を最大にすればよい。族を座標ごとの積の形(平均場近似)に限ると、1 つの因子ずつ最適にする 座標上昇法(CAVI)が閉じた形の更新になる。
この記事では、ELBO と KL ダイバージェンスの恒等式、座標ごとの最適な因子の公式、CAVI で ELBO が決して減らないこと(主定理)を証明する。正規分布の場合には、平均は正しく求まるが分散は小さく見積もられることを示し、3 つの例で数値まで計算する。
定義と使える条件
観測 $x$ を固定する。潜在変数を $z=(z_1,\dots,z_m)$ とし、$z_j$ は可測空間 $\mathcal Z_j$ に値をとり、$\mathcal Z_j$ には σ有限測度 $\lambda_j$(Lebesgue 測度や数え上げ測度)が与えられているとする。$\lambda:=\lambda_1\otimes\dots\otimes\lambda_m$ と書き、密度はすべて $\lambda$ や $\lambda_j$ に関するものとする。同時密度 $p(x,z)\ge0$ は $z$ について可測で、$\log0:=-\infty$ とする。
- $p(x):=\int p(x,z)\,\lambda(dz)$ が $0< p(x)< \infty$ を満たすとき、$p(z\mid x):=p(x,z)/p(x)$ を 事後分布 の密度という。
- 確率密度 $q$ で $\int q\lvert\log q\rvert\,d\lambda< \infty$ かつ $\int q(z)\lvert\log p(x,z)\rvert\,\lambda(dz)< \infty$ を満たすものの全体を $\mathcal Q_0$ とし、$q\in\mathcal Q_0$ について
$$ \mathrm{ELBO}(q):=\int q(z)\log p(x,z)\,\lambda(dz)-\int q(z)\log q(z)\,\lambda(dz) $$
と定める。 - $q(z)=\prod_{j=1}^mq_j(z_j)$ の形で、各 $q_j$ が $\int q_j\lvert\log q_j\rvert\,d\lambda_j< \infty$ を満たす $q\in\mathcal Q_0$ の全体を 平均場の族 $\mathcal Q_{\mathrm{MF}}$ という。
- 族 $\mathcal Q\subset\mathcal Q_0$ の中で $\mathrm{ELBO}$ を最大にする(あるいは大きくする)$q$ を求め、それを事後分布の近似に使う方法を 変分推論(variational inference、variational Bayes)という。
密度 $q,r$ について $D(q\|r):=\int_{\{q>0\}}q\log\frac qr\,d\lambda\in[0,\infty]$ を KL ダイバージェンスとする(Kullback–Leiblerダイバージェンス の補足の、密度をもつ分布への拡張)。$q\in\mathcal Q_{\mathrm{MF}}$ では Fubiniの定理 により $\int q\log q\,d\lambda=\sum_j\int q_j\log q_j\,d\lambda_j$ である。
平均場の族で座標 $j$ を更新するとき、ほかの因子 $q_{-j}:=\prod_{i\ne j}q_i$ による期待値
$$
f_j(z_j):=\int\log p(x,z)\prod_{i\ne j}q_i(z_i)\,\lambda_{-j}(dz_{-j})
$$
を使う($\lambda_{-j}$ は $\lambda_j$ 以外の積)。変分推論の定理を使ってよい条件は次のとおりである。
- (i) 周辺尤度が $0< p(x)< \infty$ を満たす。
- (ii) 初期値 $q$ が $\mathcal Q_{\mathrm{MF}}$ に入る(ELBO が有限)。
- (iii) 各更新で、$f_j(z_j)$ が $\lambda_j$ についてほとんどすべての $z_j$ で実数として定まり、$c_j:=\int e^{f_j}\,d\lambda_j$ が有限で、更新後の $q$ も $\mathcal Q_{\mathrm{MF}}$ に入る。
公式の表
| 量 | 式 | 使える条件 | 根拠 |
|---|---|---|---|
| ELBO と KL の恒等式 | $\log p(x)=\mathrm{ELBO}(q)+D\bigl(q\,\|\,p(\cdot\mid x)\bigr)$ | (i)、$q\in\mathcal Q_0$ | prop-vi-identity |
| ELBO の別の形 | $\mathrm{ELBO}(q)=E_q[\log p(x\mid z)]-D\bigl(q\,\|\,p(\cdot)\bigr)$($p(z)$ は事前分布) | 両辺が有限 | 定義を書き直す |
| 座標ごとの最適な因子 | $q_j^*(z_j)=e^{f_j(z_j)}/c_j$、すなわち $\log q_j^*=E_{-j}[\log p(x,z)]+\text{定数}$ | (iii) | thm-vi-cavi |
| 指数型分布族の場合 | $q_j^*$ は完全条件付き分布と同じ族で、自然母数は $E_{-j}[\eta_j(z_{-j},x)]$ | 完全条件付き分布が指数型分布族 | prop-vi-expfam |
| 正規分布 $N(\mu,\Lambda^{-1})$ の近似 | $q_j^*=N\bigl(m_j,\Lambda_{jj}^{-1}\bigr)$、$m_j=\mu_j-\Lambda_{jj}^{-1}\sum_{i\ne j}\Lambda_{ji}(m_i-\mu_i)$ | $q_i$ の 2 次の積率が有限 | prop-vi-gauss |
| 2 次元の正規分布の最適値 | $\max\mathrm{ELBO}=\log p(x)-\frac12\log\frac1{1-\rho^2}$($\rho$ は相関係数) | $\lvert\rho\rvert< 1$ | prop-vi-gauss |
主定理:座標上昇法で ELBO は減らない
(i) のもとで $q\in\mathcal Q_0$ なら $D(q\|p(\cdot\mid x))< \infty$ で、
$$
\log p(x)=\mathrm{ELBO}(q)+D\bigl(q\,\|\,p(\cdot\mid x)\bigr)
$$
である。特に $\mathrm{ELBO}(q)\le\log p(x)$ であり、等号は $q=p(\cdot\mid x)$($\lambda$ についてほとんど至る所)のときに限る。
$\int q\lvert\log p(x,\cdot)\rvert\,d\lambda< \infty$ なので、$q>0$ となるほとんどすべての $z$ で $p(x,z)>0$ である。その点で $\log p(x,z)-\log q(z)=\log p(x)-\log\dfrac{q(z)}{p(z\mid x)}$ であり、$q$ で積分すると $\mathrm{ELBO}(q)=\log p(x)-D(q\|p(\cdot\mid x))$ を得る。左辺と $\log p(x)$ は有限なので $D$ も有限である。
$D\ge0$ を示す。$r:=p(\cdot\mid x)$ とおく。$t>0$ で $\log t\le t-1$ であり、等号は $t=1$ のときに限る。よって
$$
-D(q\|r)=\int_{\{q>0\}}q\log\frac rq\,d\lambda\le\int_{\{q>0\}}(r-q)\,d\lambda=\int_{\{q>0\}}r\,d\lambda-1\le0
$$
である。等号が成り立つのは、$\{q>0\}$ のほとんど至る所で $r/q=1$ であり、かつ $\int_{\{q=0\}}r\,d\lambda=0$ のときで、これは $q=r$ がほとんど至る所で成り立つことと同じである。$\square$
$\log p(x)$ は $q$ によらないので、ELBO を最大にすることと $D(q\|p(\cdot\mid x))$ を最小にすることは同じである(BKM17 §2.2、式 (10)–(14)、pp. 6–7。Bis06 式 (10.2)–(10.4)、p. 463)。
(i) を仮定し、$q=\prod_iq_i\in\mathcal Q_{\mathrm{MF}}$ と座標 $j$ について (iii) の $f_j$、$c_j$ が定まるとする。$q_j^*:=e^{f_j}/c_j$ とおく。
- $q'=q_j'\otimes q_{-j}$(因子 $j$ だけを $q_j'$ に替えたもの)が $\mathcal Q_{\mathrm{MF}}$ に入るなら
$$ \mathrm{ELBO}(q')=\log c_j-\sum_{i\ne j}\int q_i\log q_i\,d\lambda_i-D(q_j'\|q_j^*) $$
である。よって、因子 $j$ だけを動かすとき、ELBO を最大にするのは $q_j'=q_j^*$ ただ 1 つである($q_j^*\otimes q_{-j}\in\mathcal Q_{\mathrm{MF}}$ のとき)。 - 初期値 $q^{(0)}\in\mathcal Q_{\mathrm{MF}}$ から $j=1,2,\dots,m,1,2,\dots$ の順に因子を $q_j^*$ に置き換えて列 $q^{(0)},q^{(1)},\dots$ を作る(CAVI)。各段で (iii) が成り立つなら、$\mathrm{ELBO}(q^{(t)})$ は単調非減少で、$\log p(x)$ 以下の有限な値に収束する。$D(q^{(t)}\|p(\cdot\mid x))$ は単調非増加である。ある段で ELBO が増えないのは、その段の因子がすでに $q_j^*$ に等しいときに限る。
1:$q'\in\mathcal Q_{\mathrm{MF}}$ なので $\int q'\lvert\log p(x,\cdot)\rvert\,d\lambda< \infty$ であり、Fubiniの定理 により
$$
\int q'\log p(x,\cdot)\,d\lambda=\int q_j'(z_j)\Bigl(\int\log p(x,z)\prod_{i\ne j}q_i(z_i)\,\lambda_{-j}(dz_{-j})\Bigr)\lambda_j(dz_j)=\int q_j'f_j\,d\lambda_j
$$
である。また $\int q'\log q'\,d\lambda=\int q_j'\log q_j'\,d\lambda_j+\sum_{i\ne j}\int q_i\log q_i\,d\lambda_i$ である。$f_j=\log c_j+\log q_j^*$ なので、
$$
\mathrm{ELBO}(q')=\int_{\{q_j'>0\}}q_j'\bigl(\log c_j+\log q_j^*-\log q_j'\bigr)\,d\lambda_j-\sum_{i\ne j}\int q_i\log q_i\,d\lambda_i
=\log c_j-D(q_j'\|q_j^*)-\sum_{i\ne j}\int q_i\log q_i\,d\lambda_i
$$
を得る。prf-vi-identity の後半と同じ議論で $D(q_j'\|q_j^*)\ge0$ であり、$0$ になるのは $q_j'=q_j^*$($\lambda_j$ についてほとんど至る所)のときに限る。
2:$t$ 段目で座標 $j$ を更新するとする。更新前の $q^{(t)}$ は $q_j'=q^{(t)}_j$ とした 1 の $q'$ であり、更新後の $q^{(t+1)}$ は $q_j'=q_j^*$ としたものである。1 から
$$
\mathrm{ELBO}(q^{(t+1)})-\mathrm{ELBO}(q^{(t)})=D(q_j^{(t)}\|q_j^*)\ge0
$$
であり、$0$ になるのは $q_j^{(t)}=q_j^*$ のときに限る。prop-vi-identity により ELBO は $\log p(x)$ 以下なので、単調非減少で上に有界な実数列として収束する。$D(q^{(t)}\|p(\cdot\mid x))=\log p(x)-\mathrm{ELBO}(q^{(t)})$ は単調非増加である。$\square$
更新の式 $\log q_j^*=E_{-j}[\log p(x,z)]+\text{定数}$ は Bis06 式 (10.9)(p. 466)、BKM17 式 (17)–(18)(p. 9)で、主定理の 1 の形の導出は BKM17 式 (19)(p. 10)にある。主定理が保証するのは ELBO の値の収束 までである。$q^{(t)}$ そのものの収束や、極限が ELBO の大域的な最大点であることは保証されない。ELBO は一般に凹でなく、初期値によって別の局所的な最大点に着く(BKM17 §2.5、p. 11。ex-vi-coupled)。
指数型分布族の場合
座標 $j$ について、関数 $h_j\ge0$、$t_j$、$\eta_j$、$g_j$ があって、すべての $z$ で($\eta_j$・$g_j$ は実数値とし、$\log0=-\infty$ とする)
$$
\log p(x,z)=\log h_j(z_j)+\eta_j(z_{-j})\cdot t_j(z_j)+g_j(z_{-j})
$$
と書けるとする($z_j$ の完全条件付き分布 $p(z_j\mid z_{-j},x)$ が、底 $h_j$・十分統計量 $t_j$・自然母数 $\eta_j(z_{-j})$ の 指数型分布族 であることと同じ)。$\bar\eta_j:=E_{q_{-j}}[\eta_j(Z_{-j})]$ と $E_{q_{-j}}[g_j(Z_{-j})]$ が有限で、$\bar\eta_j$ がこの族の自然母数空間に入るなら、$q_j^*$ は同じ族の自然母数 $\bar\eta_j$ の分布 $q_j^*(z_j)\propto h_j(z_j)\exp(\bar\eta_j\cdot t_j(z_j))$ である。
期待値の線形性から $f_j(z_j)=\log h_j(z_j)+\bar\eta_j\cdot t_j(z_j)+E_{q_{-j}}[g_j]$ であり、最後の項は $z_j$ によらない。$\bar\eta_j$ が自然母数空間に入るので $c_j=e^{E[g_j]}\int h_je^{\bar\eta_j\cdot t_j}d\lambda_j< \infty$ で、$q_j^*=e^{f_j}/c_j$ は主張の形である。$\square$
この場合、CAVI は自然母数を $\bar\eta_j$ に置き換える操作の繰り返しになる(BKM17 §4.1、式 (36)–(40)、pp. 17–18)。事前分布を共役にとった模型(指数型分布族 の命題「共役事前分布」)では多くの座標がこの形になる。
正規分布の平均場近似
事後分布が $m$ 次元の正規分布 $N(\mu,\Sigma)$($\Sigma$ は正定値、$\Lambda:=\Sigma^{-1}$)で、各 $z_j$ は 1 次元、$\lambda$ は Lebesgue 測度とする。
- $q_i$($i\ne j$)の平均が $m_i$ で 2 次の積率が有限なら、$q_j^*=N\bigl(m_j',\Lambda_{jj}^{-1}\bigr)$、$m_j'=\mu_j-\Lambda_{jj}^{-1}\sum_{i\ne j}\Lambda_{ji}(m_i-\mu_i)$ である。
- CAVI の平均の列は $\mu$ に収束する。ELBO を最大にする平均場の $q$ は $\prod_jN(\mu_j,\Lambda_{jj}^{-1})$ ただ 1 つで、各分散は $\Lambda_{jj}^{-1}\le\Sigma_{jj}$ を満たし、等号は $\Lambda_{ji}=0$(すべての $i\ne j$)のときに限る。
- $m=2$、相関係数 $\rho$ のとき、1 巡($j=1,2$ の更新)ごとに平均の誤差 $m_2-\mu_2$ は $\rho^2$ 倍になり、最適な $q$ の KL ダイバージェンスは $D=-\frac12\log(1-\rho^2)$ である。
1:$\log p(x,z)=-\frac12(z-\mu)^\top\Lambda(z-\mu)+\text{定数}$ を $z_j$ について整理すると
$$
\log p(x,z)=-\frac{\Lambda_{jj}}2z_j^2+z_j\Bigl(\Lambda_{jj}\mu_j-\sum_{i\ne j}\Lambda_{ji}(z_i-\mu_i)\Bigr)+(z_j\text{ によらない項})
$$
である。$z_j$ によらない項は $z_{-j}$ の 2 次式なので、$q_{-j}$ の 2 次の積率が有限なら期待値が有限である。$q_{-j}$ で期待値をとると $z_i$ が $m_i$ に替わり、$f_j(z_j)=-\frac{\Lambda_{jj}}2(z_j-m_j')^2+\text{定数}$ を得る。$\Lambda_{jj}>0$ なので $c_j< \infty$ で、$q_j^*=N(m_j',\Lambda_{jj}^{-1})$ である。
2:分散の更新は平均によらず 1 回で $\Lambda_{jj}^{-1}$ に定まる。平均の更新は、連立 1 次方程式 $\Lambda(m-\mu)=0$ を Gauss–Seidel 法で解く反復と同じである。$\Lambda$ は正定値なので、この反復はどの初期値からも唯一の解 $m=\mu$ に収束する(Gauss–Seidel法)。$\bar q:=\prod_jN(\mu_j,\Lambda_{jj}^{-1})$ とおく。$q\in\mathcal Q_{\mathrm{MF}}$ なら $\int q\lvert\log p(x,\cdot)\rvert d\lambda< \infty$ で $\log p$ は 2 次式なので、$q$ の 2 次の積率は有限であり、$q$ から CAVI を始められる。1 巡後の因子は分散 $\Lambda_{jj}^{-1}$ の正規分布で、その後の ELBO は平均 $m$ の連続関数として減らずに $\mathrm{ELBO}(\bar q)$ に収束するので、$\mathrm{ELBO}(q)\le\mathrm{ELBO}(\bar q)$ である。逆に最適な $q$ は、thm-vi-cavi の 1 の一意性からどの座標の更新でも変わらないので、平均は $\Lambda(m-\mu)=0$ の解 $\mu$、分散は $\Lambda_{jj}^{-1}$ であり、$q=\bar q$ である。単位ベクトル $e_j$ について Cauchy–Schwarz の不等式から
$$
1=(e_j^\top e_j)^2=\bigl((\Lambda^{1/2}e_j)^\top(\Lambda^{-1/2}e_j)\bigr)^2\le(e_j^\top\Lambda e_j)(e_j^\top\Sigma e_j)=\Lambda_{jj}\Sigma_{jj}
$$
であり、等号は $\Lambda^{1/2}e_j$ と $\Lambda^{-1/2}e_j$ が平行、すなわち $\Lambda e_j$ が $e_j$ の定数倍のときに限る。
3:$\Sigma=\begin{pmatrix}\sigma_1^2&\rho\sigma_1\sigma_2\\\rho\sigma_1\sigma_2&\sigma_2^2\end{pmatrix}$ では $-\Lambda_{12}/\Lambda_{11}=\rho\sigma_1/\sigma_2$ なので、誤差 $d_j:=m_j-\mu_j$ は $d_1\leftarrow\rho\frac{\sigma_1}{\sigma_2}d_2$、$d_2\leftarrow\rho\frac{\sigma_2}{\sigma_1}d_1$ と更新され、1 巡で $d_2$ は $\rho^2$ 倍になる。$q^*=N(\mu,\operatorname{diag}(\Lambda_{11}^{-1},\Lambda_{22}^{-1}))$ と $p=N(\mu,\Sigma)$ の密度の対数の差は $\frac12\log(\det\Sigma\cdot\Lambda_{11}\Lambda_{22})-\frac12\sum_j\Lambda_{jj}(z_j-\mu_j)^2+\frac12(z-\mu)^\top\Lambda(z-\mu)$ である。$q^*$ のもとで $E[\Lambda_{jj}(z_j-\mu_j)^2]=1$、$E[(z-\mu)^\top\Lambda(z-\mu)]=\operatorname{tr}(\Lambda\operatorname{diag}(\Lambda_{11}^{-1},\Lambda_{22}^{-1}))=2$ なので後の 2 項の期待値は打ち消し合い、 $D=\frac12\log(\det\Sigma\cdot\Lambda_{11}\Lambda_{22})$ である。$\det\Sigma=\sigma_1^2\sigma_2^2(1-\rho^2)$、$\Lambda_{jj}=1/(\sigma_j^2(1-\rho^2))$ を代入して $D=-\frac12\log(1-\rho^2)$ を得る。$\square$
平均は正しく求まり、分散は小さく見積もられる。これは $D(q\|p)$ を最小にするとき、$p$ の小さい所に $q$ の質量を置くと罰が大きいためで、$q$ は $p$ の内側に収まる(Bis06 §10.1.2、式 (10.10)–(10.15) と Figure 10.2–10.3、pp. 466–469)。
計算の手順
- 同時密度 $\log p(x,z)$ を書き、潜在変数をどう因子に分けるか決める。
- 各座標 $j$ について、$\log p(x,z)$ のうち $z_j$ を含む項だけを集め、$q_{-j}$ での期待値 $f_j$ を計算する。完全条件付き分布が指数型分布族なら、prop-vi-expfam により $q_j^*$ の族と自然母数がすぐ分かる。
- $f_j$ に現れる $q_{-j}$ の期待値($E[z_i]$、$E[z_i^2]$、$E[\log z_i]$ など)を変分母数として持ち、更新の式を書く。
- 初期値を決め、座標を順に更新する。各巡で ELBO を計算する。ELBO が減ったら更新の式か ELBO の式に誤りがある(thm-vi-cavi)。
- ELBO の増分が $10^{-8}$ 以下などで止める。初期値を変えて何回か走らせ、ELBO の最も大きい結果をとる。
例題
$p(z\mid x)=N(\mu,\Sigma)$、$\mu=(1,-1)$、$\Sigma=\begin{pmatrix}1&0.9\\0.9&1\end{pmatrix}$ を平均場の $q_1q_2$ で近似する。初期値の平均は $(0,0)$ とする。使う公式:prop-vi-gauss。
答え:$\Lambda_{11}=\Lambda_{22}=1/0.19\approx5.263158$ で、$q_j^*$ の分散は $0.19$(真の周辺分散は $1$)。平均は 1 巡目で $(1.9,-0.19)$、2 巡目で $(1.729,-0.3439)$ となり、$m_2-\mu_2$ は $0.81\to0.6561$ と $\rho^2=0.81$ 倍ずつ減って $\mu$ に近づく。最適な $q$ では $D=-\frac12\log0.19\approx0.830366$、すなわち $\mathrm{ELBO}=\log p(x)-0.830366$ である。
データ $x_1,\dots,x_6=1.2,0.4,2.1,1.7,0.9,1.5$ が $N(\mu,\tau^{-1})$ に独立に従い、事前分布を $\tau\sim\mathrm{Gamma}(a_0,b_0)$(形 $a_0$・率 $b_0$)、$\mu\mid\tau\sim N(\mu_0,(\lambda_0\tau)^{-1})$、$\mu_0=0$、$\lambda_0=a_0=b_0=1$ とする。$q(\mu)q(\tau)$ で近似する。使う公式:prop-vi-expfam、thm-vi-cavi。
答え:更新は $q(\mu)=N(\mu_N,\lambda_N^{-1})$、$\mu_N=\frac{\lambda_0\mu_0+N\bar x}{\lambda_0+N}$、$\lambda_N=(\lambda_0+N)E_q[\tau]$ と $q(\tau)=\mathrm{Gamma}(a_N,b_N)$、$a_N=a_0+\frac{N+1}2$、$b_N=b_0+\frac12E_q\bigl[\sum_i(x_i-\mu)^2+\lambda_0(\mu-\mu_0)^2\bigr]$ である。収束先は $\mu_N\approx1.114286$、$a_N=4.5$、$b_N\approx2.963571$、$E_q[\tau]\approx1.518438$、$\operatorname{Var}_q[\mu]\approx0.094082$。厳密な事後分布では $E[\mu\mid x]\approx1.114286$、$E[\tau\mid x]\approx1.518438$、$\operatorname{Var}[\mu\mid x]\approx0.125442$ で、平均は一致し分散は小さい。ELBO の収束値 $\approx-8.630469$ は $\log p(x)\approx-8.569275$ より $0.061194$ 小さい。
途中の計算を開く
$\log p(x,\mu,\tau)$ は $\mu$ について 2 次式、$\tau$ について $\bigl(a_0+\frac{N+1}2-1\bigr)\log\tau-\tau\bigl(b_0+\frac12\sum_i(x_i-\mu)^2+\frac{\lambda_0}2(\mu-\mu_0)^2\bigr)$ の形なので、prop-vi-expfam から $q(\mu)$ は正規分布、$q(\tau)$ はガンマ分布である。$\log\tau$ の係数には尤度から $\frac N2$、$\mu$ の事前分布から $\frac12$ が来るので $a_N=a_0+\frac{N+1}2$ である。厳密な事後分布は $\tau\sim\mathrm{Gamma}(a_P,b_P)$、$a_P=a_0+\frac N2=4$、$b_P=b_0+\frac12\bigl(\sum(x_i-\bar x)^2+\frac{\lambda_0N(\bar x-\mu_0)^2}{\lambda_0+N}\bigr)\approx2.634286$ である。$E_q[(\mu-c)^2]=(\mu_N-c)^2+\lambda_N^{-1}$ を使うと $b_N=b_P+\frac{\lambda_0+N}{2\lambda_N}=b_P+\frac1{2E_q[\tau]}$ となり、不動点 $E_q[\tau]=a_N/b_N$ に代入すると $E_q[\tau]\,b_P+\frac12=a_P+\frac12$、すなわち $E_q[\tau]=a_P/b_P=E[\tau\mid x]$ を得る。$\log p(x)$ は Gauss–ガンマ分布の正規化定数の比から閉じた形で計算した。
$z_1,z_2\in\{0,1\}$ の事後分布を $p(0,0\mid x)=p(1,1\mid x)=0.45$、$p(0,1\mid x)=p(1,0\mid x)=0.05$ とし、$q_1=\mathrm{Bernoulli}(a)$、$q_2=\mathrm{Bernoulli}(b)$ で近似する。使う公式:thm-vi-cavi。
答え:$J:=\log9$ とおくと $f_1(1)-f_1(0)=J(2b-1)$ なので、更新は $a\leftarrow\sigma(J(2b-1))$、$b\leftarrow\sigma(J(2a-1))$($\sigma(u)=1/(1+e^{-u})$)である。$\sigma(\log3)=\frac34$ なので $(a,b)=(\frac34,\frac34)$ と $(\frac14,\frac14)$ が不動点で、ELBO はどちらも $\approx-0.497797$($\log p(x)=0$)。初期値 $(0.6,0.55)$ からは ELBO $-0.513997$ から増えて $(\frac34,\frac34)$ に、$(0.4,0.45)$ からは $(\frac14,\frac14)$ に収束する。真の周辺確率は $P(z_1=1\mid x)=0.5$ なので、どちらの解も周辺を $0.25$ ずらす。対称な点 $(\frac12,\frac12)$ も不動点だが ELBO は $\log0.6\approx-0.510826$ と小さい。$(a,b)$ についての ELBO の Hesse 行列はこの点で $\begin{pmatrix}-4&2J\\2J&-4\end{pmatrix}$、固有値は $-4\pm2J$ で、$2J=2\log9>4$ なので鞍点である。
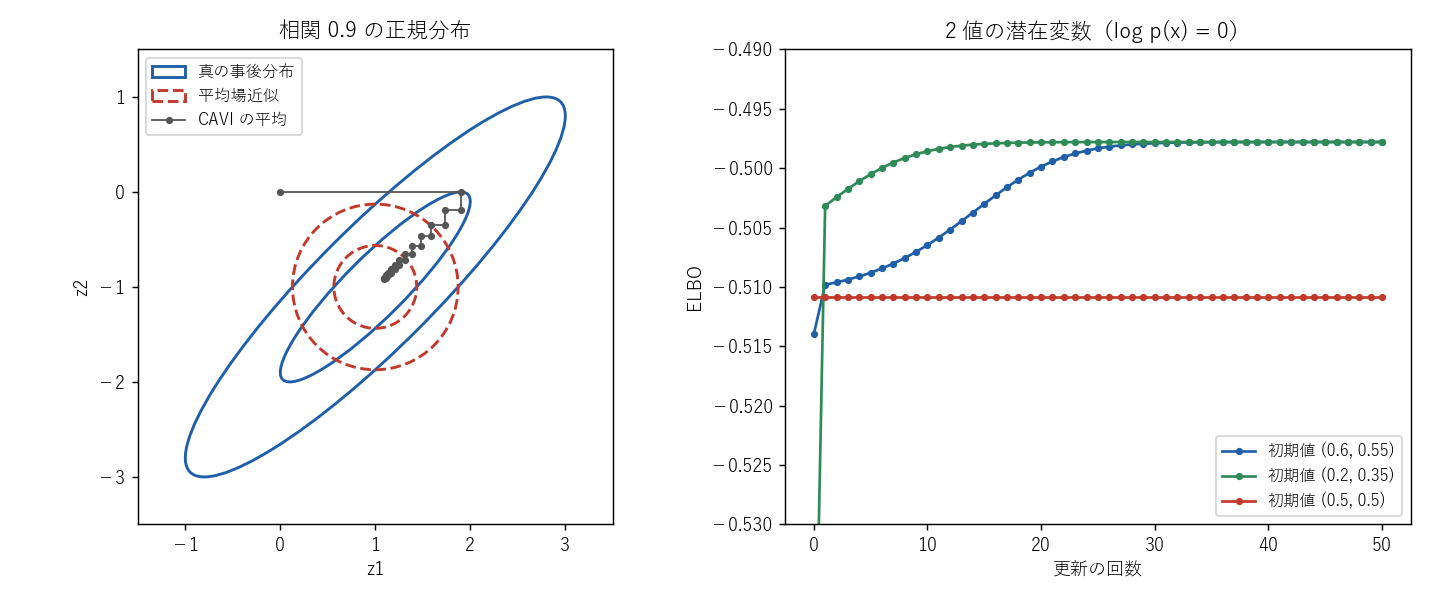 図: 左は例題の 2 次元正規分布。細長い楕円が真の事後分布、軸に平行な小さい楕円が最適な平均場近似で、原点から出る折れ線が CAVI の平均の動き。右は 2 値の例題で、3 つの初期値からの ELBO の値を更新の回数に対して描いたもの。どれも減らない。初期値 (0.6, 0.55) と (0.2, 0.35) の 2 本は約 −0.4978 に近づき、対称な初期値 (0.5, 0.5) の 1 本は鞍点の値 log 0.6 にとどまる。
使える条件と反例
各行は記事の主張の条件を 1 つだけ外す。
| 外す条件 | 反例 | 成り立たなくなること |
|---|---|---|
| 族 $\mathcal Q$ が事後分布を含む(prop-vi-identity の等号) | ex-vi-gauss:$\rho=0.9$ で平均場の族 | ELBO の最大値は $\log p(x)-0.830366$ で、$\log p(x)$ に届かない。単調性は崩れない |
| 事後分布が正規分布(prop-vi-gauss の平均の一致) | ex-vi-coupled | CAVI の平均 $0.75$ が真の平均 $0.5$ と違う |
| 因子を $q_j^*$ に替える(thm-vi-cavi の単調性) | ex-vi-gauss の最適な $q$ で、$q_1$ を真の周辺分布 $N(1,1)$ に替える | ELBO が $1.301213$ 減る |
| (ii)・(iii) の有限性 | ex-vi-gauss で初期値の $q_2$ を Cauchy 分布にとる | $E[(Z_2-\mu_2)^2]=\infty$ で $f_1$ が定まらず、更新ができない |
反例の確かめを開く
3 行目:thm-vi-cavi の 1 から、因子 1 を $q_1'$ に替えたときの減少は $D(q_1'\|q_1^*)$ に等しい。$q_1^*=N(1,0.19)$、$q_1'=N(1,1)$ なので $D=\frac12\bigl(\frac1{0.19}-1+\log0.19\bigr)\approx1.301213$ である。4 行目:$f_1(z_1)$ には $-\frac{\Lambda_{22}}2E[(Z_2-\mu_2)^2]$ の項があり、Cauchy 分布ではこの期待値が $+\infty$ なので $f_1\equiv-\infty$ となる。この $q$ はそもそも $\int q\lvert\log p(x,\cdot)\rvert d\lambda< \infty$ を満たさず、$\mathcal Q_{\mathrm{MF}}$ に入らない。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| CAVI の収束先を大域的な最大点だと思う | 収束するのは ELBO の値で、着く先は初期値による | ex-vi-coupled の 2 つの解と鞍点 |
| 変分推論の分散や区間をそのまま信用する | 平均場近似は分散を小さく見積もりやすい | prop-vi-gauss の $\Lambda_{jj}^{-1}\le\Sigma_{jj}$、ex-vi-normal-gamma |
| KL ダイバージェンスの向きを $D(p\|q)$ と思う | 最小にするのは $D(q\|p(\cdot\mid x))$ | $D(p\|q)$ の最小化は $p$ の積分を要し、ELBO にならない |
| ELBO が途中で減っても気にしない | 減ったら式に誤りがある | thm-vi-cavi の 2 |
| $a_N=a_0+\frac N2$ と書く | $\mu$ の事前分布も $\tau$ を含めば $a_N=a_0+\frac{N+1}2$ | ex-vi-normal-gamma の途中の計算 |
| ELBO の差を周辺尤度の差とみなす | 差には $D(q\|p(\cdot\mid x))$ の違いが混ざる | prop-vi-identity |
補足
EMアルゴリズム は、潜在変数の分布 $q$ を制限せず事後分布そのものに更新し、母数は点で最大化する変分推論とみなせる。データの数が大きい模型では、ELBO の勾配を部分標本で見積もる確率的変分推論が使われる(BKM17 §4.3)。ELBO の最大化は、指数型分布族 のキュムラント関数の変分表示を平均場の族に制限したものとして理解できる(WJ08 §5)。
関連項目
- 前提: Bayes統計, Kullback–Leiblerダイバージェンス, 指数型分布族
- 理論: Jensenの不等式, 多変量正規分布, Gauss–Seidel法
- 比較: Markov連鎖モンテカルロ法, EMアルゴリズム
- 発展: Isingモデル, Gibbs測度
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

