最長共通部分列
概要
最長共通部分列(longest common subsequence)とは、2 つの語の両方から文字を順序を保って取り出して得られる同じ語のうち最も長いものである。長さは語の長さの積に比例する手間の表の計算で求まり、語は表の逆たどりで復元でき、中央の行で分割する再帰を使えば記憶を語の長さの和に比例する量に減らせる。挿入と削除の編集距離と最短共通超列の長さはこの長さから決まり、一致する文字の対が少ないときは増加部分列に帰着でき、語が似ているときは帯の中だけ計算すればよい。ファイルの差分や配列の比較に使う。
最長共通部分列(longest common subsequence、LCS)は、2 つの語の両方から文字を順序を保って取り出して得られる同じ語のうち、最も長いものである。連続した部分である必要はない。
GATTACA と TACGATA からは、どちらからも GATA を順に取り出せるが、長さ $5$ の共通の語は取り出せない。この長さ $4$ が 2 つの語の近さの尺度になる。ファイルの比較(UNIX の diff)、DNA の配列の比較、綴りの訂正などの応用がある(BK18 §1、p. 1)。
長さの再帰式は 動的計画法 の命題「最長共通部分列の再帰式」で証明されていて、表を埋めれば $O(mn)$ の手間で求まる。実際に使うには、それだけでは足りない。長さ $10^5$ の 2 つの語の表は $10^{10}$ マスあり、記憶に収まらない。この記事で計算すること・証明することは次のとおりである。
- 表から語そのものを復元すること(prop-lcs-backtrace)。
- 最長共通部分列の長さから、挿入と削除の編集距離、最短共通超列の長さが決まること(thm-lcs-duality)。
- 手間を $O(mn)$ のまま、記憶を $O(m+n)$ にして語を復元すること(thm-lcs-linear-space)。
- 一致する文字の対が少ないとき(thm-lcs-matches)、2 つの語の差が小さいとき(prop-lcs-band)の速い計算。
定義と使える条件
$\Sigma$ を集合とし、その元を 文字 という。$X=x_1\cdots x_m$、$Y=y_1\cdots y_n$ を $\Sigma$ の上の語とする。
(a) 添字 $p_1< \dots< p_r$ を選んで作った語 $x_{p_1}\cdots x_{p_r}$ を $X$ の 部分列 という。$r=0$ の空の語も部分列である。
(b) $X$ と $Y$ の両方の部分列である語を 共通部分列 という。長さが最大の共通部分列を 最長共通部分列 といい、その長さを $L(X,Y)$ と書く。
(c) 添字の対の列 $(p_1,q_1),\dots,(p_r,q_r)$ で、$p_t$ も $q_t$ も狭義に増え、$x_{p_t}=y_{q_t}$ となるものを、長さ $r$ の 対応 という。
対応があれば $x_{p_1}\cdots x_{p_r}$ は共通部分列で、逆に長さ $r$ の共通部分列からは長さ $r$ の対応が作れる。よって $L(X,Y)$ は対応の長さの最大値である。$X_i:=x_1\cdots x_i$、$Y_j:=y_1\cdots y_j$、$L(i,j):=L(X_i,Y_j)$ と書く。
使える条件は次のとおりである。
(i) 語は有限の長さで、文字の比較(等しいかどうか)が $O(1)$ でできる。文字は行全体でもよい(ex-lcs-diff)。
(ii) 文字は完全に一致するときだけ対にする。似ている文字に部分点を与える問題は別である。
(iii) 順序を保つ。対どうしが交わる取り出し方は許さない。
(iv) 語は 2 つである。語の個数を増やすと手間が急に増える(ex-lcs-counterexamples、節「補足」)。
$L(X,Y)$ は一意であるが、最長共通部分列は一意とは限らない。同じ語が別の対応から得られることもある(ex-lcs-counterexamples)。
公式の表
$m=\lvert X\rvert$、$n=\lvert Y\rvert$、$L=L(X,Y)$ とする。$r$ は $x_i=y_j$ となる対 $(i,j)$ の個数である。
| 求めるもの | 式・方法 | 手間 | 記憶 | 根拠 |
|---|---|---|---|---|
| 長さ $L$ | $x_i=y_j$ なら $L(i,j)=L(i-1,j-1)+1$、それ以外は $\max\{L(i-1,j),L(i,j-1)\}$ | $O(mn)$ | $O(\min\{m,n\})$ | 動的計画法 の命題「最長共通部分列の再帰式」 |
| 語を 1 つ | 表の逆たどり | $O(mn)$ | $O(mn)$ | prop-lcs-backtrace |
| 語を 1 つ(少ない記憶) | 中央の行で分割する再帰 | $O(mn)$ | $O(m+n)$ | thm-lcs-linear-space |
| 一致が少ないとき | 増加部分列への帰着 | $O((r+m+n)\log n)$ | $O(r+m+n)$ | thm-lcs-matches |
| 差が小さいとき | 帯の中だけの表 | $O((m+n)(\Delta+1))$ | 同じ | prop-lcs-band。$\Delta=\max\{m,n\}-L$ |
| 挿入と削除の編集距離 | $m+n-2L$ | $L$ と同じ | $L$ と同じ | thm-lcs-duality |
| 最短共通超列の長さ | $m+n-L$ | $L$ と同じ | $L$ と同じ | thm-lcs-duality |
| 列の最長増加部分列 | 整列した列との $L$ | $O(n\log n)$ | $O(n)$ | cor-lcs-increasing |
| 最長の対応の個数 | $N(i,j)$ の再帰式 | $O(mn)$ | $O(\min\{m,n\})$ | 下の導出 |
| 最長共通部分文字列(連続) | $x_i=y_j$ なら $M(i,j)=M(i-1,j-1)+1$、それ以外は $0$。答えは $M$ の最大値 | $O(mn)$ | $O(\min\{m,n\})$ | 下の導出 |
手間は文字の比較と整数の演算の回数である。
表の行の導出を開く
記憶:表の $i$ 行目は $i-1$ 行目だけから計算できるので、長さだけなら 2 行で足りる。短い語の方を列にとる。
最長の対応の個数:$L(i,j)$ を達成する $X_i,Y_j$ の対応の個数を $N(i,j)$ とする($i=0$ または $j=0$ のとき $1$)。対応は、対 $(i,j)$ で終わるか、$x_i$ を使わないか、$y_j$ を使わないかのどれかである。$[\,P\,]$ を $P$ が真なら $1$、偽なら $0$ とすると、包除で $N(i,j)=[x_i=y_j]\,N(i-1,j-1)+[L(i-1,j)=L(i,j)]\,N(i-1,j)+[L(i,j-1)=L(i,j)]\,N(i,j-1)-[L(i-1,j-1)=L(i,j)]\,N(i-1,j-1)$ である。$x_i=y_j$ のとき最後の項は $0$ である。これは対応の個数で、語の個数ではない。
最長共通部分文字列:$M(i,j)$ は $X_i$ の末尾と $Y_j$ の末尾の共通の連続部分の長さの最大値である。最後の文字が違えば $0$ で、等しければ 1 文字短い末尾の値に $1$ を足す。
主定理と証明
語の復元
表 $L(i,j)$ があるとする。$(i,j)=(m,n)$ から始めて、$i,j\ge1$ の間、次を行う。$x_i=y_j$ なら対 $(i,j)$ を記録して $(i-1,j-1)$ へ進む。そうでなく $L(i-1,j)\ge L(i,j-1)$ なら $(i-1,j)$ へ、それ以外は $(i,j-1)$ へ進む。記録した対を逆順に並べたものは長さ $L(m,n)$ の対応である。手間は $O(m+n)$ である。
再帰式より、対を記録した段では $L$ が $1$ 減り、記録しない段では $L$ は変わらない。$i=0$ または $j=0$ で $L=0$ なので、記録した対の個数は $L(m,n)$ である。$i$ も $j$ も増えない向きに進み、対を記録した段で両方が減るので、対の $p,q$ は狭義に増える。$i+j$ は各段で減るので、段の数は $m+n$ 以下である。$\square$
編集距離と最短共通超列
語の 挿入 は 1 文字を好きな位置に入れること、削除 は 1 文字を除くことである。$X$ を $Y$ に変える挿入と削除の回数の最小値を $D(X,Y)$ と書く。$X$ と $Y$ の両方を部分列にもつ語を 共通超列 といい、その長さの最小値を $S(X,Y)$ と書く。
$L=L(X,Y)$ について
$$
D(X,Y)=m+n-2L,\qquad S(X,Y)=m+n-L
$$
が成り立つ。
$D$:最長共通部分列 $Z$ をとる。$X$ から $m-L$ 文字を削除して $Z$ にし、$n-L$ 文字を挿入して $Y$ にすれば、$m+n-2L$ 回で済む。
逆に、削除 $a$ 回、挿入 $b$ 回で $X$ を $Y$ に変えるとする。$X$ の文字のうち最後まで残るものの個数を $t$ とする。残る文字は順序を保って $Y$ の中に現れるので、共通部分列をなし、$t\le L$ である。残らない文字はそれぞれ 1 回削除されるので $a\ge m-t$ である。$Y$ の文字のうち $X$ から残ったものでない $n-t$ 個は、それぞれ 1 回挿入されたものなので $b\ge n-t$ である。よって $a+b\ge m+n-2t\ge m+n-2L$ である。
$S$:長さ $L$ の対応 $(p_t,q_t)$ をとる。$p_t,q_t$ の間の $X$ の文字と $Y$ の文字を並べ、対の文字を 1 つにまとめると、$X$ と $Y$ を部分列にもつ長さ $m+n-L$ の語ができる。
逆に $Z$ を共通超列とし、$X$ の文字を置く $Z$ の位置の集合を $A$、$Y$ の文字を置く位置の集合を $B$ とする。$\lvert A\rvert=m$、$\lvert B\rvert=n$ で $A\cup B$ は $Z$ の位置に含まれるので、$\lvert A\cap B\rvert\ge m+n-\lvert Z\rvert$ である。$A\cap B$ の位置の文字を順に読むと、$X$ の部分列であり $Y$ の部分列でもある。よって $L\ge m+n-\lvert Z\rvert$ である。$\square$
挿入と削除だけの編集距離が最長共通部分列と同じ計算であることは、Eri19 §3.7 の注 14(p. 115)、ABV15 §1(p. 2)にも述べられている。置換も許す 編集距離 は別の量で、$m+n-2L$ と一致しない(ex-lcs-counterexamples)。
線形領域の方法
表全体を持たずに語を復元する。鍵は、中央の行を通る列を 1 つ決めれば、問題が小さい 2 つに分かれることである。
$0\le h\le m$ とし、$X'=x_1\cdots x_h$、$X''=x_{h+1}\cdots x_m$ とする。$j=0,\dots,n$ について $f(j):=L(X',y_1\cdots y_j)$、$g(j):=L(X'',y_{j+1}\cdots y_n)$ とおくと
$$
L(X,Y)=\max_{0\le j\le n}\bigl(f(j)+g(j)\bigr)
$$
である。最大を与える $j$ について、$X'$ と $y_1\cdots y_j$ の最長共通部分列の後ろに $X''$ と $y_{j+1}\cdots y_n$ の最長共通部分列をつないだ語は、$X$ と $Y$ の最長共通部分列である。
任意の $j$ について、2 つの共通部分列をつなぐと $X,Y$ の共通部分列になるので、$L(X,Y)\ge f(j)+g(j)$ である。
逆に、長さ $L(X,Y)$ の対応をとり、$p_t\le h$ の対の個数を $s$ とする。$j:=q_s$($s=0$ なら $j:=0$)とおくと、前の $s$ 個は $X'$ と $y_1\cdots y_j$ の対応で、残りは $X''$ と $y_{j+1}\cdots y_n$ の対応である。よって $L(X,Y)\le f(j)+g(j)$ である。主張の後半は、つないだ語の長さが $f(j)+g(j)=L(X,Y)$ であることから従う。$\square$
$f$ は表の $h$ 行目で、2 行の記憶で計算できる。$g$ は、$X''$ と $Y$ を逆順にした語について同じ計算をすれば求まる(語を逆順にしても共通部分列は逆順になるだけである)。
次の手順 $H(X,Y)$ を考える。
- $X$ か $Y$ が空なら空の語を返す。
- $m=1$ なら、$x_1$ が $Y$ に現れれば語 $x_1$、現れなければ空の語を返す。
- $h=\lfloor m/2\rfloor$ とし、$f(j)$、$g(j)$ を計算する。
- $f(j)+g(j)$ を最大にする $j$ をとる。
- $H(X',y_1\cdots y_j)$ の後ろに $H(X'',y_{j+1}\cdots y_n)$ をつないで返す。
$H(X,Y)$ は $X,Y$ の最長共通部分列を返す。全体で計算する表のマスの数は $8mn$ 以下で、記憶は $X,Y$ を含めて $O(m+n)$ である。
正しさは $m$ についての帰納法と lem-lcs-split による。$m\ge2$ なら $h$ も $m-h$ も $1$ 以上で $m$ より小さい。
長さ $a$ と $b$ の語についての呼び出しで計算するマスの総数の最大値を $C(a,b)$ とする。$C(a,b)\le8ab$ を $a$ についての帰納法で示す。$a=0$ または $b=0$ なら $C=0$ である。$a=1$、$b\ge1$ なら、$Y$ を見るだけで $b+1\le 8b$ である。$a\ge2$、$b\ge1$ のとき、$h=\lfloor a/2\rfloor$ とすると、手順 3 のマスは $h(b+1)+(a-h)(b+1)=a(b+1)\le2ab$ である。$a-h=\lceil a/2\rceil\ge h$ と $\lceil a/2\rceil\le\tfrac34a$ を使うと
$$
C(a,b)\le2ab+8hj+8(a-h)(b-j)\le2ab+8(a-h)b\le2ab+6ab=8ab
$$
となる。
記憶について:手順 3 の行の記憶は $O(b+1)$ で、手順 5 の再帰の前に捨ててよい。再帰の深さは $O(\log m)$ で、各段に残すのは添字だけである。語は添字の範囲で渡す。返す語の長さは $m$ 以下である。$\square$
線形領域で最長共通部分列を計算する手順は Hirschberg が 1975 年に与えた(ABV15 の文献表の [Hir75])。
一致が少ないとき
$x_i=y_j$ となる対の全体を $R$、$r:=\lvert R\rvert$ とする。語の文字がほとんど異なるとき、たとえばファイルの行を文字とみるとき、$r$ は $mn$ よりずっと小さい。対応は $R$ の中の鎖なので、表全体を埋める必要はない。
$R$ の元を、$i$ の増える順に、同じ $i$ の中では $j$ の 減る 順に並べ、$j$ の成分だけを読んだ数の列を $J$ とする。
(1) $L(X,Y)$ は $J$ の狭義増加部分列の長さの最大値に等しい。
(2) 文字に全順序があるとき、それは手間 $O((r+m+n)\log n)$ で求まる。
- 長さ $k$ の対応の対は $i$ の増える順なので $J$ の中でこの順に現れ、$j$ の成分は狭義に増える。逆に $J$ の狭義増加部分列をとる。同じ $i$ の対は $j$ の減る順に並ぶので、2 つ同時には選ばれない。よって選ばれた対の $i$ は狭義に増え、$j$ も狭義に増えるので、対応である。
- $Y$ の添字を文字ごとに整列して $O(n\log n)$ で表を作り、$x_i$ ごとに表を二分探索で引く。これで $J$ が左から順に $O((r+m)\log n)$ で読める。増加部分列の長さの計算は lem-lcs-tails による。$\square$
数の列を左から読み、次のように列 $T$ を更新する。読んだ数を $v$ とする。$T[k]\ge v$ となる最小の $k$ があれば $T[k]:=v$ とし、なければ $T$ の最後に $v$ を足す。読んだ部分について、$T[k]$ は長さ $k$ の狭義増加部分列の末尾の値の最小値であり、$T$ は狭義に増加する。とくに $T$ の長さは最長の狭義増加部分列の長さである。1 回の更新の手間は、二分探索で $O(\log\lvert T\rvert)$ である。
読んだ部分について主張が成り立つとし、次の数 $v$ を読む。長さ $l$ の増加部分列で $v$ で終わるものがあることと、$l=1$ または $T[l-1]< v$ であることは同値である。$k$ を $T[k]\ge v$ となる最小の添字(なければ $\lvert T\rvert+1$)とする。$T$ は増加するので、$T[l-1]< v$ であることと $l\le k$ であることは同値である。$l< k$ なら $T[l]< v$ なので値は変わらず、$l=k$ なら最小値は $v$ になる。$l>k$ の長さの列は $v$ で終われない。更新のあとも $T[k-1]< v\le T[k]< T[k+1]$ なので $T$ は増加する。$\square$
$j$ を増える順に並べると成り立たない(ex-lcs-counterexamples)。lem-lcs-tails に、各 $T[k]$ を与えた対と 1 つ前の対への参照を記録すれば、語も復元できる。同じ手間の手順は Hunt と Szymanski による(BK18 表 1、p. 3 の $O((n+M)\log n)$。$M$ はここの $r$、$n$ は長い方の語の長さである)。
相異なる数の列 $\pi=(\pi_1,\dots,\pi_n)$ の最長の増加部分列の長さは、$\pi$ と、それを整列した列の $L$ に等しく、$O(n\log n)$ で求まる。
整列した列を $Y$ とすると、共通部分列は $Y$ の部分列なので増加であり、$\pi$ の増加部分列は $Y$ の部分列である。計算は lem-lcs-tails を $\pi$ に使う。$\square$
最長の増加部分列の長さは、RSK 対応の挿入盤 $P$ の第 1 行の長さに等しい(Robinson–Schensted–Knuth対応 の定理「Greeneの定理」の $k=1$)。
差が小さいとき
2 つの語がよく似ているとき、最長の対応の対は表の対角線の近くにしかない。
$\Delta:=\max\{m,n\}-L$ とする。
(1) 長さ $L$ の対応のどの対も $\lvert p_t-q_t\rvert\le\Delta$ を満たす。
(2) $d\ge\lvert m-n\rvert$ について、$\lvert i-j\rvert\le d$ のマスだけで、$V(i,j):=\max\{V(i-1,j),\ V(i,j-1),\ V(i-1,j-1)+[x_i=y_j]\}$ を計算する。帯の外のマスは最大の中に入れず、行 $0$ と列 $0$ の値は $0$ とする。$[x_i=y_j]$ は等しければ $1$、そうでなければ $0$ である。$L_d:=V(m,n)$ が $\max\{m,n\}-L_d\le d$ を満たせば $L_d=L$ である。
(3) $d=\max\{1,\lvert m-n\rvert\}$ から始めて、(2) の条件が成り立つまで $d$ を 2 倍にしていくと、手間は $O((m+n)(\Delta+1))$ である。
証明を開く
(1) 対 $(p_t,q_t)$ より前の、対に使われない $x$ の文字は $p_t-t$ 個で、$0\le p_t-t\le m-L$ である。同様に $0\le q_t-t\le n-L$ である。よって $\lvert p_t-q_t\rvert=\lvert(p_t-t)-(q_t-t)\rvert\le\Delta$ である。
(2) $V(i,j)$ は $X_i,Y_j$ のある対応の長さなので、$L_d\le L$ である。条件より $\Delta\le\max\{m,n\}-L_d\le d$ である。(1) より長さ $L$ の対応の対はすべて帯の中にある。帯の中の 2 点 $(i,j)$、$(i',j')$($i\le i'$、$j\le j'$)は、斜めの歩を先に、右か下の歩をあとにすると $i-j$ が単調に変わるので、帯から出ずに結べる。$(0,0)$ から $(m,n)$ まで、各対の直前のマスから対のマスへ斜めに進むように結ぶ。$V$ は 1 歩ごとに減らず、対のマスへの斜めの歩で $1$ 増えるので、$L_d\ge L$ である。
(3) $d\ge\Delta$ なら (2) の後半の議論で $L_d\ge L$ となるので $L_d=L$ で、条件が成り立つ。よって最後の $d$ は $\max\{1,2\Delta\}$ 以下である(最初の $d$ で止まるときも、$\lvert m-n\rvert\le\Delta$ なので同じである)。1 回の計算のマスは $O((m+n)(d+1))$ で、$d$ は等比数列なので、総和は最後の項の定数倍である。$\square$
UNIX の diff のように差の小さい語を比べる計算は、差の大きさを使う手順で速くなる(BK18 §1、p. 1。同じ論文の表 1 に Myers の手順などが並ぶ)。
計算の手順
- 文字を決める:比較の単位(文字、単語、行)を決める。行なら文字列のハッシュなどで整数にする。
- 共通の前後を除く:共通の先頭と共通の末尾は取り除いて、その長さを答えに足してよい(最長の対応の最初の対を、先頭の文字の対に取り替えられる。末尾も同じである)。もう一方の語に現れない文字も除いてよい。
- 方法を選ぶ:下の表で選ぶ。
- 長さを求める:必要なら 2 行の記憶で $L$ だけ求める。
- 語が要るなら復元する:prop-lcs-backtrace か thm-lcs-linear-space を使う。
- 読み替える:差分(削除と挿入の列)は、対応に使われない文字を順に読む。thm-lcs-duality の証明のとおりである。
場合 方法 根拠 語が短く表が記憶に収まる 表と逆たどり prop-lcs-backtrace 語が長く、一致が多い(小さい字母) 線形領域の方法 thm-lcs-linear-space 語が長く、一致が少ない(行の比較、大きい字母) 増加部分列への帰着 thm-lcs-matches 語がよく似ている 帯の中の計算 prop-lcs-band 語が 3 つ 表を 3 次元にする。$O(n^3)$ 節「補足」
例題
図の左は ex-lcs-table の表と逆たどり、右は ex-lcs-split の最初の分割である。
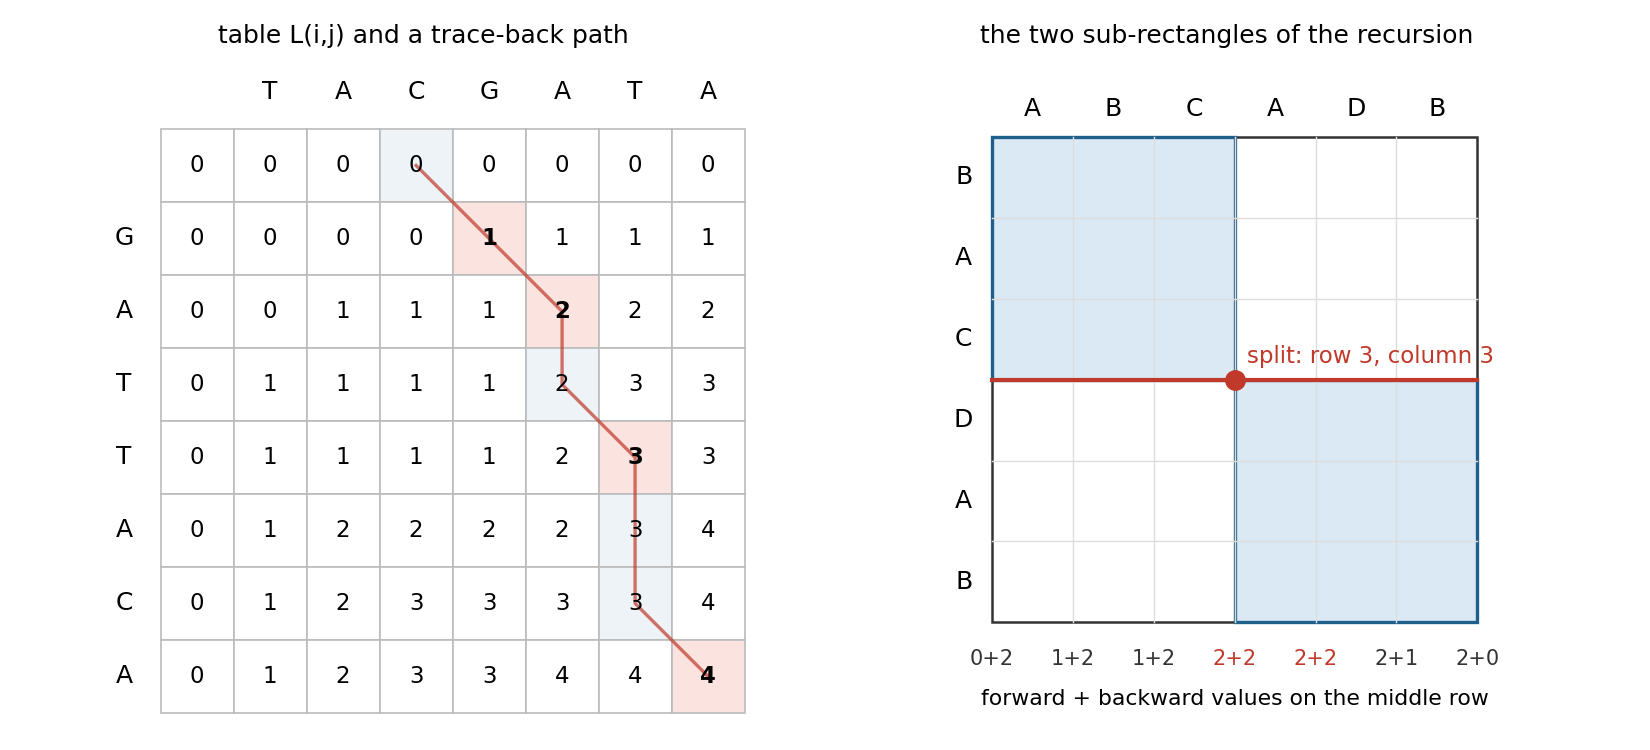 左:GATTACA と TACGATA の表 L(i,j)。太字の赤いマスが記録した対で、線が逆たどりの経路。右:BACDAB と ABCADB の分割。中央の行の上の値 f(j)+g(j) が 4 になる列 3 で、問題が左上と右下の 2 つの長方形に分かれる。
使う公式:公式の表の長さの行、prop-lcs-backtrace。
答え:$L=4$ である。逆たどりは GATA を与える。長さ $4$ の共通部分列は GATA と TACA の 2 語で、長さ $4$ の対応は $8$ 個ある。
表を開く
行が GATTACA、列が TACGATA である。
| T | A | C | G | A | T | A | ||
|---|---|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| G | 0 | 0 | 0 | 0 | 1 | 1 | 1 | 1 |
| A | 0 | 0 | 1 | 1 | 1 | 2 | 2 | 2 |
| T | 0 | 1 | 1 | 1 | 1 | 2 | 3 | 3 |
| T | 0 | 1 | 1 | 1 | 1 | 2 | 3 | 3 |
| A | 0 | 1 | 2 | 2 | 2 | 2 | 3 | 4 |
| C | 0 | 1 | 2 | 3 | 3 | 3 | 3 | 4 |
| A | 0 | 1 | 2 | 3 | 3 | 4 | 4 | 4 |
逆たどりで記録する対は $(7,7),(4,6),(2,5),(1,4)$ で、語は G, A, T, A である。
使う公式:thm-lcs-duality。
答え:$L=7$ で、最長共通部分列の 1 つは LGRITHM である。$D=9+9-14=4$、$S=9+9-7=11$ である。共通超列の例は ALOGOARITHM である。
$X$ の A と O を削除すると LGRITHM になり、O と A を挿入すると $Y$ になる。置換も許す編集距離は $3$ で、$D$ とは違う(先頭の 4 文字のうち 3 文字を置き換える)。
使う公式:lem-lcs-split、thm-lcs-linear-space。
答え:$h=3$ で $X'=$ BAC、$X''=$ DAB である。$f+g$ の最大値は $4$ で、$j=3$ で達成される。$Y'=$ ABC、$Y''=$ ADB に分かれ、最長共通部分列 ACAB を得る。
| $j$ | $0$ | $1$ | $2$ | $3$ | $4$ | $5$ | $6$ |
|---|---|---|---|---|---|---|---|
| $f(j)$ | $0$ | $1$ | $1$ | $2$ | $2$ | $2$ | $2$ |
| $g(j)$ | $2$ | $2$ | $2$ | $2$ | $2$ | $1$ | $0$ |
| $f+g$ | $2$ | $3$ | $3$ | $4$ | $4$ | $3$ | $2$ |
$L(\text{BAC},\text{ABC})=2$(AC)、$L(\text{DAB},\text{ADB})=2$(AB)である。$j=4$ でも最大になり、そこで分けると別の最長共通部分列が得られることがある。
使う定理:thm-lcs-matches、lem-lcs-tails。
答え:$r=10$ で、$J=(6,2,4,1,3,5,4,1,6,2)$ である。$T$ の長さは $4$ で、$L=4$ である。増加部分列 $1,3,5,6$ は対 $(2,1),(3,3),(4,5),(6,6)$ で、語 ACDB である。
$T$ の変化を開く
$J$ を読むと $T$ は $[6]$、$[2]$、$[2,4]$、$[1,4]$、$[1,3]$、$[1,3,5]$、$[1,3,4]$、$[1,3,4]$、$[1,3,4,6]$、$[1,2,4,6]$ と変わる。最後の $T$ そのものは増加部分列とは限らない。末尾の値の最小値を記録しているだけである。
列 $\pi=(3,1,4,6,2,5,7)$ に cor-lcs-increasing を使うと、$T$ は最後に $[1,2,5,7]$ となり、最長の増加部分列の長さは $4$ である。たとえば $1,4,6,7$ である。
次の 2 つの短いプログラムを、行を 1 文字とみて比べる。
使う公式:prop-lcs-band、thm-lcs-duality。
答え:$m=6$、$n=7$、$L=5$ である。差分は 1 行の削除と 2 行の挿入で、$D=3$ である。
| 古い版 | 新しい版 | 差分 |
|---|---|---|
| int a; | int a; | 共通 |
| int b; | 削除 | |
| a = 1; | a = 1; | 共通 |
| c = 3; | 挿入 | |
| b = 2; | b = 2; | 共通 |
| print(a); | print(a); | 共通 |
| print(b); | 挿入 | |
| return; | return; | 共通 |
帯の計算は $d=1$ で $L_1=5$ を与えるが、$7-5=2>1$ なのでまだ確定しない。$d=2$ で $L_2=5$、$7-5\le2$ となって確定する。行はほとんど異なるので $r=5$ で、表の $42$ マスよりずっと少ない。
語 $X,Y$ の各文字を $\{0,1\}$ から独立に一様に選ぶ。長さ $n$ の 2 語の $L$ の期待値を $\ell_n$ とする。
使う公式:全部の語の組で表を計算する($4^n$ 組)。
答え:
| $n$ | $1$ | $2$ | $3$ | $4$ | $5$ | $6$ | $7$ | $8$ |
|---|---|---|---|---|---|---|---|---|
| $\ell_n$ | $0.5$ | $1.125$ | $1.8125$ | $2.5234$ | $3.2461$ | $3.9800$ | $4.7214$ | $5.4691$ |
| $\ell_n/n$ | $0.5$ | $0.5625$ | $0.6042$ | $0.6309$ | $0.6492$ | $0.6633$ | $0.6745$ | $0.6836$ |
Feketeの補題 の例「ランダムな語の最長共通部分列」により $\ell_n/n$ の極限 $\gamma_2=\sup_n\ell_n/n$ が存在する。上の表から $\gamma_2\ge\ell_8/8=44803/65536\approx0.68364$ である。
使える条件と反例
| 外す条件・変える手順 | 反例 | 成り立たなくなること |
|---|---|---|
| 部分列を連続部分に変える | axb と ayb | $L=2$ だが、共通の連続部分の長さは $1$ で、再帰式が別になる |
| 全部の選択を試さず、左から貪欲に対にする | dabc と abcd | 貪欲の長さは $1$、$L=3$ |
| thm-lcs-matches で同じ $i$ の $j$ を増える順に並べる | a と aa | 増加部分列の長さは $2$、$L=1$ |
| 置換を許す | a と b | 編集距離は $1$、$m+n-2L=2$ |
| 語が 3 つのとき 2 語ずつ順に解く | abc、cab、c | 順に解くと $0$、本当の値は $1$ |
| 手順 $H$ の $m=1$ の場合を除く | $m=1$ で $h=0$ | $X''=X$ となり再帰が終わらない |
連続部分:axb と ayb の共通部分列 ab は連続していない。
貪欲:$X$ を左から読み、$Y$ の中で前の対より後ろにある最初の同じ文字と対にする。dabc の d は abcd の最後の文字と対になり、そのあとは対が作れない。abc を取れば長さ $3$ である。
増える順:$Y=$ aa、$X=$ a で $R=\{(1,1),(1,2)\}$ である。$j$ の増える順なら $J=(1,2)$ で、同じ $x_1$ を 2 度使う列が増加部分列になる。減る順なら $J=(2,1)$ で長さは $1$ である。
置換:a を b に置き換えれば 1 回だが、$L=0$ で $m+n-2L=2$ である。thm-lcs-duality は挿入と削除だけの距離についての等式である。
3 語:abc と cab の最長共通部分列は ab だけで、ab と c の共通部分列は空である。一方、3 語の共通部分列 c がある。最長共通部分列は、語の対ごとの最長共通部分列の部分とは限らない。
一意でないこと:ab と ba の最長共通部分列は a と b の 2 語である。また aab と ab の最長の対応は 2 個あるが、語は ab の 1 つである。対応の個数は語の個数ではない。
$m=1$:$h=\lfloor1/2\rfloor=0$ なので、$X'$ は空、$X''=X$ であり、$j=0$ が選ばれると同じ呼び出しに戻る。
よくある誤り
| 誤り | 正しくは | なぜ |
|---|---|---|
| 部分列と部分文字列を混同する | 部分列は連続でなくてよい | 公式の表の最後の行 |
| 最長共通部分列は 1 つと思う | 長さが一意で、語は一意でない | ex-lcs-counterexamples |
| 2 行の記憶で語も復元できると思う | 2 行で求まるのは長さだけである。語には線形領域の方法を使う | thm-lcs-linear-space |
| 分割を毎回 $Y$ の中央で行う | $Y$ の分割点は $f+g$ を最大にする $j$ である。分けるのは $X$ の中央 | lem-lcs-split |
| 増加部分列の計算の $T$ をそのまま答えの語とする | $T$ は末尾の値の最小値の表である。語は参照をたどる | ex-lcs-hs |
| 増加部分列への帰着がいつも速いと思う | $r$ が $mn$ に近いと $O(mn\log n)$ で、表より遅い | thm-lcs-matches |
補足
- 下界:一般の 2 語については、対数因子の改善しか知られていない。字母の大きさが定数のとき、$n\ge m$ として $O(n+nm/\log^2n)$ の手順がある(BK18 表 1、p. 3)。字母の大きさ $7$ の語の $L$ が、ある $\varepsilon>0$ について $O(n^{2-\varepsilon})$ で求まれば、強指数時間仮説は成り立たない(ABV15 定理 1、p. 2)。これは計算量の仮説のもとでの主張で、この記事では証明しない。
- 語が多いとき:$k$ 語の最長共通部分列は $k$ 次元の表で $O(n^k)$ で求まるが、$k$ も入力とすると文字が 2 種類でも NP 困難である(ABV15 §1.1、p. 3 が Maier の結果として引く)。
- 無作為な語:ex-lcs-random の $\gamma_2$ の存在は Feketeの補題 の例で、ほとんど確実な収束は、Kingmanの劣加法的エルゴード定理 の例「ランダムな語の最長共通部分列」の劣加法性にこの定理を当てて得られる。
- 増加部分列の組合せ論:cor-lcs-increasing の長さは Erdős–Szekeresの定理(単調部分列) と Dilworthの定理 が扱う対象である。
- 編集距離:置換を含めた 編集距離 も同じ形の表で計算する。動的計画法 の公式の表にある。
関連項目
- 前提: 動的計画法
- 比較: 編集距離, Robinson–Schensted–Knuth対応
- 応用: Feketeの補題, Kingmanの劣加法的エルゴード定理
- 発展: 計算量理論
参考文献
Mathpediaは寄付と、参考文献の書籍リンク(Amazonアソシエイト)の紹介料で運営されています。 支援について / 寄付する

